
Η γωνία του Anderson
Προς ανθρώπους AI σε πραγματικό χρόνο με το Neural Lumigraph Rendering

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Βασικά σημείαΤο Neural Lumigraph Rendering βελτιώνει το NeRF κατά περίπου δύο τάξεις μεγέθους.
Δείτε περισσότερα
- Το Neural Lumigraph Rendering βελτιώνει το NeRF κατά περίπου δύο τάξεις μεγέθους.
- Το NLR χρησιμοποιεί δίκτυα SIREN για να συνδυάσει τα πλεονεκτήματα των NeRF και IDR για γραφικά σε πραγματικό χρόνο.
- Το NLR δεν διαθέτει δυναμικό φωτισμό και δυνατότητες επαναφωτισμού, περιορίζοντας την έξοδο στον φωτισμό της στιγμής λήψης.
Παρά την τρέχουσα έξαρση ενδιαφέροντος για τα Νευρωνικά Πεδία Ραδιότητας (NeRF), μια τεχνολογία που μπορεί να δημιουργήσει περιβάλλοντα και αντικείμενα 3D που παράγονται από το AI, αυτή η νέα προσέγγιση της τεχνολογίας σύνθεσης εικόνας vẫn απαιτεί πολύ χρόνο εκπαίδευσης και δεν έχει μια εφαρμογή που να επιτρέπει διεπαφές σε πραγματικό χρόνο και υψηλής απόκρισης.
Ωστόσο, μια συνεργασία μεταξύ ονομάτων που εντυπωσιάζουν στην βιομηχανία και την ακαδημία προσφέρει μια νέα ματιά σε αυτή την πρόκληση (γενικά γνωστή ως Σύνθεση Νέων Όψεων, ή NVS).
Το ερευνητικό άρθρο, με τίτλο Neural Lumigraph Rendering, ισχυρίζεται ότι υπάρχει μια βελτίωση περίπου δύο τάξεων μεγέθους σε σχέση με τις πιο προηγμένες υπάρχουσες μεθόδους, που αντιπροσωπεύει αρκετά βήματα προς την απόδοση CG σε πραγματικό χρόνο μέσω των αλυσίδων επεξεργασίας μηχανικής μάθησης.

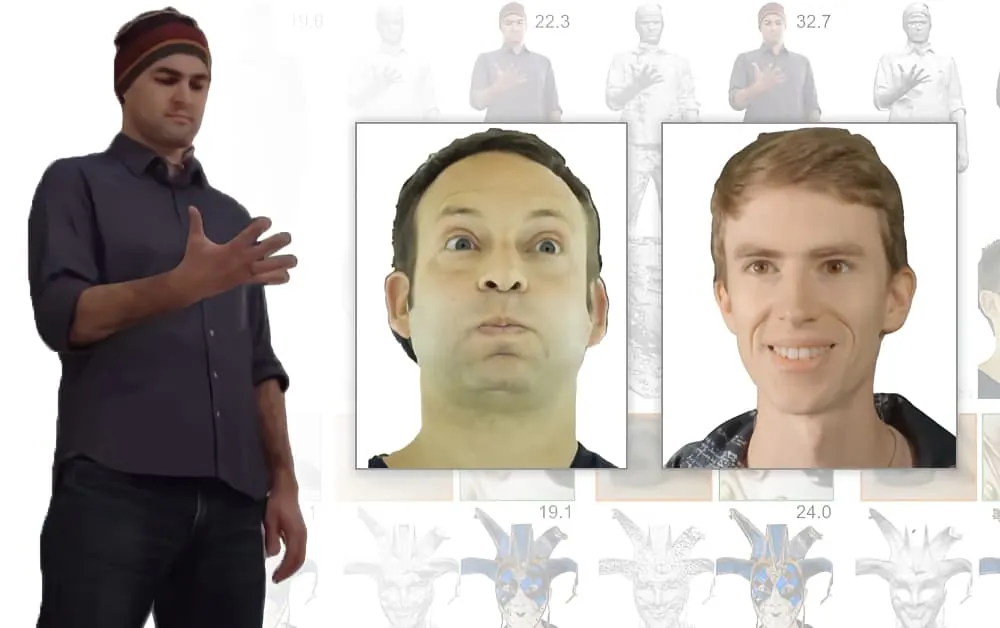
Το Neural Lumigraph Rendering (δεξιά) αντιμετωπίζει καλύτερα τα τεχνουργήματα ανάμειξης και την απόκρυψη επιφανειών σε σχέση με τις προηγούμενες μεθόδους. Πηγή.
Παρότι οι αναφορές φορέων στο άρθρο αναφέρουν μόνο το Πανεπιστήμιο του Στάνφορντ και την εταιρεία τεχνολογίας ολογραφικών οθονών Raxium (η οποία λειτουργεί σήμερα σε κρυφό τρόπο), οι συντελεστές περιλαμβάνουν έναν επικεφαλής αρχιτέκτονα μηχανικής μάθησης στη Google, έναν επιστήμονα υπολογιστών στην Adobe (ADBE ) και τον διευθυντή τεχνολογίας της StoryFile (η οποία έκανε τα πρωτοσέλιδα πρόσφατα με μια εκδοχή του AI του William Shatner).
Σχετικά με την πρόσφατη δημοσιότητα του Shatner, η StoryFile φαίνεται να χρησιμοποιεί την NLR στη νέα της διαδικασία για τη δημιουργία διαδραστικών οντοτήτων που παράγονται από το AI με βάση τα χαρακτηριστικά και τις αφηγήσεις των ατόμων.
Η StoryFile οραματίζεται τη χρήση αυτής της τεχνολογίας σε εκθέσεις μουσείων, διαδραστικές αφηγήσεις στο διαδίκτυο, ολογραφικές οθόνες, επαυξημένη πραγματικότητα (AR) και τεκμηρίωση κληρονομιάς – και φαίνεται επίσης να εξετάζει πιθανές νέες εφαρμογές της NLR σε συνεντεύξεις πρόσληψης και εφαρμογές εικονικών ραντεβού:

Προτεινόμενες χρήσεις από ένα διαδικτυακό βίντεο της StoryFile.
Τρισδιάστατη Καταγραφή για Σύνθεση Νέων Όψεων Διεπαφών και Βίντεο
Η αρχή της τρισδιάστατης καταγραφής, σε όλο το εύρος των εγγράφων που συσσωρεύονται στο θέμα, είναι η ιδέα της λήψης στατικών εικόνων ή βίντεο ενός αντικειμένου και της χρήσης της μηχανικής μάθησης για να «γεμίσουμε» τις οπτικές γωνίες που δεν καλύπτονται από την αρχική σειρά των καμερών.
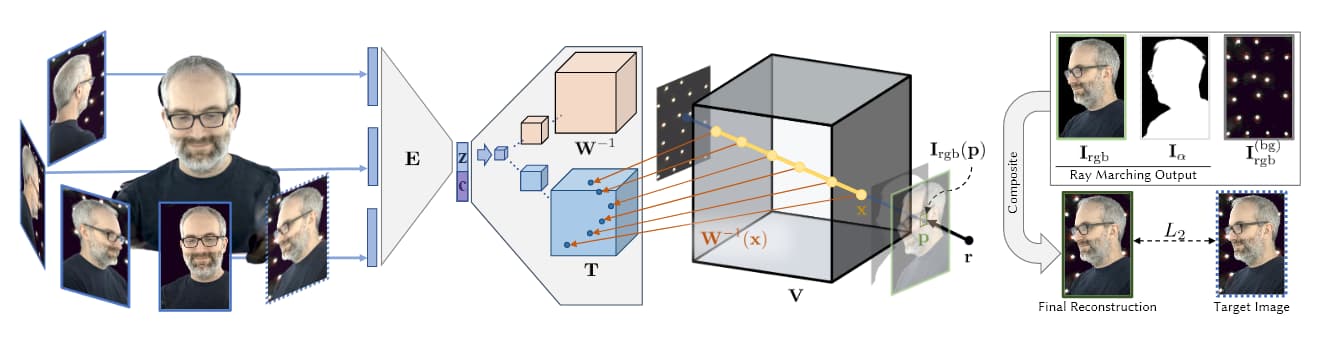
Πηγή: https://research.fb.com/wp-content/uploads/2019/06/Neural-Volumes-Learning-Dynamic-Renderable-Volumes-from-Images.pdf
Στην εικόνα παραπάνω, που έχει ληφθεί από την έρευνα του Facebook για το AI το 2019 (βλέπε παρακάτω), βλέπουμε τα τέσσερα στάδια της τρισδιάστατης καταγραφής: πολλές κάμερες λαμβάνουν εικόνες/βίντεο. η αρχιτεκτονική encoder/decoder (ή άλλες αρχιτεκτονικές) υπολογίζει και συνδυάζει τις σχετικές σχέσεις των όψεων. αλγόριθμοι ray-marching υπολογίζουν τα voxels (ή άλλες μονάδες χωρικής γεωμετρίας XYZ) κάθε σημείου στο τρισδιάστατο χώρο. και (σε πιο πρόσφατα έγγραφα) η εκπαίδευση πραγματοποιείται για τη σύνθεση μιας πλήρους οντότητας που μπορεί κανείς να χειριστεί σε πραγματικό χρόνο.
Είναι αυτή η συχνά εκτεταμένη και απαιτητική σε δεδομένα φάση εκπαίδευσης που, μέχρι σήμερα, έχει κρατήσει τη σύνθεση νέων όψεων έξω από το πεδίο του πραγματικού χρόνου ή της υψηλής απόκρισης.
Το γεγονός ότι η Σύνθεση Νέων Όψεων δημιουργεί ένα πλήρες 3D χάρτη ενός τρισδιάστατου χώρου σημαίνει ότι είναι σχετικά εύκολο να συνδέσει αυτά τα σημεία μαζί σε ένα παραδοσιακό πλέγμα γραφικών υπολογιστή, καταγράφοντας και αρθρώνοντας έτσι έναν ψηφιακό άνθρωπο CGI (ή οποιοδήποτε άλλο σχετικά οριοθετημένο αντικείμενο) σε πραγματικό χρόνο.
Οι προσεγγίσεις που χρησιμοποιούν NeRF βασίζονται σε νέφη σημείων και χάρτες βάθους για να παράγουν τις παρεμβολές μεταξύ των αραιών οπτικών γωνιών των συσκευών καταγραφής:
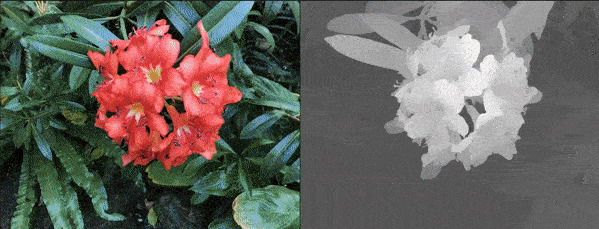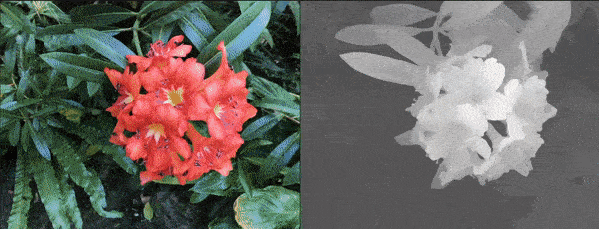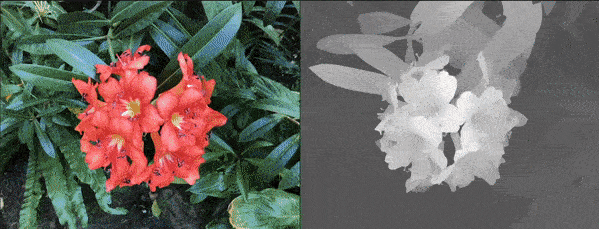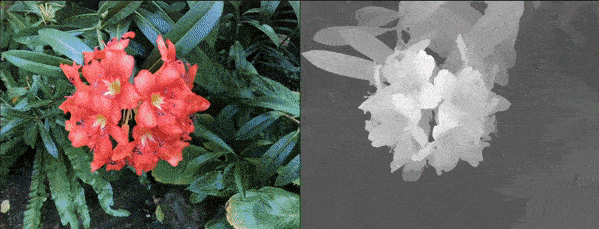
Το NeRF μπορεί να παράγει τρισδιάστατο βάθος μέσω του υπολογισμού των χαρτών βάθους, αντί του υπολογισμού των CG πλεγμάτων. Πηγή: https://www.youtube.com/watch?v=JuH79E8rdKc
Αν και το NeRF είναι ικανό να υπολογίζει πλέγματα, οι περισσότερες εφαρμογές δεν χρησιμοποιούν αυτό για να παράγουν τρισδιάστατα σκηνικά.
Αντίθετα, η προσεγγίση του Implicit Differentiable Renderer (IDR), που δημοσιεύθηκε από το Ινστιτούτο Επιστημών Weizmann τον Οκτώβριο του 2020, βασίζεται στην εκμετάλλευση των πληροφοριών 3D πλέγματος που παράγονται αυτόματα από τις σειρές καταγραφής:
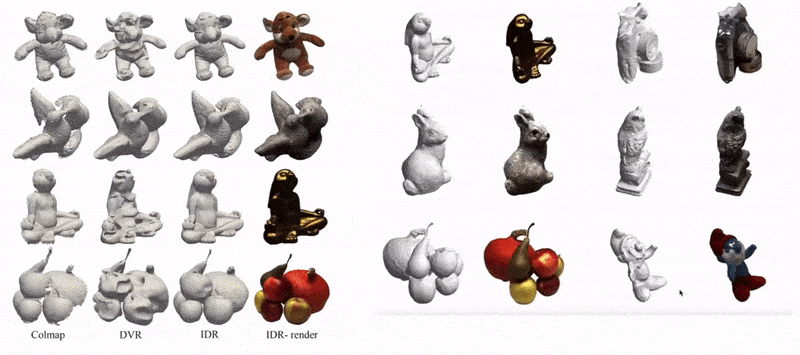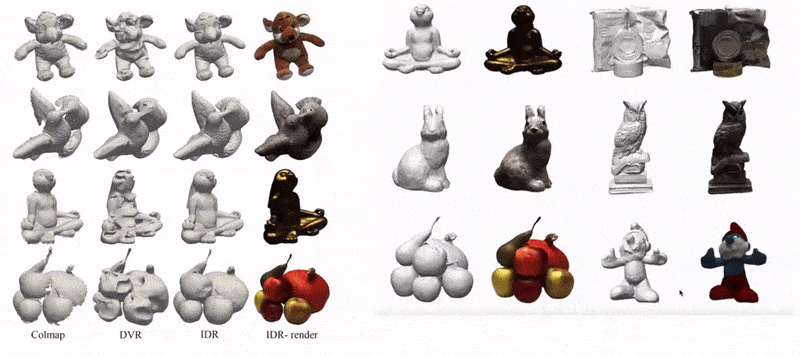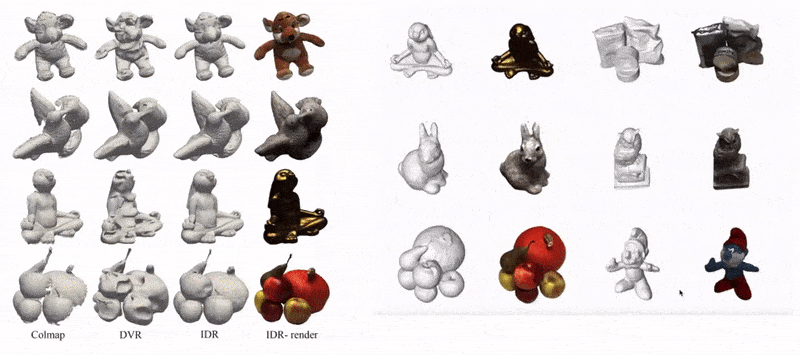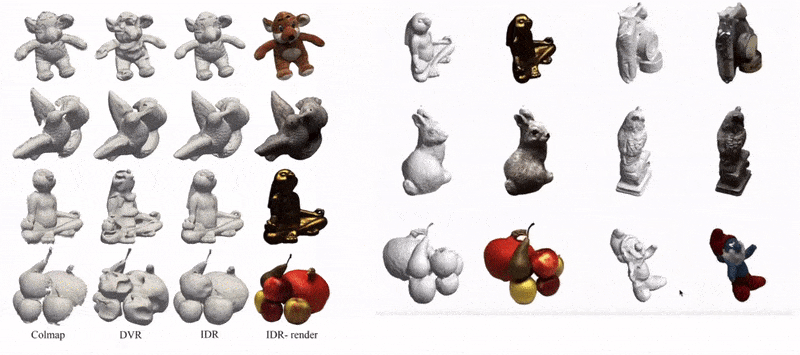
Παραδείγματα IDR που μετατρέπονται σε διαδραστικά CGI πλέγματα. Πηγή: https://www.youtube.com/watch?v=C55y7RhJ1fE
Ενώ το NeRF δεν έχει την ικανότητα του IDR για εκτίμηση σχήματος, το IDR δεν μπορεί να ταιριάξει την ποιότητα εικόνας του NeRF, και και τα δύο απαιτούν εκτεταμένους πόρους για εκπαίδευση και συλλογή (αν και πρόσφατες καινοτομίες στο NeRF ξεκινάνε να αντιμετωπίσουν αυτό).

Η NLR χρησιμοποιεί μια ειδική διάταξη καμερών με 16 GoPro HERO7 και 6 κεντρικές κάμερες Back-Bone H7PRO. Για την απόδοση σε πραγματικό χρόνο, αυτές λειτουργούν με ελάχιστη ταχύτητα 60fps. Πηγή: https://arxiv.org/pdf/2103.11571.pdf
Αντίθετα, η Neural Lumigraph Rendering χρησιμοποιεί SIREN (Sinusoidal Representation Networks) για να ενσωματώσει τα πλεονεκτήματα κάθε προσεγγίσεως στο δικό της πλαίσιο, η οποία έχει ως στόχο να παράγει εξόδους που είναι άμεσα χρησιμές στις υφιστάμενες αλυσίδες επεξεργασίας γραφικών σε πραγματικό χρόνο.
Το SIREN έχει χρησιμοποιηθεί για παρόμοιες εφαρμογές κατά το τελευταίο έτος, και τώρα αντιπροσωπεύει μια δημοφιλή κλήση API για hobbyist Colabs στις κοινότητες σύνθεσης εικόνας. ωστόσο, η καινοτομία της NLR είναι να εφαρμόσει SIRENs σε επιβλεπόμενη μάθηση από δισδιάστατες εικόνες πολλαπλών όψεων, η οποία είναι προβληματική λόγω του βαθμού στον οποίο το SIREN παράγει υπερπροσαρμοσμένες αντί για γενικευμένες εξόδους.
Μετά την εξαγωγή του CGI πλέγματος από τις εικόνες της σειράς, το πλέγμα μετατρέπεται σε εικονοστοιχεία μέσω του OpenGL, και οι θέσεις των κορυφών του πλέγματος αντιστοιχούν στα αντίστοιχα pixels, μετά από αυτό η συγχώνευση των διαφόρων χαρτών που συνεισφέρουν υπολογίζεται.
Το πλέγμα που προκύπτει είναι πιο γενικευμένο και αντιπροσωπευτικό από το NeRF (βλέπε εικόνα παρακάτω), απαιτεί λιγότερο υπολογισμό, και δεν εφαρμόζει υπερβολική λεπτομέρεια σε περιοχές (όπως το λείο δέρμα του προσώπου) που δεν μπορούν να επωφεληθούν από αυτό:

Πηγή: https://arxiv.org/pdf/2103.11571.pdf
Στην αρνητική πλευρά, η NLR δεν έχει ακόμη την ικανότητα για δυναμικό φωτισμό ή relighting, και η έξοδος περιορίζεται σε χάρτες σκιών και άλλες παραμέτρους φωτισμού που λαμβάνονται κατά τη στιγμή της καταγραφής. Οι ερευνητές σκοπεύουν να αντιμετωπίσουν αυτό σε μελλοντική εργασία.
Επιπλέον, το έγγραφο παραδέχεται ότι τα σχήματα που παράγονται από την NLR δεν είναι τόσο ακριβή όσο κάποιες εναλλακτικές προσεγγίσεις, όπως Pixelwise View Selection for Unstructured Multi-View Stereo, ή η έρευνα του Ινστιτούτου Weizmann που αναφέρθηκε νωρίτερα.
Η Άνοδος της Τρισδιάστατης Σύνθεσης Εικόνας
Η ιδέα της δημιουργίας 3D οντοτήτων από μια περιορισμένη σειρά φωτογραφιών με νευρωνικά δίκτυα προηγήθηκε του NeRF, με οραματικές εργασίες που χρονολογούνται από το 2007 ή νωρίτερα. Το 2019, το τμήμα έρευνας του Facebook για το AI παρήγαγε μια θεμελιώδη ερευνητική εργασία, Neural Volumes: Learning Dynamic Renderable Volumes from Images, η οποία πρώτα επέτρεψε τη δημιουργία διεπαφών με γρήγορη απόκριση για συνθετικούς ανθρώπους που παράγονται από την τρισδιάστατη καταγραφή με βάση τη μηχανική μάθηση.
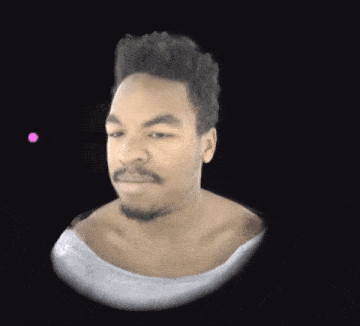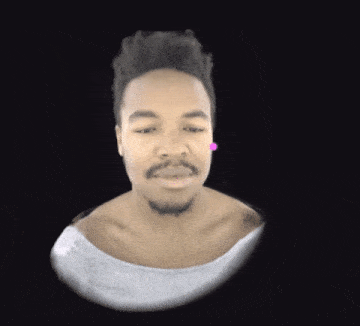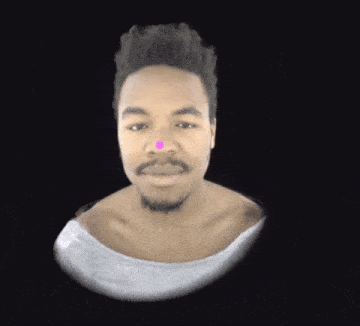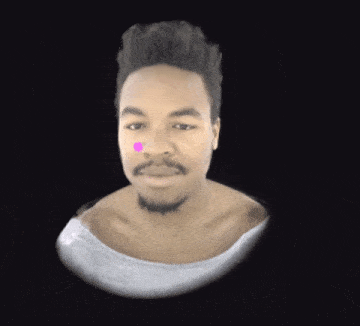
Η έρευνα του Facebook για το AI το 2019 επέτρεψε τη δημιουργία μιας διεπαφής με γρήγορη απόκριση για ένα τρισδιάστατο άνθρωπο. Πηγή: https://research.fb.com/publications/neural-volumes-learning-dynamic-renderable-volumes-from-images/


