
Η γωνία του Anderson
Τρεις Προκλήσεις για το Stable Diffusion

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Βασικά σημείαΤο Stable Diffusion δυσκολεύεται με τα ανθρώπινα άκρα λόγω ανεπαρκώς λεπτομερούς…
Δείτε περισσότερα
- Το Stable Diffusion δυσκολεύεται με τα ανθρώπινα άκρα λόγω ανεπαρκώς λεπτομερούς σχολιασμού των δεδομένων εκπαίδευσης.
- Οι μέθοδοι αναβαθμίσεως με πλακίδια κινδυνεύουν να παράγουν ασυνεχή εικόνες χωρίς ευρύτερη εννοιολογική επίγνωση.
- Η εγγενής ανάλυση 512x512 του μοντέλου περιορίζει την ποιότητα εξόδου και απαιτεί πολύπλοκες λύσεις.
Η κυκλοφορία του μοντέλου σύνθεσης εικόνων Stable Diffusion της stability.ai, που βασίζεται στη λανθάνουσα διάχυση και παρουσιάστηκε πριν από λίγες εβδομάδες, ίσως αποτελεί μία από τις σημαντικότερες δημοσιοποιήσεις τεχνολογίας μετά το DeCSS το 1999· είναι σίγουρα το μεγαλύτερο γεγονός στις εικόνες που παράγονται με AI μετά το 2017, όταν ο κώδικας των deepfakes αντιγράφηκε στο GitHub και διακλαδώθηκε σε αυτό που θα γινόταν DeepFaceLab και FaceSwap, καθώς και στο λογισμικό ζωντανής μετάδοσης deepfake σε πραγματικό χρόνο DeepFaceLive.
Μεμιάς, η απογοήτευση των χρηστών για τους περιορισμούς περιεχομένου του API σύνθεσης εικόνων του DALL-E 2 παραμερίστηκε, καθώς διαπιστώθηκε ότι το φίλτρο NSFW του Stable Diffusion μπορούσε να απενεργοποιηθεί αλλάζοντας μία μόνο γραμμή κώδικα. Κοινότητες του Reddit για πορνογραφικές δημιουργίες με Stable Diffusion εμφανίστηκαν σχεδόν αμέσως και έκλεισαν εξίσου γρήγορα, ενώ προγραμματιστές και χρήστες χωρίστηκαν στο Discord σε επίσημες κοινότητες και κοινότητες NSFW. Το Twitter άρχισε να γεμίζει με φανταστικές δημιουργίες του Stable Diffusion.
Αυτή τη στιγμή κάθε μέρα φαίνεται να φέρνει κάποια εκπληκτική καινοτομία από προγραμματιστές που υιοθέτησαν το σύστημα, με πρόσθετα και συμπληρωματικά εργαλεία τρίτων να γράφονται βιαστικά για τα Krita, Photoshop, Cinema4D, Blenderκαι πολλές άλλες πλατφόρμες εφαρμογών.
Στο μεταξύ, η τέχνη διαμόρφωσης προτροπών —η πλέον επαγγελματική τέχνη του «ψιθυριστή της AI», η οποία ίσως αποδειχθεί η συντομότερη επιλογή καριέρας μετά τον «οργανωτή Filofax»— ήδη εμπορευματοποιείται, ενώ η αρχική αξιοποίηση του Stable Diffusion για έσοδα γίνεται στο επίπεδο του Patreon. Είναι βέβαιο ότι θα ακολουθήσουν πιο εξελιγμένες υπηρεσίες για όσους δεν θέλουν να αντιμετωπίσουν εγκαταστάσεις μέσω Conda του πηγαίου κώδικα ή τα περιοριστικά φίλτρα NSFW των διαδικτυακών υλοποιήσεων.
Ο ρυθμός ανάπτυξης και η ελεύθερη εξερεύνηση των χρηστών προχωρούν τόσο ιλιγγιωδώς ώστε είναι δύσκολο να δούμε πολύ μπροστά. Ουσιαστικά, δεν ξέρουμε ακόμη ακριβώς με τι έχουμε να κάνουμε ή ποιες μπορεί να είναι όλες οι δυνατότητες και οι περιορισμοί.
Ας δούμε, ωστόσο, τρία από τα πιθανώς πιο ενδιαφέροντα και απαιτητικά εμπόδια που καλείται να αντιμετωπίσει και, ελπίζουμε, να ξεπεράσει η κοινότητα του Stable Diffusion, η οποία συγκροτήθηκε και αναπτύσσεται ταχύτατα.
1: Βελτιστοποίηση ροών επεξεργασίας με πλακίδια εικόνας
Με περιορισμένους πόρους υλικού και αυστηρά όρια στην ανάλυση των εικόνων εκπαίδευσης, φαίνεται πιθανό οι προγραμματιστές να βρουν παρακάμψεις για να βελτιώσουν τόσο την ποιότητα όσο και την ανάλυση των αποτελεσμάτων του Stable Diffusion. Πολλά τέτοια έργα θα αξιοποιήσουν τους περιορισμούς του συστήματος, όπως την εγγενή ανάλυση μόλις 512×512 pixel.
Όπως συμβαίνει συνήθως στην υπολογιστική όραση και τη σύνθεση εικόνων, το Stable Diffusion εκπαιδεύτηκε σε τετραγωνικές εικόνες, εδώ επαναδειγματοληπτημένες σε 512×512, ώστε να τυποποιηθούν οι πηγαίες εικόνες και να χωρέσουν στους περιορισμούς των GPU της εκπαίδευσης.
Επομένως, το Stable Diffusion «σκέφτεται» —αν σκέφτεται— σε όρους 512×512 και σίγουρα τετραγώνου. Πολλοί χρήστες που διερευνούν τα όριά του αναφέρουν ότι δίνει τα πιο αξιόπιστα αποτελέσματα με τα λιγότερα σφάλματα σε αυτή την περιορισμένη αναλογία διαστάσεων (βλ. παρακάτω τα προβλήματα με τα άκρα).
Παρότι διάφορες υλοποιήσεις διαθέτουν αύξηση ανάλυσης μέσω RealESRGAN (και επιδιόρθωση κακοσχηματισμένων προσώπων μέσω GFPGAN) αρκετοί χρήστες αναπτύσσουν μεθόδους διαίρεσης των εικόνων σε τμήματα 512×512 pixel και συρραφής τους σε μεγαλύτερες συνθέσεις.

Αυτή η απόδοση 1024×576, ανάλυση συνήθως αδύνατη σε μία απόδοση Stable Diffusion, δημιουργήθηκε με αντιγραφή και επικόλληση του αρχείου Python attention.py από τη διακλάδωση DoggettX του Stable Diffusion, η οποία εφαρμόζει αύξηση ανάλυσης με πλακίδια, σε άλλη διακλάδωση. Πηγή: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Παρότι ορισμένες τέτοιες πρωτοβουλίες χρησιμοποιούν πρωτότυπο κώδικα ή άλλες βιβλιοθήκες, η μεταφορά txt2imghd του GOBIG, μιας λειτουργίας του απαιτητικού σε VRAM ProgRockDiffusion, αναμένεται να φέρει σύντομα αυτή τη δυνατότητα στον κύριο κλάδο. Ενώ το txt2imghd είναι ειδική μεταφορά του GOBIG, άλλες προσπάθειες της κοινότητας χρησιμοποιούν διαφορετικές υλοποιήσεις του.

Μια αφηρημένη εικόνα που εξυπηρετεί το παράδειγμα, στην αρχική απόδοση 512×512 pixel (αριστερά και δεύτερη από αριστερά), με αύξηση ανάλυσης μέσω ESGRAN, το οποίο πλέον είναι σχεδόν ενσωματωμένο σε όλες τις διανομές Stable Diffusion. Μια υλοποίηση GOBIG της έδωσε «ειδική προσοχή», παράγοντας λεπτομέρειες που φαίνονται καλύτερα μεγεθυμένες, τουλάχιστον εντός του συγκεκριμένου τμήματος. Πηγή: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Το παραπάνω αφηρημένο παράδειγμα έχει πολλά «μικρά βασίλεια» λεπτομερειών που ταιριάζουν σε αυτή την αυτοαναφορική προσέγγιση μεγέθυνσης. Μπορεί όμως να χρειαστούν πιο απαιτητικές λύσεις μέσω κώδικα για μη επαναλαμβανόμενη, συνεκτική μεγέθυνση που δεν μοιάζει να έχει συναρμολογηθεί από πολλά κομμάτια. Ιδίως στα ανθρώπινα πρόσωπα, είμαστε ιδιαίτερα ευαίσθητοι σε παραμορφώσεις και ενοχλητικά τεχνουργήματα. Επομένως, τα πρόσωπα ίσως τελικά χρειάζονται ειδική λύση.
Το Stable Diffusion δεν διαθέτει ακόμη μηχανισμό εστίασης της προσοχής στο πρόσωπο κατά την απόδοση όπως οι άνθρωποι δίνουν προτεραιότητα στις πληροφορίες του προσώπου. Παρότι ορισμένοι προγραμματιστές στο Discord εξετάζουν μεθόδους τέτοιας «ενισχυμένης προσοχής», είναι πολύ ευκολότερο τώρα να βελτιώνεται το πρόσωπο χειροκίνητα, και αργότερα αυτόματα, μετά την αρχική απόδοση.
Το ανθρώπινο πρόσωπο έχει εσωτερική και ολοκληρωμένη σημασιολογική λογική που δεν υπάρχει σε ένα «πλακίδιο» της κάτω γωνίας ενός κτιρίου, για παράδειγμα. Έτσι είναι πλέον δυνατό να μεγεθυνθεί και να αποδοθεί ξανά αποτελεσματικά ένα πρόχειρα σχεδιασμένο πρόσωπο στο αποτέλεσμα του Stable Diffusion.

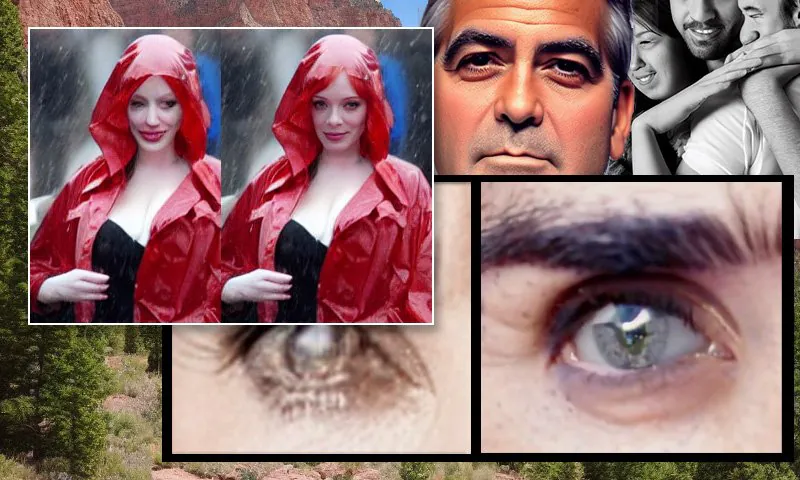
Αριστερά: η αρχική προσπάθεια του Stable Diffusion με την προτροπή ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. Δεξιά: βελτιωμένο πρόσωπο, δίνοντας μέσω Img2Img την πλήρη προσοχή του Stable Diffusion στο θολό και πρόχειρο πρόσωπο της πρώτης απόδοσης (βλ. κινούμενες εικόνες παρακάτω).
Χωρίς ειδική λύση Textual Inversion (βλ. παρακάτω), αυτό λειτουργεί μόνο για εικόνες διασημοτήτων με ήδη καλή εκπροσώπηση στα υποσύνολα LAION που εκπαίδευσαν το Stable Diffusion. Έτσι λειτουργεί για τους Tom Cruise, Brad Pitt, Jennifer Lawrence και περιορισμένο αριθμό πραγματικών διασημοτήτων των μέσων, των οποίων πολλές εικόνες υπάρχουν στα πηγαία δεδομένα.
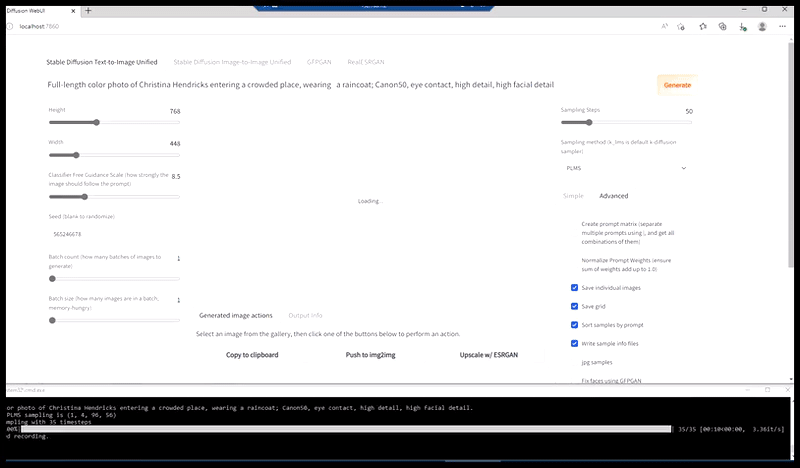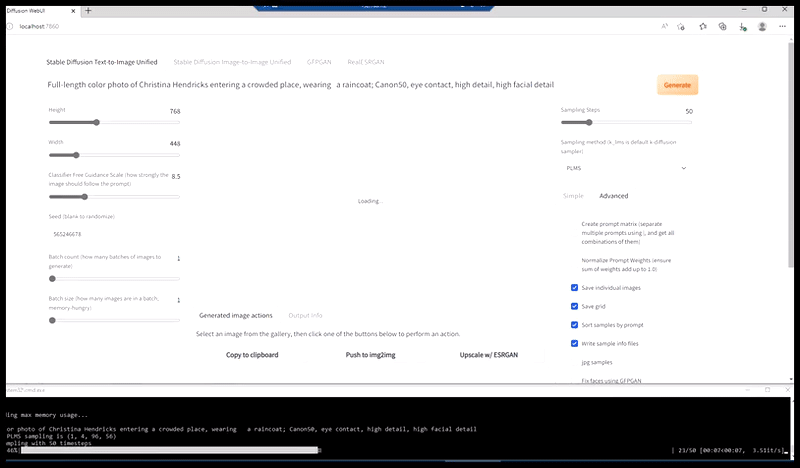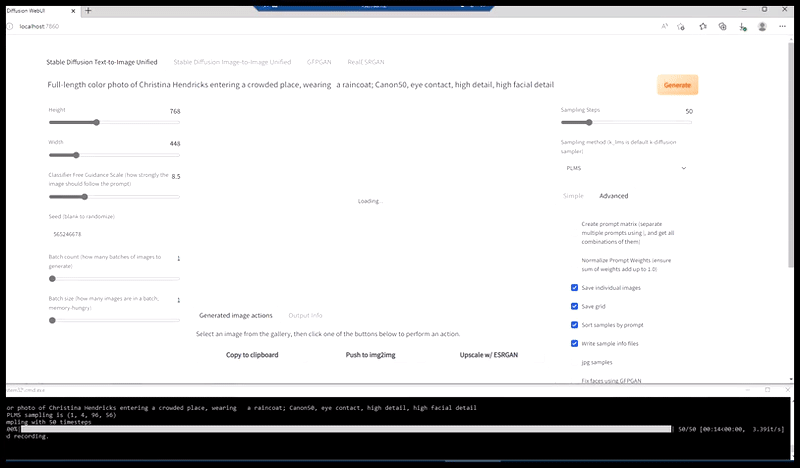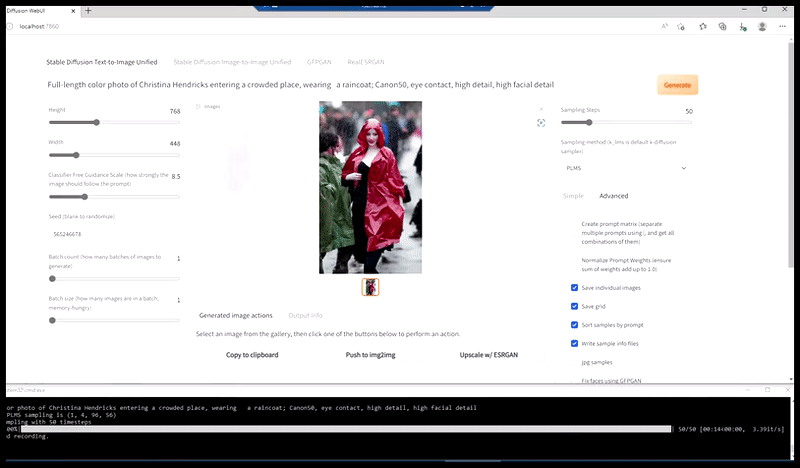
Παραγωγή πειστικής φωτογραφίας Τύπου με την προτροπή ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
Για διασημότητες με μακρόχρονη, διαρκή καριέρα, το Stable Diffusion συνήθως παράγει εικόνα τους σε πρόσφατη, δηλαδή μεγαλύτερη, ηλικία. Χρειάζονται προσθήκες στην προτροπή όπως ‘young’ ή ‘in the year [YEAR]’ για εικόνες νεότερης εμφάνισης.

Με διακεκριμένη, πολυφωτογραφημένη και συνεπή καριέρα σχεδόν 40 ετών, η Jennifer Connelly είναι μία από τις λίγες διασημότητες του LAION που επιτρέπουν στο Stable Diffusion να αποδώσει πολλές ηλικίες. Πηγή: τοπικό, έτοιμο πακέτο Stable Diffusion, checkpoint v1.4· προτροπές σχετικές με ηλικία.
Αυτό οφείλεται σε μεγάλο βαθμό στην εξάπλωση της ψηφιακής φωτογραφίας Τύπου, αντί της ακριβής φωτογραφίας με φωτογραφικό γαλάκτωμα, από τα μέσα της δεκαετίας του 2000 και στην κατοπινή αύξηση του όγκου εικόνων λόγω μεγαλύτερων ευρυζωνικών ταχυτήτων.
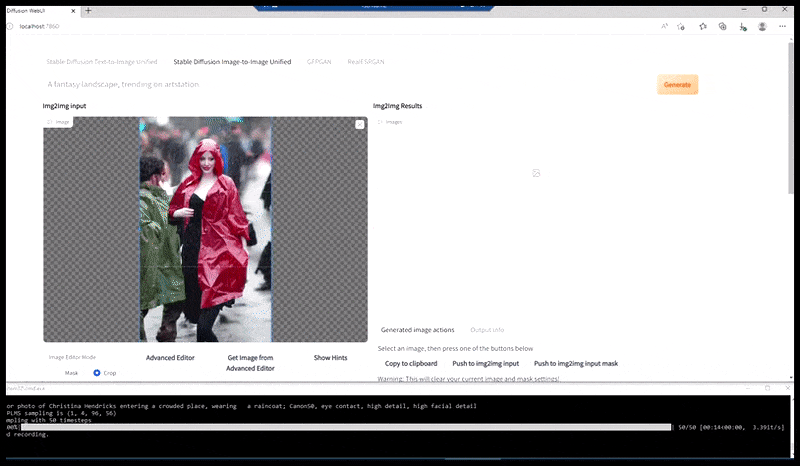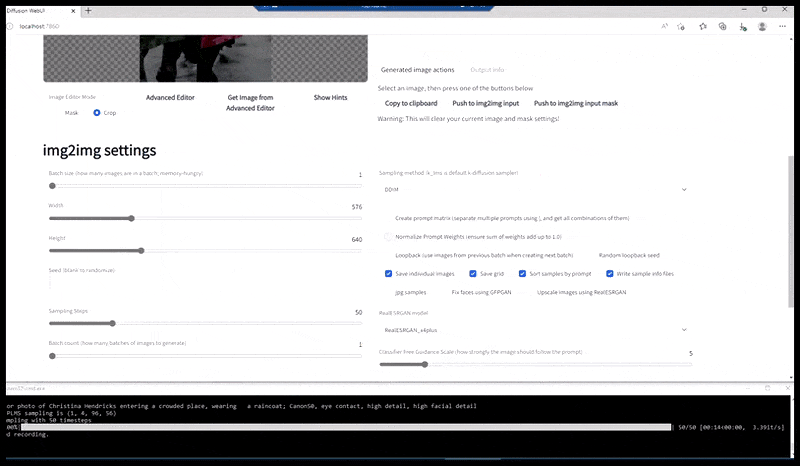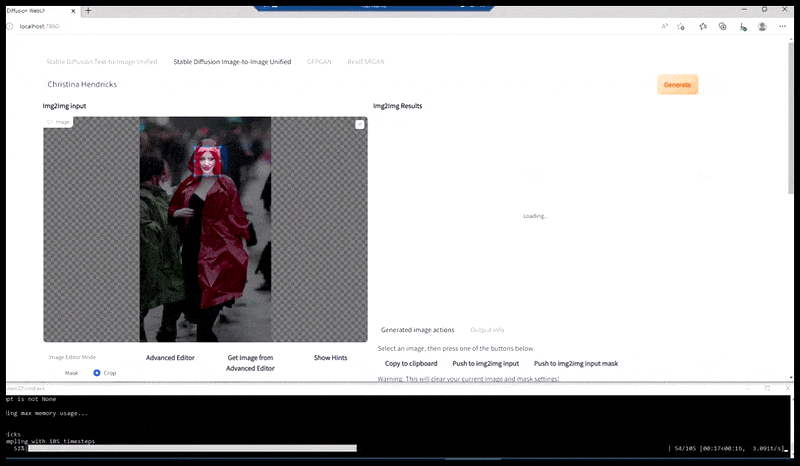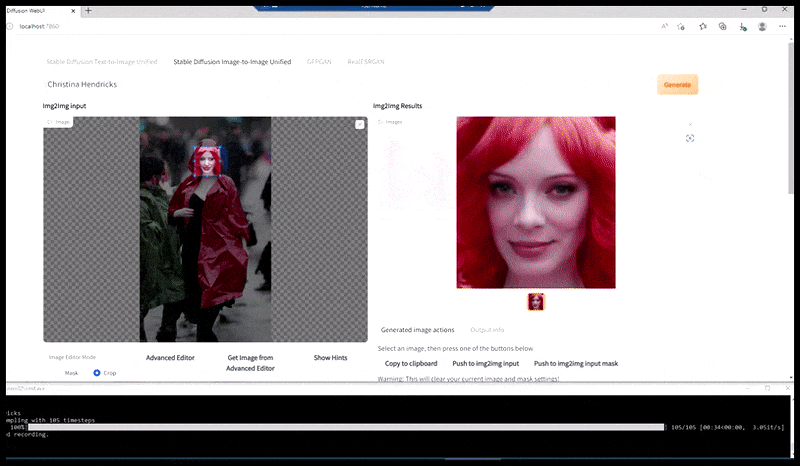
Η παραγόμενη εικόνα περνά στο Img2Img του Stable Diffusion, όπου επιλέγεται μια «περιοχή εστίασης» και δημιουργείται νέα απόδοση μέγιστου μεγέθους μόνο γι’ αυτήν. Έτσι το Stable Diffusion διαθέτει όλους τους πόρους στην αναδημιουργία του προσώπου.
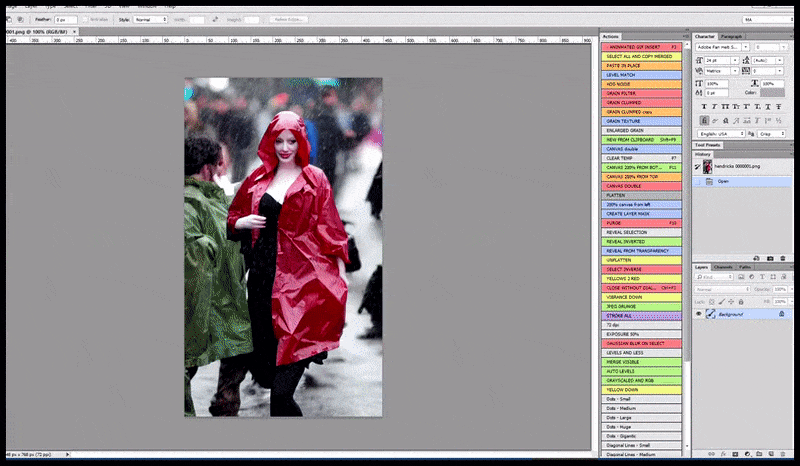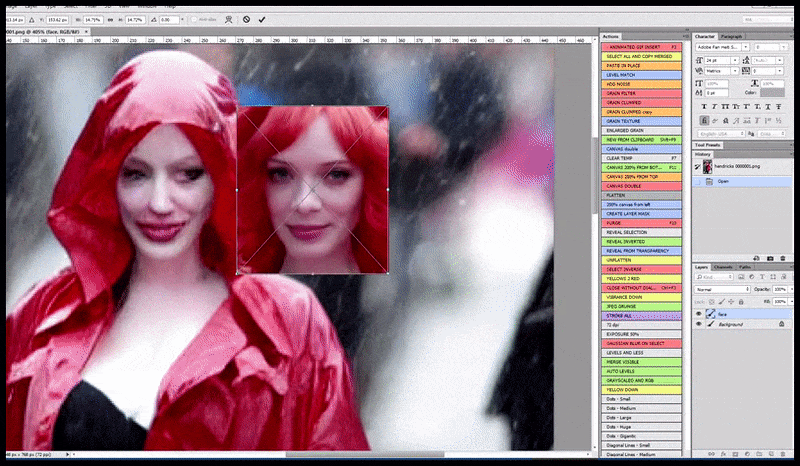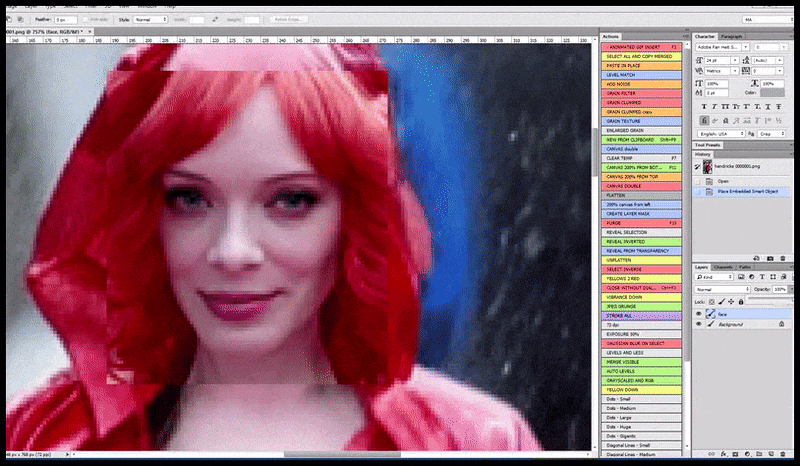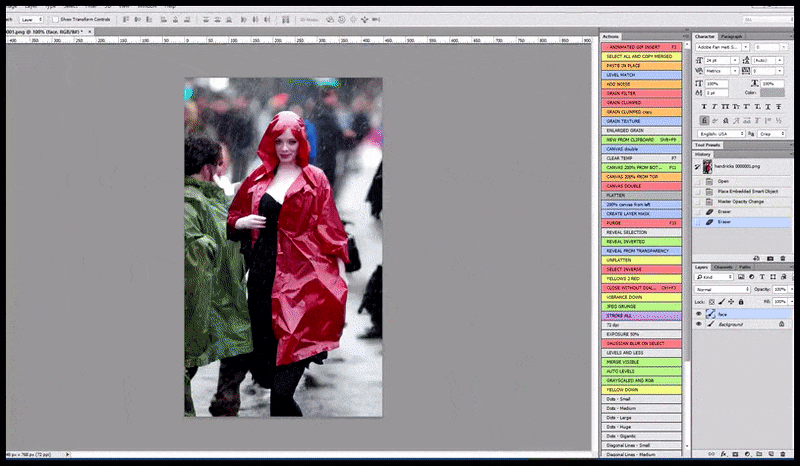
Σύνθεση του προσώπου που έλαβε «υψηλή προσοχή» πίσω στην αρχική απόδοση. Πέρα από πρόσωπα, η διαδικασία λειτουργεί μόνο για οντότητες με δυνητικά γνωστή, συνεκτική και ολοκληρωμένη εμφάνιση, όπως τμήμα της αρχικής φωτογραφίας που περιέχει διακριτό αντικείμενο, π.χ. ρολόι ή αυτοκίνητο. Η μεγέθυνση τμήματος ενός τοίχου θα οδηγήσει σε πολύ παράξενο ανασυντεθειμένο τοίχο, επειδή κατά την απόδοση των πλακιδίων έλειπε το ευρύτερο πλαίσιο για αυτό το «κομμάτι του παζλ».
Ορισμένες διασημότητες στη βάση δεδομένων είναι ήδη «παγωμένες» στον χρόνο, είτε επειδή πέθαναν νέες, όπως η Marilyn Monroe, είτε επειδή έγιναν ευρέως γνωστές μόνο για λίγο, παράγοντας πολλές εικόνες σε περιορισμένο διάστημα. Η διερεύνηση του Stable Diffusion μπορεί να θεωρηθεί ένα είδος «τρέχοντος» δείκτη δημοτικότητας σύγχρονων και παλαιότερων σταρ. Για ορισμένες παλαιότερες και σημερινές διασημότητες δεν υπάρχουν αρκετές πηγαίες εικόνες για πολύ καλή ομοιότητα, ενώ η διαρκής δημοτικότητα συγκεκριμένων σταρ που πέθαναν προ πολλού ή έπαψαν να προβάλλονται επιτρέπει στο σύστημα να αποδώσει εύλογη ομοιότητά τους.

Οι αποδόσεις του Stable Diffusion αποκαλύπτουν γρήγορα ποια διάσημα πρόσωπα εκπροσωπούνται καλά στα δεδομένα εκπαίδευσης. Παρά την τεράστια δημοτικότητά της ως μεγαλύτερης έφηβης την εποχή συγγραφής, η Millie Bobby Brown ήταν νεότερη και λιγότερο γνωστή όταν συλλέχθηκαν από το διαδίκτυο τα πηγαία δεδομένα LAION, κάτι που δυσκολεύει ακόμη την παραγωγή πολύ πιστής ομοιότητας.
Όταν υπάρχουν δεδομένα, οι λύσεις αύξησης ανάλυσης με πλακίδια στο Stable Diffusion θα μπορούσαν να προχωρήσουν πέρα από την εστίαση στο πρόσωπο. Διαχωρίζοντας τα χαρακτηριστικά του και αφιερώνοντας όλη την ισχύ των τοπικών GPU σε κάθε σημαντικό χαρακτηριστικό ξεχωριστά πριν από την ανασύνθεση, θα μπορούσαν να δώσουν ακόμη ακριβέστερα και λεπτομερέστερα πρόσωπα. Και αυτή η διαδικασία παραμένει χειροκίνητη.

Αυτό δεν περιορίζεται στα πρόσωπα, αλλά αφορά τμήματα αντικειμένων που βρίσκονται τουλάχιστον εξίσου προβλέψιμα μέσα στο ευρύτερο πλαίσιο του αντικειμένου και αντιστοιχούν σε αναπαραστάσεις υψηλού επιπέδου που εύλογα αναμένονται σε σύνολο δεδομένων τεράστιας κλίμακας.
Το πραγματικό όριο είναι η ποσότητα διαθέσιμων δεδομένων αναφοράς: τελικά, οι λεπτομέρειες μετά από πολλές επαναλήψεις θα γίνουν εντελώς «παραισθητικές», δηλαδή επινοημένες, και λιγότερο αυθεντικές.
Τέτοιες μεγεθύνσεις σε τόσο λεπτομερές επίπεδο λειτουργούν για την Jennifer Connelly επειδή εκπροσωπείται καλά σε πολλές ηλικίες στο LAION-aesthetics , το κύριο υποσύνολο του LAION 5B που χρησιμοποιεί το Stable Diffusion, και γενικότερα στο LAION. Σε πολλές άλλες περιπτώσεις, η ακρίβεια θα υποφέρει λόγω έλλειψης δεδομένων, απαιτώντας λεπτομερή προσαρμογή, δηλαδή πρόσθετη εκπαίδευση (βλ. «Προσαρμογή» παρακάτω), ή Textual Inversion (βλ. παρακάτω).
Τα πλακίδια είναι ισχυρός και σχετικά φθηνός τρόπος παραγωγής αποτελεσμάτων υψηλής ανάλυσης με Stable Diffusion. Ωστόσο, τέτοια αλγοριθμική μεγέθυνση, χωρίς ευρύτερο μηχανισμό προσοχής υψηλότερου επιπέδου, μπορεί να αποτύχει να καλύψει τα αναμενόμενα πρότυπα σε διάφορους τύπους περιεχομένου.
2: Αντιμετώπιση προβλημάτων με τα ανθρώπινα άκρα
Το Stable Diffusion δεν δικαιώνει το όνομά του όταν απεικονίζει την πολυπλοκότητα των ανθρώπινων άκρων. Χέρια πολλαπλασιάζονται τυχαία, δάχτυλα συγχωνεύονται, εμφανίζονται απρόσκλητα τρίτα πόδια και υπάρχοντα άκρα εξαφανίζονται χωρίς ίχνος. Προς υπεράσπισή του, μοιράζεται το πρόβλημα με άλλα παρόμοια μοντέλα και ασφαλώς με το DALL-E 2.

Ανεπεξέργαστα αποτελέσματα από DALL-E 2 και Stable Diffusion (1.4) στα τέλη Αυγούστου 2022, και τα δύο με προβλήματα στα άκρα. Η προτροπή είναι ‘A woman embracing a man’.
Οι φίλοι του Stable Diffusion που ελπίζουν ότι το επερχόμενο checkpoint 1.5, μια εντατικότερα εκπαιδευμένη έκδοση με βελτιωμένες παραμέτρους, θα λύσει τη σύγχυση των άκρων μάλλον θα απογοητευτούν. Το νέο μοντέλο, που θα κυκλοφορήσει σε περίπου δύο εβδομάδες, παρουσιάζεται ήδη στη διαδικτυακή εμπορική πύλη της stability.ai DreamStudio, η οποία χρησιμοποιεί το 1.5 από προεπιλογή. Εκεί οι χρήστες μπορούν να συγκρίνουν τα νέα αποτελέσματα με αποδόσεις από τοπικά ή άλλα συστήματα 1.4:

Πηγή: τοπικό έτοιμο πακέτο 1.4 και https://beta.dreamstudio.ai/

Πηγή: τοπικό έτοιμο πακέτο 1.4 και https://beta.dreamstudio.ai/

Πηγή: τοπικό έτοιμο πακέτο 1.4 και https://beta.dreamstudio.ai/
Όπως συμβαίνει συχνά, η ποιότητα των δεδομένων μπορεί να είναι ο κύριος συντελεστής του προβλήματος.
Οι ανοικτές βάσεις δεδομένων που τροφοδοτούν συστήματα σύνθεσης εικόνων, όπως Stable Diffusion και DALL-E 2, μπορούν να δίνουν πολλές ετικέτες για μεμονωμένους ανθρώπους και αλληλεπιδράσεις μεταξύ τους. Αυτές εκπαιδεύονται συμβιωτικά με τις σχετικές εικόνες ή τμήματά τους.

Οι χρήστες του Stable Diffusion μπορούν να εξερευνήσουν τις έννοιες που έμαθε το μοντέλο αναζητώντας στο LAION-aesthetics, υποσύνολο του μεγαλύτερου LAION 5B που τροφοδοτεί το σύστημα. Οι εικόνες ταξινομούνται με βάση το «αισθητικό σκορ» και όχι αλφαβητικά βάσει ετικετών. Πηγή: https://rom1504.github.io/clip-retrieval/
Μια καλή ιεραρχία μεμονωμένων ετικετών και κλάσεων που συμβάλλουν στην απεικόνιση ενός ανθρώπινου βραχίονα θα ήταν κάπως έτσι: body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

Λεπτομερής σημασιολογική τμηματοποίηση των μερών ενός χεριού. Ακόμη και αυτή η ασυνήθιστα αναλυτική αποδόμηση αφήνει κάθε «δάχτυλο» ως ενιαία οντότητα, χωρίς να συνυπολογίζει τα τρία τμήματα ενός δαχτύλου και τα δύο του αντίχειρα. Πηγή: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
Στην πραγματικότητα, οι πηγαίες εικόνες μάλλον δεν έχουν τόσο συνεπή επισημείωση σε ολόκληρο το σύνολο δεδομένων. Οι αλγόριθμοι μη επιβλεπόμενης επισήμανσης πιθανότατα σταματούν στο υψηλότερο επίπεδο, π.χ. «χέρι», αφήνοντας τα εσωτερικά pixel —που τεχνικά περιέχουν πληροφορίες για δάχτυλα— ως μάζα χωρίς ετικέτες. Από αυτήν εξάγονται αυθαίρετα χαρακτηριστικά που σε μεταγενέστερες αποδόσεις μπορεί να εμφανιστούν ως ενοχλητικά στοιχεία.

Όπως θα έπρεπε να είναι (πάνω δεξιά, αν δεν είναι άπερκατ) και όπως συνήθως είναι (κάτω δεξιά), λόγω περιορισμένων πόρων επισήμανσης ή της αρχιτεκτονικής αξιοποίησης τέτοιων ετικετών, εφόσον υπάρχουν στα δεδομένα.
Έτσι, αν ένα μοντέλο λανθάνουσας διάχυσης φτάσει να αποδώσει βραχίονα, σχεδόν σίγουρα θα επιχειρήσει να αποδώσει χέρι στην άκρη του, επειδή το arm>hand είναι η ελάχιστη απαραίτητη ιεραρχία, αρκετά ψηλά σε όσα γνωρίζει η αρχιτεκτονική για την «ανθρώπινη ανατομία».
Έπειτα, τα «δάχτυλα» μπορεί να είναι η μικρότερη ομάδα, παρότι υπάρχουν ακόμη 14 υποτμήματα δαχτύλων και αντίχειρα που πρέπει να ληφθούν υπόψη στην απεικόνιση χεριών.
Αν ισχύει αυτή η θεωρία, δεν υπάρχει πραγματική θεραπεία, λόγω της έλλειψης κονδυλίων για χειροκίνητη επισημείωση σε όλο τον κλάδο και επαρκώς αποτελεσματικών αλγορίθμων που να αυτοματοποιούν την επισήμανση με χαμηλά ποσοστά σφάλματος. Ίσως το μοντέλο βασίζεται τώρα στην ανατομική συνέπεια των ανθρώπων για να καλύπτει τις αδυναμίες του συνόλου εκπαίδευσης.
Ένας πιθανός λόγος που δεν μπορεί να βασιστεί σε αυτό, όπως πρόσφατα προτάθηκε στο Discord του Stable Diffusion, είναι η σύγχυση για τον σωστό αριθμό δαχτύλων ενός ρεαλιστικού ανθρώπινου χεριού: η βάση LAION που τροφοδοτεί το μοντέλο περιλαμβάνει χαρακτήρες κινουμένων σχεδίων με λιγότερα δάχτυλα (κάτι που από μόνο του αποτελεί συντόμευση για εξοικονόμηση εργασίας).

Δύο πιθανοί υπαίτιοι για το σύνδρομο «χαμένων δαχτύλων» στο Stable Diffusion και παρόμοια μοντέλα. Κάτω: παραδείγματα χεριών κινουμένων σχεδίων από το LAION-aesthetics που τροφοδοτεί το Stable Diffusion. Πηγή: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Αν αυτό ισχύει, η μόνη προφανής λύση είναι επανεκπαίδευση χωρίς μη ρεαλιστικό ανθρωπόμορφο περιεχόμενο, με κατάλληλη επισήμανση πραγματικών περιπτώσεων απουσίας άκρων, π.χ. ακρωτηριασμένων ανθρώπων, ως εξαιρέσεων. Ακόμη και μόνο ως επιμέλεια δεδομένων, αυτό θα ήταν μεγάλη πρόκληση, ιδίως για κοινοτικές προσπάθειες με λίγους πόρους.
Η δεύτερη προσέγγιση είναι φίλτρα που αποκλείουν τέτοιο περιεχόμενο, π.χ. «χέρι με τρία/πέντε δάχτυλα», κατά την απόδοση, όπως το OpenAI έχει σε κάποιο βαθμό φιλτράρει το GPT-3 και το DALL-E 2, ώστε να ρυθμίζει τα αποτελέσματα χωρίς επανεκπαίδευση των πηγαίων μοντέλων.

Στο Stable Diffusion η σημασιολογική διάκριση μεταξύ δαχτύλων και ακόμη και άκρων μπορεί να θολώσει φρικτά, θυμίζοντας το ρεύμα «body horror» στις ταινίες τρόμου της δεκαετίας του 1980 από δημιουργούς όπως ο David Cronenberg. Πηγή: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Ωστόσο, και πάλι, αυτό απαιτεί ετικέτες που μπορεί να μην υπάρχουν για όλες τις σχετικές εικόνες, αφήνοντας την ίδια οργανωτική και δημοσιονομική πρόκληση.
Θα μπορούσε να υποστηριχθεί ότι απομένουν δύο δρόμοι: περισσότερα δεδομένα για το πρόβλημα και ερμηνευτικά συστήματα τρίτων που παρεμβαίνουν όταν τέτοια σωματικά λάθη παρουσιάζονται στον τελικό χρήστη. Τουλάχιστον το δεύτερο θα έδινε στο OpenAI τρόπο επιστροφής χρημάτων για αποδόσεις «body horror», εφόσον η εταιρεία επιθυμούσε να το κάνει.
3: Προσαρμογή
Μία από τις πιο συναρπαστικές προοπτικές για το Stable Diffusion είναι η ανάπτυξη τροποποιημένων συστημάτων από χρήστες ή οργανισμούς. Αυτά θα ενσωματώνουν περιεχόμενο έξω από το προεκπαιδευμένο πεδίο του LAION, ιδανικά χωρίς το ανεξέλεγκτο κόστος επανεκπαίδευσης ολόκληρου του μοντέλου ή τον κίνδυνο εκπαίδευσης με πολλές νέες εικόνες ενός ήδη ώριμου και ικανού μοντέλου.
Κατ’ αναλογία, αν δύο λιγότερο ταλαντούχοι μαθητές μπουν σε προχωρημένη τάξη τριάντα μαθητών, είτε θα προσαρμοστούν και θα συμβαδίσουν είτε θα αποτύχουν ως εξαιρέσεις. Και στις δύο περιπτώσεις ο μέσος όρος της τάξης μάλλον δεν θα αλλάξει. Αν όμως μπουν 15 τέτοιοι μαθητές, η κατανομή των βαθμών όλης της τάξης πιθανότατα θα επηρεαστεί αρνητικά.
Αντίστοιχα, το συνεργατικό και λεπτό δίκτυο σχέσεων που δημιουργείται με διαρκή και δαπανηρή εκπαίδευση μπορεί να υπονομευθεί, ακόμη και να καταστραφεί ουσιαστικά σε ορισμένες περιπτώσεις, από υπερβολικά νέα δεδομένα, μειώνοντας συνολικά την ποιότητα των αποτελεσμάτων.
Το κύριο επιχείρημα υπέρ αυτής της προσέγγισης αφορά την περίπτωση που θέλετε να οικειοποιηθείτε πλήρως την εννοιολογική κατανόηση του μοντέλου για σχέσεις και πράγματα και να την αξιοποιήσετε αποκλειστικά για περιεχόμενο παρόμοιο με το πρόσθετο υλικό σας.
Έτσι, η εκπαίδευση με 500.000 καρέ από τους Simpsons σε υπάρχον checkpoint Stable Diffusion πιθανότατα θα δώσει τελικά καλύτερο προσομοιωτή Simpsons από την αρχική έκδοση, εφόσον επιβιώσουν αρκετές ευρείες σημασιολογικές σχέσεις (π.χ. Homer Simpson eating a hotdog, που μπορεί να απαιτεί δεδομένα για χοτ ντογκ τα οποία δεν υπήρχαν στο πρόσθετο υλικό αλλά υπήρχαν στο αρχικό checkpoint). Επίσης, με την προϋπόθεση ότι δεν θα θέλετε ξαφνικά να μεταβείτε από περιεχόμενο Simpsons στη δημιουργία fabulous landscape by Greg Rutkowski —επειδή η προσοχή του επιπλέον εκπαιδευμένου μοντέλου έχει εκτραπεί μαζικά και δεν θα κάνει πια τέτοια πράγματα τόσο καλά όσο πριν.
Ένα αξιοσημείωτο παράδειγμα είναι το waifu-diffusion, το οποίο πραγματοποίησε επιτυχώς πρόσθετη εκπαίδευση με 56.000 εικόνες anime σε ολοκληρωμένο και εκπαιδευμένο checkpoint Stable Diffusion. Για έναν ερασιτέχνη, όμως, είναι δύσκολο: απαιτούνται τουλάχιστον 30GB VRAM, πολύ περισσότερα από όσα πιθανώς θα προσφέρει η καταναλωτική κατηγορία της επερχόμενης σειράς NVIDIA 40XX.

Εκπαίδευση με προσαρμοσμένο περιεχόμενο στο Stable Diffusion μέσω waifu-diffusion: το μοντέλο χρειάστηκε δύο εβδομάδες πρόσθετης εκπαίδευσης για αυτό το επίπεδο εικονογράφησης. Οι έξι εικόνες αριστερά δείχνουν την πρόοδο κατά την εκπαίδευση στην παραγωγή αποτελεσμάτων με συνεκτικό θέμα βάσει των νέων δεδομένων. Πηγή: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Πολύς κόπος μπορεί να αναλωθεί σε τέτοιες διακλαδώσεις των checkpoint του Stable Diffusion, μόνο για να προσκρούσει στο τεχνικό χρέος. Οι προγραμματιστές στο επίσημο Discord έχουν ήδη αναφέρει ότι τα μεταγενέστερα checkpoint δεν θα είναι κατ’ ανάγκη συμβατά με τα παλαιότερα, ακόμη και ως προς τη λογική προτροπών που δούλευε πριν. Πρωταρχικός στόχος είναι το καλύτερο δυνατό μοντέλο, όχι η υποστήριξη παλιών εφαρμογών και διαδικασιών.
Επομένως, εταιρεία ή άτομο που διακλαδώνει ένα checkpoint σε εμπορικό προϊόν ουσιαστικά δεν έχει επιστροφή: το μοντέλο είναι πια «hard fork» και δεν θα μπορεί να αξιοποιεί βελτιώσεις από επόμενες εκδόσεις της stability.ai. Πρόκειται για σημαντική δέσμευση.
Η τρέχουσα και μεγαλύτερη ελπίδα για προσαρμογή του Stable Diffusion είναι το Textual Inversion, όπου ο χρήστης εκπαιδεύει με λίγες εικόνες ευθυγραμμισμένες με το CLIP.

Το Textual Inversion, συνεργασία του Πανεπιστημίου του Τελ Αβίβ με τη NVIDIA, επιτρέπει εκπαίδευση νέων, διακριτών οντοτήτων χωρίς να καταστρέφονται οι δυνατότητες του πηγαίου μοντέλου. Πηγή: https://textual-inversion.github.io/
Ο κύριος εμφανής περιορισμός του Textual Inversion είναι η σύσταση για πολύ λίγες εικόνες, ακόμη και μόνο πέντε. Έτσι δημιουργείται μια περιορισμένη οντότητα που ίσως είναι πιο χρήσιμη για μεταφορά ύφους παρά για εισαγωγή φωτορεαλιστικών αντικειμένων.
Ωστόσο, στα διάφορα Discord του Stable Diffusion διεξάγονται πειράματα με πολύ περισσότερες εικόνες εκπαίδευσης, και μένει να φανεί πόσο παραγωγική θα αποδειχθεί η μέθοδος. Και πάλι, απαιτούνται πολλή VRAM, χρόνος και υπομονή.
Λόγω αυτών των περιορισμών, ίσως περιμένουμε λίγο για πιο εξελιγμένα πειράματα Textual Inversion από τους φίλους του Stable Diffusion, και για να δούμε αν η προσέγγιση μπορεί να «σας βάλει στην εικόνα» καλύτερα από αποκοπή και επικόλληση στο Photoshop, διατηρώντας την εκπληκτική λειτουργικότητα των επίσημων checkpoint.
Πρώτη δημοσίευση: 6 Σεπτεμβρίου 2022.


