
Η γωνία του Anderson
Το GAN ως μηχανή απόδοσης προσώπων για «παραδοσιακά» CGI

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google

Βασικά σημείαΗ αποσύνδεση της ταυτότητας από την έκφραση στον λανθάνοντα χώρο των GAN παραμένει η…
Δείτε περισσότερα
- Η αποσύνδεση της ταυτότητας από την έκφραση στον λανθάνοντα χώρο των GAN παραμένει η κεντρική ανεπίλυτη πρόκληση για τη σύνθεση βίντεο προσώπου.
- Παραμετρικά μοντέλα CGI, όπως τα SMPL και 3DMM, χρησιμοποιούνται ολοένα και περισσότερο για να επιβάλουν τάξη στους απείθαρχους λανθάνοντες κώδικες των GAN.
- Η υβριδική προσέγγιση Rendering with Style της Disney παρήγαγε ανοίκεια αποτελέσματα συνδυάζοντας παραδοσιακούς χάρτες υφής με εικόνες που δημιουργήθηκαν από GAN.
Γνώμη Όταν τα Παραγωγικά Ανταγωνιστικά Δίκτυα (GANs) απέδειξαν για πρώτη φορά την ικανότητά τους να αναπαράγουν εντυπωσιακά ρεαλιστικά 3D πρόσωπα, η έναρξή τους προκάλεσε πυρετό έρευνας για το ανεκμετάλλευτο δυναμικό των GANs για τη δημιουργία χρονικά συνεπούς βίντεο με ανθρώπινα πρόσωπα.
Κάπου στον λανθάνοντα χώρο του GAN, φαινόταν ότι πρέπει να υπήρχε κρυφή τάξη και ορθολογισμός – μια αναδυόμενη μορφή σημασιολογικής λογικής, θαμμένο στους λανθάνοντες κωδικούς, που θα επέτρεπε σε ένα GAN να γεννήσει συνεπή πολλαπλές όψεις και αποδόσεις (όπως αλλαγές έκφρασης) του ίδιου προσώπου – και στη συνέχεια να προσφέρει μια χρονικά πειστική μέθοδο deepfake βίντεο που θα ξεπερνούσε κατά πολύ τους αυτοκωδικοποιητές.
Η υψηλή ανάλυση εξόδου θα ήταν εύκολη, σε σύγκριση με το χαμηλής ανάλυσης περιβάλλοντα στα οποία οι περιορισμοί GPU αναγκάζουν το DeepFaceLab και το FaceSwap να λειτουργούν, ενώ η “ζώνη ανταλλαγής” ενός προσώπου (σε εργασίες autoencoder) θα γινόταν η “ζώνη δημιουργίας” ενός GAN, καθοδηγούμενη από λίγες εικόνες εισόδου, ή ακόμη και μόνο μια εικόνα.
Δεν θα υπήρχε πλέον ασυμφωνία μεταξύ του προσώπου αντικατάστασης και του προσώπου υποδοχής, επειδή το σύνολο της εικόνας θα δημιουργούνταν από την αρχή, συμπεριλαμβανομένων μαλλιών, γνάθων και των εξωτερικότερων ακραίων των γραμμών του προσώπου, που συχνά αποδεικνύονται μια πρόκληση για τα “παραδοσιακά” autoencoder deepfakes.
Ο χειμώνας του βίντεο προσώπων με GAN
Όπως αποδείχθηκε, δεν θα ήταν τόσο εύκολο. Τελικά, η αποσύνδεση αποδείχθηκε το κεντρικό ζήτημα και παραμένει η κύρια πρόκληση. Πώς μπορείτε να διατηρήσετε μια διακριτή ταυτότητα προσώπου και να αλλάξετε την πόζα ή την έκφραση χωρίς να συλλέξετε μαζί ένα σώμα χιλιάδων εικόνων αναφοράς που διδάσκουν ένα νευρωνικό δίκτυο τι συμβαίνει όταν αυτές οι αλλαγές πραγματοποιούνται, όπως κάνουν τα συστήματα autoencoder;
Αντίθετα, η μεταγενέστερη σκέψη στην έρευνα κίνησης προσώπων με GAN και σύνθεσης ήταν ότι μια ταυτότητα εισόδου μπορεί να γίνει αντικείμενο τηλεολογικών, γενικών, προτυποποιημένων μετασχηματισμών που δεν είναι ειδικά για την ταυτότητα. Ένα παράδειγμα αυτού θα ήταν να εφαρμόσετε μια έκφραση σε ένα GAN πρόσωπο που δεν ήταν παρόν σε καμία από τις εικόνες του προσώπου που το GAN γνωρίζει.

Από το 2022 paper Tensor-based Emotion Editing in the StyleGAN Latent Space, προτυποποιημένες εκφράσεις εφαρμόζονται σε ένα εισαγόμενο πρόσωπο από το σύνολο δεδομένων FFHQ. Πηγή: https://arxiv.org/pdf/2205.06102.pdf
Είναι προφανές ότι μια “ένα μέγεθος ταιριάζει σε όλα” προσέγγιση δεν μπορεί να καλύψει την ποικιλία των εκφράσεων προσώπου που είναι μοναδικές για ένα άτομο. Πρέπει να αναρωτηθούμε αν ένα χαμόγελο τόσο μοναδικό όπως αυτό του Jack Nicholson ή του Willem Dafoe θα μπορούσε ποτέ να λάβει μια πιστή ερμηνεία υπό την επήρεια τέτοιων “μέσου όρου” λανθανόντων κωδικών.

Ποιος είναι αυτός ο χαριτωμένος Λατίνος ξένος; Αν και η μέθοδος GAN παράγει ένα πιο ρεαλιστικό και υψηλής ανάλυσης πρόσωπο, η μετασχηματισμός δεν ενημερώνεται από πολλαπλές πραγματικές εικόνες του ηθοποιού, όπως συμβαίνει με το DeepFaceLab, το οποίο εκπαιδεύεται εκτενώς σε μια βάση δεδομένων χιλιάδων τέτοιων εικόνων, και κατά συνέπεια η ομοιότητα είναι επηρεασμένη. Εδώ (πίσω) ένα μοντέλο DeepFaceLab εισάγεται στο DeepFaceLive, μια εφαρμογή ροής του δημοφιλούς και αμφιλεγόμενου λογισμικού. Παραδείγματα είναι από https://www.youtube.com/watch?v=9tr35y-yQRY (2022) και https://arxiv.org/pdf/2205.06102.pdf.
Πολλά εργαλεία επεξεργασίας εκφράσεων προσώπου με GAN έχουν προταθεί τα τελευταία χρόνια, τα περισσότερα από αυτά ασχολούνται με άγνωστες ταυτότητες, όπου η πιστότητα των μετασχηματισμών είναι αδύνατο για τον καθημερινό αναγνώστη να γνωρίζει,επειδή αυτά δεν είναι οικεία πρόσωπα.

Αγνωστες ταυτότητες μετασχηματίζονται στο 2020 Cascade-EF-GAN. Πηγή: https://arxiv.org/pdf/2003.05905.pdf
Ίσως το GAN face editor που έχει λάβει το μεγαλύτερο ενδιαφέρον (και παραπομπές) τα τελευταία τρία χρόνια είναι InterFaceGAN, το οποίο μπορεί να πραγματοποιεί διαδρομές στο λανθάνοντα χώρο που σχετίζονται με πόζα (γωνία της κάμερας/προσώπου), έκφραση, ηλικία, φυλή, φύλο και άλλα ουσιώδη χαρακτηριστικά.
Οι ικανότητες μορφοποίησης, τύπου δεκαετίας του 1980, του InterFaceGAN και παρόμοιων πλαισίων είναι κυρίως ένας τρόπος να εικονογραφηθεί η διαδρομή προς τη μετασχηματισμό ως μια εικόνα αναπροβάλλεται πίσω μέσω ενός κατάλληλου λανθάνοντος κωδικού (όπως “ηλικία”). Σε όρους παραγωγής βίντεο με χρονική συνέχεια, τέτοια σχήματα μέχρι τώρα έχουν προκύψει ως “εντυπωσιακές καταστροφές”.
Εάν προστεθεί σε αυτό η δυσκολία δημιουργίας χρονικά συνεπούς μαλλιών, και το γεγονός ότι η τεχνική της εξερεύνησης/χειραγώγησης του λανθάνοντος κωδικού δεν έχει κανένα εγγενή χρονικό οδηγό να εργαστεί με (και είναι δύσκολο να γνωρίζουμε πώς να ενσωματωθούν τέτοιοι οδηγοί σε ένα πλαίσιο που σχεδιάστηκε για να γεννήσει και να αναπαράγει εικόνες, και δεν έχει κανένα εγγενή πρόβλεψη για βίντεο εξόδου), μπορεί να είναι λογικό να συμπεράνουμε ότι το GAN δεν είναι το μόνο που χρειάζεται™ για τη σύνθεση βίντεο προσώπου.
Επομένως, μεταγενέστερες προσπάθειες έχουν οδηγήσει σε βελτιώσεις στην αποσύνδεση, ενώ άλλοι έχουν προσθέσει άλλες συμβάσεις στην υπολογιστική όραση ως “στρώμα οδηγίας”, όπως η χρήση της σημασιολογικής κατάτμησης ως μηχανισμού ελέγχου στα τέλη του 2021 μελέτη SemanticStyleGAN: Learning Compositional Generative Priors for Controllable Image Synthesis and Editing.
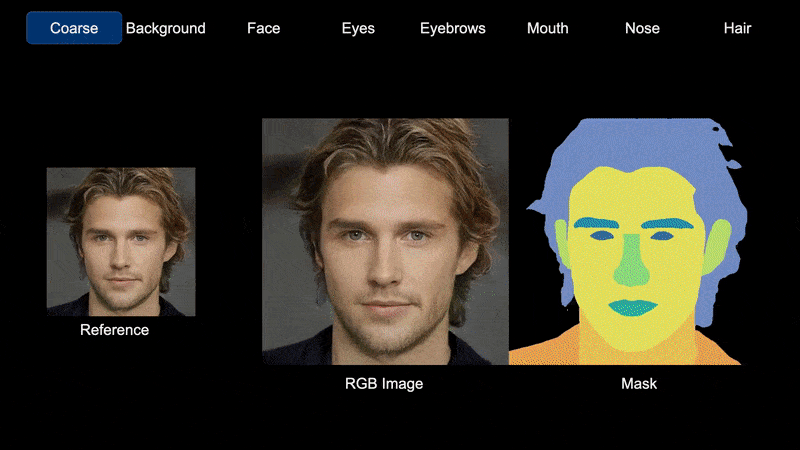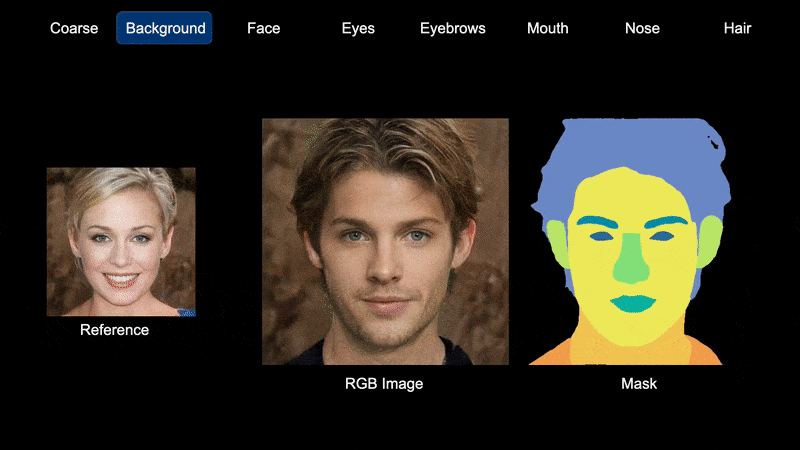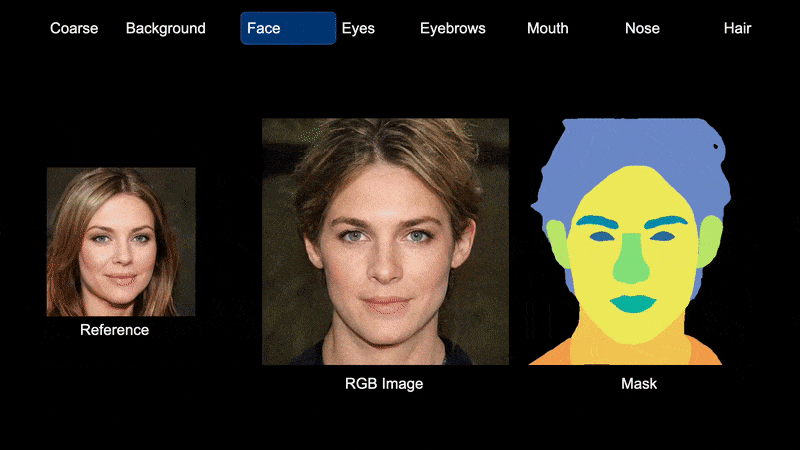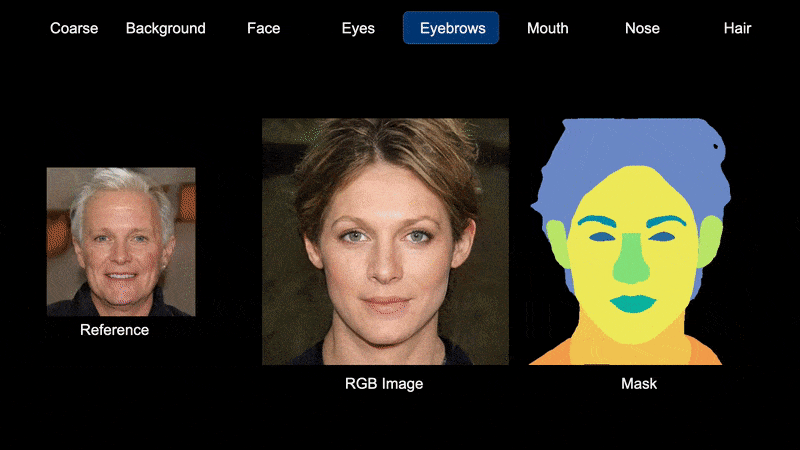
Η σημασιολογική κατάτμηση ως μέθοδος ελέγχου του λανθάνοντος χώρου στο SemanticStyleGAN. Πηγή: https://semanticstylegan.github.io/
Παραμετρική Οδηγία
Η έρευνα σύνθεσης προσώπων με GAN κατευθύνεται ολοένα και περισσότερο προς τη χρήση “παραδοσιακών” παραμετρικών προσώπων CGI ως μέθοδο για να οδηγήσει και να φέρει τάξη στους εντυπωσιακούς αλλά ανεξέλεγκτους λανθάνοντες κωδικούς στο λανθάνοντα χώρο του GAN.
Αν και τα παραμετρικά στοιχεία προσώπου έχουν υπάρξει ένα σταθερό στοιχείο της έρευνας υπολογιστικής όρασης για περισσότερα από είκοσι χρόνια, το ενδιαφέρον για αυτήν την προσέγγιση έχει αυξηθεί τελευταία, με την αυξημένη χρήση Skinned Multi-Person Linear Model (SMPL) παραμετρικών στοιχείων CGI, μια προσέγγιση που πρωτοπορήθηκε από το Max Planck Institute και ILM, και από τότε βελτιώθηκε με το Sparse Trained Articulated Human Body Regressor (STAR) πλαίσιο.

Το SMPL (σε αυτήν την περίπτωση μια παραλλαγή που ονομάζεται SMPL-X) μπορεί να επιβάλλει ένα παραμετρικό πλέγμα CGI που συμφωνεί με την εκτιμώμενη πόζα (συμπεριλαμβανομένων εκφράσεων, αν χρειάζεται) του συνόλου του ανθρώπινου σώματος που εμφανίζεται σε μια εικόνα, επιτρέποντας νέες λειτουργίες να εκτελεστούν στην εικόνα χρησιμοποιώντας το παραμετρικό πλέγμα ως οδηγό όγκου ή αντίληψης. Πηγή: https://arxiv.org/pdf/1904.05866.pdf
Η πιο διακεκριμένη ανάπτυξη σε αυτήν τη γραμμή ήταν η πρωτοβουλία Rendering with Style της Disney το 2019, η οποία συνδύασε τη χρήση παραδοσιακών χαρτών υφής με εικόνες GAN, σε μια προσπάθεια να δημιουργηθεί βελτιωμένη, “deepfake-στυλ” κινούμενη εικόνα:

Παλιό συναντά νέο, στην υβριδική προσέγγιση της Disney για δημιουργημένο από GAN deepfakes. Πηγή: https://www.youtube.com/watch?v=TwpLqTmvqVk
Η προσέγγιση της Disney επιβάλλει συμβατικά αποδοσμένα στοιχεία CGI σε ένα δίκτυο StyleGAN2 για να συμπληρώσει ανθρώπινα πρόσωπα σε “προβληματικές” περιοχές, όπου η χρονική συνέχεια είναι ένα ζήτημα για τη δημιουργία βίντεο – περιοχές όπως η υφή του δέρματος.

Η διαδικασία Rendering with Style.
Επειδή το παραμετρικό κεφάλι CGI που οδηγεί αυτήν τη διαδικασία μπορεί να τροποποιηθεί και να αλλάξει για να ταιριάξει με τον χρήστη, το δημιουργημένο από GAN πρόσωπο μπορεί να αντανακλά αυτές τις αλλαγές, συμπεριλαμβανομένων αλλαγών πόζας και έκφρασης.
Αν και σχεδιασμένο για να παντρεύσει την δυνατότητα ελέγχου του CGI με τον φυσικό ρεαλισμό των προσώπων GAN, τελικά, τα αποτελέσματα δείχνουν το χειρότερο των δύο κόσμων και ακόμη δεν μπορούν να διατηρήσουν τη υφή μαλλιών και ακόμη και βασικές θέσεις χαρακτηριστικών:
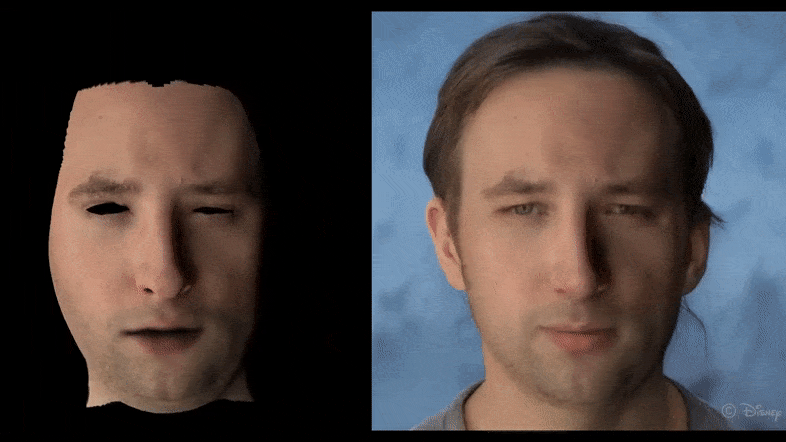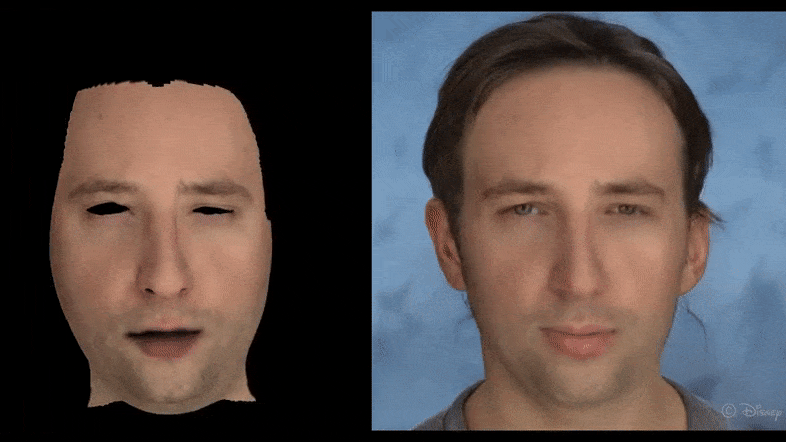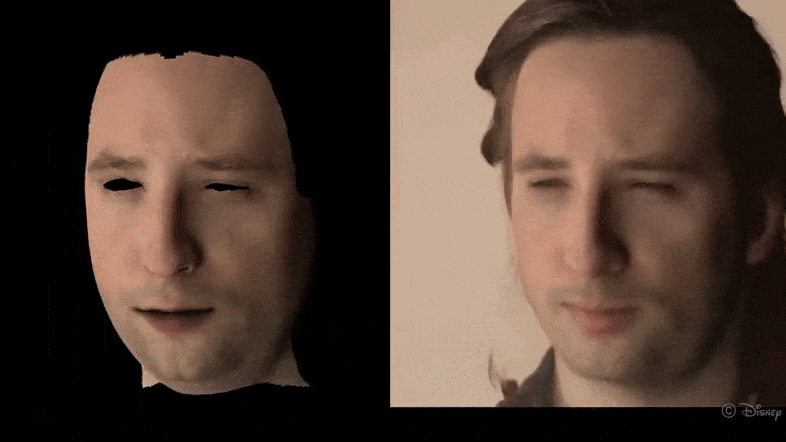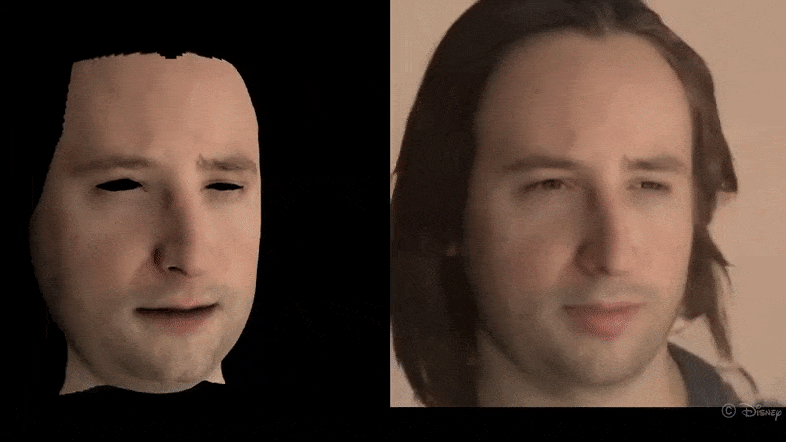
Μια νέα μορφή κοιλάδας του αλλόκοτου προκύπτει από το Rendering with Style, αν και η αρχή εξακολουθεί να έχει κάποιο δυναμικό.
Το 2020 μελέτη StyleRig: Rigging StyleGAN για 3D έλεγχο πάνω σε εικόνες πορτρέτου ακολουθεί μια ολοένα και πιο δημοφιλή προσέγγιση, με τη χρήση τρισδιάστατων μοντέλων προσώπου (3DMMs) ως ενδιάμεσα μοντέλα για αλλαγή χαρακτηριστικών σε ένα περιβάλλον StyleGAN, σε αυτήν την περίπτωση μέσω ενός νέου δικτύου ελέγχου που ονομάζεται RigNet:

Τα 3DMM χρησιμοποιούνται ως ενδιάμεσα μοντέλα για ερμηνείες του λανθάνοντος χώρου στο StyleRig. Πηγή: https://arxiv.org/pdf/2004.00121.pdf
Ωστόσο, όπως συνήθως με αυτές τις πρωτοβουλίες, τα αποτελέσματα μέχρι τώρα φαίνονται περιορισμένα σε ελάχιστες αλλαγές πόζας και αλλαγές έκφρασης ή συναισθηματικής κατάστασης χωρίς σχετική καθοδήγηση.

Το StyleRig βελτιώνει το επίπεδο ελέγχου, αν και η χρονικά συνεχής υφή μαλλιών παραμένει μια ανεπίλυτη πρόκληση. Πηγή: https://www.youtube.com/watch?v=eaW_P85wQ9k
Παρόμοια αποτελέσματα μπορεί να βρεθεί από το MOST-GAN της Mitsubishi Research, ένα 2021 μελέτη που χρησιμοποιεί μη γραμμικά 3DMMs ως αρχιτεκτονική αποσύνδεσης, αλλά που επίσης παλεύει να επιτύχει δυναμική και συνεχή κίνηση.
Η τελευταία έρευνα που προσπαθεί να επιτύχει έλεγχο και διαχωρισμό παραγόντων είναι το One-Shot Face Reenactment on Megapixels, το οποίο χρησιμοποιεί παραμετρικά κεφάλια 3DMM ως εύχρηστη διεπαφή για το StyleGAN.

Στην διαδικασία MegaFR του One-Shot Face Reenactment, το δίκτυο εκτελεί σύνθεση προσώπου συνδυάζοντας μια πραγματική εικόνα που έχει αναχθεί στη λανθάνουσα αναπαράσταση με παραμέτρους που λαμβάνονται από ένα αποδοσμένο μοντέλο 3DMM. Πηγή: https://arxiv.org/pdf/2205.13368.pdf
Το OSFR ανήκει σε μια αυξανόμενη κατηγορία εργαλείων επεξεργασίας προσώπων με GAN που προσπαθούν να αναπτύξουν γραμμικές ροές επεξεργασίας τύπου Photoshop/After Effects όπου ο χρήστης μπορεί να εισάγει μια επιθυμητή εικόνα στην οποία μπορούν να εφαρμοστούν μετασχηματισμοί, αντί να ψάχνει στο λανθάνοντα χώρο για λανθάνοντες κωδικούς που σχετίζονται με μια ταυτότητα.
Πάλι, παραμετρικές εκφράσεις αντιπροσωπεύουν μια γενικευμένη και μη εξατομικευμένη μέθοδο για να εισαγάγετε έκφραση, οδηγώντας σε μετασχηματισμούς που φαίνονται αλλόκοτοι με τον δικό τους, όχι πάντα θετικό τρόπο.

Εκφράσεις που εγχέονται στο OSFR.
Όπως και με προηγούμενη δουλειά, το OSFR μπορεί να συναγάγει πόζες κοντά στις αρχικές από μια μεμονωμένη εικόνα, και επίσης να εκτελέσει “frontalization”, όπου μια εικόνα που είναι εκτός κέντρου μετατρέπεται σε μια μετωπικό πορτρέτο:

Αρχική (πάνω) και συναγόμενες μετωπικές εικόνες από μια από τις εφαρμογές του OSFR που περιγράφονται στο νέο paper.
Στην πράξη, αυτό το είδος συναγωγής είναι παρόμοιο με κάποιες από τις αρχές φωτογραμμετρίας που υποστηρίζουν Neural Radiance Fields (NeRF), εκτός από το γεγονός ότι η γεωμετρία εδώ πρέπει να οριστεί από μια μεμονωμένη εικόνα, αντί των 3-4 οπτικών γωνιών που επιτρέπουν στο NeRF να ερμηνεύσει τις λείπουσες μεσοδιαστηματικές πόζες και να δημιουργήσει εξερευνήσιμες νευρωνικές τρισδιάστατες σκηνές με ανθρώπους.
(Ωστόσο, το NeRF δεν είναι το μόνο που χρειάζεται™ ούτε, καθώς φέρει ένα σχεδόν εντελώς διαφορετικό σύνολο εμποδίων σε σχέση με τα GANs όσον αφορά τη σύνθεση βίντεο προσώπου)
Έχει το GAN μια θέση στη σύνθεση βίντεο προσώπου;
Η επίτευξη δυναμικών εκφράσεων και πόζες εκτός της κατανομής εκπαίδευσης από μια μεμονωμένη εικόνα πηγή φαίνεται να είναι μια αλχημιστική εμμονή στην έρευνα σύνθεσης προσώπων με GAN αυτή τη στιγμή, κυρίως επειδή τα GANs είναι η μόνη μέθοδος που μπορεί να παραγάγει αρκετά υψηλής ανάλυσης και σχετικά υψηλής πιστότητας νευρωνικά πρόσωπα: αν και τα deepfake frameworks autoencoder μπορούν να εκπαιδευτούν σε πολλαπλά πραγματικά πόζες και εκφράσεις, πρέπει να λειτουργούν σε VRAM-περιορισμένες εισόδους/εξόδους ανάλυσης, και απαιτούν ένα “ξενιστή”; ενώ το NeRF είναι επίσης περιορισμένο, και – σε αντίθεση με τις άλλες δύο προσεγγίσεις – δεν έχει καθορισμένες μεθόδους για αλλαγή εκφράσεων προσώπου, και υποφέρει από περιορισμένη επεξεργασία γενικά.
Φαίνεται ότι ο μόνος τρόπος για να προχωρήσει ένα ακριβές CGI/GAN σύστημα σύνθεσης προσώπου είναι για μια νέα πρωτοβουλία να βρει κάποιον τρόπο να συναρμολογήσει μια οντότητα ταυτότητας πολλαπλών φωτογραφιών μέσα στον λανθάνοντα χώρο, όπου ένας λανθάνων κωδικός για μια ταυτότητα δεν χρειάζεται να ταξιδέψει όλο τον δρόμο μέσα από το λανθάνοντα χώρο για να εκμεταλλευτεί ανεξάρτητους παράμετρους πόζας, αλλά μπορεί να αναφερθεί στις δικές του σχετικές (πραγματικές) εικόνες ως αναφορές για μετασχηματισμούς.
Ακόμη και σε τέτοια περίπτωση, ή ακόμη και αν ένα ολόκληρο δίκτυο StyleGAN εκπαιδευτεί σε ένα σύνολο εικόνων προσώπου μίας μόνο ταυτότητας (παρόμοιο με τα σύνολα εκπαίδευσης που χρησιμοποιούν τα autoencoders), η λείπουσα σημασιολογική λογική θα χρειαζόταν ακόμη να παρέχεται από συμπληρωματικές τεχνολογίες όπως η σημασιολογική κατάτμηση ή παραμετρικά πρόσωπα 3DMM, τα οποία, σε τέτοια περίπτωση, θα είχαν τουλάχιστον περισσότερο υλικό να δουλέψουν.


