
Η γωνία του Anderson
Συνεπής επεξεργασία περιεχομένου βίντεο με τεχνητή νοημοσύνη και κειμενική καθοδήγηση

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
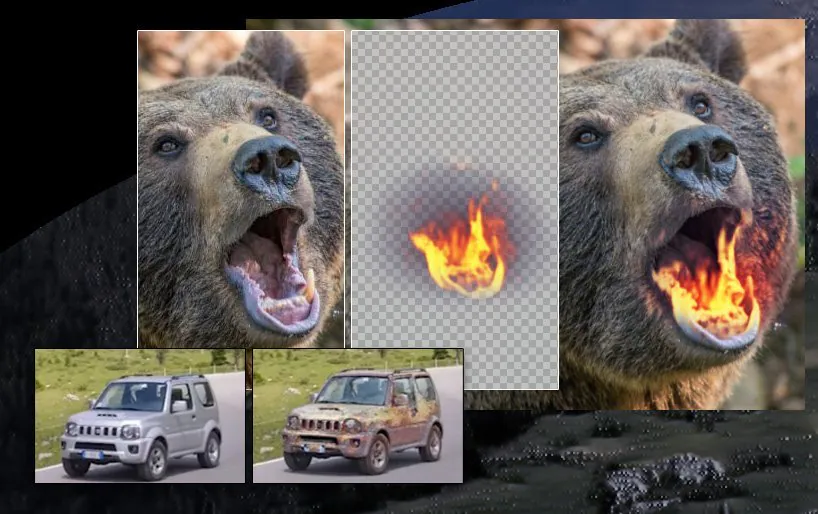
Βασικά σημείαΤο Text2Live επιτρέπει συνεπείς επεξεργασίες βίντεο από προτροπές κειμένου χωρίς…
Δείτε περισσότερα
- Το Text2Live επιτρέπει συνεπείς επεξεργασίες βίντεο από προτροπές κειμένου χωρίς επεξεργασία ανά καρέ.
- Το σύστημα χρησιμοποιεί έναν νευρωνικό στρωματοποιημένο άτλαντα για να εφαρμόσει επεξεργασίες μία φορά σε ολόκληρο το χρονοδιάγραμμα του βίντεο.
- Το Text2Live αυτοματοποιεί τη δημιουργία μάσκας και τη σύνθεση, εξαλείφοντας την ανάγκη για rotoscoping ή πράσινες οθόνες.
Ενώ η επαγγελματική κοινότητα των οπτικών εφέ ενδιαφέρεται – και μερικές φορές νιώθει λίγο απειλημένη – από τις νέες καινοτομίες στη σύνθεση εικόνων και βίντεο, η έλλειψη χρονικής συνέχειας στα περισσότερα έργα επεξεργασίας βίντεο με βάση τον AI οδηγεί πολλές από αυτές τις προσπάθειες στην “ψυχεδελική” σφαίρα, με λαμπερές και ταχέως μεταβαλλόμενες υφές και δομές, ασυνεπή εφέ και το είδος της πρόχειρης τεχνολογικής διαχείρισης που θυμίζει την φωτοχημική εποχή των οπτικών εφέ.
Εάν θέλετε να αλλάξετε κάτι πολύ συγκεκριμένο σε ένα βίντεο που δεν ανήκει στο πεδίο των deepfakes (δηλαδή, επιβάλλοντας μια νέα ταυτότητα σε υφιστάμενο βίντεο ενός ατόμου), οι περισσότερες από τις τρέχουσες λύσεις λειτουργούν υπό πολύ αυστηρά όρια, όσον αφορά την ακρίβεια που απαιτείται για παραγωγή υψηλής ποιότητας οπτικών εφέ.
Μια εξαίρεση είναι η συνεχιζόμενη εργασία μιας χαλαρής ένωσης ακαδημαϊκών από το Ινστιτούτο Επιστημών Weizmann. Το 2021, τρεις από τους ερευνητές του, σε συνεργασία με την Adobe (ADBE ), ανακοίνωσαν μια νέα μέθοδο για την αποσύνθεση βίντεο και την επιβολή μιας συνεπούς εσωτερικής χαρτογράφησης —ενός στρωματωμένου νευρωνικού άτλαντα— σε ένα σύνθετο αποτέλεσμα, με κανάλια άλφα και χρονικά συνεκτικά αποτελέσματα.
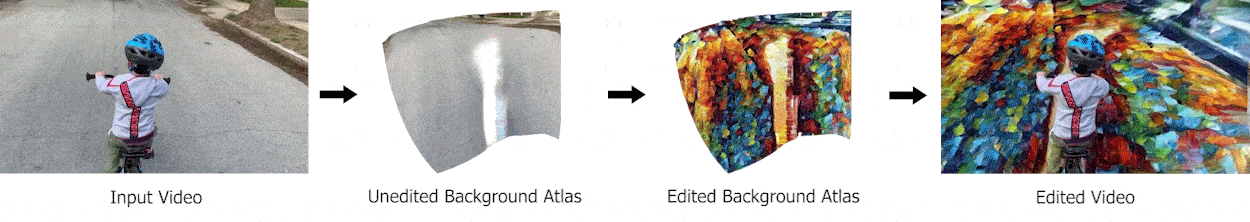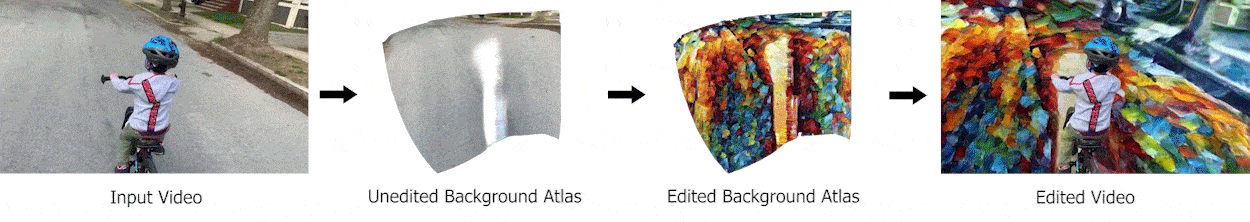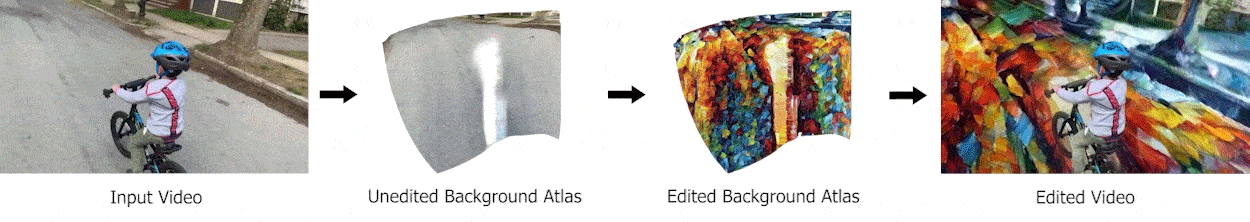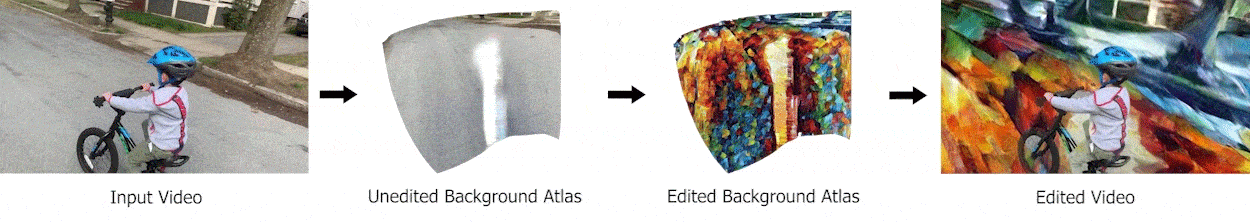
Από το έγγραφο του 2021: μια εκτίμηση της πλήρους διαδρομής του δρόμου στο αρχικό clip επεξεργάζεται μέσω ενός νευρωνικού δικτύου με τρόπο που παραδοσιακά θα απαιτούσε εκτεταμένη rotoscoping και match-moving.Επειδή τα στοιχεία του φόντου και του προσκηνίου αντιμετωπίζονται από διαφορετικά δίκτυα, οι μάσκες είναι πραγματικά ‘αυτόματες’. Πηγή: https://layered-neural-atlases.github.io/
Αν και ανήκει κάπου στο πεδίο της οπτικής ροής στις διαδικασίες VFX, ο στρωματωμένος άτλας δεν έχει άμεσο αντίστοιχο στις παραδοσιακές διαδικασίες CGI, καθώς αποτελεί ουσιαστικά έναν ‘χρονικό χάρτη υφής’ που μπορεί να παραχθεί και να επεξεργαστεί μέσω παραδοσιακών μεθόδων λογισμικού. Στη δεύτερη εικόνα της εικονογράφησης παραπάνω, το φόντο της επιφάνειας του δρόμου αντιπροσωπεύεται (εικονικά) σε όλη τη διάρκεια του βίντεο. Η αλλαγή της βασικής εικόνας (τρίτη εικόνα από αριστερά στην εικονογράφηση παραπάνω) παράγει μια συνεπή αλλαγή στο φόντο.
Οι εικόνες του «ξεδιπλωμένου» άτλαντα παραπάνω παρουσιάζουν μόνο μεμονωμένα ερμηνευμένα καρέ. Οι συνεπείς αλλαγές σε οποιοδήποτε καρέ του βίντεο-στόχου αντιστοιχίζονται ξανά στο αρχικό καρέ, διατηρώντας τις απαραίτητες αποκρύψεις και άλλα απαιτούμενα εφέ της σκηνής, όπως σκιές ή ανακλάσεις.
Η βασική αρχιτεκτονική χρησιμοποιεί ένα πολυστρωματικό perceptron (MLP) για να αναπαραστήσει τους ξεδιπλωμένους άτλαντες, τα κανάλια άλφα και τις αντιστοιχίσεις. Όλα βελτιστοποιούνται από κοινού και αποκλειστικά σε δισδιάστατο χώρο, χωρίς να χρειάζονται η προηγούμενη γνώση σημείων τρισδιάστατης γεωμετρίας, οι χάρτες βάθους και τα συναφή στοιχεία CGI που απαιτούν προσεγγίσεις τύπου NeRF.
Ο άτλαντας αναφοράς των επιμέρους αντικειμένων μπορεί επίσης να τροποποιηθεί αξιόπιστα:
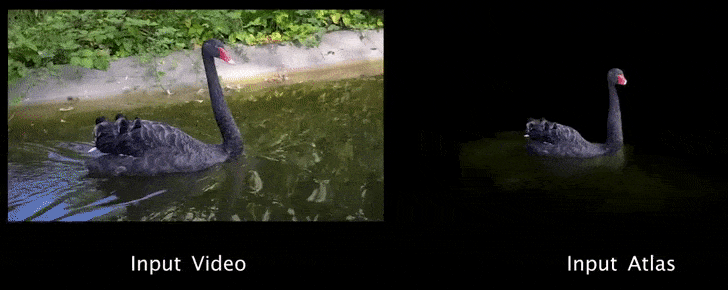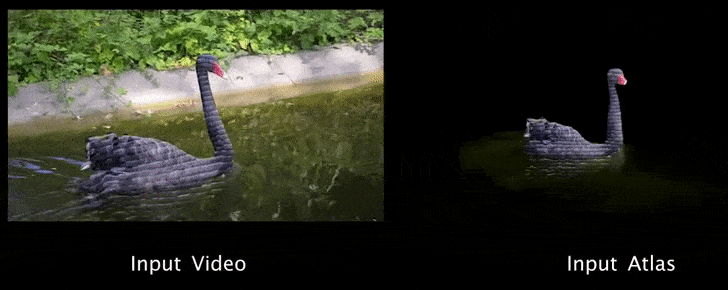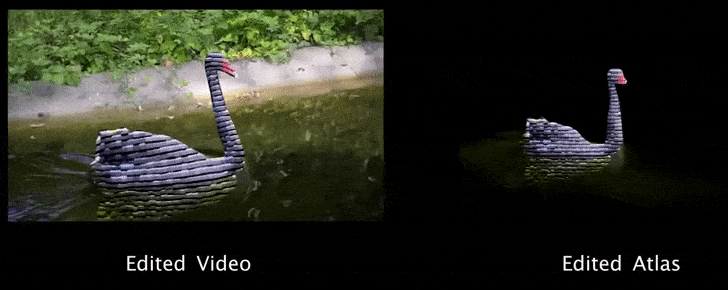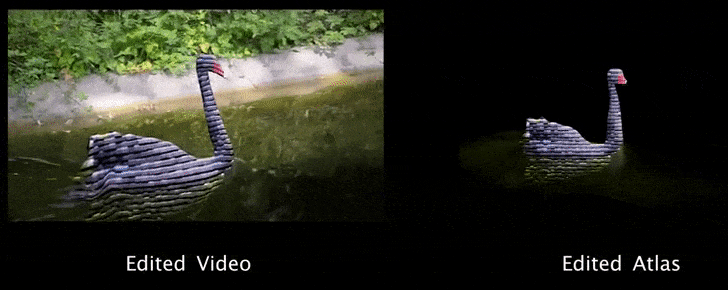
Συνεχής αλλαγή σε ένα κινούμενο αντικείμενο υπό το πλαίσιο του 2021. Πηγή: https://www.youtube.com/watch?v=aQhakPFC4oQ
Ουσιαστικά, το σύστημα του 2021 συνδυάζει την ευθυγράμμιση γεωμετρίας, match-moving, χαρτογράφηση, re-texturizing και rotoscoping σε μια διακριτή νευρωνική διαδικασία.
Text2Live
Οι τρεις αρχικοί ερευνητές του εγγράφου του 2021, μαζί με την NVIDIA (NVDA ) Research, είναι μεταξύ των συντελεστών μιας νέας καινοτομίας στην τεχνική που συνδυάζει τη δύναμη των στρωματωμένων άτλαντων με τον τύπο της κειμενο-καθοδηγούμενης τεχνολογίας CLIP που έχει επιστρέψει στο προσκήνιο αυτή την εβδομάδα με την έκδοση του πλαισίου DALL-E 2.
Η νέα αρχιτεκτονική, με τίτλο Text2Live, επιτρέπει στον τελικό χρήστη να δημιουργήσει τοπικές επεξεργασίες σε πραγματικό περιεχόμενο βίντεο με βάση κειμενικές προτροπές:
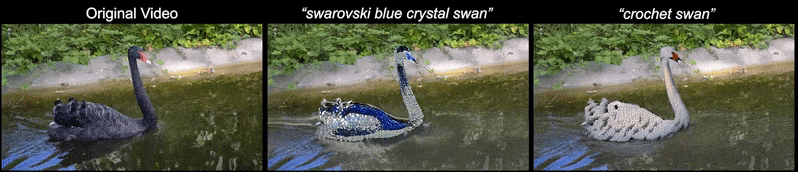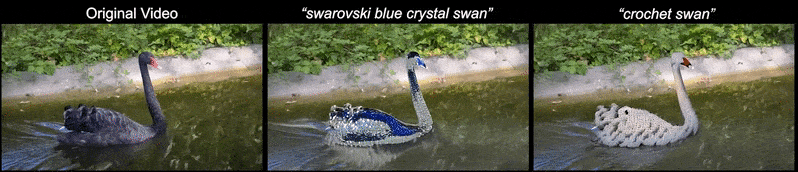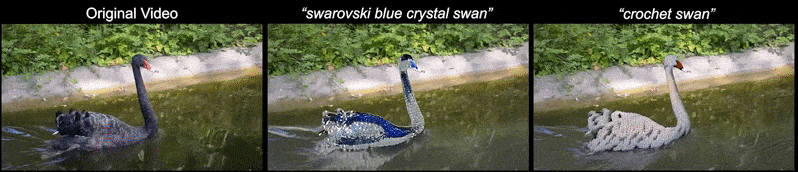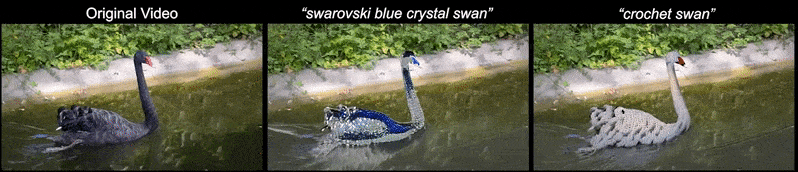
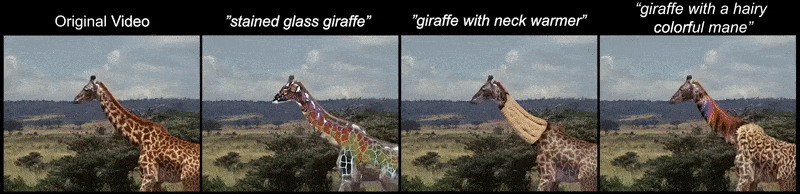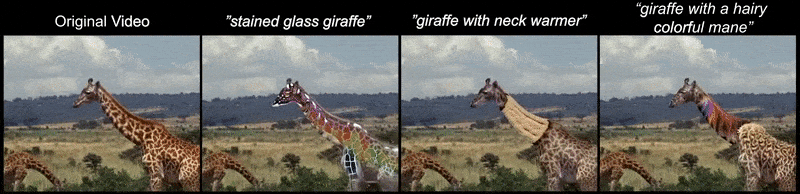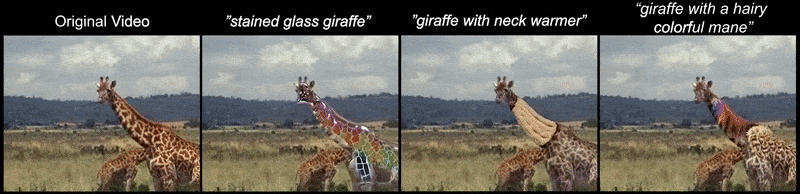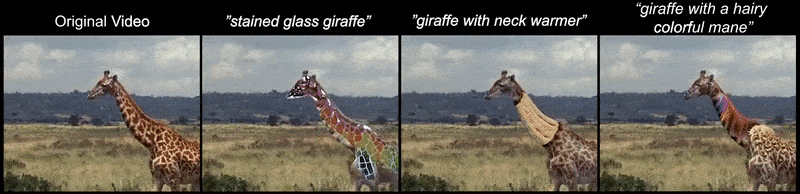
Δύο παραδείγματα επεξεργασίας προσκηνίου. Για καλύτερη ανάλυση και ευκρίνεια, επισκεφθείτε τα αρχικά βίντεο στο https://text2live.github.io/sm/pages/video_results_atlases.html
Το Text2Live προσφέρει σημασιολογική και υψηλά τοπική επεξεργασία χωρίς τη χρήση ενός προεκπαιδευμένης γεννήτριας, χρησιμοποιώντας μια εσωτερική βάση δεδομένων που είναι συγκεκριμένη για το clip βίντεο που επηρεάζεται.

Μετασχηματισμοί φόντου και προσκηνίου (αντικειμένου) υπό το Text2Live. Πηγή: https://text2live.github.io/sm/pages/video_results_atlases.html
Η τεχνική δεν απαιτεί μάσκες που παρέχονται από τον χρήστη, όπως μια τυπική διαδικασία rotoscoping ή green-screen, αλλά αντίθετα εκτιμά χαρτογραφήσεις σχετικότητας μέσω μιας τεχνικής bootstrapping που βασίζεται σε έρευνα του 2021 από το Τμήμα Επιστήμης Υπολογιστών του Πανεπιστημίου του Τελ Αβίβ και την Facebook AI Research (FAIR).

Χάρτες εξόδου που παράγονται από ένα γενικό μοντέλο προσοχής βασισμένο σε transformer.
Το νέο έγγραφο έχει τον τίτλο Text2LIVE: Text-Driven Layered Image and Video Editing. Η αρχική ομάδα του 2021 ενώνεται με τον Omer Bar-Tal του Ινστιτούτου Weizmann και τον Yoni Kasten της NVIDIA Research.
Αρχιτεκτονική
Το Text2Live αποτελείται από μια γεννήτρια που εκπαιδεύεται σε μία μόνο εικόνα εισόδου και στις κειμενικές προτροπές-στόχους. Ένα μοντέλο αντιθετικής προεκπαίδευσης γλώσσας–εικόνας (CLIP), προεκπαιδευμένο σε 400 εκατομμύρια ζεύγη κειμένου/εικόνας, παρέχει το σχετικό οπτικό υλικό που επιτρέπει την ερμηνεία των μετασχηματισμών που ζητά ο χρήστης.

Η γεννήτρια δέχεται μια εικόνα εισόδου, δηλαδή ένα καρέ, και παράγει ένα στρώμα RGBA-στόχο με πληροφορίες χρώματος και αδιαφάνειας. Το στρώμα αυτό ενσωματώνεται στο αρχικό βίντεο με πρόσθετες τροποποιήσεις.

Το κανάλι άλφα στο παραγόμενο στρώμα RGBA επιτρέπει εσωτερική σύνθεση χωρίς τις παραδοσιακές ροές εργασίας που χρησιμοποιούν λογισμικό βασισμένο σε pixel, όπως το After Effects.
Με την εκπαίδευση σε εσωτερικές εικόνες που σχετίζονται με το στόχο βίντεο ή εικόνας, το Text2Live αποφεύγει την ανάγκη είτε να αντιστρέψει την είσοδο εικόνας στο latent χώρο ενός Generative Adversarial Network (GAN), μια πρακτική που είναι ακόμη μακράν από την ακρίβεια που απαιτείται για τις απαιτήσεις επεξεργασίας βίντεο παραγωγής, είτε να χρησιμοποιήσει ένα μοντέλο Diffusion που είναι πιο ακριβές και ρυθμιζόμενο, αλλά δεν μπορεί να διατηρήσει πιστότητα στο στόχο βίντεο.

Διάφοροι μετασχηματισμοί βάσει κειμενικών προτροπών από το Text2Live.
Προηγούμενες προσεγγίσεις έχουν χρησιμοποιήσει μεθόδους που βασίζονται στη διάδοση ή προσεγγίσεις που βασίζονται στην οπτική ροή. Επειδή αυτές οι τεχνικές βασίζονται σε κάποιον βαθμό σε μεμονωμένα καρέ, καμία δεν μπορεί να διατηρήσει χρονικά συνεπή την εμφάνιση των αλλαγών στο παραγόμενο βίντεο. Ένας νευρωνικός στρωματωμένος άτλας, αντίθετα, παρέχει ένα ενιαίο χώρο στον οποίο να αντιμετωπιστούν αλλαγές, οι οποίες μπορούν να παραμείνουν πιστές στην αλλαγή που έχει δεσμευτεί καθώς το βίντεο προχωρά.
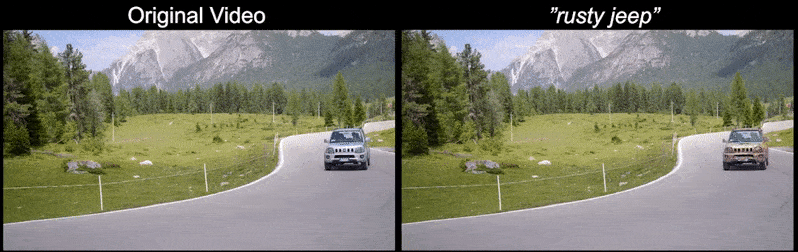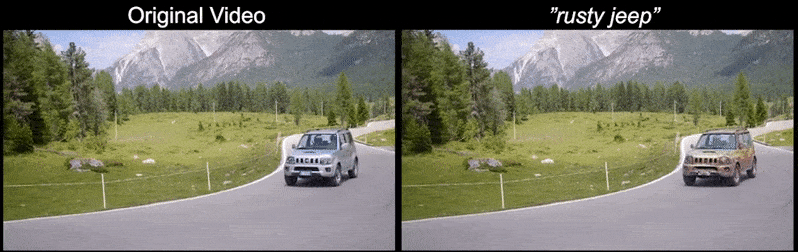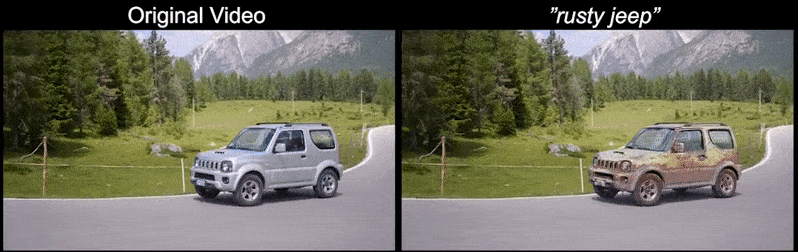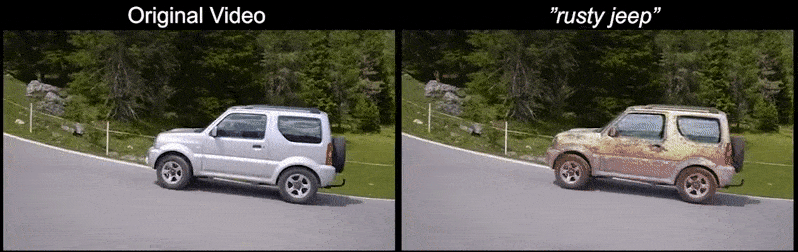
Χωρίς ‘σπάσιμο’ ή τυχαίες εικασίες: το Text2Live λαμβάνει μια ερμηνεία της κειμενικής προτροπής ‘rusty jeep’ και την εφαρμόζει μια φορά στον νευρωνικό στρωματωμένο άτλαντα του αυτοκινήτου στο βίντεο, αντί να επανεκκινεί τον μετασχηματισμό για κάθε ερμηνευμένο καρέ.

Διαδικασία συνθέσεως του Text2Live για τη συνεπή μετασχηματισμό ενός Jeep σε ένα σκουριασμένο απομεινάρι.
Το Text2Live είναι πιο κοντά σε μια επαναστατική καινοτομία στην AI-βασισμένη σύνθεση, παρά στην πλούσια περιοχή κειμένου-εικόνας που έχει προσελκύσει τόσο την προσοχή αυτή την εβδομάδα με την δεύτερη γενιά του πλαισίου DALL-E της OpenAI (η οποία μπορεί να ενσωματώσει στόχους εικόνων ως μέρος της μετασχηματιστικής διαδικασίας, αλλά παραμένει περιορισμένη στην ικανότητά της να επεμβαίνει άμεσα σε μια φωτογραφία, εκτός από την λογοκρισία των πηγαίων δεδομένων εκπαίδευσης και την επιβολή φίλτρων, που έχουν σχεδιαστεί για να αποτρέψουν την κατάχρηση από τους χρήστες).
Αντίθετα, το Text2Live επιτρέπει στον τελικό χρήστη να εξαγάγει έναν άτλαντα και να τον επεξεργαστεί σε ένα μόνο πέρασμα σε περιβάλλοντα υψηλής ελέγχου pixel-βασισμένα, όπως το Photoshop (και ενδεχομένως ακόμη και πιο αφηρημένα πλαίσια σύνθεσης εικόνας, όπως το NeRF), πριν να τον επαναφέρει σε ένα σωστά προσανατολισμένο περιβάλλον που δεν βασίζεται σε τρισδιάστατη εκτίμηση ή σε προσεγγίσεις CGI που επιστρέφουν σε παλαιότερες μεθόδους.
Επιπλέον, το Text2Live, όπως ισχυρίζονται οι συγγραφείς, είναι το πρώτο συγκρίσιμο πλαίσιο που επιτυγχάνει μάσκες και σύνθεση με εντελώς αυτόματο τρόπο.
Πρώτη δημοσίευση 7ης Απριλίου 2022.





