
Η γωνία του Anderson
Ένας Αλγόριθμος Μηχανικής Μάθησης για την Ανασυγγραφή ενός Άρθρου Κατά τη Διάρκεια της Ανάγνωσής του

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
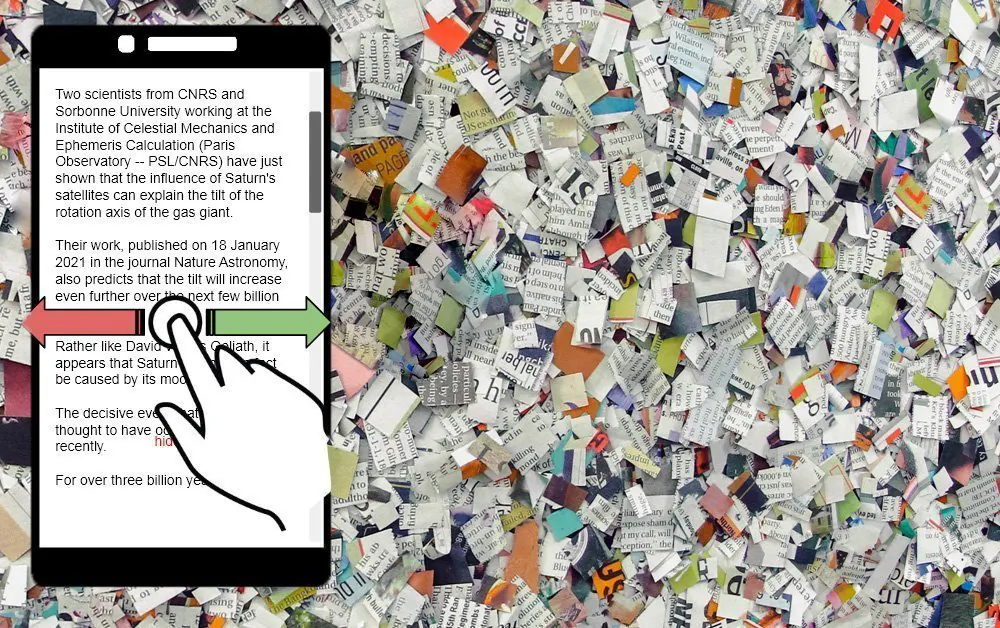
Νέα έρευνα από τον Καναδά προτείνει μια μέθοδο για την αυτόματη ανασυγγραφή ενός άρθρου κατά τη διάρκεια της ανάγνωσής του, με βάση το στυλ “swiping” του Tinder ή την παθητική παρατήρηση της αλληλεπίδρασης του αναγνώστη με τους verschiedenen τύπους περιεχομένου που περιέχονται στο άρθρο.
Το σύστημα, με τίτλο Hone As You Read (HARE), παρουσιάζεται σε một έγγραφο από το Πανεπιστήμιο του Οντάριο στον Καναδά, με τον αντίστοιχο κώδικα Python στο GitHub.
Η κεντρική ιδέα του έργου είναι ότι ένα άρθρο μπορεί να περιέχει verschiedenen τύπους περιεχομένου, που εξελίσσονται (όπως και αυτό) από τον τίτλο μέχρι τις περαιτέρω λεπτομέρειες. Τα μεταγενέστερα τμήματα ενός άρθρου μπορεί να περιέχουν διαφορετικούς τύπους υποστηρικτικού υλικού, παραδείγματα, ή υποθέσεις ή εικασίες σχετικά με τις επιπτώσεις των ειδήσεων.
Υπό το HARE, αν δεν σας αρέσει ένας τέτοιος τύπος υλικού, μπορείτε να ψηφίσετε κατά της αφαίρεσής του σε βάση παραγράφου, ενώ το σύστημα μαθαίνει τις προτιμήσεις σας, ώστε μέχρι να κάνετε scroll xuống, το περιεχόμενο που είναι παρόμοιο με το υλικό που “κατέβασες” έχει ήδη αφαιρεθεί ή ανασυγγραφεί. Αν δεν θέλετε να συμμετέχετε ενεργά στην εκπαίδευση του συστήματος, το HARE μπορεί να καταλάβει τις επιλογές σας παρατηρώντας τις παθητικές αλληλεπιδράσεις σας με το έγγραφο.
Ψηφοφορία Στυλ Tinder Για Ανηγούμενες Προτάσεις
Στην εικόνα παρακάτω, βλέπουμε τρεις πιθανές κατηγορίες για το HARE, με βάση την σαφή ή ασάφεια της συμπεριφοράς του χρήστη. Στην πρώτη περίπτωση (αριστερά), ο χρήστης ψηφίζει ενεργά “swipe αριστερά” (ή δεξιά), σε ένα στυλ ψηφοφορίας του Tinder που εκφράζει έγκριση ή δυσαρέσκεια για το περιεχόμενο της παραγράφου ή της πρότασης, ή για το στυλ, τη сложκότητα ή τον τόνο.
Στη δεύτερη περίπτωση (κέντρο), το σύστημα χρησιμοποιεί το χρόνο παραμονής ως μέτρο του ενδιαφέροντος του χρήστη, με βάση τη θέση και τη διάρκεια της παύσης του scroll.
Στην τρίτη περίπτωση (δεξιά), το HARE χρησιμοποιεί την κάμερα του smartphone για να εκτιμήσει τη διαδρομή και το χρόνο παραμονής της θέσης του βλέμματος του χρήστη στις παραγράφους του ορατού εγγράφου.
Οι ερευνητές υποστηρίζουν ότι ο αυξημένος χρόνος παραμονής σε οποιαδήποτε παράγραφο μπορεί να δείξει αυξημένο ενδιαφέρον του χρήστη, αν και λογικά αυτό μπορεί να μην είναι η περίπτωση όπου ο χρήστης προσπαθεί να συνειδητοποιήσει κείμενο που μπορεί να είναι σύνθετο ή απλώς κακογραμμένο.
Προεπεξεργασία Περιεχομένου Σύμφωνα Με τις Προτιμήσεις του Χρήστη
Το έγγραφο ασχολείται με την εμπειρία του χρήστη του HARE σε βάση άρθρου, αλλά σαφώς η ιστορική αλληλεπίδραση του χρήστη με τα έγγραφα επιτρέπει την προσαρμογή των μελλοντικών εμπειριών ανάγνωσης, αναγνωρίζοντας συνεχώς τους τύπους περιεχομένου και εφαρμόζοντας προκατασκευασμένες προτιμήσεις του χρήστη σε νέα άρθρα, ώστε η ανάγκη για αλληλεπίδραση να μειώνεται καθώς ο χρήστης βλέπει όλο και λιγότερο “απωθητικό” περιεχόμενο.
Το HARE χαρακτηρίζεται ως αλγόριθμος περίληψης, που επιτρέπει σε μη ορατό περιεχόμενο να ανασυγγραφεί σε όρους στυλ ή συντομίας πριν ο χρήστης φτάσει σε αυτό. Tuy nhiên, το έγγραφο καθιστά σαφές ότι μπορεί επίσης να αφαιρέσει προληπτικά περιεχόμενο με βάση την ανατροφοδότηση του χρήστη.
Για τους σκοπούς της δοκιμής, το σύστημα χρησιμοποίησε ένα σύνολο δεδομένων από 11.222 άρθρα από την εφημερίδα Daily Mail του Ηνωμένου Βασιλείου και αξιολογήθηκε μέσω μιας δοκιμαστικής ανάπτυξης στην εφαρμογή Telegram. Τα άρθρα με λιγότερες από δέκα παραγράφους απορρίφθηκαν για τους σκοπούς της δοκιμής.
Η μεθοδολογία των ερευνητών χρησιμοποιεί K-Means clustering σε SBERT sentence embeddings στα άρθρα, με αρχικά τυχαία βάρη για τις έννοιες που αντιμετωπίζονται.
Μεταξύ ενός ευρέος συνόλου αλγορίθμων και προσεγγίσεων, το HARE διαθέτει τρία μοντέλα σύγκρισης, το πρώτο από τα οποία (ORACLEGREEDY) έχει πρόσβαση σε προηγούμενες προτιμήσεις του χρήστη, υποδεικνύοντας την πρόθεση ότι ο αλγόριθμος θα μπορούσε να προεπεξεργαστεί άρθρα κατά τη φόρτωση, αντί να αλληλεπιδρά ενεργά.
Αφαίρεση και Ανασυγγραφή Περιεχομένου
Εξαιρετικά, το ORACLEUNIFORM ξεπέρασε το σύνολο ελέγχου,尽管 δεν είχε πρόσβαση σε προηγούμενες προτιμήσεις του χρήστη. Οι ερευνητές υποστηρίζουν ότι αυτό οφείλεται στο γεγονός ότι αντιμετωπίζει το整λό άρθρο σε μια κίνηση, “επιλέγοντας μόνο τις πιο ενδιαφέρουσες προτάσεις”. Οι ερευνητές παραδέχονται ότι αυτό μπορεί να περιορίσει το διαθέσιμο περιεχόμενο σε προτάσεις που ασχολούνται αποκλειστικά με την πιο σημαντική έννοια, λογικά αφαιρώντας άλλες προτάσεις που μπορεί να ασχολούνται με τις επιπτώσεις ή την αξιολόγηση της έννοιας.
Οι αλγόριθμοι περίληψης που χρησιμοποιούνται στο HARE είναι LexRank, SumBasic και TextRank.
Το HARE δοκιμάστηκε σε 13 εθελοντές κατά τη διάρκεια 70 δοκιμών και διαφορετικών αλγορίθμων, και ήταν σε θέση να ενημερώσει περιλήψεις (ανασυγγραφές/αφαιρέσεις κειμένου) σε κάπου μεταξύ 1,3 χιλιοστού του δευτερολέπτου και 100 ms σε ένα laptop καταναλωτικής ποιότητας, ανάλογα με το μοντέλο που δοκιμάζεται. Τα αποτελέσματα έδειξαν ότι τα μοντέλα που αφαίρεσαν το περισσότερο κείμενο δεν εκτέλεσαν καλά, κυρίως επειδή αυτό μπορεί να επηρεάσει τη συνοχή του υπόλοιπου κειμένου.
Ηθικές Επιβεβαιώσεις της Δυναμικής Ανασυγγραφής Άρθρου
Οι ερευνητές αναγνωρίζουν τις ηθικές ανησυχίες γύρω από τις τεχνολογίες αυτού του είδους:
‘Η εργασία HARE προορίζεται για τον σχεδιασμό μελλοντικών εφαρμογών που αντιμετωπίζουν τον χρήστη. Από σχεδιασμό, αυτές οι εφαρμογές έχουν την ικανότητα να ελέγχουν τι διαβάζει ο χρήστης από ένα δεδομένο άρθρο. Είναι δυνατό ότι, όταν αναπτύσσονται χωρίς επαρκή φροντίδα, αυτά τα εργαλεία θα μπορούσαν να ενισχύσουν την “ηχώ-αίθουσα” που παράγεται από τις αυτόματες ειδησεογραφικές ροές, τα αποτελέσματα αναζήτησης και τις online κοινότητες.’
Ωστόσο, επίσης σημειώνουν ότι ένα τέτοιο σύστημα θα μπορούσε να χρησιμοποιηθεί σε μελλοντικές εφαρμογές για να μετριάσει την “ηχώ-αίθουσα” εισάγοντας κείμενο που προτείνει εναλλακτικές απόψεις που μπορεί να μην ήταν αρχικά παρόντες στο άρθρο. Παρατηρούν: ‘Το βάρος αυτού του παράγοντα θα μπορούσε να ρυθμιστεί για να παρέχει τόσο μια ελκυστική εμπειρία ανάγνωσης όσο και έκθεση σε μια ποικιλία ιδεών.’
Αυτοί που πιθανότατα θα επωφεληθούν από ένα τέτοιο σύστημα, σύμφωνα με τους ερευνητές, είναι οι αναγνώστες που θέλουν να εξοικονομήσουν χρόνο στην ανάγνωση πληροφοριών και οι εκδότες περιεχομένου.


