Grundlagen der KI
Was ist Computational Thinking?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
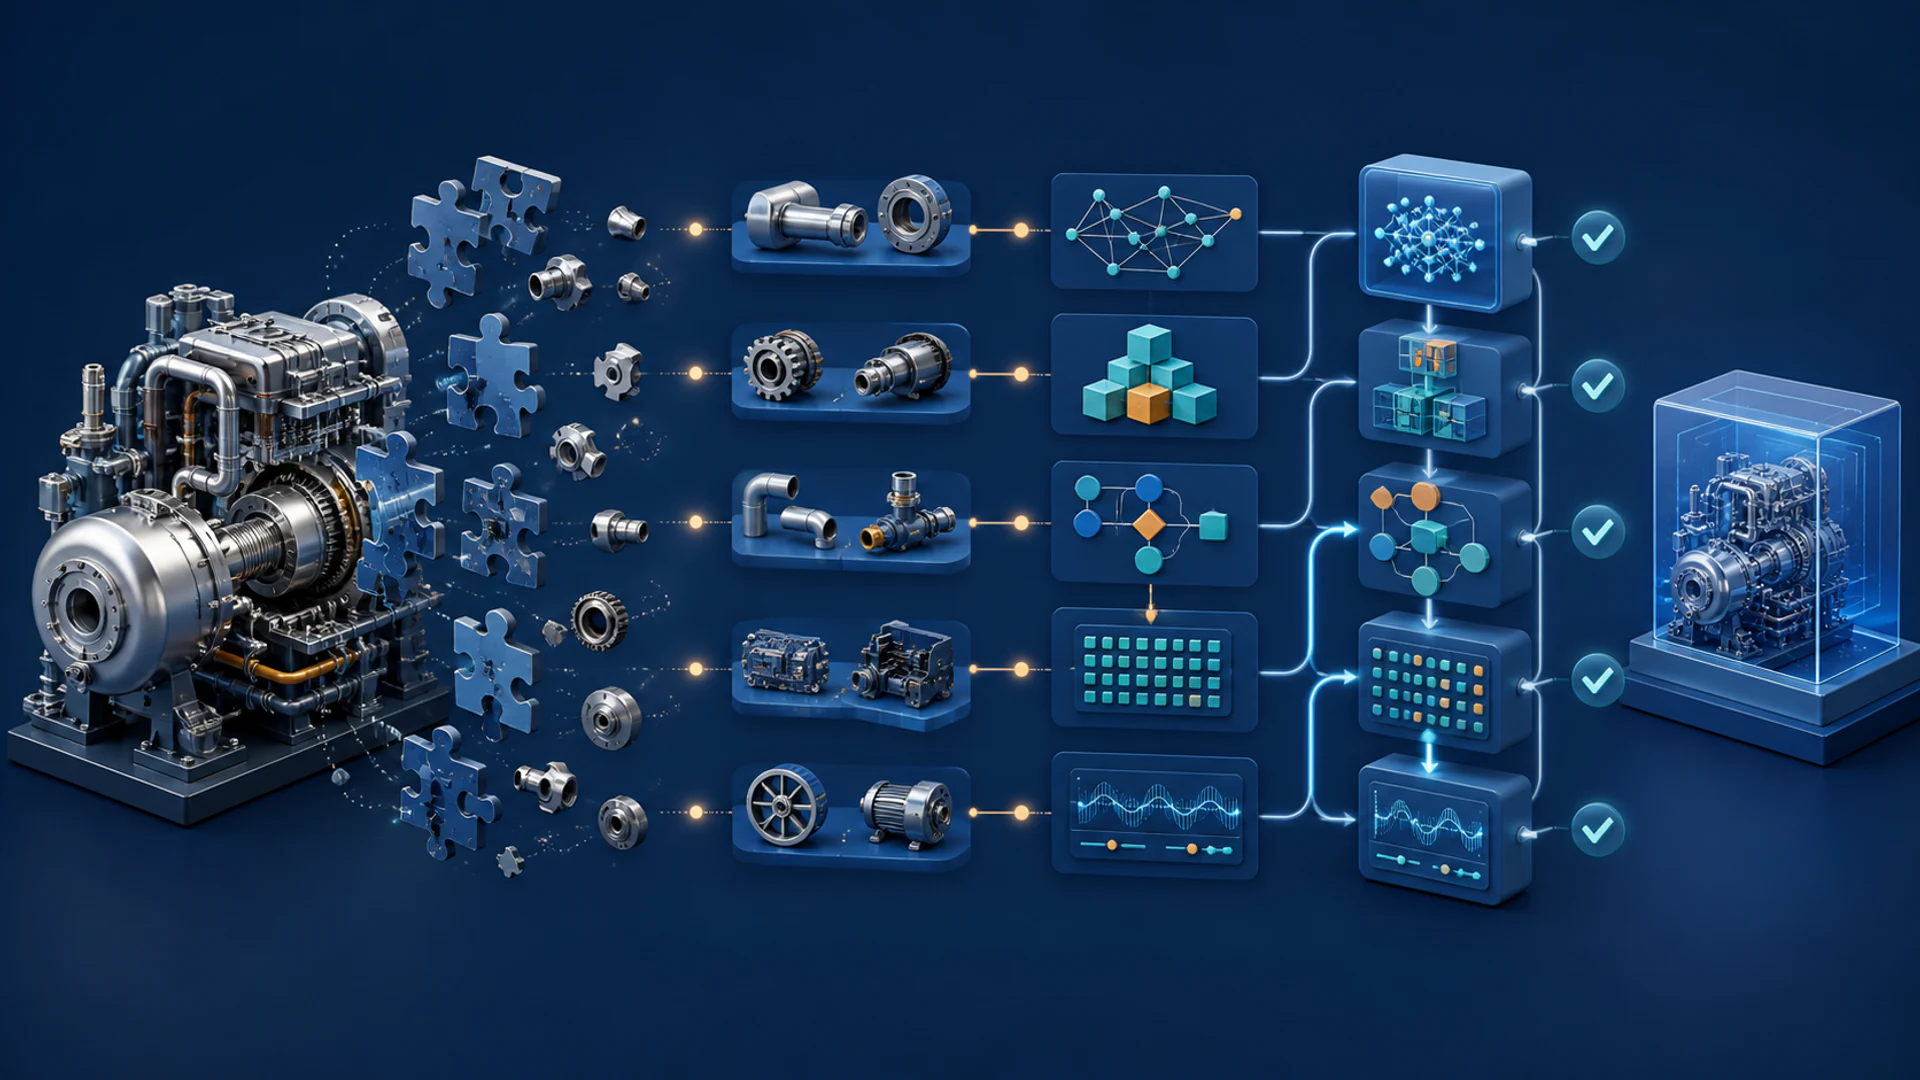
Computational thinking ist ein Ansatz, Probleme und Lösungen so zu formulieren, dass Informationsverarbeitungsschritte systematisch von einer Person, einem Computer oder einem Netzwerk von Systemen durchgeführt werden können. Er umfasst Abstraktion und Algorithmus‑Design, beinhaltet aber auch die Entscheidung, was dargestellt werden soll und wie eine vorgeschlagene Lösung getestet wird.
Computational Thinking ist weiter gefasst als Programmieren. Code kann eine Lösung implementieren, doch die schwierige Arbeit liegt häufig bereits vorher: die Zieldefinition, die Zerlegung des Problems, die Auswahl relevanter Details und das Erkennen, wo Automatisierung unangemessen ist.
Wesentliche Erkenntnisse
- Formuliere das Problem, bevor du ein Verfahren optimierst.
- Zerlegung teilt ein komplexes System in miteinander interagierende Teile; Abstraktion verbirgt Details, die auf der gewählten Ebene irrelevant sind.
- Algorithmen benötigen Eingaben, Ausgaben, Annahmen, Abbruchbedingungen und Tests.
- Computational Thinking ersetzt weder soziale Urteilsfähigkeit, mehrdeutige Werte noch Verantwortlichkeit.
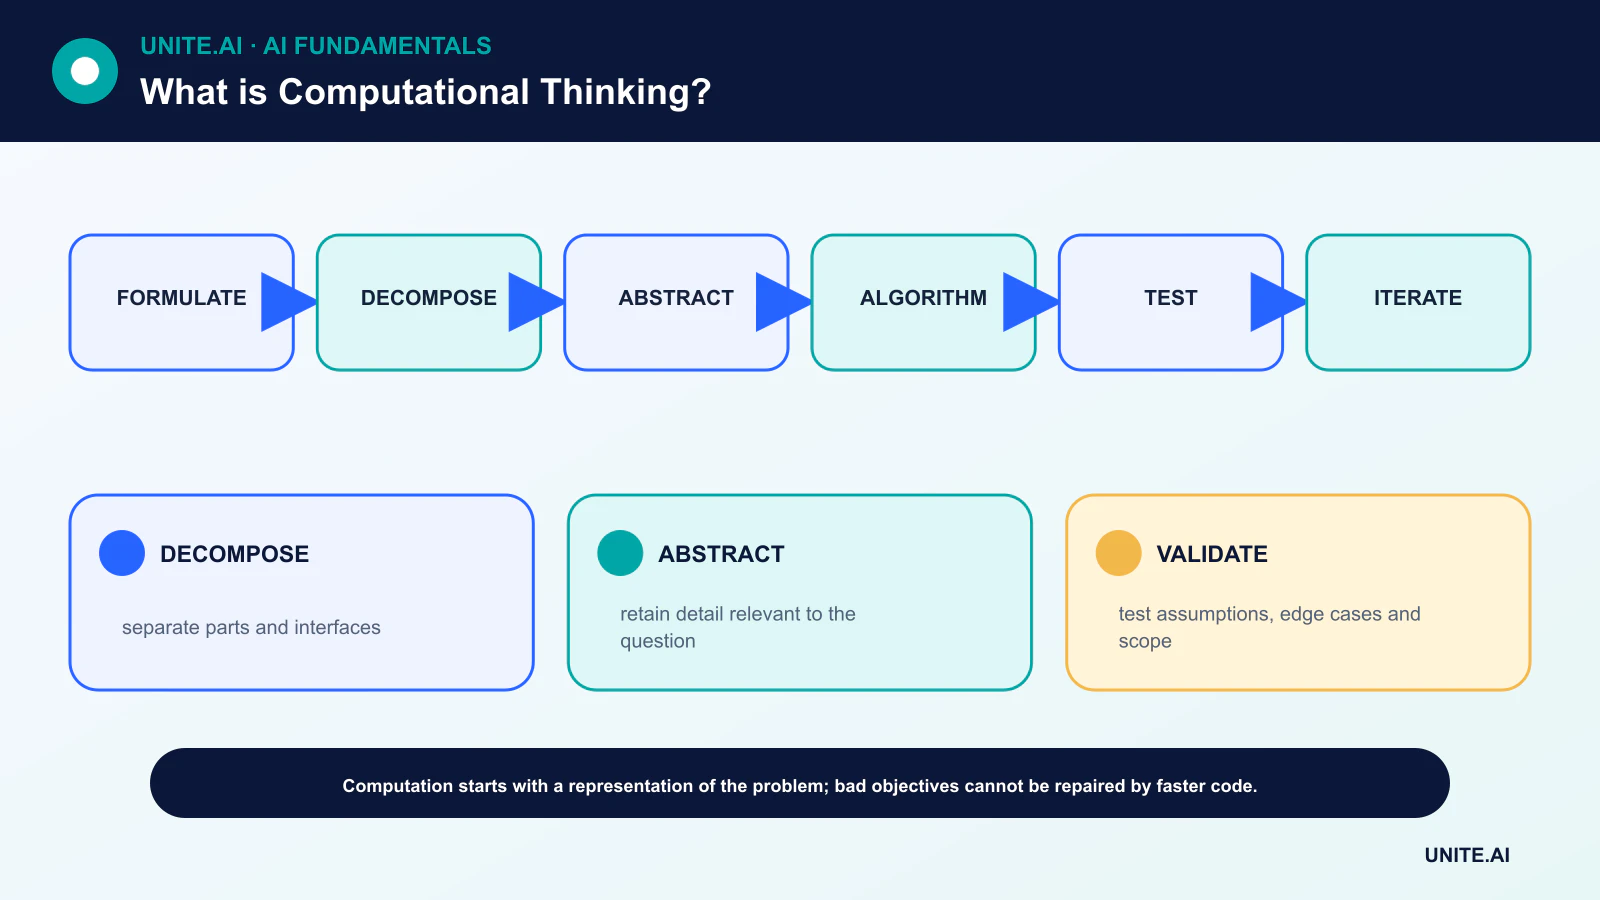
Formuliere das Problem und das Ziel
Identifiziere die betroffenen Personen, die zu unterstützende Entscheidung, die verfügbaren Informationen und die Folgen von Fehlern. Übersetze eine vage Anforderung in ein beobachtbares Ergebnis, ohne ein leicht messbares Proxy mit dem eigentlichen Ziel zu verwechseln.
Im Maschinellen Lernen kann das Vorhersagen von Klicks technisch bequem sein, muss aber nicht Zufriedenheit repräsentieren. Computational Thinking beginnt damit, diese Formulierung zu testen, anstatt sofort einen Algorithmus zu wählen.
Zerlege Systeme und Abhängigkeiten
Zerlege das Problem in Komponenten, über die separat nachgedacht werden kann: Datenerfassung, Validierung, Transformation, Entscheidungslogik, Nutzerinteraktion und Monitoring. Dokumentiere Schnittstellen und Rückmeldungen zwischen ihnen, damit lokale Verbesserungen das Gesamtsystem nicht beschädigen.
Zerlegung ist keine Fragmentierung. Ein Team muss die Teile wieder zusammenführen und das End‑zu‑End‑Verhalten testen, einschließlich Timing, fehlender Eingaben und Ausfällen in vorgelagerten oder nachgelagerten Diensten.
Abstrahieren und darstellen
Eine Abstraktion behält Details bei, die für eine Fragestellung relevant sind, und unterdrückt andere. Ein Graph kann Verbindungen darstellen, eine Tabelle kann Datensätze darstellen, und eine Wahrscheinlichkeitsverteilung kann Unsicherheit darstellen. Die gleiche reale Situation kann für unterschiedliche Entscheidungen verschiedene Darstellungen erfordern.
Alle Darstellungen lassen etwas aus. Dokumentiere Einheiten, Kategorien, Zeitfenster und fehlende Werte. Der Unterschied zwischen strukturierter und unstrukturierter Daten beeinflusst, was ausgedrückt werden kann und welche Transformationen Kontext verlieren können.
Entwirf einen Algorithmus und automatisiere vorsichtig
Ein Algorithmus ist ein definierter Ablauf mit Eingaben, Schritten und Ausgaben. Berücksichtige Korrektheit, Terminierung, Komplexität, Speicherbedarf, Fehlverhalten und ob Ergebnisse deterministisch oder probabilistisch sind. Nutze Beispiele und Randfälle, bevor du verallgemeinerst.
Automatisierung sollte Validierung und eine sichere Reaktion auf nicht unterstützte Eingaben umfassen. Ein Prozess, der schnell läuft, aber das falsche Ziel kodiert, ist keine Verbesserung. Menschliche Prüfung kann Teil des algorithmischen Systems sein, anstatt ein Hinweis darauf, dass es gescheitert ist.
Teste, iteriere und verallgemeinere
Unit‑Tests prüfen Komponenten; Integrationstests prüfen Schnittstellen; Szenariotests prüfen das End‑zu‑End‑Verhalten. Vergleiche erwartete und beobachtete Ergebnisse, spüre Fehler bis zu den Annahmen zurück und überarbeite die Formulierung, wenn die Evidenz ihr widerspricht.
Verallgemeinerung fragt, ob der Ansatz über die Beispiele hinaus, die zu seiner Entwicklung verwendet wurden, übertragbar ist. Gib den gültigen Anwendungsbereich an. Probleme, die Rechte, Werte oder umstrittene Ziele betreffen, erfordern partizipative Urteile und Governance zusätzlich zur Berechnung.
Die Kernpraktiken des Computational Thinking
Computational Thinking rahmt ein Problem so, dass eine Person oder Maschine eine Lösung ausführen kann. Zerlegung teilt ein komplexes Ziel in handhabbare Teile; Mustererkennung erkennt wiederkehrende Strukturen; Abstraktion behält informationen, die für die Aufgabe relevant sind; Algorithmus‑Design spezifiziert Schritte und Bedingungen. Repräsentation ist ebenso wichtig: Tabellen, Graphen, Zustände, Koordinaten und Datentypen erleichtern manche Operationen und erschweren andere. Das Ziel ist diszipliniertes Problemlösen, nicht bloß das Erlernen von Code.
Eine gute Zerlegung definiert Schnittstellen und Verantwortlichkeiten zwischen den Teilen. Abstraktion sollte nebensächliche Details verbergen, ohne notwendige Einschränkungen für die Korrektheit zu verbergen. Algorithmen benötigen Eingaben, Ausgaben, Vorbedingungen, Invarianten, Terminierung und Fehlverhalten. Pseudocode, Flussdiagramme, Entscheidungstabellen und Beispiele helfen vor der Implementierung. Effizienz berücksichtigt Zeit, Speicher, Kommunikation, Energie und menschlichen Aufwand, doch Optimierung sollte erst nach einer korrekten Basis erfolgen. Einige Probleme sind unentscheidbar oder rechnerisch bei großem Umfang unlösbar, wodurch Approximation und Kompromisse wesentlich werden.
Testen, Debuggen und Daten‑Reasoning
Testen leitet Fälle aus den Anforderungen ab: normal, Grenzwerte, leer, fehlerhaft, wiederholt, extrem und antagonistisch. Debuggen bildet Hypothesen, beobachtet Zustände, isoliert Ursachen und verifiziert eine Korrektur, ohne Regressionen einzuführen. Reproduzierbarkeit dokumentiert Eingaben, Versionen und Umgebung. Bei Datenproblemen fragt man, wie Beobachtungen gesampelt, gemessen, gekennzeichnet, fehlend und transformiert wurden. Ein Algorithmus kann perfekt ausgeführt werden und dennoch zu einem falschen Ergebnis führen, weil die Repräsentation oder Annahme zur Datengenerierung ungültig war.
Automatisierung verändert einen Prozess und seine Anreize. Identifiziere, wer Eingaben liefert, wer von den Ausgaben betroffen ist, welche Ausnahmen existieren und wie Beschwerde‑ oder Korrekturmöglichkeiten funktionieren. Datenschutz, Barrierefreiheit, Sicherheit und Fairness gehören zur Problemdefinition, nicht als nachträglicher Gedanke. Eine deterministische Spezifikation ist für exakte Regeln vorzuziehen; Maschinelles Lernen ist geeignet, wenn Muster aus Daten geschätzt werden müssen und Fehler bewertet werden können. Die Entscheidung, nicht zu automatisieren, kann die richtige rechnerische Entscheidung sein.
Lehren und Anwenden der Fähigkeit
Lernende sollten dasselbe Problem mit physischen Schritten, Pseudocode, einer Tabellenkalkulation und Code lösen, um zu sehen, wie Darstellungen das Denken verändern. Projekte sollten Erklärungen und Tests verlangen, nicht nur ein funktionierendes Ergebnis. In Organisationen verbessert Computational Thinking das Schreiben von Anforderungen, das Design von Workflows, die Datenanalyse und die Zusammenarbeit mit Ingenieuren. Sein dauerhafter Wert liegt darin, Annahmen explizit zu machen, einen reproduzierbaren Prozess zu konstruieren und zu erkennen, wo Unsicherheit oder menschliches Urteil verhindern, dass ein Problem auf einen einfachen Algorithmus reduziert werden kann.
Durchgearbeitetes Beispiel: Entwurf eines Schulbus‑Routen‑Algorithmus
Studierende zerlegen die Aufgabe in Haltestellen, Fahrgäste, Kapazität, Zeitfenster, Fahrzeiten, Barrierefreiheit und Sicherheitsbeschränkungen. Sie stellen das Straßennetz als Graph dar, erstellen eine einfache gierige Route und testen sie an kleinen Fällen mit bekannten Lösungen. Grenztests umfassen keine Fahrgäste, eine nicht erreichbare Haltestelle, Fahrzeugausfall und einen Fahrgast, der einen barrierefreien Bus benötigt. Effizienz wird erst nach Korrektheit und Sichtbarkeit der Beschränkungen verglichen.
Die Klasse untersucht dann Kompromisse: Die kürzeste Strecke kann lange Einzelfahrten oder ungleiche Versorgung erzeugen. Sie fügen Fairness‑ und Resilienz‑Metriken hinzu, dokumentieren Annahmen und erlauben Planern, mit einer Begründung zu überschreiben. Persönliche Adressen werden geschützt und Beispieldaten sind synthetisch. Die Übung zeigt, dass Abstraktion Berechnung ermöglicht, aber auch entscheidet, welche menschlichen Bedürfnisse im Modell erscheinen. Computational Thinking beinhaltet das Erkennen, wann ein reines Optimierungsziel einen wichtigen Wert oder Ausnahmefall auslässt.
Implementierungsnachweise und betriebliche Einsatzbereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definiere die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etabliere ein reproduzierbares Baseline‑Set und ein versioniertes Evaluations‑Set, bevor du optimierst. Teste normale Fälle, Grenzbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unterversorgt werden. Miss die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcenkosten, Barrierefreiheit, Datenschutz und Sicherheit. Dokumentiere jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weise Autorität für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutze ein gestaffeltes Rollout, bewahre ein sicheres Fallback und verifiziere das Monitoring mit bewusst injizierten Fehlern. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regelversion, Gesundheitszustand von Abhängigkeiten, menschliche Overrides und bestätigte Ergebnisse offenbaren, ohne unnötige sensible Daten zu sammeln. Definiere Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfe nach dem Deployment reale Evidenz, anstatt anzunehmen, dass Offline‑Leistung bestehen bleibt. Überprüfe erneut, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gewartetes System benötigt zudem dokumentierte Wiederherstellungs‑, Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden sollte.
Häufig gestellte Fragen
Ist Computational Thinking dasselbe wie Codierung?
Nein. Codierung drückt Anweisungen in einer Programmiersprache aus; Computational Thinking umfasst die Problemformulierung, Darstellung, Algorithmus‑Design, Testen und Bewertung.
Kann jedes Problem rechnerisch gelöst werden?
Nein. Einige Probleme sind unentscheidbar oder nicht durchführbar, und viele menschliche Probleme haben mehrdeutige Ziele oder Wertkonflikte, die die Berechnung nicht allein lösen kann.
Primärreferenzen