
Andersons vinkel
Tre udfordringer for Stable Diffusion

 Føj Unite.AI til dine foretrukne kilder på Google
NøglepunkterStable Diffusion har svært ved menneskelige lemmer på grund af utilstrækkeligt…
Vis mere
- Stable Diffusion har svært ved menneskelige lemmer på grund af utilstrækkeligt detaljerede træningsdata-annotationer.
- Flis-baserede opskaleringsteknikker risikerer at producere usammenhængende billeder uden bredere kontekstuel forståelse.
- Modellens oprindelige opløsning på 512x512 begrænser outputkvaliteten og kræver komplekse omgåelser.
Den udgivelse af stability.ai’s billedsyntesemodel Stable Diffusion baseret på latent diffusion , som fandt sted for et par uger siden, kan være en af de vigtigste teknologiske offentliggørelser siden DeCSS i 1999; den er bestemt den største begivenhed inden for AI-genererede billeder siden 2017, hvor deepfakes-koden blev kopieret til GitHub og forgrenet til det, der blev til DeepFaceLab og FaceSwap, samt deepfake-softwaren til streaming i realtid DeepFaceLive.
Med ét blev brugernes frustration over indholdsbegrænsningerne i DALL-E 2’s billedsyntese-API fejet til side, da det viste sig, at Stable Diffusions NSFW-filter kunne slås fra ved at ændre en enkelt kodelinje. Pornofokuserede Stable Diffusion-grupper på Reddit dukkede næsten straks op og blev lukket lige så hurtigt, mens udviklere og brugere delte sig på Discord i officielle fællesskaber og NSFW-fællesskaber. Twitter begyndte at flyde over med fantastiske Stable Diffusion-kreationer.
I øjeblikket synes hver dag at bringe en imponerende innovation fra udviklere, der har taget systemet til sig. Plugins og tredjepartstilføjelser bliver hastigt skrevet til Krita, Photoshop, Cinema4D, Blenderog mange andre applikationsplatforme.
I mellemtiden er kunsten at udforme prompts —den nu professionelle kunst at være »AI-hvisker«, som kan ende med at blive det korteste karrierevalg siden »Filofax-organisator«—allerede ved at blive kommercialiseret, mens den tidlige indtjening på Stable Diffusion sker på Patreon-niveau. Mere avancerede tilbud vil med sikkerhed følge for dem, der ikke ønsker at håndtere Conda-baserede installationer af kildekoden eller de restriktive NSFW-filtre i webbaserede løsninger.
Udviklingen og brugernes frie udforskning foregår så hurtigt, at det er svært at se langt frem. Grundlæggende ved vi endnu ikke præcis, hvad vi har med at gøre, eller hvad alle begrænsninger og muligheder er.
Lad os alligevel se på tre af de måske mest interessante og krævende forhindringer, som det hurtigt dannede og voksende Stable Diffusion-fællesskab må møde og forhåbentlig overvinde.
1: Optimering af behandlingsforløb baseret på billedfliser
Med begrænsede hardwareressourcer og faste grænser for træningsbilledernes opløsning vil udviklere sandsynligvis finde omveje til at forbedre både kvalitet og opløsning af Stable Diffusions output. Mange projekter vil udnytte systemets begrænsninger, såsom dets oprindelige opløsning på blot 512×512 pixels.
Som sædvanligt inden for computersyn og billedsyntese blev Stable Diffusion trænet på kvadratiske billeder, her resamplet til 512×512, så kildebillederne kunne standardiseres og passe inden for begrænsningerne af de GPU’er, der trænede modellen.
Stable Diffusion »tænker« derfor, hvis det overhovedet tænker, i 512×512 og bestemt i kvadrater. Mange brugere, der undersøger systemets grænser, beretter om de mest pålidelige og mindst fejlbehæftede resultater ved dette ret snævre billedformat (se problemerne med lemmer nedenfor).
Selvom forskellige implementeringer har opskalering via RealESRGAN (og kan rette dårligt gengivne ansigter via GFPGAN) udvikler flere brugere metoder til at dele billeder i sektioner på 512×512 pixels og sy dem sammen til større kompositioner.

Denne gengivelse på 1024×576, en opløsning normalt umulig i én Stable Diffusion-gengivelse, blev skabt ved at kopiere Python-filen attention.py fra DoggettX -forgreningen af Stable Diffusion, som implementerer flisebaseret opskalering, ind i en anden forgrening. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Selvom nogle af disse initiativer bruger egen kode eller andre biblioteker, er txt2imghd-porteringen af GOBIG, en tilstand i det VRAM-krævende ProgRockDiffusion, på vej til snart at give hovedgrenen denne funktion. Mens txt2imghd er en særlig portering af GOBIG, bruger andre fællesskabsudviklere forskellige implementeringer af GOBIG.

Et belejligt abstrakt billede i den oprindelige gengivelse på 512×512 pixels (venstre og andet fra venstre); opskaleret med ESGRAN, som nu mere eller mindre er indbygget i alle Stable Diffusion-distributioner; og givet »særlig opmærksomhed« gennem en GOBIG-implementering, der frembringer detaljer, som i hvert fald inden for billedsektionen ser bedre opskalerede ud. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Det abstrakte eksempel ovenfor har mange »små kongeriger« af detaljer, der passer til denne selvcentrerede opskaleringsmetode, men der kan være brug for mere krævende kodebaserede løsninger for at skabe sammenhængende, ikke-gentagende opskalering, som ikke ser ud til at være samlet af mange dele. Det gælder især menneskeansigter, hvor vi er særligt følsomme over for afvigelser og forstyrrende billedfejl. Ansigter kan derfor i sidste ende kræve en særlig løsning.
Stable Diffusion har endnu ingen mekanisme til at fokusere på ansigtet under gengivelsen på samme måde, som mennesker prioriterer ansigtsinformation. Selvom nogle udviklere i Discord-fællesskaberne overvejer metoder til sådan »forstærket opmærksomhed«, er det nu langt lettere at forbedre ansigtet manuelt, og senere automatisk, efter den første gengivelse.
Et menneskeansigt har en indre, komplet semantisk logik, som ikke findes i en »flise« af det nederste hjørne af eksempelvis en bygning. Derfor kan man nu meget effektivt zoome ind og gengive et skitseagtigt ansigt i Stable Diffusions output igen.

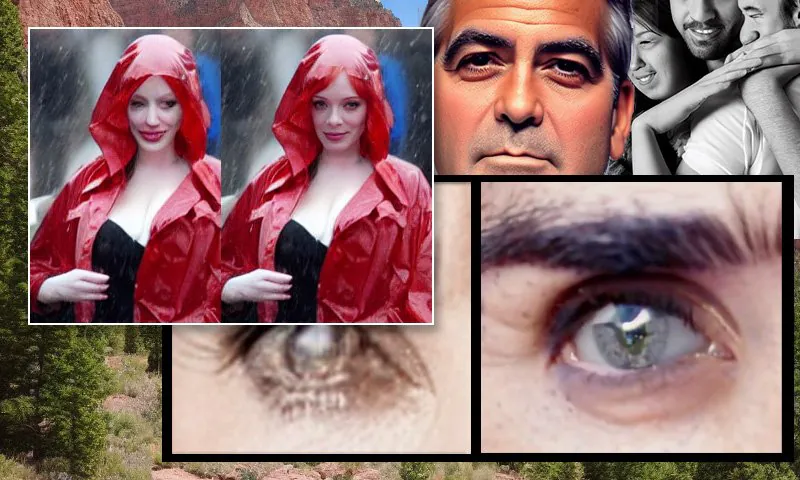
Venstre: Stable Diffusions første forsøg med prompten ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. Højre: et forbedret ansigt, hvor det slørede, skitseagtige ansigt fra første gengivelse via Img2Img fik Stable Diffusions fulde opmærksomhed (se de animerede billeder nedenfor).
Uden en særlig Textual Inversion-løsning (se nedenfor) virker dette kun for kendisbilleder, hvor personen allerede er godt repræsenteret i de LAION-delmængder, som trænede Stable Diffusion. Det gælder derfor personer som Tom Cruise, Brad Pitt, Jennifer Lawrence og en begrænset kreds af ægte mediestjerner, som findes i mange billeder i kildedataene.
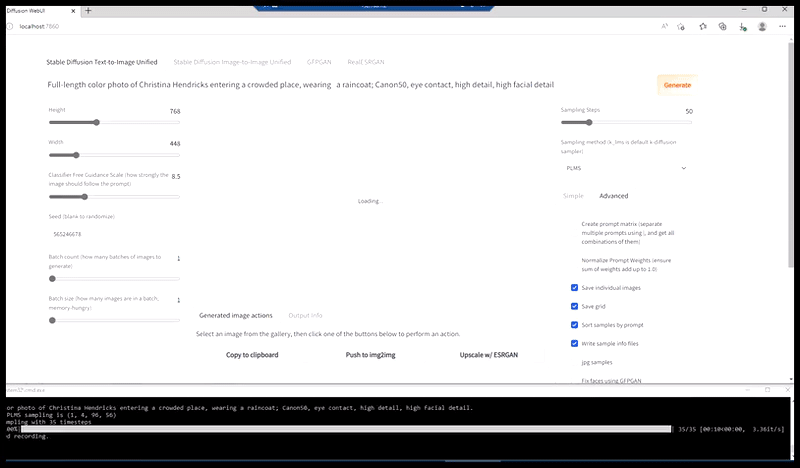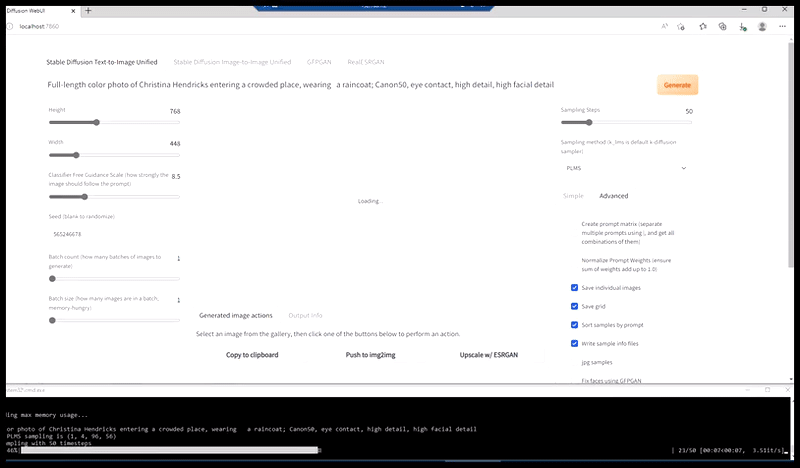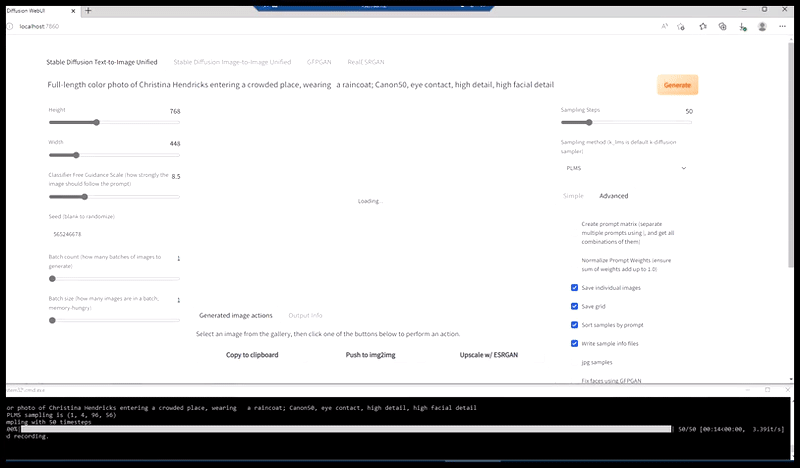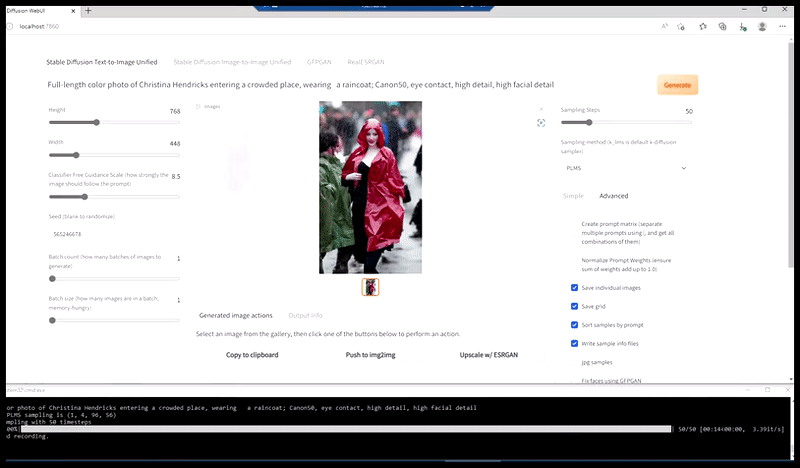
Generering af et plausibelt pressefoto med prompten ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
For kendte med lange, vedvarende karrierer vil Stable Diffusion normalt skabe et billede ved deres nyere, altså højere, alder. Det kræver tilføjelser til prompten såsom ‘young’ eller ‘in the year [YEAR]’ at skabe billeder med et yngre udseende.

Med en fremtrædende, meget fotograferet og stabil karriere på næsten 40 år er skuespilleren Jennifer Connelly en af få kendte i LAION, som lader Stable Diffusion gengive forskellige aldre. Kilde: færdigpakket lokal Stable Diffusion, checkpoint v1.4; aldersrelaterede prompts.
Det skyldes især udbredelsen af digital pressefotografering frem for dyr emulsionsbaseret fotografering fra midten af 2000’erne og den efterfølgende vækst i billedmængden som følge af hurtigere bredbånd.
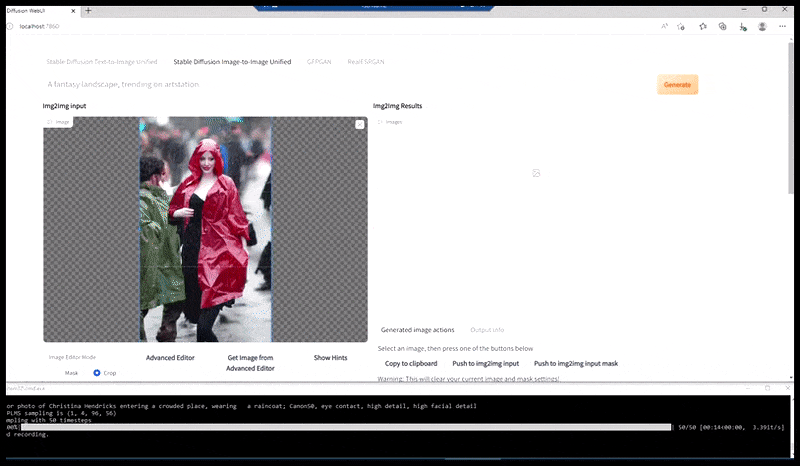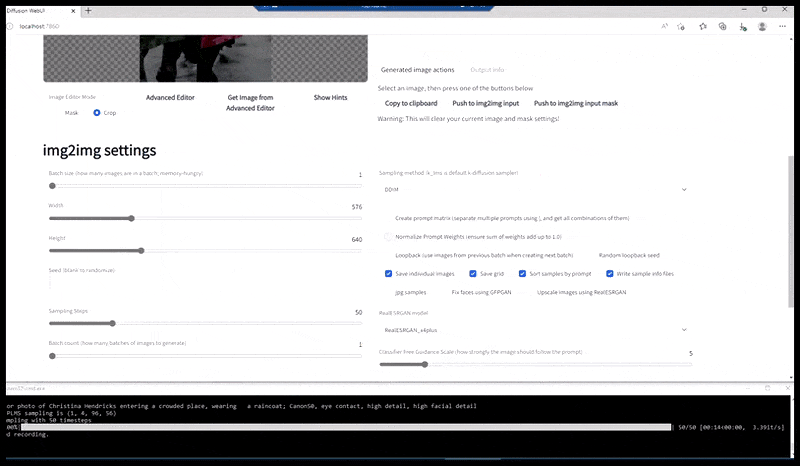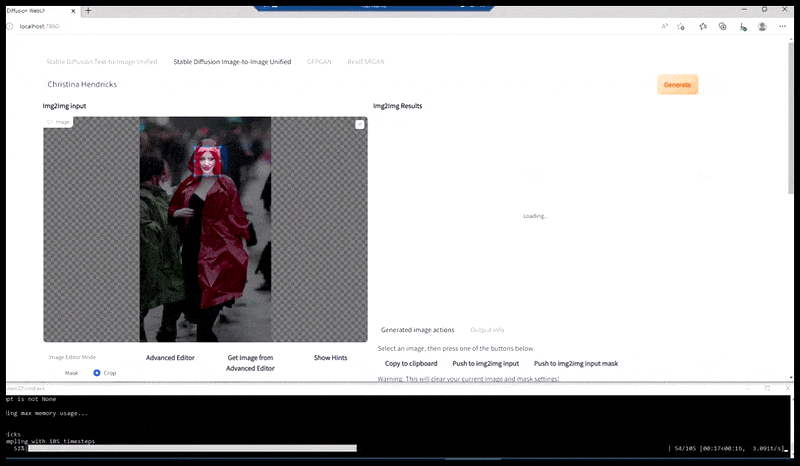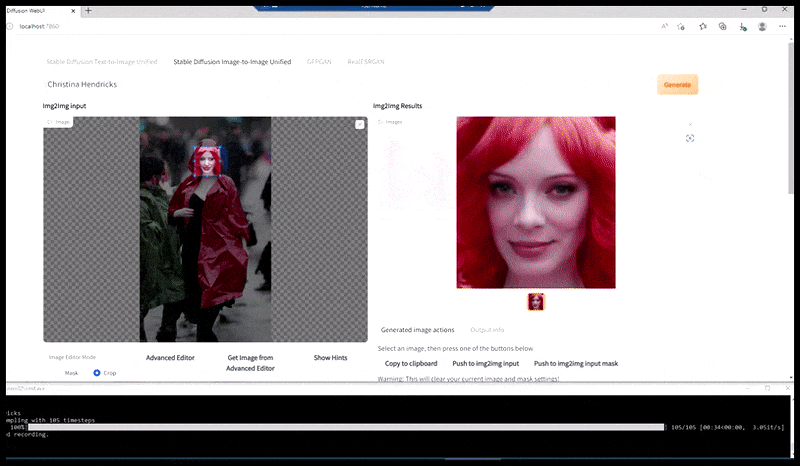
Det gengivne billede sendes til Img2Img i Stable Diffusion, hvor et »fokusområde« vælges. Kun dette område gengives igen i maksimal størrelse, så Stable Diffusion kan bruge alle tilgængelige ressourcer på at genskabe ansigtet.
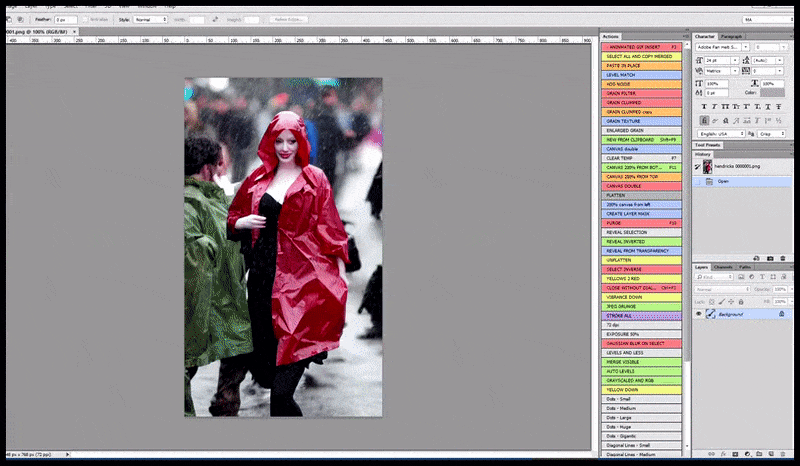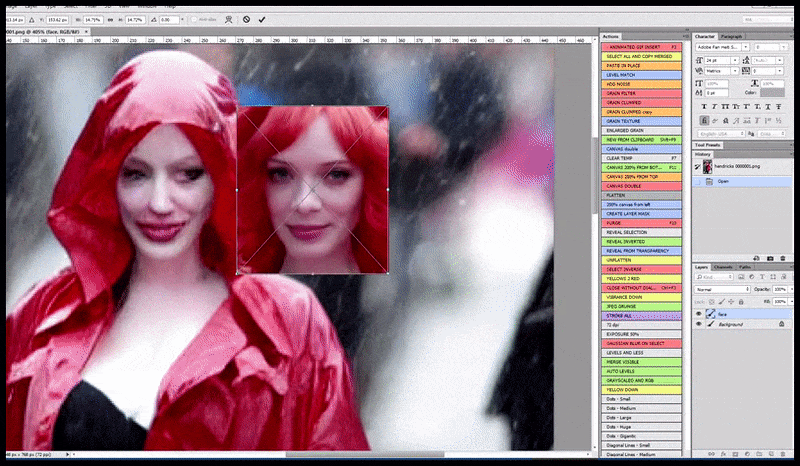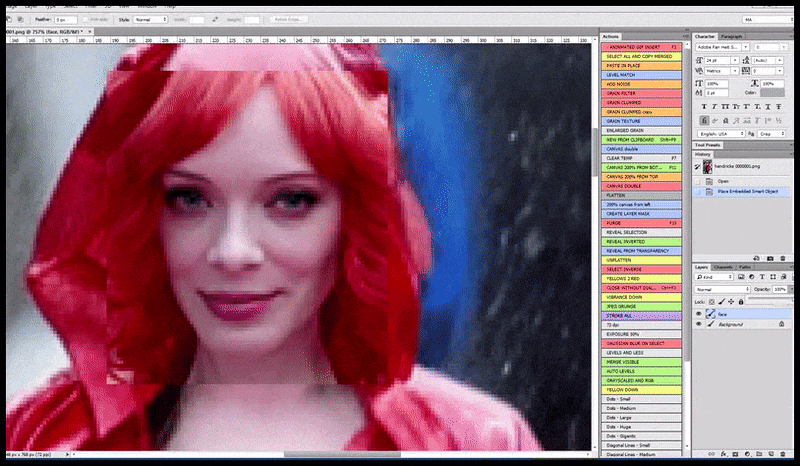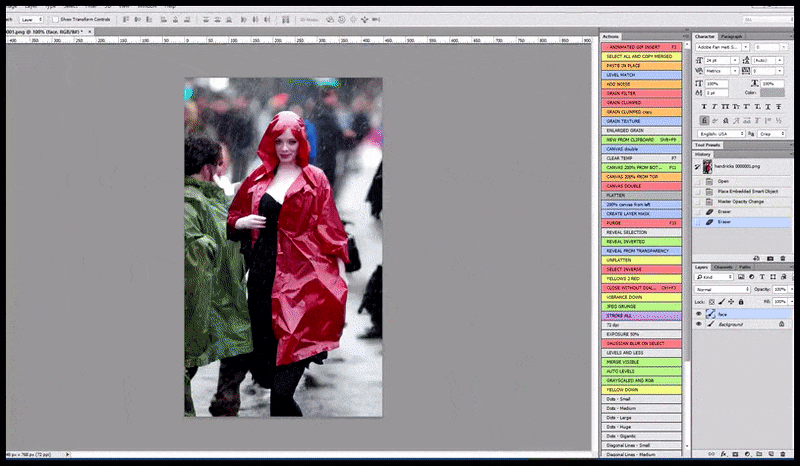
Ansigtet med »høj opmærksomhed« sættes tilbage i den oprindelige gengivelse. Ud over ansigter virker processen kun for ting med et potentielt kendt, sammenhængende og fuldstændigt udseende, eksempelvis et udsnit med et tydeligt objekt som et ur eller en bil. Opskalering af et udsnit af en mur vil give en meget mærkelig sammensat mur, fordi flisegengivelserne manglede den bredere sammenhæng for denne »puslespilsbrik«, da de blev skabt.
Nogle kendte i databasen er på forhånd »frosset« i tiden, enten fordi de døde tidligt, som Marilyn Monroe, eller kun var bredt berømte kortvarigt og derfor fik mange billeder i en begrænset periode. Forespørgsler til Stable Diffusion kan siges at give en slags »aktuelt« popularitetsindeks for moderne og ældre stjerner. For nogle ældre og nuværende kendte er der ikke nok kildebilleder til en særlig god lighed, mens den vedvarende popularitet hos bestemte forlængst døde eller falmede stjerner sikrer, at systemet kan skabe en rimelig lighed.

Stable Diffusion-gengivelser afslører hurtigt, hvilke berømte ansigter der er godt repræsenteret i træningsdataene. Trods sin enorme popularitet som ældre teenager på skrivetidspunktet var Millie Bobby Brown yngre og mindre kendt, da LAION-kildedataene blev indsamlet fra nettet. Derfor er en meget vellignende gengivelse med Stable Diffusion stadig vanskelig.
Når data findes, kan flisebaserede opskaleringsløsninger i Stable Diffusion gå videre end blot at fokusere på ansigtet. De kan give endnu mere præcise, detaljerede ansigter ved at opdele ansigtstrækkene og rette hele de lokale GPU-ressourcers kraft mod de enkelte fremtrædende træk før samling. Også denne proces er endnu manuel.

Det er ikke begrænset til ansigter, men til dele af objekter, som er mindst lige så forudsigeligt placeret i den større sammenhæng omkring hovedobjektet, og som svarer til repræsentationer på højt niveau, man rimeligt kan forvente at finde i et datasæt i meget stor skala.
Den virkelige grænse er mængden af tilgængelige referencedata, fordi dybt gentagne detaljer til sidst bliver helt »hallucinerede«, altså opdigtede, og mindre autentiske.
Sådanne finkornede forstørrelser på højt niveau virker for Jennifer Connelly, fordi hun er godt repræsenteret i mange aldre i LAION-aesthetics , den primære delmængde af LAION 5B , som Stable Diffusion bruger, og generelt i LAION. I mange andre tilfælde ville præcisionen lide under datamangel, hvilket kræver finjustering, altså yderligere træning (se »Tilpasning« nedenfor), eller Textual Inversion (se nedenfor).
Fliser er en stærk og forholdsvis billig måde at få Stable Diffusion til at producere højopløseligt output. Men algoritmisk fliseopskalering uden en bredere opmærksomhedsmekanisme på højere niveau kan komme til kort over for de forventede standarder på tværs af forskellige indholdstyper.
2: Løsning af problemer med menneskelige lemmer
Stable Diffusion lever ikke op til sit navn, når det afbilder kompleksiteten i menneskers yderste kropsdele. Hænder kan formere sig tilfældigt, fingre flyde sammen, et tredje ben dukke uventet op og eksisterende lemmer forsvinde sporløst. Til dets forsvar deler det problemet med lignende modeller og bestemt med DALL-E 2.

Uredigerede resultater fra DALL-E 2 og Stable Diffusion (1.4) sidst i august 2022, begge med problemer med lemmer. Prompten er ‘A woman embracing a man’.
Stable Diffusion-entusiaster, der håber, at det kommende checkpoint 1.5, en mere intensivt trænet model med forbedrede parametre, vil løse forvirringen om lemmer, bliver sandsynligvis skuffede. Den nye model, som udkommer om cirka to uger, vises allerede på stability.ai’s kommercielle portal DreamStudio, som anvender 1.5 som standard. Her kan brugerne sammenligne de nye resultater med gengivelser fra deres lokale eller andre 1.4-systemer:

Kilde: færdigpakket lokal 1.4 og https://beta.dreamstudio.ai/

Kilde: færdigpakket lokal 1.4 og https://beta.dreamstudio.ai/

Kilde: færdigpakket lokal 1.4 og https://beta.dreamstudio.ai/
Som så ofte kan datakvaliteten være den vigtigste medvirkende årsag.
De åbne databaser, som forsyner billedsyntesesystemer som Stable Diffusion og DALL-E 2, kan give mange etiketter for både enkeltpersoner og handlinger mellem mennesker. Disse etiketter trænes symbiotisk ind sammen med de tilhørende billeder eller billedsegmenter.

Stable Diffusion-brugere kan undersøge modellens indlærte begreber ved at søge i LAION-aesthetics, en delmængde af det større LAION 5B-datasæt, som driver systemet. Billederne er sorteret efter deres »æstetiske score«, ikke alfabetisk efter etiketter. Kilde: https://rom1504.github.io/clip-retrieval/
Et godt hierarki af enkelte etiketter og klasser, som bidrager til at afbilde en menneskearm, ville være noget i retning af body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

Finkornet semantisk segmentering af håndens dele. Selv denne usædvanligt detaljerede opdeling lader hver »finger« være en enkelt enhed uden at tage højde for fingerens tre afsnit og tommelfingerens to. Kilde: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
I virkeligheden er kildebillederne næppe annoteret så konsekvent gennem hele datasættet. Algoritmer til uovervåget mærkning vil sandsynligvis stoppe på det højere niveau, eksempelvis »hånd«, og efterlade de indre pixels, som teknisk indeholder fingerinformation, som en umærket masse. Derfra udledes træk vilkårligt, og de kan i senere gengivelser fremstå som forstyrrende elementer.

Hvordan det burde være (øverst til højre, hvis ikke en uppercut), og hvordan det ofte er (nederst til højre), på grund af begrænsede mærkningsressourcer eller arkitekturens udnyttelse af sådanne etiketter, hvis de findes i datasættet.
Hvis en latent diffusionsmodel når til at gengive en arm, vil den derfor næsten sikkert forsøge at gengive en hånd for enden af den, fordi arm>hand er det nødvendige minimumshierarki, ret højt i arkitekturens viden om »menneskelig anatomi«.
Derefter kan »fingre« være den mindste gruppe, selvom der er 14 yderligere finger- og tommelfingerdele at overveje ved afbildning af menneskehænder.
Hvis teorien holder, findes ingen reel kur på grund af branchens manglende budget til manuel annotering og manglen på tilstrækkeligt effektive algoritmer til automatisk mærkning med lave fejlrater. Modellen kan i øjeblikket være afhængig af menneskets anatomiske regelmæssighed for at dække over manglerne i træningsdataene.
En mulig grund til, at den ikke kan stole på dette, blev for nylig foreslået på Stable Diffusions Discord: modellen kan være forvirret over det korrekte antal fingre på en realistisk menneskehånd, fordi den LAION-baserede database indeholder tegnefilmsfigurer med færre fingre (hvilket i sig selv er en arbejdsbesparende genvej).

To mulige syndere bag »manglende finger«-syndromet i Stable Diffusion og lignende modeller. Nedenfor: eksempler på tegnefilmshænder fra LAION-aesthetics, som driver Stable Diffusion. Kilde: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Hvis det er sandt, er den eneste oplagte løsning at genoptræne modellen uden urealistisk menneskebaseret indhold og sikre, at reelle tilfælde af manglende lemmer, eksempelvis amputerede personer, mærkes korrekt som undtagelser. Alene fra et datakurateringsperspektiv er det en stor udfordring, især for ressourcesvage fællesskabsprojekter.
Den anden tilgang er filtre, som udelukker sådant indhold, eksempelvis »hånd med tre/fem fingre«, fra at dukke op under gengivelsen, på omtrent samme måde som OpenAI til en vis grad har filtreret GPT-3 og DALL-E 2, så deres output kan reguleres uden at genoptræne kildemodellerne.

I Stable Diffusion kan den semantiske forskel mellem fingre og selv lemmer blive uhyggeligt udvisket, hvilket minder om 1980’ernes »body horror«-strømning i gyserfilm fra instruktører som David Cronenberg. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Igen ville det dog kræve etiketter, som måske ikke findes for alle berørte billeder, så den samme logistiske og budgetmæssige udfordring består.
Man kan hævde, at der er to veje tilbage: mere data til problemet og fortolkende tredjepartssystemer, som kan gribe ind, når sådanne fysiske fejl præsenteres for slutbrugeren. Det sidste ville i det mindste give OpenAI en måde at refundere »body horror«-gengivelser på, hvis virksomheden ønskede det.
3: Tilpasning
En af de mest spændende muligheder for Stable Diffusions fremtid er, at brugere eller organisationer kan udvikle reviderede systemer. Ændringerne vil integrere indhold uden for den forudtrænede LAION-sfære, ideelt uden ukontrollable omkostninger ved at træne hele modellen igen eller risikoen ved at træne en stor mængde nye billeder ind i en eksisterende, moden og dygtig model.
Som sammenligning: Hvis to mindre dygtige elever kommer ind i en avanceret klasse med tredive elever, vil de enten tilpasse sig og indhente de andre eller falde igennem som undtagelser. Klassens gennemsnit bliver sandsynligvis ikke påvirket i nogen af tilfældene. Hvis 15 mindre dygtige elever kommer ind, vil karakterfordelingen for hele klassen derimod sandsynligvis blive dårligere.
Tilsvarende kan det synergistiske og ret følsomme netværk af relationer, som opbygges gennem vedvarende og dyr modeltræning, blive svækket eller i visse tilfælde reelt ødelagt af for mange nye data, så outputkvaliteten falder over hele linjen.
Argumentet for dette gælder især, når målet er helt at overtage modellens begrebsmæssige forståelse af relationer og ting og bruge den udelukkende til indhold, der ligner det ekstra materiale.
Træning med 500.000 Simpsons -billedrammer i et eksisterende Stable Diffusion-checkpoint vil derfor sandsynligvis i sidste ende give en bedre Simpsons -simulator end den oprindelige modelversion, forudsat at nok brede semantiske relationer overlever processen (f.eks. Homer Simpson eating a hotdog, som kan kræve materiale om hotdogs, der ikke var i det tilføjede materiale, men allerede fandtes i checkpointet). Og forudsat at du ikke pludselig vil gå fra Simpsons -indhold til at skabe fabulous landscape by Greg Rutkowski —fordi den eftertrænede models opmærksomhed er blevet kraftigt omdirigeret, og den ikke vil være så god til den slags som før.
Et bemærkelsesværdigt eksempel er waifu-diffusion, som med held har eftertrænet med 56.000 animebilleder i et færdigt, trænet Stable Diffusion-checkpoint. Det er dog en svær opgave for en hobbybruger, da modellen kræver mindst 30GB VRAM, langt over det, der sandsynligvis vil være tilgængeligt på forbrugerniveau i NVIDIAs kommende 40XX-serie.

Træning af tilpasset indhold i Stable Diffusion via waifu-diffusion: Modellen brugte to ugers eftertræning for at nå dette illustrationsniveau. De seks billeder til venstre viser fremskridtet under træningen i at skabe motivmæssigt sammenhængende output på baggrund af de nye data. Kilde: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Der kan bruges meget arbejde på sådanne forgreninger af Stable Diffusion-checkpoints, blot for at blive bremset af teknisk gæld. Udviklere på det officielle Discord har allerede oplyst, at senere checkpoints ikke nødvendigvis bliver bagudkompatible, selv med promptlogik som virkede i en tidligere version. Deres primære interesse er den bedst mulige model frem for støtte til gamle applikationer og processer.
En virksomhed eller person, der forgrener et checkpoint til et kommercielt produkt, har derfor reelt ingen vej tilbage: Modelversionen er da en »hard fork« og vil ikke kunne trække forbedringer ind fra senere stability.ai-udgivelser. Det er en betydelig forpligtelse.
Det nuværende og større håb for tilpasning af Stable Diffusion er Textual Inversion, hvor brugeren træner med en lille håndfuld billeder tilpasset CLIP.

Textual Inversion er et samarbejde mellem Tel Aviv Universitet og NVIDIA, som gør det muligt at træne nye, særskilte enheder ind uden at ødelægge kildemodellens evner. Kilde: https://textual-inversion.github.io/
Den væsentligste synlige begrænsning ved Textual Inversion er, at et meget lille antal billeder anbefales, måske blot fem. Det giver en begrænset enhed, som kan være mere nyttig til stiloverførsel end til indsættelse af fotorealistiske objekter.
Der foregår dog forsøg i de forskellige Stable Diffusion-fællesskaber på Discord med langt flere træningsbilleder. Det er endnu uvist, hvor produktiv metoden vil være. Igen kræver teknikken meget VRAM, tid og tålmodighed.
På grund af begrænsningerne må vi måske vente lidt på mere avancerede Textual Inversion-forsøg fra Stable Diffusion-entusiaster, og på at se om metoden kan »sætte dig ind i billedet« bedre end klip-og-klistre i Photoshop, samtidig med at den bevarer de officielle checkpoints’ imponerende funktioner.
Først udgivet den 6. september 2022.


