
AGI og fremtidens AI
Rollen af Vektor-Databaser i Moderne Generative AI-Anvendelser

 Føj Unite.AI til dine foretrukne kilder på Google

For store skala Generative AI-anvendelser til at fungere effektivt, har de brug for et godt system til at håndtere en masse data. Et sådant vigtigt system er vektor-databasen. Det, der adskiller denne database fra andre, er dens evne til at håndtere mange typer data som tekst, lyd, billeder og videoer i en numerisk/væktor-form.
Hvad er Vektor-Databaser?
Vektor-databasen er et specialiseret lagringssystem designet til at håndtere høj-dimensionelle vektorer effektivt. Disse vektorer, som kan betragtes som punkter i et multi-dimensionelt rum, repræsenterer ofte indlejring eller komprimerede repræsentationer af mere komplekse data som billeder, tekst eller lyd.
Vektor-databaser tillader hurtige lignende søgninger blandt disse vektorer, hvilket muliggør hurtig hentning af de mest lignende elementer fra en stor dataset.
Traditionelle Databaser vs. Vektor-Databaser
Vektor-Databaser:
- Håndtering af Høj-Dimensionel Data: Vektor-databaser er designet til at håndtere og gemme data i høj-dimensionelle rum. Dette er særligt nyttigt for anvendelser som maskinlæring, hvor datapunkter (såsom billeder eller tekst) kan repræsenteres som vektorer i multi-dimensionelle rum.
- Optimeret til Lignende Søgning: En af de mest fremtrædende funktioner ved vektor-databaser er deres evne til at udføre lignende søgninger. I stedet for at søge efter data baseret på nøjagtige match, tillader disse databaser brugerne at hente data, der er “lignende” en given forespørgsel, hvilket gør dem uvurderlige for opgaver som billed- eller teksthentning.
- Skalérbarhed for Store Datasets: Da AI- og maskinlæringsanvendelser fortsætter med at vokse, så gør også mængden af data, de behandler. Vektor-databaser er bygget til at skalere, hvilket sikrer, at de kan håndtere store mængder data uden at gå på kompromis med ydeevnen.
Traditionelle Databaser:
- Struktureret Data-Gemme: Traditionelle databaser, som relationelle databaser, er designet til at gemme struktureret data. Dette betyder, at data er organiseret i foruddefinerede tabeller, rækker og kolonner, hvilket sikrer data-integritet og konsistens.
- Optimeret til CRUD-Operationer: Traditionelle databaser er primært optimeret til CRUD-operationer. Dette betyder, at de er designet til at effektivt oprette, læse, opdatere og slette data-poster, hvilket gør dem egnede til en bred vifte af anvendelser, fra webtjenester til virksomhedssoftware.
- Fast Skema: En af de definerende karakteristika ved mange traditionelle databaser er deres faste skema. Når databasens struktur er defineret, kan ændringer være komplekse og tidskrævende. Denne rigiditet sikrer data-konsistens, men kan være mindre fleksibel end det skema-løse eller dynamiske skema-natur af nogle moderne databaser.
Traditionelle databaser kæmper ofte med kompleksiteten af indlejring, en udfordring, der let kan håndteres af vektor-databaser.
VEktor-Repræsentationer
Centralt for vektor-databasers funktion er det grundlæggende begreb om at repræsentere forskellige former for data ved hjælp af numeriske vektorer. Lad os tage et billede som eksempel. Når du ser et billede af en kat, kan det for en maskine transformereres til en unik 512-dimensionel vektor, såsom:
[0,23, 0,54, 0,32, …, 0,12, 0,45, 0,90]
Med vektor-databaser kan Generative AI-anvendelser udføre mere. Den kan finde information baseret på mening og huske ting i lang tid. Interessant nok er denne metode ikke begrænset til billeder alene. Tekstdata fyldt med kontekstuelle og semantiske betydninger kan også transformereres til vektorformer.
Generative AI og Behovet for Vektor-Databaser
Generative AI indebærer ofte indlejring. Tag for eksempel ord-indlejring i naturlig sprogbehandling (NLP). Ord eller sætninger transformereres til vektorer, der fanger semantisk betydning. Når der genereres menneske-lignende tekst, har modellerne brug for at sammenligne og hente relevante indlejring hurtigt, hvilket sikrer, at den genererede tekst fastholder kontekstuelle betydninger.
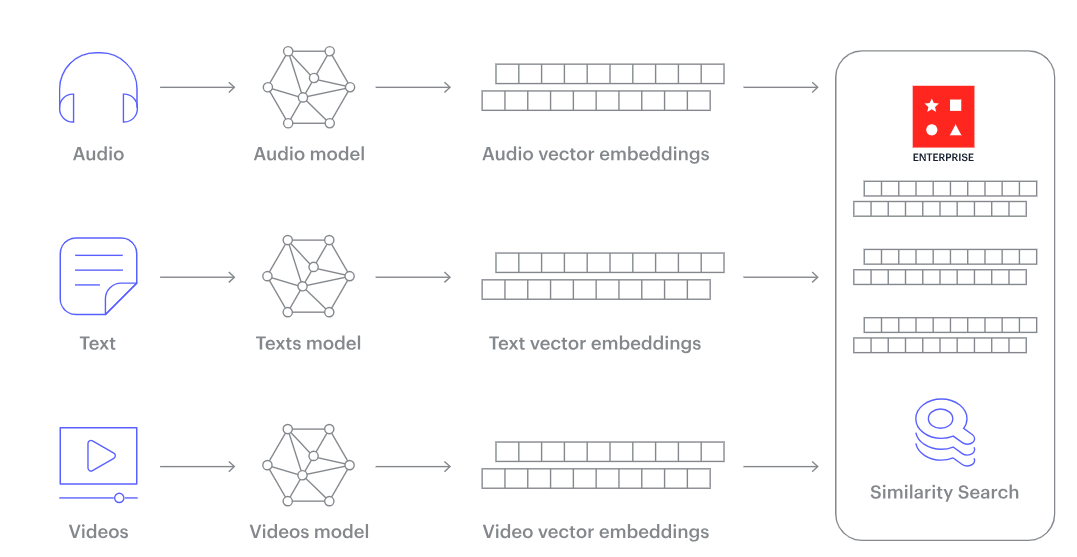
På samme måde i billed- eller lyd-generering spiller indlejring en afgørende rolle i kodning af mønstre og funktioner. For at disse modeller kan fungere optimalt, kræver de en database, der tillader øjeblikkelig hentning af lignende vektorer, hvilket gør vektor-databaser til en essentiel komponent i Generative AI-puslen.
Oprettelse af indlejring for naturligt sprog indebærer ofte brug af forudtrænede modeller såsom:
- GPT-3 og GPT-4: OpenAI’s GPT-3 (Generative Pre-trained Transformer 3) har været et monumentalt model i NLP-fællesskabet med 175 milliarder parametre. Følgende GPT-4, med endnu flere parametre, fortsætter med at udvide grænserne i oprettelse af højkvalitets-indlejring. Disse modeller er trænet på diverse datasæt, hvilket giver dem mulighed for at oprette indlejring, der fanger en bred vifte af lingvistiske nuancer.
- BERT og dets Varianter: BERT (Bidirectional Encoder Representations from Transformers) af Google er et andet betydningsfuldt model, der har set diverse opdateringer og iterationer som RoBERTa og DistillBERT. BERT’s bidirectional træning, der læser tekst i begge retninger, er særligt egnet til at forstå konteksten omkring et ord.
- ELECTRA: Et mere nyt model, der er effektivt og performer på niveau med meget større modeller som GPT-3 og BERT, mens det kræver færre beregningsressourcer. ELECTRA diskriminerer mellem ægte og falsk data under fortræning, hvilket hjælper med at oprette mere raffinerede indlejring.

Forståelse af ovenstående proces:
Initialt anvendes en indlejring-model til at transformere det ønskede indhold til vektor-indlejring. Når disse indlejring er oprettet, gemmes de herefter i en vektor-database. For let tilgængelighed og relevans opretholdes der en reference eller henvisning til det oprindelige indhold, de er afledt fra.
Senere, når en bruger eller system stiller et spørgsmål til anvendelsen, springer den samme indlejring-model i aktion. Den transformerer dette spørgsmål til korresponderende indlejring. Disse nyanlagte indlejring søger herefter i vektor-databasen efter lignende vektor-repræsentationer. De indlejring, der identificeres som match, har en direkte association med deres oprindelige indhold, hvilket sikrer, at brugerens spørgsmål mødes med relevante og præcise resultater.
Øget Finansiering til Vektor-Database-Nykommerne
Med AI’s stigende popularitet investerer mange virksomheder mere i vektor-databaser for at forbedre deres algoritmer og gøre dem hurtigere. Dette kan ses med de seneste investeringer i vektor-database-startups som Pinecone, Chroma DB og Weviate.

Store virksomheder som Microsoft (MSFT ) har også deres egne værktøjer. For eksempel tillader Azure Cognitive Search virksomheder at oprette AI-værktøjer ved hjælp af vektor-databaser.
Oracle (ORCL ) har også nyligt annonceret nye funktioner til sin Database 23c, der introducerer en integreret vektor-database. Navngivet “AI Vector Search”, vil den have en ny datatyp, indekser og søgeværktøjer til at gemme og søge gennem data som dokumenter og billeder ved hjælp af vektorer. Den understøtter Retrieval Augmented Generation (RAG), der kombinerer store sprogmodeller med virksomhedsdata for bedre svar på sprogspørgsmål uden at dele private data.
Primære Overvejelser for Vektor-Databaser
Afstands-Malinger
Effektiviteten af en lignende søgning afhænger af den valgte afstands-måling. Almindelige målinger inkluderer Euclidisk afstand og cosinus-lighed, hver især tilpasset forskellige typer vektorfordelinger.
Indeksering
Givet den høj-dimensionelle natur af vektorer, fungerer traditionelle indekseringsmetoder ikke. Vektor-databaser anvender teknikker som Hierarkisk Navigabel Lille Verden (HNSW) grafer eller Annoy-træer, der muliggør effektiv opdeling af vektor-rummet og hurtige nærmeste-nabo-søgninger.

Annoy-træ (Kilde)
Annoy er en metode, der anvender binære søgetræer. Den opdeler vores dataspace mange gange og ser kun på en del af den for at finde nære naboer.
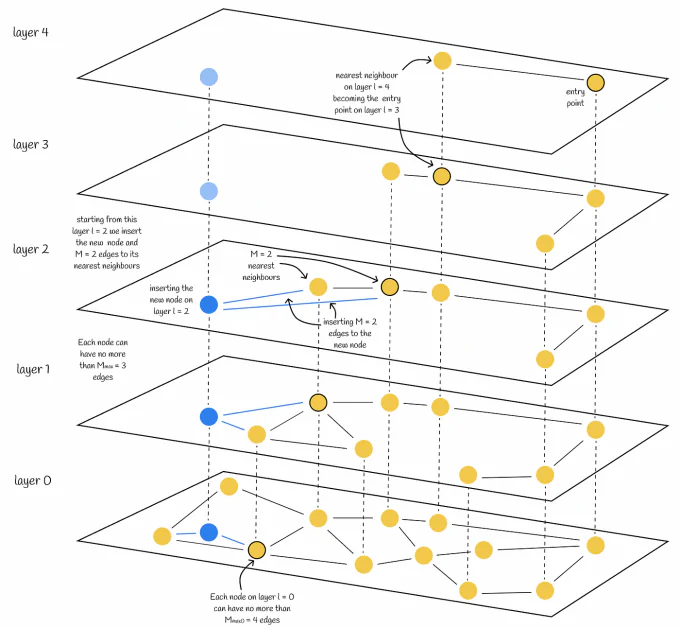
Hierarkisk Navigabel Lille Verden (HNSW) grafer (Kilde)
HNSW-grafer, på den anden side, er som netværk. De forbinder datapunkter på en særlig måde for at gøre søgningen hurtigere. Disse grafer hjælper med at finde nære punkter i data hurtigt.
Skalérbarhed
Da datasæt vokser, vokser også udfordringen med at opretholde hurtige hentningstider. Distribuerede systemer, GPU-acceleration og optimeret hukommelsesstyring er nogle måder, hvorpå vektor-databaser tackler skalérbarhed.
Rollen af Vektor-Databaser: Konsekvenser og Muligheder
1. Træningsdata for Avancerede Generative AI-Modeller: Generative AI-modeller, såsom DALL-E og GPT-3, trænes ved hjælp af enorme mængder data. Disse data består ofte af vektorer, der er ekstraheret fra en mangfoldighed af kilder, herunder billeder, tekst, kode og andre domæner. Vektor-databaser kuraterer og administrerer disse datasæt omhyggeligt, hvilket giver AI-modellerne mulighed for at assimilere og analysere verdens viden ved at identificere mønstre og relationer inden for disse vektorer.
2. Fremme af Få-Shot-Læring: Få-shot-læring er en AI-træningsteknik, hvor modeller trænes med begrænsede data. Vektor-databaser forstærker denne tilgang ved at opretholde en robust vektor-indekset. Når en model udsættes for kun et par vektorer – sagen om et par billeder af fugle – kan den hurtigt ekstrapolere det bredere begreb om fugle ved at genkende lignende mønstre og relationer mellem disse vektorer.
3. Forbedring af Anbefalings-Systemer: Anbefalings-systemer anvender vektor-databaser til at foreslå indhold, der er tæt på brugerens præferencer. Ved at analysere brugerens adfærd, profil og forespørgsler, ekstraheres vektorer, der er repræsentative for deres interesser. Systemet søger derefter i vektor-databasen for at finde indhold-vektorer, der ligner disse interesse-vektorer, hvilket sikrer præcise anbefalinger.
4. Semantisk Informationssøgning: Traditionelle søgemetoder afhænger af nøjagtige nøgleordsmatch. Vektor-databaser giver imidlertid systemer mulighed for at forstå og hente indhold baseret på semantisk lighed. Dette betyder, at søgninger bliver mere intuitive, fokuserer på den underliggende mening bag forespørgslen i stedet for kun at matche ord.
5. Multimodal Søgning: Multimodal søgning er en opkomende teknik, der integrerer data fra multiple kilder, såsom tekst, billeder, lyd og video. Vektor-databaser fungerer som rygmarven i denne tilgang ved at tillade kombineret analyse af vektorer fra forskellige modaliteter. Dette resulterer i en holistisk søgeoplevelse, hvor brugere kan hente information fra en række kilder baseret på en enkelt forespørgsel, hvilket fører til rigere indsigt og mere omfattende resultater.
Konklusion
AI-verden udvikler sig hurtigt. Den berører mange brancher, bringer gode ting og nye udfordringer med sig. De hurtige fremskridt i Generative AI understreger den væsentlige rolle, vektor-databaser spiller i håndtering og analyse af multi-dimensionel data.
Disse specialiserede lagringssystemer, der er dygtige til at håndtere høj-dimensionelle vektorer fra forskellige dataformer som billeder, tekst eller lyd, står som en central del i den effektive funktion af moderne AI-anvendelser, især i området af lignende søgninger.


