
Interviews
Nikunj Bajaj, medstifter og administrerende direktør i TrueFoundry – Interviewserie

 Føj Unite.AI til dine foretrukne kilder på Google
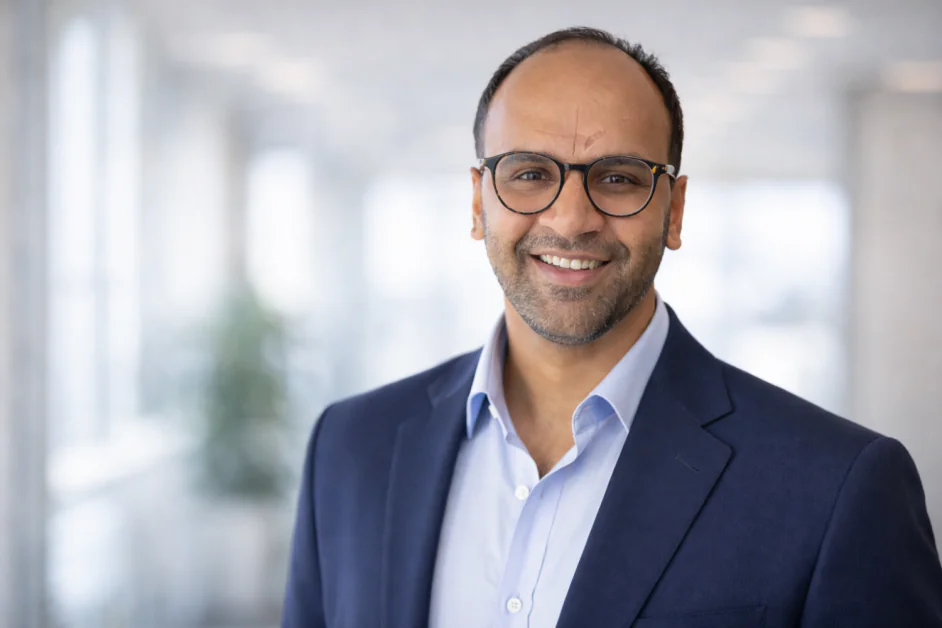
Før du grundlagde TrueFoundry, arbejdede du med forskning i maskinlæring, AI i produktion hos Facebook (META ) og anbefalingssystemer i stor skala. Hvilke erfaringer førte dig mest direkte til at bygge en virksomhed med AI-infrastruktur til virksomheder, og hvilket problem oplevede du ikke blev løst dengang?
Hos Meta betragtede vi maskinlæring som et særtilfælde af software og generativ AI som et særtilfælde af maskinlæring. Det gav en vertikal teknologistak med software nederst, maskinlæring i midten og generativ AI øverst. Hvis jeg er udvikler inden for maskinlæring i denne opsætning, følger de modeller, jeg bygger, samme mønster for idriftsættelse som resten af softwaren. Det gør det meget enkelt at skalere systemerne.
De fleste virksomheder satte imidlertid parallelle stakke i drift, altså separate stakke til software, maskinlæring og generativ AI. Med disse parallelle stakke bliver skalering mere kompleks på grund af de nødvendige overdragelser mellem maskinlæring og softwareområdet.
Vores team har altid arbejdet i krydsfeltet mellem udvikling af maskinlæringsmodeller og maskinlæringsinfrastruktur. Det gav os et særligt perspektiv: Vi kunne bringe lignende vertikale stakke ind i virksomheder og tilpasse dem til deres specifikke krav. Mod slutningen af 2021 havde vi også en hypotese om, at maskinlæring nærmede sig et vendepunkt. Når det skete, ville flere virksomheder få brug for en vertikalt integreret stak til effektivt at sætte disse systemer i drift og skalere dem. Det førte os i sidste ende til at grundlægge TrueFoundry, og vores hypotese viste sig at holde. Indførelsen af AI tog fart efter lanceringen af ChatGPT i slutningen af 2022.
Hvad har ændret sig i den måde, organisationer bør tænke om pålidelighed og fejl, efterhånden som AI-systemer bevæger sig fra eksperimenter til den daglige drift?
Der er betydeligt mere på spil med generativ AI end med traditionelle maskinlæringssystemer. Når disse systemer kommer i produktion, står organisationer over for langt større tvetydighed og ikkedeterminisme, fordi LLM’er er stokastiske af natur. Agentbaserede systemer, der bygger oven på dem, tilføjer yderligere tvetydighed.
Desuden er fejl ikke længere binære. Det handler ikke længere blot om, hvorvidt et system virker eller ej; mange problemer viser sig som delvise fejl eller forringelser, der sker i det skjulte. Over tid kan systemer svare med højere latenstid, ringere kvalitet eller forkert adfærd. I mange tilfælde er disse forringelser sværere at opdage og undertiden endda mere skadelige end et fuldstændigt nedbrud.
Organisationer skal tænke på pålidelighed både i forhold til oppetid og i forhold til forringelse af ydeevnen over tid.
TrueFailover blev lanceret midt i en bølge af forstyrrelser i cloud- og AI-tjenester, der fik stor opmærksomhed. Hvilke nylige begivenheder gjorde det klart, at AI-pålidelighed havde bevæget sig fra at være en ønskelig ekstra egenskab til et centralt arkitekturkrav?
En af vores kunder i sundhedssektoren behandler patientanmodninger om recepter i realtid, hvor det er afgørende at reagere rettidigt. Kunden blev ramt af et driftsstop, som skyldtes en fejl i en model. Kundens arbejdsgange genererer tusindvis af dollars i omsætning i sekundet, og driftsstoppet forstyrrede nogle af disse kritiske arbejdsgange. Kunden var blandt de første brugere af TrueFailover, så vi kunne hjælpe med hurtigt at genoprette driften og begrænse konsekvenserne.
Hændelser som denne rejser et vigtigt spørgsmål: Når der er stadig mere på spil med generative AI-systemer, hvorfor er processerne til genoprettelse så stadig overvejende manuelle? Det styrkede tanken om, at systemer skal bygges med udgangspunkt i, at fejl vil ske, og designes til automatisk at rette sig selv. Pålidelighed skal også indbygges i selve AI-stakken gennem AI-gateways, der kan levere centraliseret routing, observerbarhed, sikkerhedsforanstaltninger og intelligent skift mellem modeller fra forskellige udbydere.
Mange AI-driftsstop beskrives stadig som små tekniske problemer. Hvor ser du de reelle økonomiske og menneskelige omkostninger begynde at vise sig, når AI-systemer går ned?
AI i virksomheder har udviklet sig så langt, at disse problemer ikke længere kun påvirker interne arbejdsgange. I dag påvirker driftsstop og forringelser offentlighedens opfattelse og indtjeningen direkte og øjeblikkeligt, fordi anvendelserne i produktion nu betjener kunderne. Dette skift fra interne test til offentligt tilgængelige applikationer, hvor der er meget på spil, er grunden til, at vi ser et øget behov for opmærksomhed og tilsyn fra topledelsen.
Efterhånden som AI-systemer integreres dybere i de operationelle arbejdsgange, er driftsstop ikke længere blot tekniske problemer. De får i stigende grad direkte konsekvenser for forretningen, kunderne og omdømmet.
Hvor hurtigt kan AI-nedetid udvikle sig til en driftsrisiko eller en risiko for omdømmet i driftskritiske miljøer som apoteker, sundhedsydelser eller kundesupport?
I driftskritiske miljøer sker eskaleringen næsten øjeblikkeligt, fordi disse systemer understøtter arbejdsgange i realtid, hvor rettidig behandling er afgørende. Selv en kort afbrydelse kan standse kritiske processer, forsinke leveringen af ydelser eller afbryde efterfølgende systemer, der er afhængige af disse resultater, og dermed skabe en kædereaktion af driftsmæssige konsekvenser i hele organisationen.
I sektorer som sundhedsvæsenet rækker konsekvenserne ud over driftsforstyrrelsen og påvirker også kundeoplevelsen og resultaterne af ydelserne. Hvis en patient ikke kan få udleveret sin receptmedicin til tiden, kan det få reelle konsekvenser. Det er ikke kun et problem for patienten; det kan også skade apotekets eller sundhedsudbyderens omdømme. I driftskritiske miljøer, hvor tillid spiller en rolle, er det altafgørende, at systemerne forbliver i drift. Derfor erkender organisationer i stigende grad, at AI-systemer skal designes med udgangspunkt i, at fejl vil opstå, og at genoprettelsesmekanismer skal aktiveres automatisk for at minimere risikoen.
Du har sagt, at mange teams designer arkitektur med fokus på kapabiliteter frem for kontinuitet. Hvorfor tror du, at modstandsdygtighed historisk har haft lavere prioritet i designet af AI-systemer?
Det skyldes i høj grad incitamenterne i organisationerne. Nye kapabiliteter er synlige og spændende. De åbner for demonstrationer, funktioner og nye produktmuligheder, som ledelsen kan se med det samme.
Kontinuitet er per definition usynlig, når alt fungerer godt. Derfor belønner incitamentsstrukturer ofte lanceringen af nye funktioner mere end det at sikre, at intet går i stykker. Som følge heraf investerer organisationer ofte uforholdsmæssigt meget i udvikling af kapabiliteter sammenlignet med det tekniske arbejde med at sikre modstandsdygtighed.
Hvilke nye sårbarheder i AI-stakken kan ledere stadig undervurdere, efterhånden som virksomheder bliver mere afhængige af eksterne modeller og API’er?
LLM’er er grundlæggende delte ressourcer, og virksomheder ejer dem ikke, som de ejer traditionel infrastruktur. Desuden kører vigtige forretningskritiske systemer i virksomheder på eksterne systemer, der endnu ikke er fuldt afprøvet over tid. LLM’erne selv udvikler sig hurtigt, hvilket betyder, at en modeludbyder ikke kan holdes ansvarlig for ting som latenstid eller et mindre fald i modellens ydeevne, fordi udbyderen meget hurtigt gennemfører nye iterationer af sin forskning.
Fordi LLM’er er delte ressourcer, kan latenstiden stige brat, når en anden bruger af dem udfører en bestemt handling. LLM’ernes grundlæggende natur medfører mange af disse fejlpunkter, og virksomheder har ganske enkelt ikke fuld kontrol i denne nye verden. Uden fuld kontrol er det bedste, en virksomhed kan gøre, at skabe tilstrækkelig redundans i systemet til at designe et modstandsdygtigt system.
Uden at fokusere på bestemte produkter: Hvordan bør organisationer gentænke AI-arkitektur, så de tager højde for, at fejl vil ske, i stedet for at behandle driftsstop som sjældne særtilfælde?
Organisationer bør vende tilbage til de grundlæggende principper for design af distribuerede systemer. Softwaresystemer blev bygget med udgangspunkt i, at netværkskomponenter og maskiner ville fejle, og at en hel region kunne gå ned.
AI-systemer bør ikke være anderledes. Vi bør antage, at modeludbydere vil opleve latenstidsproblemer, forringelser eller driftsstop, og indbygge redundans, så applikationerne forbliver modstandsdygtige i forskellige fejlscenarier.
Forventer du, at AI-modstandsdygtighed bliver en afgørende faktor i valget af platform og udbyder, ligesom oppetid og redundans har præget beslutninger om cloudinfrastruktur?
Når flere AI-systemer kommer i produktion, bliver modstandsdygtighed et minimumskrav. Hvis en udbyder ikke kan fremvise grafer og målinger for oppetid og samlet modstandsdygtighed, vil udbyderen slet ikke blive taget i betragtning. Når modstandsdygtighed bliver en grundlæggende forventning til alle udbydere, vil de afgørende faktorer flytte sig til brugeroplevelse, optimering af ydeevnen, observerbarhed og produktets kapabiliteter på højere niveau. Med tiden vil komponenter som en AI-gateway og automatisk failover blive centrale grundelementer i virksomheders AI-infrastruktur.
Hvad betyder “produktionsklar” AI egentlig fremover i en verden, hvor AI forventes at være tilgængelig hele tiden og ikke blot nyttig en gang imellem?
Produktionsklare AI-systemer skal kunne observeres, styres og genoprettes. Alle tre krav skal være opfyldt.
For at AI i produktion kan observeres, skal teams have dyb indsigt i modellernes adfærd, latenstid, fejlrater, tokenforbrug, drift og fejlmønstre. Uden stærk observerbarhed bliver det meget svært at opdage forringelser, før brugerne begynder at bemærke dem.
Muligheden for at styre systemer omfatter trafikregulering, begrænsning af forespørgselsraten, sikkerhedsforanstaltninger, håndhævelse af politikker og intelligent routing mellem modeller og udbydere. Her bliver en AI-gateway et grundelement, der fungerer som et centraliseret styringslag: Det håndhæver sikkerhedsforanstaltninger, sikrer ensartet governance og muliggør dynamisk skift mellem modeller, når ydeevnen eller pålideligheden falder.
Endelig skal systemer kunne genoprettes og derfor bygges med udgangspunkt i, at komponenter kan være delvist eller helt ude af funktion, uanset om årsagen er driftsstop hos udbyderen, forringet modelkvalitet, grænser for forespørgselsraten eller uventede input fra ondsindede aktører. Automatisk failover og mekanismer til selvreparation bør være indbygget i arkitekturen frem for at bero på manuelle procedurer, der først aktiveres, efter at noget er gået galt.
Det er den retning, vi arbejder i hos TrueFoundry. Udbydere, der definerer produktionsklarhed på denne måde ved at kombinere observerbarhed, centraliseret styring og automatisk genoprettelse, vil opnå kundernes tillid på lang sigt og kunne fortsætte med at løse nye problemer, efterhånden som de opstår.
Tak for det gode interview. Læsere, der ønsker at vide mere, kan besøge TrueFoundry.


