
Interviews
Dr. Mathilde Pavis, juridisk chef, OpenOrigins – Intervieuserie

 Føj Unite.AI til dine foretrukne kilder på Google
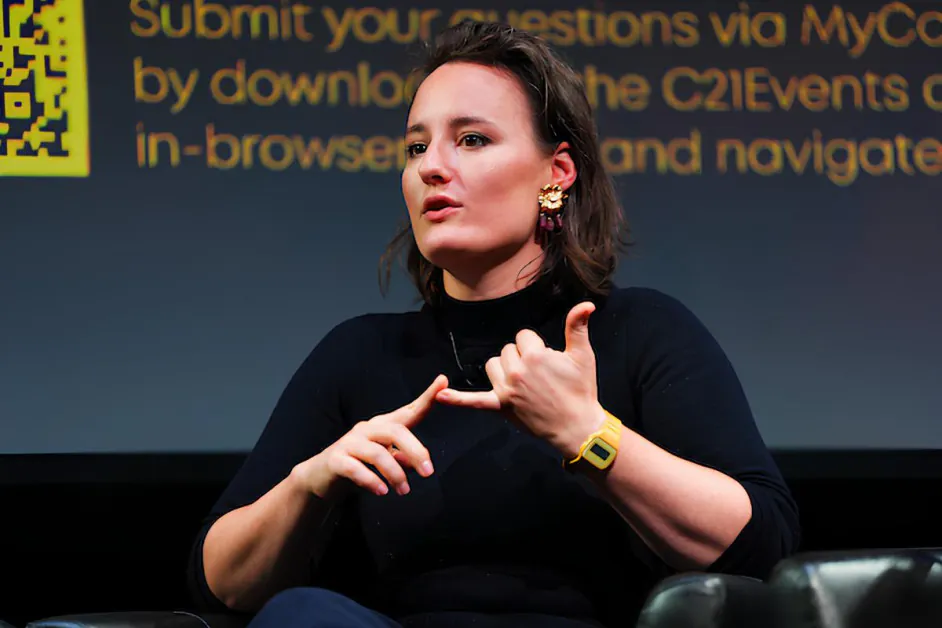
Dr. Mathilde Pavis, juridisk chef hos OpenOrigins, er en førende ekspert i AI-regulering og digital mediestyring, med speciale i deepfakes, syntetisk medie og indholdshistorik. Hun rådgiver virksomheder, regeringer og fagforeninger om overholdelse, licensering og risiko i generativ AI, og har arbejdet med Microsoft (MSFT ) og ElevenLabs på AI-politik og strategi. Hun har også rådgivet UNESCO om AI og immaterielle rettigheder, og bidrager regelmæssigt med ekspertvidnesbyrd til britiske beslutningstagere.
OpenOrigins udvikler teknologi til at bekæmpe misinformationskampagner og deepfakes ved at oprette verificerbare, uforfalskede optegnelser over digitalt indhold. Deres platform fokuserer på at etablere en klar historik, der giver medier, skabere og platforme mulighed for at bevise, hvornår og hvordan indhold er blevet skabt, redigeret og distribueret – en stadig mere kritisk evne, da syntetisk medie bliver mere avanceret og sværere at opdage.
De har rådgivet regeringer, globale institutioner som UNESCO og virksomheder som Microsoft og ElevenLabs om AI-regulering. Hvad førte til, at de fokuserede specifikt på deepfakes, digitale kopier og syntetisk medie, og hvordan formede den rejse deres beslutning om at grundlægge Replique?
Mit arbejde med deepfakes begyndte ikke med teknologien – det begyndte med et meget ældre juridisk puslespil. Da jeg startede med at forskere i immaterielle rettigheder til min ph.d. i 2013, blev jeg slået af, hvor lidt beskyttelse udførere får i forhold til forfattere, komponister eller filminstruktører. I praksis betyder det, at dine ord eller din musik bliver bedre beskyttet i loven end din stemme, dit ansigt og din krop. Denne ubalance føltes underlig, og det fik mig til at stille et dybere spørgsmål: Hvordan værdisætter vi kulturelt og juridisk arbejdet med en person, hvis bidrag er deres ansigt, stemme og krop på skærmen?
Det spørgsmål førte mig ind i udførernes rettigheder og data. På det tidspunkt blev det betragtet som et nicheområde med lidt kommerciel relevans. Jeg blev aktivt rådet til at gå over i mere “lucrative” felter som patenter eller traditionel ophavsret. Antagelsen var, at spørgsmål om en persons lighed eller stemme i hovedsagen blev håndteret uformelt – gennem branchenormer eller “gentlemens aftaler i Hollywood”. Men for mig signalerede manglen på formel beskyttelse en åbning, ikke en død ende for min forskning, så jeg fortsatte med det.
Hvad der er ændret, er, at næsten alle i dag er udførere. Vores liv er formidlet gennem kameraer – på telefoner, bærbare computere, videokald og sociale platforme. Uanset om det er til arbejde eller personligt brug, optager og deler folk konstant versioner af sig selv. De juridiske spørgsmål, der tidligere kun gjaldt skuespillere eller musikere, gælder nu for alle med en smartphone.
Deepfakes skabte ikke disse problemer – de afslørede og accelererede dem. Den forskning, jeg havde bedrevet fra 2013 og frem, blev pludselig presserende. Omkring 2017 og 2018 begyndte udviklingen inden for neurale netværk – især fra steder som MIT og UC Berkeley – at demonstrere, hvor overbevisende en persons ansigt, stemme og krop kunne digitalt manipuleres. Inden for et år blev denne evne bredt kendt som “deepfakes”, og den fik først trækkraft på en dybt skadelig måde, især gennem ikke-samtykkende seksuelt indhold, der var rettet mod kvinder og børn.
Først senere opstod de kommercielle implikationer, da de kreative industrier begyndte at antage syntetisk medie. Det var, da de kontraktmæssige og økonomiske spørgsmål, jeg havde arbejdet med, kom til syne. Det, der havde været set som et teoretisk eller doktrinært område af loven, blev pludselig et højst praktisk, kommercielt betydningsfuldt og socialt presserende felt.
I sin kerne har den juridiske udfordring ikke ændret sig: Folk vil dele aspekter af sig selv, men ønsker stadig at beholde meningsfuld kontrol. Eksisterende rammer kæmper med den nuance. De tenderer til at behandle individer som enten fuldstændig private eller fuldstændig offentlige – enten beskyttet eller fair game. Men de fleste mennesker eksisterer et sted imellem. Den spænding er nu central, ikke kun for professionelle udførere, men for alle, der deltar i digitalt liv.
Jeg blev kendt som en person, der forskede og arbejdede i dette område, hvilket førte til, at jeg arbejdede med regeringer, der var interesseret i at beskytte mennesker mod deepfakes, og virksomheder, der ønskede at gøre digitale kloner sikre at bruge, som ElevenLabs. Hos Replique bringer jeg alt, hvad jeg har lært, til mennesker og virksomheder, der ønsker at bruge digital kloning eller digital replica-teknologi ansvarligt og sikkert. Jeg har grundlæggende omdannet min “blue sky”-forskning til en rådgivningsvirksomhed, der bringer specialiseret juridisk rådgivning til de kreative industrier.
Som juridisk chef hos OpenOrigins, en virksomhed, der fokuserer på at etablere en uforfalskbar optegnelse over indholdshistorik for at bekæmpe deepfakes, hvordan ser du på, at proveniensbaserede systemer konkurrerer med eller erstatter traditionelle deepfake-detektionsmetoder?
At sammenligne deepfake-detektionsværktøjer kan hurtigt blive en æble-til-æble-øvelse, fordi deres effektivitet afhænger af kontekst og formål. Fra en politisk synsvinkel har vi brug for en række komplementære værktøjer – der er ingen enkelt “bedst” løsning, og OpenOrigins er kun en del af det bredere økosystem. Hvor OpenOrigins’ teknologi står ud som en deepfake-detektionsløsning, er i situationer, hvor en indholdsskaber eller informationsorganisation har brug for at bevise indholdets ægthed for partnere, publikum eller offentligheden.
Ved at give verificerbar proveniens og “kvitteringer” ved skabelsestidspunktet tilbyder det en stærk form for forebyggelse ved at demonstrere, at indholdet ikke er en deepfake. Men denne tilgang er mindre nyttig for almindelige internetbrugere, der ønsker at hurtigt vurdere indhold, de møder online. I disse tilfælde afhænger detektion mere af sandsynlighedsbaserede og indholdsanalytiske metoder end proveniensbaseret verificering. Vi har brug for forskellige værktøjer til forskellige behov, og vi må acceptere, at der ikke er nogen sølvkugle mod deepfakes.
Set fra et juridisk synspunkt, hvad er i øjeblikket den største åbning i, hvordan jurisdiktioner håndterer samtykke og ejerskab i AI-genereret eller AI-reproduceret indhold?
Øv, hvor lang tid har du? Svaret afhænger af, hvad vi mener med AI-genereret eller reproduceret indhold. Problemerne varierer, afhængigt af, om vi ser på en AI-genereret billed af et hus eller en kat. Eller en digital genskabelse af en persons ansigt eller stemme. Lad os holde os til emnet om deepfakes og digital kloning, og svare på dit spørgsmål i konteksten af “digital kloning”.
Når det gælder samtykke, er det centrale problem, at de fleste kontrakter – enten ansættelsesaftaler eller platformsvilkår – indeholder brede, vage klausuler, der giver omfattende rettigheder over brugerindhold. Disse kan fortolkes som en form for “bagdør-samtykke”, hvor accept af vilkår kan opfattes som samtykke til brug som kloning, selvom de fleste mennesker ville stærkt bestride denne fortolkning. Dette skaber en betydelig åbning mellem juridisk fortolkning og brugerforventning, en åbning, der i øjeblikket gavner virksomheder, mens reguleringen kommer til at ligge efter.
Når det gælder ejerskab, er der ingen klar juridisk besked på, hvem der ejer en digital klon, fordi eksisterende rammer som dataværn, ophavsret og personlige rettigheder ikke var designet til denne teknologi. I dag bliver de fleste mennesker skannet og klonet på arbejdspladsen, på opfordring og med finansiering fra en arbejdsgiver eller en kunde. Og disse enheder forventer som regel en høj grad af kontrol over denne ejendom, hvilket er forståeligt, men ofte problematisk, fordi denne ejendom er en digital imitation af dit ansigt eller din stemme og kan få dig til at sige ting, du aldrig har sagt, eller gøre ting, du aldrig har gjort.
Spørgsmålet om “hvem ejer din klon?” er meget vigtigt, men ubesvaret i loven i dag.
De har arbejdet tæt på taleklon-teknologier. Hvad er de mest misforståede juridiske risici, når det gælder syntetiske stemmer, både for virksomheder og individer?
Det mest misforståede problem i juridisk overholdelse er balancen mellem en virksomheds kommercielle interesse i at finansiere og udnytte en digital klon og en persons ret til privatliv og digital værdighed. Denne spænding ligger på tværs af flere juridiske regimer (primært immaterielle rettigheder, dataværn og privatliv), der aldrig var designet til at fungere sammen og fortolker kloning på fundamentalt forskellige måder. Som følge heraf er det komplekst og ofte uklart at oversætte dette til fungerende, virksomhedsvenlige praksis. Virksomheder overseer derfor ofte væsentlige risici eller pådrager sig betydelige omkostninger for at navigere dem ordentligt. Dette skaber en pervers udgang, hvor ansvarlig overholdelse bliver den svære, dyre vej, snarere end standarden.
Hvordan skal virksomheder tænke om samtykkearkitektur i AI-systemer, især når det handler om lighed, identitet og træningsdata?
Virksomheder skal designe deres systemer omkring tre kernekapaciteter. Først skal de sikre informeret, kontekstuel samtykke ved onboarding. Anden skal de gøre det let for brugere at trække samtykke tilbage og slette nogle eller alle deres data, noget, der er teknisk udfordrende og ofte overset, men afgørende for overholdelse af love som den britiske og EU’s GDPR og lignende regimer i USA. Vedligeholdelse af samtykke over tid indebærer opbygning af systemer, hvor tilbagetrækning er operationsmæssigt glat og i overensstemmelse med forretningsmodellen.
Samtykke skal være detaljeret. Og tredje, skal brugere kunne styre tilladelser på niveauet for enkeltfiler, opdatere deres lighedsdata og forstå, hvordan det bruges. Dette kræver gennemsigtighed og kontrol – værktøjer, der giver brugerne mulighed for at overvåge, gennemgå og moderere, hvordan deres digitale kloner er anvendt. Denne niveau af fleksibilitet er stadig sjælden, men det er, hvor den konkurrencemæssige fordel ligger.
I deres erfaring med at rådgive både startups og regeringer, hvor er den største åbning mellem, hvordan AI bliver bygget, og hvordan det bliver reguleret?
Den åbning mellem, hvordan AI bliver bygget, og hvordan det bliver reguleret, kommer ned til fundamentalt forskellige missioner. Regeringer regulerer i offentlighedens interesse, mens AI-virksomheder (ofte venturefinansierede) primært drives af vækst, omsætning og profit. Disse prioriteringer er ikke altid i konflikt, men de trækker ofte i forskellige retninger, med regulering set som en begrænsning snarere end en støtte.
Dette skaber en strukturel spænding: Regulatorer og innovatører opererer med forskellige incitamenter, værdier og sprog. Det gør det svært at opnå harmoni i praksis, selvom det ikke er umuligt. Vi begynder at se en ny bølge af teknologivirksomheder, der nærmer sig mere offentlighedens mål, men de er stadig undtagelsen snarere end reglen – især blandt dem, der succesfuldt skalerer.
OpenOrigins fokuserer på at verificere indhold ved skabelsestidspunktet ved hjælp af kryptografisk proveniens. Hvordan kritisk er denne “først-til-origo”-tilgang sammenlignet med efter-distributions-sikkerhedsforanstaltninger?
Dette løber tilbage til mit svar ovenfor. At autentificere indhold ved skabelse, “upstream”, er langt mere effektivt end at forsøge at verificere det ved distributions- eller forbrugstidspunktet, dvs. “downstream”. At autentificere indhold ved skabelse er som at spore mad fra det øjeblik, det dyrkes på en farm, snarere end at forsøge at afgøre det ud fra, hvad der er på din tallerken. Hvis du ved, hvor kyllen blev opdrættet, hvordan den blev behandlet, og hvordan den blev ført gennem forsyningskæden, kan du stole på, hvad du spiser. Hvis du i stedet forsøger at slutte alt dette af det færdige måltid, er du afhængig af gætteri. Det er det samme med at skelne mellem menneskeskabt og AI-genereret indhold online: Proveniens ved kildepunktet giver dig verificerbar sikkerhed, mens downstream-detektion er inherernt mere usikker og reaktiv.
Hvad er rollen for standarder som C2PA i fremtidens medie, og er de tilstrækkelige i sig selv til at genskabe tillid online?
C2PA er en velkommen initiativ, og på mange måder støtter den samme bevægelse for indholdssikkerhed og indholdssærlighed som OpenOrigins. De er en vigtig del af indholdssikkerheds- og indholdssærlighedsøkosystemet. Som med alle sikkerhedsværktøjer er der ingen sølvkugle.
For skabere og talenter i brancher som film, musik og spil, hvilke praktiske skridt skal de tage i dag for at beskytte sig selv mod uautoriseret digital reproduktion?
Kunstnere i dag står over for to distinkte risici: Reproduktionen af deres arbejde (såsom musik, billeder eller skrift) og reproduktionen af deres lighed, herunder deres ansigt, stemme og krop. Med minimalt input kan AI-systemer nu reproducere begge med en høj grad af troværdighed. I praktisk forstand begynder beskyttelse med at være bevidst om, hvad man deler online, og erkende, at ethvert indhold, der offentliggøres, kan blive skrabet og brugt i træningsdata uden tydeligt samtykke eller indsigt.
Denne risiko er nu en basal realitet for at operere online. Men den mere umiddelbare og kontrollerbare risiko ligger ofte i kontrakter. Aftaler, kunstnere indgår med deres samarbejdspartnere, distributører eller platforme, kan indeholde klausuler, der tillader AI-brug, genbrug eller salg af indhold til træningsformål – ofte uden væsentlig deltagelse i efterfølgende omsætning.
For kunstnere gør dette kontraktgennemgang kritisk. At forstå, hvordan deres arbejde og lighed kan bruges, licenseres eller genbruges, er nu lige så vigtigt som den kreative proces selv. Meget af den nuværende debat (over fagforeninger, brancheforeninger og platforme) handler om at korrigere denne ubalance og sikre, at skabere beholder både kontrol og fair kompensation.
Så to vigtige råd: Vær omhyggelig med, hvad du deler online, og læs dine kontrakter og find AI-klausuler, før du underskriver.
Set fremad på tre til fem år, tror du, vi vil nå et punkt, hvor hvert stykke digitalt indhold skal bære verificerbar proveniens, eller vil tillid forblive fragmenteret på tværs af platforme og jurisdiktioner?
Jeg ville gerne sige ja, men realistisk, nej – ikke inden for fem år. I teknologi føles fem år langt; i forhold til at ændre brugeradfærd og vaner er det meget kort. De fleste forbrugere er usandsynligt at basere deres beslutninger på, om indhold kommer med autentificeret proveniens. Platforme følger brugerkrav, optimerer til engagement snarere end proveniens.
Det kunne ændre sig, hvis reguleringen griber ind. Vi ser allerede tidlige bevægelser i steder som Californien, hvor mærknings- og modereringskrav dukker op, men at skale det globalt vil tage tid – sandsynligvis tættere på en årti end fem år.
Et andet område for ændring er sektorspecifikt: Brancher som journalistik, finans, forsikring og sundhedspleje kan begynde at kræve proveniens og autentificering, fordi tillid er grundlæggende for deres drift.
Sidst, men ikke mindst, kan forbrugere ikke bekymre sig om proveniensinformation i den korte tid, men de vil sandsynligvis bekymre sig om indholdskvalitet og informationskvalitet. Hvis AI-genereret indhold bliver for ensartet eller “fladt”, kan publikum begynde at værdsætte menneskeskabt indhold mere eksplicit. Det kunne drive en segmentation af markedet, hvor nogle platforme prioriterer skala og AI-genereret indhold, og andre kuraterer for ægthed, proveniens og høj-tillid, menneskeledet materiale – men den ændring forbliver en ukendt.
Tak for dine store svar, læsere, der ønsker at lære mere, skal besøge OpenOrigins.


