
AI-modeller og platforme
Mistral AI: Sætter nye standarder udover Llama2 i open-source-rummet

 Føj Unite.AI til dine foretrukne kilder på Google

Large Language Models (LLM’er) har for nylig taget center-scenen, takket være fremragende præstationer som ChatGPT. Da Meta introducerede deres Llama-modeller, fik det fornyet interesse for open-source LLM’er. Formålet? At skabe billigere, open-source LLM’er, der er lige så gode som topmodeller som GPT-4, men uden den høje pris eller kompleksitet.
Dette mix af billigere og effektivere åbner ikke kun nye veje for forskere og udviklere, men sætter også scenen for en ny æra af teknologiske fremskridt i naturlig sprogbehandling.
For nylig har generative AI-startups været på rulle med finansiering. Together hævede $20 millioner, med målet at forme open-source AI. Anthropic hævede også en imponerende $450 millioner, og Cohere, i partnerskab med Google Cloud, sikrede $270 millioner i juni i år.
Introduktion til Mistral 7B: Størrelse og Tilgængelighed

Mistral AI, der er baseret i Paris og co-founded af tidligere ansatte fra Google’s DeepMind og Meta, annoncerede deres første store sprogmodel: Mistral 7B. Denne model kan let downloades af alle fra GitHub og endda via en 13,4-gigabyte torrent.
Dette startup lykkedes med at sikre rekordbrydende seed-finansiering, selv før de havde et produkt ud. Mistral AI’s første model med 7 milliarder parametre overgår Llama 2 13B i alle tests og slår Llama 1 34B i mange metrikker.
I sammenligning med andre modeller som Llama 2, tilbyder Mistral 7B lignende eller bedre funktioner, men med mindre beregningsmæssig overhead. Mens grundlæggende modeller som GPT-4 kan opnå mere, kommer de til en højere pris og er ikke så brugervenlige, da de primært er tilgængelige via API’er.
Når det kommer til kodningstasks, giver Mistral 7B CodeLlama 7B en chance for sin penge. Plus, det er kompakt nok til at køre på standardmaskiner.
Dertil kommer, at Mistral 7B Instruct, der er finjusteret specifikt for instruktionsdata på Hugging Face, har vist god præstation. Det overgår andre 7B-modeller på MT-Bench og står skulder til skulder med 13B-chat-modeller.

Hugging Face Mistral 7B Eksempel
Præstationsbenchmarking
I en detaljeret præstationsanalyse blev Mistral 7B målt op imod Llama 2-familien. Resultaterne var klare: Mistral 7B overgik betydeligt Llama 2 13B på alle benchmarks. Faktisk matcher det præstationen af Llama 34B, især i kode- og resonemementsbenchmarks.
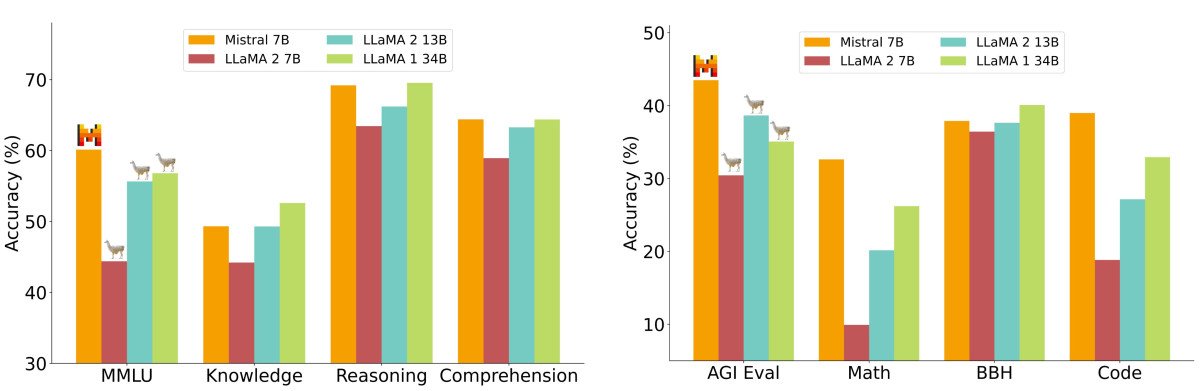
Benchmarkene var organiseret i flere kategorier, såsom Commonsense Reasoning, World Knowledge, Reading Comprehension, Math og Code, blandt andre. En særlig værdig bemærkning var Mistral 7B’s omkostningspræstationsmetrik, kaldet “ækvivalent modelstørrelse”. I områder som resonemement og forståelse viste Mistral 7B en præstation lignende en Llama 2-model tre gange sin størrelse, hvilket betyder potentielle besparelser i hukommelse og en øgning i gennemløbstid. Men i videnbenchmarks ligner Mistral 7B tæt Llama 2 13B, hvilket sandsynligvis skyldes dens parameterbegrænsninger, der påvirker videnkomprimering.
Hvad gør egentlig Mistral 7B-modellen bedre end de fleste andre sprogmodeller?
Forenkling af opmærksomhedsmekanismer
Mens detaljerne i opmærksomhedsmekanismer er tekniske, er den grundlæggende idé relativt enkel. Forestil dig, at du læser en bog og markerer vigtige sætninger; dette er analogt med, hvordan opmærksomhedsmekanismer “markerer” eller giver vigtighed til bestemte data punkter i en sekvens.
I sammenhæng med sprogmodeller muliggør disse mekanismer, at modellen kan fokusere på de mest relevante dele af inputdata, så outputtet er koherent og kontekstligt præcist.
I standardtransformatorer beregnes opmærksomheds-score med formlen:

Transformers Attention Formula
Formlen for disse score involverer et afgørende trin – matrixmultiplikation af Q og K. Udfordringen her er, at når sekvenslængden vokser, udvides både matricer derefter, hvilket fører til en beregningsintensiv proces. Dette skalbarhedsproblem er en af de største årsager til, at standardtransformatorer kan være langsomme, især når de har med lange sekvenser at gøre.

Multi-query opmærksomhed (MQA) accelererer processen ved at bruge ét sæt ‘nøgle-værdi’-hoveder, men ofrer iblandt kvaliteten. Nu kan du undre dig over, hvorfor ikke kombinere MQA’s hastighed med multi-hoved opmærksomheds kvalitet? Det er her, hvor Grupperet-opmærksomhed (GQA) kommer ind.
Grupperet-opmærksomhed (GQA)

Grupperet-opmærksomhed
GQA er en midtergrundsløsning. I stedet for at bruge kun ét eller flere ‘nøgle-værdi’-hoveder, grupperer det dem. På denne måde opnår GQA en præstation tæt på den detaljerede multi-hoved opmærksomhed, men med MQA’s hastighed. For modeller som Mistral betyder dette effektiv præstation uden at gå for meget på kompromis med kvaliteten.
Glidende Vindue Opmærksomhed (SWA)

Den glidende vindue er en anden metode, der bruges til at behandle opmærksomhedssekvenser. Denne metode bruger et faststørrelses opmærksomheds-vindue omkring hvert token i sekvensen. Med flere lag, der stablede denne vindue-opmærksomhed, får de øverste lag til sidst en bredere perspektiv, der omfatter information fra hele input. Denne mekanisme er analog til de receptive felter, der ses i Convolutional Neural Networks (CNN’er).
På den anden side beregner “dilated sliding window attention” i Longformer-modellen, der konceptuelt ligner glidende vindue-metoden, kun nogle diagonaler af matricen. Denne ændring resulterer i, at hukommelsesforbruget øger lineært i stedet for kvadratisk, hvilket gør det til en mere effektiv metode for længere sekvenser.
Mistral AI’s Gennemsigtighed vs. Sikkerhedsbekymringer i Decentralisering
I deres annoncering understregede Mistral AI også gennemsigtighed med udtalelsen: “Ingen tricks, ingen proprietær data.” Men på samme tid er deres eneste tilgængelige model på nuværende tidspunkt ‘Mistral-7B-v0.1’, der er en pretrained base-model, og derfor kan generere en respons til enhver forespørgsel uden moderation, hvilket rejser potentielle sikkerhedsbekymringer. Mens modeller som GPT og Llama har mekanismer til at afgøre, hvornår de skal svare, kan Mistral’s fuldt decentraliserede natur udnyttes af dårlige aktører.
Men decentraliseringen af Large Language Models har sine fortjenester. Mens nogle kan misbruge det, kan mennesker udnytte dets kraft til sociale formål og gøre intelligens tilgængelig for alle.
Implementeringsflexibilitet
En af højdepunkterne er, at Mistral 7B er tilgængelig under Apache 2.0-licensen. Dette betyder, at der ikke er nogen virkelige barrierer for at bruge det – uanset om du bruger det til personlige formål, et stort firma eller endda en regeringsenhed. Du har bare brug for det rette system til at køre det, eller du måske skal investere i cloud-resourcer.
Mens der er andre licenser, såsom den enklere MIT-licens og den kooperative CC BY-SA-4.0, der kræver kredit og lignende licensering for afledte værker, giver Apache 2.0 en solid grundlag for store foretagender.
Afsluttende tanker
Opkomsten af open-source Large Language Models som Mistral 7B markerer en afgørende skift i AI-industrien, hvor højkvalitets sprogmodeller bliver tilgængelige for et bredere publikum. Mistral AI’s innovative tilgange, såsom Grupperet-opmærksomhed og Glidende Vindue Opmærksomhed, lover effektiv præstation uden at gå for meget på kompromis med kvaliteten.
Mens den decentraliserede natur af Mistral stiller visse udfordringer, understreger dens fleksibilitet og open-source-licens potentialet for at demokratisere AI. Da landskabet udvikler sig, vil fokus uundgåeligt være på at balancere disse modellers kraft med etiske overvejelser og sikkerhedsforanstaltninger.
Hvad er næste skridt for Mistral? 7B-modellen var kun begyndelsen. Holdet har til hensigt at lancerer endnu større modeller snart. Hvis disse nye modeller matcher 7B’s præstation, kan Mistral hurtigt stige som en top-spiller i industrien, alt inden for deres første år.


