
Interviews
Josh Miller, administrerende direktør for Gradient Health – interviewserie

 Føj Unite.AI til dine foretrukne kilder på Google
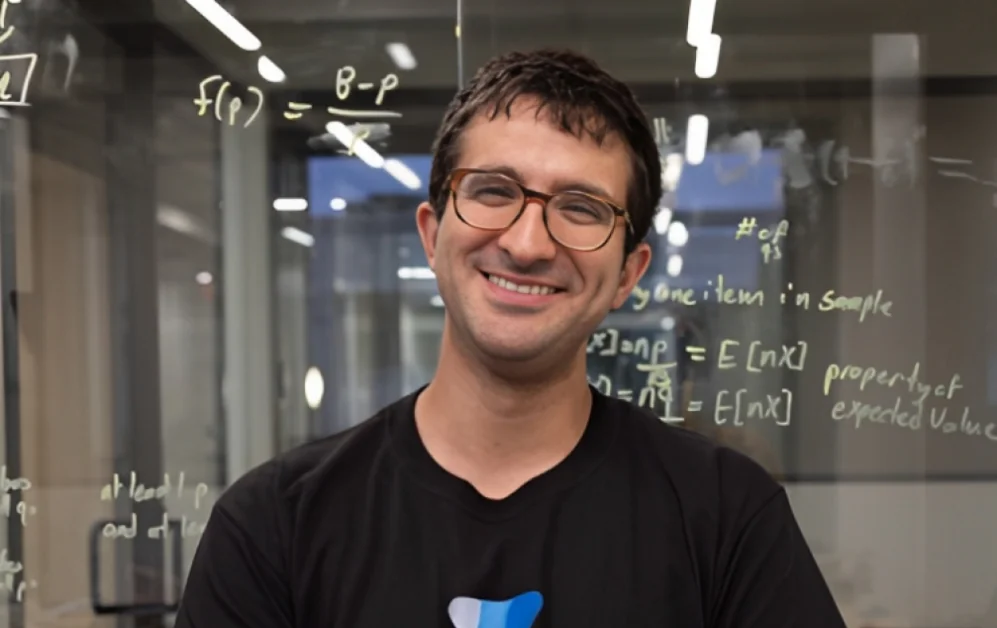
Josh Miller er administrerende direktør for Gradient Health, en virksomhed grundlagt på idéen om, at automatiseret diagnostik er nødvendig for at gøre sundhedsydelser lige og tilgængelige for alle. Gradient Health vil fremskynde automatiseret AI-diagnostik med organiserede, mærkede og tilgængelige data.
Kan du fortælle historien om, hvordan Gradient Health opstod?
Min medstifter Ouwen og jeg havde netop forladt vores første startup, FarmShots, som brugte computer vision til at reducere mængden af pesticider i landbruget, og vi ledte efter vores næste udfordring.
Vi har altid været drevet af ønsket om at finde et svært problem, som kan løses med teknologi, og som a) giver mulighed for at gøre meget godt i verden og b) kan føre til en solid forretning. Ouwen var i gang med sin lægeuddannelse, og med vores erfaring inden for computer vision var medicinsk billeddiagnostik et naturligt valg. På grund af brystkræftens ødelæggende konsekvenser valgte vi mammografi som en mulig første anvendelse. Vi sagde: “Hvor begynder vi? Vi skal bruge data. Vi skal bruge tusind mammografibilleder. Hvor får man data i den størrelsesorden?” Svaret var: “Ingen steder.” Vi indså straks, at det er meget svært at finde data. Efter flere måneder blev frustrationen et filosofisk problem for os. Vi tænkte: “Enhver, der prøver at gøre noget godt på dette område, bør ikke skulle kæmpe for at få de data, der er nødvendige for at udvikle livreddende algoritmer.” Derfor sagde vi: “Måske er det faktisk dét problem, vi skal løse.”
Hvilke risici er der på markedet ved ikke-repræsentative data?
Fra utallige undersøgelser og eksempler fra virkeligheden ved vi, at hvis man udvikler en algoritme udelukkende med data fra vestkysten og tager den med til det sydøstlige USA, virker den simpelthen ikke. Vi hører igen og igen om AI, der fungerer fremragende på det hospital i det nordøstlige USA, hvor den blev udviklet, men hvor nøjagtigheden falder til under 50 %, når den anvendes andre steder.
Jeg mener, at AI’s grundlæggende etiske formål bør være at mindske ulighed i sundhed. Målet er at gøre behandling af høj kvalitet økonomisk overkommelig og tilgængelig for alle. Men bygger man den på dårlige data, øger man faktisk forskellene. Vi svigter sundheds-AI’s opgave, hvis vi kun lader den virke for hvide mænd fra kystområderne. Mennesker med underrepræsenterede baggrunde vil så opleve mere diskrimination, ikke mindre.
Hvordan indsamler Gradient Health data?
Vi samarbejder med alle typer sundhedssystemer verden over, hvis data ellers ligger gemt, koster penge og ikke gavner nogen. Vi fjerner grundigt alle personidentificerende oplysninger fra dataene ved kilden og organiserer dem derefter omhyggeligt til forskerne.
Hvordan sikrer Gradient Health, at dataene er fri for bias og så forskellige som muligt?
Det gør vi på mange måder. Når vi indsamler data, sørger vi eksempelvis for at medtage mange lokale klinikker, hvor dataene ofte er mere repræsentative, sammen med de større hospitaler. Vi henter også data fra et stort antal kliniske behandlingssteder. Vi prøver at inkludere så mange steder som muligt fra så mange forskellige befolkningsgrupper som muligt. Det handler ikke kun om antallet af steder, men også om geografisk og socioøkonomisk variation. Hvis alle behandlingsstederne er hospitaler i bymidter, er dataene stadig ikke repræsentative, vel?
For at kontrollere dette laver vi statistiske analyser af alle datasættene og tilpasser dem til kunden, så vi sikrer, at kunden får data med både teknologisk og demografisk variation.
Hvorfor er denne grad af datakontrol så vigtig for at udvikle robuste AI-algoritmer?
En AI kan møde mange variable i virkeligheden, og vores mål er at gøre algoritmen så robust som muligt. For at forenkle det tænker vi på fem centrale variable i vores data. Den første er “udstyrsproducent”. Det er indlysende, men hvis man udvikler en algoritme alene med data fra GE-scannere, fungerer den for eksempel ikke lige så godt på en Hitachi-scanner.
Tilsvarende er der variablen “udstyrsmodel”. Den er interessant set i forhold til ulighed i sundhed. Store, velfinansierede forskningshospitaler har typisk de nyeste og bedste scannere. Hvis de kun træner deres AI på deres egne 2022-modeller, fungerer den ikke lige så godt på en ældre model fra 2010. Netop disse ældre systemer findes i mindre velstående områder og på landet. Ved kun at bruge data fra nyere modeller indfører man derfor utilsigtet yderligere bias mod mennesker fra disse lokalsamfund.
De øvrige centrale variable er køn, etnicitet og alder. Vi gør meget for at sikre, at dataene er forholdsmæssigt afbalancerede på tværs af dem alle.
Hvilke regulatoriske hindringer møder MedTech-virksomheder?
Vi begynder at se FDA undersøge bias i datasæt grundigt. Forskere er kommet til os og har sagt: “FDA har afvist vores algoritme, fordi den manglede 15 % afroamerikansk repræsentation” — omtrent afroamerikanernes andel af USA’s befolkning. Vi har også hørt om en udvikler, som fik besked på at inkludere 1 % personer med baggrund fra Hawaii og Stillehavsøerne i sine træningsdata.
FDA er altså ved at indse, at algoritmer, der kun er trænet på ét hospital, ikke fungerer i virkeligheden. Hvis man vil have CE-mærkning og FDA-tilladelse, skal man have et datasæt, der repræsenterer befolkningen. Det er med rette ikke længere acceptabelt at træne en AI på en lille eller ikke-repræsentativ gruppe.
Risikoen for MedTech-virksomheder er, at de investerer millioner af dollars i at bringe teknologien til et punkt, hvor de mener, den er klar til regulatorisk godkendelse. Hvis de derefter ikke får tilladelsen, får de aldrig refusion eller indtægter. Vejen til kommercialisering og til den gavnlige virkning på sundhedsydelser, de ønsker at opnå, kræver derfor, at de tager bias i data alvorligt.
Hvilke muligheder er der for at overvinde disse hindringer set fra et dataperspektiv?
Metoderne til datastyring har udviklet sig i de senere år, og AI-udviklere har flere muligheder end nogensinde før. Fra dataformidlere og samarbejdspartnere til fødereret læring og syntetiske data findes der nye tilgange. Uanset metoden opfordrer vi altid udviklere til at overveje, om dataene virkelig repræsenterer den befolkning, som skal bruge produktet. Dette er langt den sværeste del af at skaffe data.
Gradient Health tilbyder løsningen Gradient Label. Hvad er den, og hvordan gør den mærkning af data i stor skala mulig?
AI til medicinsk billeddiagnostik kræver ikke kun data, men også ekspertannoteringer. Vi hjælper virksomheder med at få disse annoteringer, blandt andet fra radiologer.
Hvad er din vision for fremtiden for AI og data i sundhedssektoren?
Der findes allerede tusindvis af AI-værktøjer, som undersøger alt fra fingerspidser til tåspidser, og det vil fortsætte. Jeg tror, der vil være mindst 10 algoritmer til hver tilstand i en medicinsk lærebog. Hver tilstand vil have flere, sandsynligvis konkurrerende, værktøjer til at hjælpe klinikere med at give den bedste behandling.
Jeg tror ikke, vi ender med en Tricorder som i Star Trek, der scanner et menneske og håndterer ethvert tænkeligt problem fra top til tå. I stedet vil vi have specialiserede anvendelser til hvert delområde.
Er der andet, du gerne vil fortælle om Gradient Health?
Jeg glæder mig til fremtiden. Jeg tror, vi bevæger os mod en situation, hvor sundhedsydelser er billige, lige og tilgængelige for alle. Jeg ønsker, at Gradient får mulighed for at spille en grundlæggende rolle i at gøre det muligt. Hele teamet tror virkelig på denne mission, og vi deler en passion, som man ikke finder i alle virksomheder. Og jeg elsker det!
Tak for det gode interview. Læsere, som vil vide mere, kan besøge Gradient Health.






