
Andersons vinkel
Hvordan Stable Diffusion kan udvikle sig til et forbrugerprodukt for den brede offentlighed

 Føj Unite.AI til dine foretrukne kilder på Google
NøglepunkterEn mainstream Stable Diffusion-app skal løse sine komplekse…
Vis mere
- En mainstream Stable Diffusion-app skal løse sine komplekse kommandolinje-installations- og afhængighedsproblemer.
- Kommercielle udviklere står over for juridiske risici fra deepfake-generering og NSFW-indholds-filtre.
- Avancerede funktioner som tidsmæssig konsistens og tekstuel inversion kræver cloud-baseret behandling til forbrugerbrug.
Ironisk nok er Stable Diffusion, det nye AI-billede-syntese-rammeværk, der har taget verden med storm, hverken stabil eller rigtig “diffus” – i hvert fald ikke endnu.
Det fulde udvalg af systemets funktioner er spredt over en varieret samling af konstant muterende tilbud fra en håndfuld udviklere, der febrilsk udveksler den seneste information og teorier i diverse diskussioner på Discord – og det overvældende flertal af installationsprocedurene for de pakker, de er ved at oprette eller ændre, er langt fra “plug and play”.
I stedet tenderer de til at kræve kommandolinje eller BAT-drevet installation via GIT, Conda, Python, Miniconda og andre udviklingsmiljøer i teknologiens front – software-pakker, der er så sjældne blandt den generelle løb af forbrugere, at deres installation ofte bliver markeret af antivirus- og anti-malware-leverandører som bevis på et kompromitteret host-system.

Kun et lille udvalg af trin i forhindringsløbet, som den standard Stable Diffusion-installation kræver i øjeblikket. Mange af distributionerne kræver også specifikke versioner af Python, som kan være i konflikt med eksisterende versioner, der er installeret på brugerens maskine – selvom dette kan undgås med Docker-baserede installationer og, i visse tilfælde, ved hjælp af Conda-miljøer.
Beskedtråde i både SFW- og NSFW-Stable Diffusion-samfund er oversvømmet med tips og tricks relateret til hacking af Python-skripter og standardinstallationer, for at aktivere forbedret funktionalitet eller løse hyppige afhængighedsfejl og en række andre problemer.
Dette efterlader den gennemsnitlige forbruger, der er interesseret i at oprette fantastiske billeder fra tekstprompt, næsten helt afhængig af det voksende antal kommercielle API-webgrænseflader, der tilbyder en minimal mængde gratis billedgenerationer, før de kræver køb af tokens.
Desuden nægter næsten alle disse web-baserede tilbud at udgive NSFW-indhold (som kan omfatte ikke-pornografiske emner af generel interesse, såsom “krig”), hvilket adskiller Stable Diffusion fra de censurerede tjenester fra OpenAI’s DALL-E 2.
‘Photoshop for Stable Diffusion’
Lokket af de fantastiske, vovede eller overjordiske billeder, som dagligt fylder Twitters #stablediffusion-hashtag, venter den brede offentlighed formentlig på ‘Photoshop for Stable Diffusion’ – en installerbar applikation til flere platforme, der kombinerer det bedste og mest kraftfulde funktionalitet af Stability.ai’s arkitektur samt de forskellige geniale innovationer fra den opkommende SD-udviklingssamfund, uden nogen flydende CLI-vinduer, obskure og konstant ændrende installations- og opdateringsrutiner eller manglende funktioner.
Hvad vi i øjeblikket har, i de fleste kapable installationer, er en forskelligt elegant web-side, knyttet til et separat kommandolinjevindue, og hvis URL er en lokalhost-port:

Lignende CLI-drevne syntese-applikationer som FaceSwap og BAT-centrisk DeepFaceLab, viser ‘prepack’-installationen af Stable Diffusion sin kommando-linje-rødder, med grænsefladen tilgængelig via en lokalhost-port (se top af billedet ovenfor), som kommunikerer med den CLI-baserede Stable Diffusion-funktionalitet.
Uden tvivl er en mere strømlinet applikation på vej. Allerede er der flere Patreon-baserede integrale applikationer, der kan downloades, såsom GRisk og NMKD (se billedet nedenfor) – men ingen af dem integrerer endnu det fulde udvalg af funktioner, som nogle af de mere avancerede og mindre tilgængelige implementationer af Stable Diffusion kan tilbyde.

Tidlige, Patreon-baserede pakker af Stable Diffusion, let ‘app-ized’. NMKD’s er den første til at integrere CLI-udgangen direkte i GUI’en.
Lad os se, hvordan en mere poleret og integral implementation af denne forbløffende åbne kilde-vidunder kan se ud – og hvilke udfordringer den kan møde.
Retlige overvejelser for en fuldt finansieret kommerciel Stable Diffusion-applikation
NSFW-faktoren
Stable Diffusion-kildekoden er udgivet under en meget tilladende licens, der ikke forhindrer kommercielle genimplementeringer og afledte værker, der bygger ud fra kildekoden.
Ud over den nævnte og voksende mængde Patreon-baserede Stable Diffusion-versioner samt det omfattende antal applikations-tilføjelser, der udvikles til Figma, Krita, Photoshop, GIMP og Blender (blandt andre), er der ingen praktisk grund til, at en vel-finansieret software-udviklingshus ikke kan udvikle en langt mere avanceret og kapabel Stable Diffusion-applikation. Fra et markedsperspektiv er der alle grund til at tro, at flere sådanne initiativer allerede er godt i gang.
Her står sådanne bestræbelser straks over for dilemmaet om, hvorvidt Stable Diffusions native NSFW-filter (en fragment af kode) skal være slået til eller fra.
‘Begravelse’ af NSFW-kontakten
Selvom Stability.ai’s åbne kilde-licens for Stable Diffusion inkluderer en bredt fortolkelig liste over anvendelser, som det ikke må bruges til (muligvis inklusive pornografisk indhold og deepfakes), er den eneste måde, en leverandør kunne effektivt forhindre sådan brug, at kompilere NSFW-filtret til en uigennemsigtig eksekverbar fil i stedet for en parameter i en Python-fil, eller også tvinge en checksum-sammenligning på Python-filen eller DLL’en, der indeholder NSFW-direktivet, således at rendering ikke kan ske, hvis brugere ændrer denne indstilling.
Dette ville efterlade den påståede applikation “kastreret” på samme måde, som DALL-E 2 er i øjeblikket, hvilket ville mindske dens kommercielle appel. Desuden ville det uundgåeligt føre til, at dekompilerede modificerede versioner af disse komponenter (enten originale Python-runtime-elementer eller kompilerede DLL-filer, som nu bruges i Topaz-linjen af AI-billede-forbedringsværktøjer) ville opstå i torrent/hacking-samfundet for at omgå sådanne begrænsninger, blot ved at erstatte de hindrende elementer og negere enhver checksum-krav.
Til sidst kan leverandøren måske blot gentage Stability.ai’s advarsel mod misbrug, som kendetegner den første kørsel af mange nuværende Stable Diffusion-distributioner.
Men de små åbne kilde-udviklere, der i øjeblikket bruger sådanne uformelle ansvarsfraskrivelser, har lidt at tabe i sammenligning med et software-firma, der har investeret betydelige mængder tid og penge i at gøre Stable Diffusion fuldt udbygget og tilgængeligt – hvilket inviterer til dybere overvejelser.
Deepfake-ansvar
Som vi nyligt har nævnt, indeholder LAION-æstetik-databasen, der er en del af de 4,2 milliarder billeder, som Stable Diffusions fortsatte modeller er trænet på, et stort antal berømthedsbilleder, hvilket giver brugerne mulighed for at effektivt skabe deepfakes, herunder deepfake-berømtheds-porn.

Fra vores seneste artikel, fire stadier af Jennifer Connelly over fire årtier af hendes karriere, afledt fra Stable Diffusion.
Dette er et separat og mere kontroversielt spørgsmål end genereringen af (som regel) lovlige “abstrakte” porn, der ikke afbilder “rigtige” mennesker (selvom sådanne billeder er afledt fra multiple rigtige fotos i træningsmaterialet).
Da et stigende antal amerikanske stater og lande udvikler eller har indført love mod deepfake-porn, kunne Stable Diffusions evne til at skabe berømtheds-porn betyde, at en kommerciel applikation, der ikke er fuldstændig censureret (dvs. kan skabe pornografisk materiale), måske stadig har brug for en vis mulighed for at filtrere opfattede berømthedsansigter.
En metode ville være at give en indbygget “sortliste” over termer, der ikke vil blive accepteret i en bruger-prompt, relateret til berømthedsnavne og til fiktive karakterer, de kan være associeret med. Formodentlig ville sådanne indstillinger også behøve at være institueret på flere sprog end blot engelsk, da det oprindelige data omfatter andre sprog. En anden tilgang kunne være at integrere berømtheds-genkendelsessystemer som dem, der er udviklet af Clarifai.
Det kan være nødvendigt for software-producenter at integrere sådanne metoder, måske først slået fra, som kan hjælpe med at forhindre en selvstændig Stable Diffusion-applikation i at generere berømthedsansigter, indtil der kommer nye love, der kan gøre sådan funktionalitet ulovlig.
Igen, kan sådan funktionalitet dog uundgåeligt blive dekompileret og omvendt af interesserede parter; dog kan software-producenten i sådant tilfælde påstå, at dette er effektivt uautoriseret hærværk – så længe sådan omvendt ingeniørarbejde ikke gøres overdrevent let.
Funktioner, der kunne være inkluderet
Kernefunktionaliteten i enhver distribution af Stable Diffusion ville forventes at være en del af enhver vel-finansieret kommerciel applikation. Disse inkluderer muligheden for at bruge tekstprompt til at generere passende billeder (tekst-til-billede); muligheden for at bruge skitser eller andre billeder som retningslinjer for nye genererede billeder (billede-til-billede); midlet til at justere, hvor “fantasifuld” systemet er instrueret til at være; en måde at afveje render-tid mod kvalitet; og andre “basics”, såsom valgfri automatisk billed/prompt-arkivering og rutine-valgfri opskalering via RealESRGAN, og mindst grundlæggende “ansigt-rettelse” med GFPGAN eller CodeFormer.
Det er en ret grundinstallation. Lad os se på nogle af de mere avancerede funktioner, der i øjeblikket udvikles eller udvides, som kunne integreres i en fuldt udbygget “traditionel” Stable Diffusion-applikation.
Stokastisk frysning
Selv hvis du genbruger en seed fra en tidligere succesfuld render, er det frygteligt svært at få Stable Diffusion til nøjagtigt at gentage en transformation, hvis noget som helst af prompten eller kilde-billedet (eller begge) ændres for en efterfølgende render.
Dette er et problem, hvis du ønsker at bruge EbSynth til at påføre Stable Diffusions transformationer på virkeligt video på en tidsmæssigt kohærent måde – selvom teknikken kan være meget effektiv til simple optagelser af hoved og skuldre:
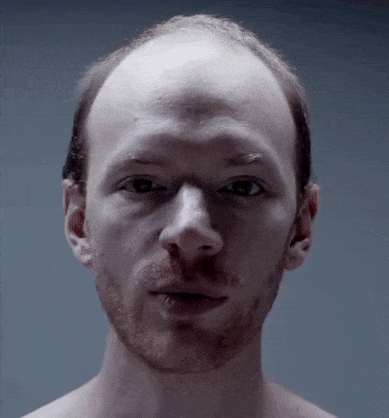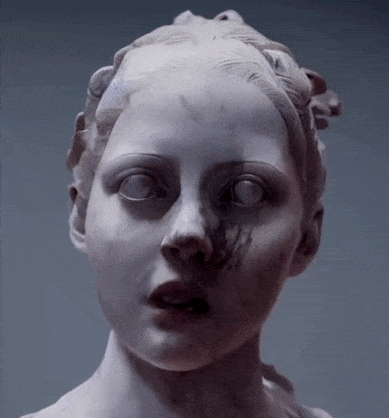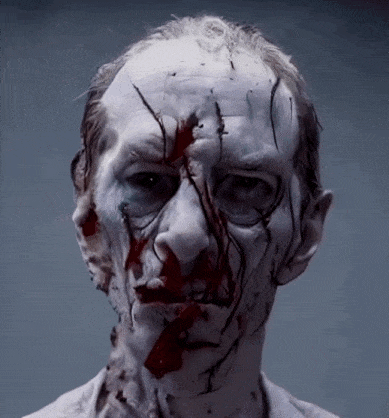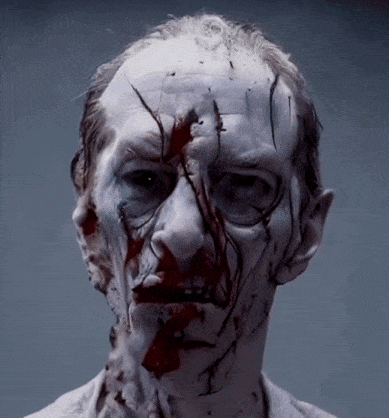
Begrænset bevægelse kan gøre EbSynth til et effektivt medium til at omdanne Stable Diffusions transformationer til realistisk video. Kilde: https://streamable.com/u0pgzd
EbSynth ekstrapolerer et lille udvalg ændrede nøglebilleder til en video, der er eksporteret som en serie billedfiler. De kan bagefter samles til video igen.

I dette eksempel fra EbSynths hjemmeside er en håndfuld videobilleder malet kunstnerisk. Programmet bruger dem som stilvejledning og ændrer hele videoen, så den passer til den malede stil. Kilde: https://www.youtube.com/embed/eghGQtQhY38
I eksemplet nedenfor bevæger den virkelige blonde yogainstruktør til venstre sig næsten ikke. Alligevel har Stable Diffusion svært ved at bevare et ensartet ansigt, fordi de tre billeder, der ændres til nøglebilleder, ikke er helt identiske, selv om de bruger samme numeriske startværdi.

Selv med samme prompt og startværdi i alle tre ændringer og meget små forskelle mellem kildebillederne varierer musklernes størrelse og form. Vigtigst er ansigtet inkonsekvent, hvilket hindrer tidsmæssig sammenhæng i en mulig EbSynth-rendering.
SD/EbSynth-videoen nedenfor er opfindsom: brugerens fingre bliver til henholdsvis gående ben i bukser og en and. De skiftende bukser viser dog Stable Diffusions problemer med sammenhæng mellem nøglebilleder, selv når kilderne ligner hinanden og startværdien er uændret.
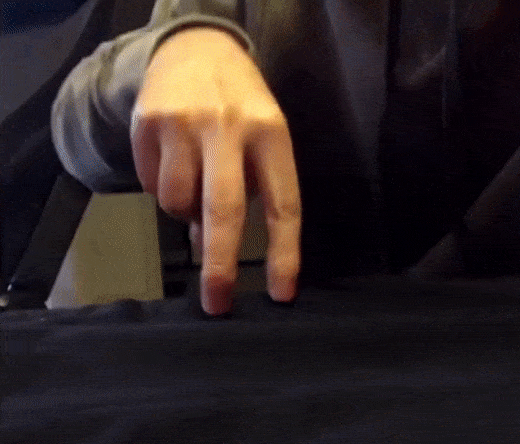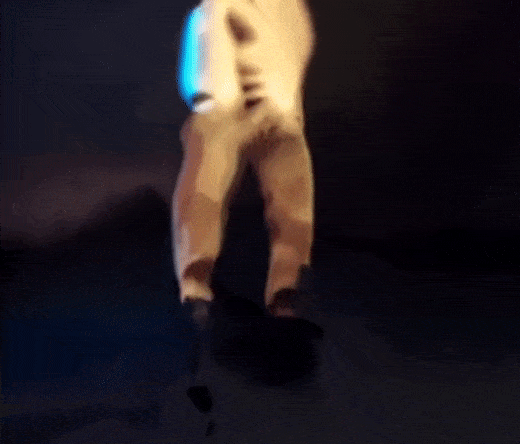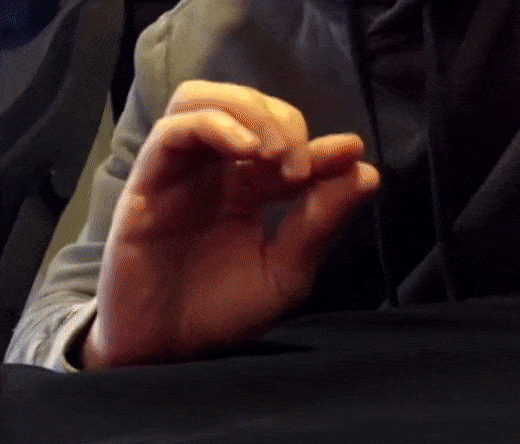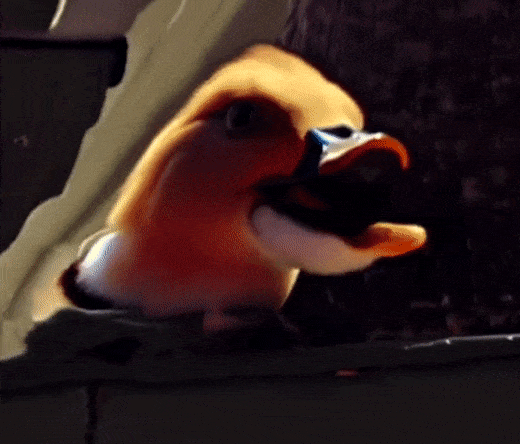
En mands fingre bliver til en gående mand og en and gennem Stable Diffusion og EbSynth. Kilde: https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
Brugeren, der skabte videoen, kommenterede, at forvandlingen til en and, måske den mest vellykkede, men mindre slående og original, kun krævede ét ændret nøglebillede. De gående bukser krævede derimod 50 Stable Diffusion-billeder og viser større tidsmæssig inkonsistens. Brugeren bemærkede også, at det tog fem forsøg at opnå sammenhæng for hvert af de 50 nøglebilleder.
En virkelig komplet applikation ville derfor have stor fordel af en funktion, der bevarer egenskaber bedst muligt mellem nøglebilleder.
En mulighed er at lade brugeren fryse den stokastiske kodning for hver billedrammes ændring. Det kræver i dag manuel ændring af kildekoden. Eksemplet nedenfor viser, at det hjælper, men ikke løser alle problemer med tidsmæssig sammenhæng:
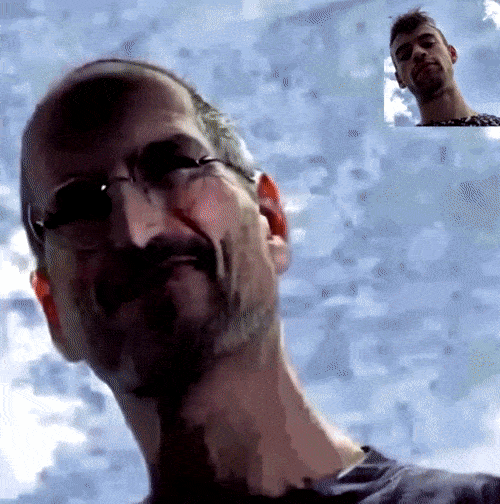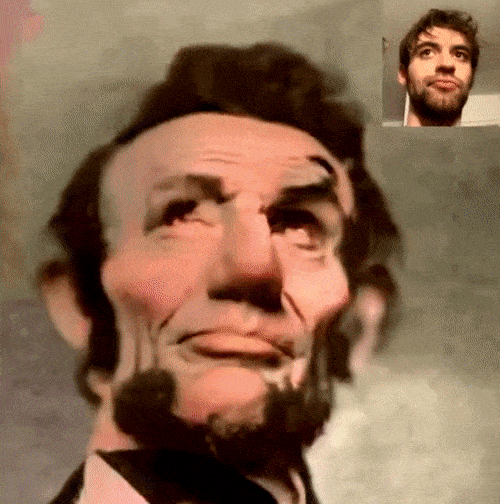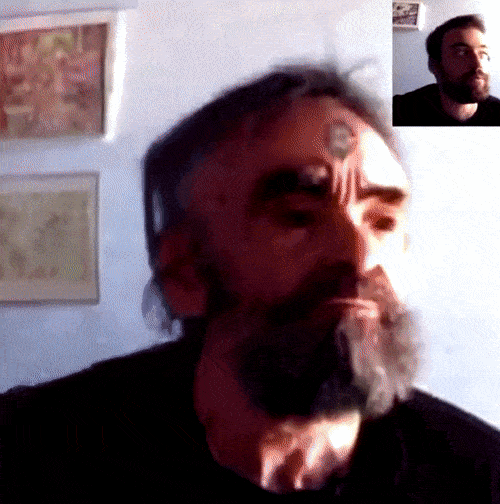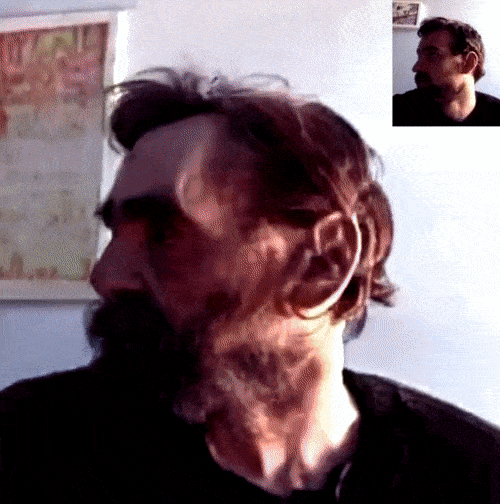
En Reddit-bruger forvandlede optagelser af sig selv til forskellige kendte mennesker ved ikke blot at bevare startværdien, som enhver Stable Diffusion-implementation kan, men også en identisk stochastic_encode()-parameter i alle ændringer. Det krævede kodeændringer, men kunne let blive en brugertilgængelig knap. Det løser dog tydeligvis ikke alle tidsmæssige problemer. Kilde: https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
Tekstuel inversion i skyen
En bedre løsning til figurer og objekter med tidsmæssig sammenhæng er at bage dem ind i en tekstuel inversion — en fil på 5 KB, der kan trænes på få timer med kun fem annoterede billeder og derefter hentes frem med en særlig *-prompt. Det kan eksempelvis bevare nye figurers udseende gennem en fortælling.

Billeder med passende etiketter kan gøres til selvstændige enheder med tekstuel inversion og hentes frem entydigt i korrekt sammenhæng og stil gennem særlige tokenord. Kilde: https://huggingface.co/docs/diffusers/training/text_inversion
Tekstuelle inversioner er tillægsfiler til den meget store, færdigtrænede model bag Stable Diffusion. De indflettes i processen til fremkaldelse og prompter, så de kan deltage i scener skabt af modellen og udnytte dens enorme viden om objekter, stilarter, miljøer og samspil.
Træningen tager ikke lang tid, men kræver meget grafikhukommelse. Aktuelle vejledninger nævner 12, 20 og endda 40 GB VRAM.
De fleste almindelige brugere har formentlig ikke så kraftig en GPU, så skytjenester dukker frem for at klare opgaven, herunder en Hugging Face-version. Der findes Google Colab-implementationer som kan skabe tekstuelle inversioner, men krav til hukommelse og tid kan være vanskelige for brugere på Colabs gratisniveau.
For en mulig komplet og velfinansieret installeret Stable Diffusion-applikation er det en oplagt indtægtsstrategi at sende denne tunge opgave til firmaets skyservere. Det forudsætter, at en billig eller gratis applikation indeholder sådanne betalte funktioner, hvilket virker sandsynligt i mange programmer, der kan opstå fra teknologien i de næste 6–9 måneder.
Den forholdsvis komplicerede annotering og formatering af indsendte billeder og tekster kan også automatiseres i et integreret miljø. At skabe unikke elementer, som udforsker og samspiller med Stable Diffusions vidtstrakte verdener, kan blive stærkt vanedannende for både entusiaster og yngre brugere.
Fleksibel vægtning af prompter
Der er mange nuværende implementationer, der giver brugeren mulighed for at tildele større vægt til en del af en lang tekstprompt, men instrumenteringen varierer ret meget mellem disse, og er ofte klodset eller ikke-intuitiv.
Den meget populære Stable Diffusion-gren af AUTOMATIC1111 kan f.eks. sænke eller hæve værdien af et promptord ved at inkludere det i enkelt eller multiple parenteser (til formindskelse) eller firkantede parenteser til ekstra vægt.

Firkantede parenteser og/eller parenteser kan forvandle din morgenmad i denne version af Stable Diffusion-prompt-vægt, men det er en kolesterolmareridt i begge tilfælde.
Andre iterationer af Stable Diffusion bruger udråbstegn til vægtning, mens de mest fleksible giver brugeren mulighed for at tildele vægt til hvert ord i prompten via GUI’en.
Systemet bør også tillade negative prompt-vægt – ikke kun for gyser-fans, men fordi der kan være færre alarmerende og mere opbyggelige mysterier i Stable Diffusions latente rum end vores begrænsede brug af sprog kan fremkalde.
Billedudvidelse (outpainting)
Kort efter den sensationelle åbning af Stable Diffusion forsøgte OpenAI at genskabe noget af sin opmærksomheden omkring DALL-E 2 ved at annoncere outpainting, der giver brugeren mulighed for at udvide et billede ud over dets grænser med semantisk logik og visuel kohærens.
Naturligvis er dette siden da blevet implementeret i forskellige former for Stable Diffusion, samt i Krita, og bør absolut inkluderes i en komplet, Photoshop-lignende version af Stable Diffusion.
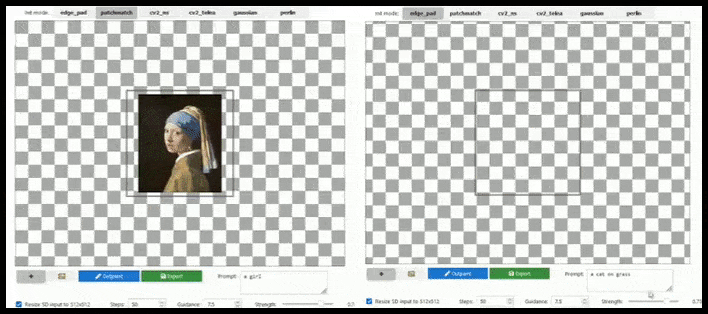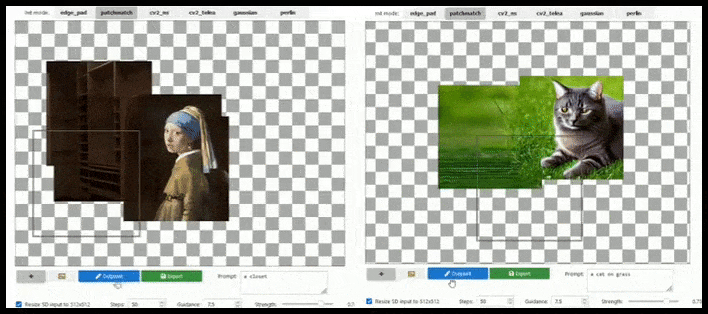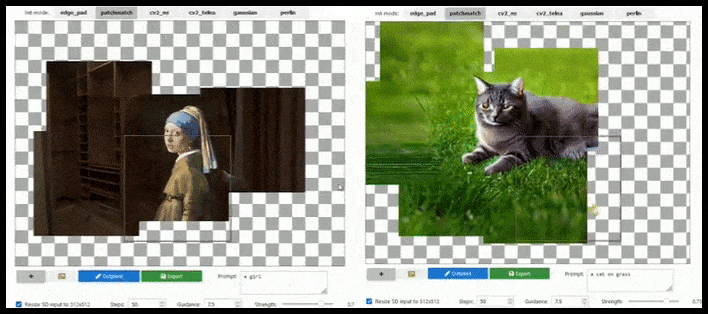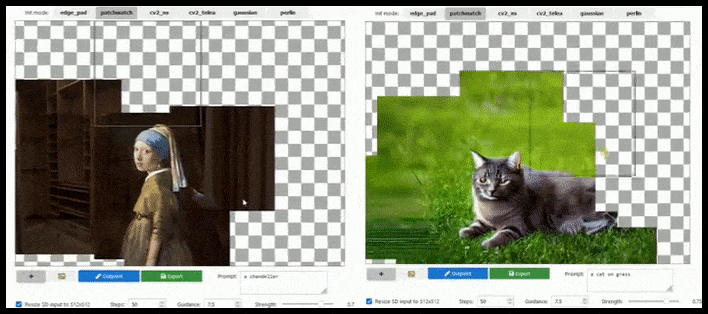
Flis-baseret udvidelse kan udvide et standard 512×512-render næsten ubegrænset, så længe prompten, eksisterende billede og semantisk logik tillader det. Kilde: https://github.com/lkwq007/stablediffusion-infinity
Fordi Stable Diffusion er trænet på 512x512px-billeder (og af en række andre årsager) skærer det ofte hoveder (eller andre essentielle kropsdele) af menneskelige subjekter, selv hvor prompten tydeligt angav “hoved-til-fokus”, osv..

Typiske eksempler på Stable Diffusions “afhugning”; men billedudvidelse kunne sætte George tilbage i billedet.
Enhver outpainting-implementation af den type, der er illustreret i den animerede billedsekvens ovenfor (som udelukkende er baseret på Unix-biblioteker, men burde være i stand til at blive repliceret på Windows) bør også være værktøjet som en enklik/prompt-løsning for dette problem.
I øjeblikket udvider en række brugere canvas af “afhuggede” afbildninger opad, udfylder omtrent området for hovedet og bruger img2img til at fuldføre det fejlbehæftede render.
Effektiv maskering, der forstår kontekst
Maskering kan være en meget uforudsigelig proces i Stable Diffusion, afhængigt af grenen eller versionen i spørgsmålet. Ofte, hvor det er muligt at tegne en samlet maskering, ender det specifikke område med at blive påmalet med indhold, der ikke tager hele konteksten af billedet i betragtning.
På et tidspunkt maskerede jeg korneerne på et ansigtsbillede og gav prompten ‘blå øjne’ som masker-til-påføring – kun for at opdage, at jeg så ud til at kigge gennem to udskårne menneskeøjne på et fjernt billede af et uhyggeligt udseende ulv. Jeg gætter, jeg er heldig, det ikke var Frank Sinatra.
Semantisk redigering er også mulig ved at identificere støjen, der konstruerede billedet fra starten, hvilket giver brugeren mulighed for at bearbejde specifikke strukturelle elementer i et render uden at forstyrre resten af billedet:

Ændring af et element i et billede uden traditionel maskering og uden at ændre tilstødende indhold, ved at identificere støjen, der oprindeligt skabte billedet, og bearbejde de dele af det, der bidrog til målområdet. Kilde: https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
Dette er baseret på K-Diffusion-sampleren.
Semantiske filtre til fysiologiske fejl
Som vi tidligere har nævnt, kan Stable Diffusion ofte tilføje eller fjerne lemmer, primært på grund af data-problemer og mangler i annotationerne, der ledsager billederne, der trænede det.

Lige som det uartige barn, der stak sin tunge ud i skolefotoet, er Stable Diffusions biologiske uhyrligheder ikke altid øjeblikkeligt tydelige, og du kan have delt dit seneste AI-mesterværk på Instagram, før du opdager de ekstra hænder eller smeltede lemmer.
Det er så svært at korrigere disse fejl, at det ville være nyttigt, hvis en fuldstændig Stable Diffusion-applikation indeholdt et eller andet anatomisk genkendelsessystem, der anvender semantisk segmentering til at beregne, om det indkommende billede har alvorlige anatomiske mangler (som i billedet ovenfor), og kasserer det til fordel for en ny render, før det præsenteres for brugeren.

Naturligvis kan du måske ønske at rendre gudinden Kali, eller Doctor Octopus, eller endda redde en uberørt del af et lem-hæmmet billede, så denne funktion bør være en valgfri knap.
Hvis brugere kan acceptere den telemetri-aspekt, kan sådanne fejl også blive overført anonymt i en kollektiv indsats for fødereret læring, der kan hjælpe fremtidige modeller med at forbedre deres forståelse af anatomisk logik.
LAION-baseret automatisk ansigtsforbedring
Som jeg nævnte i min tidligere kig på tre ting, Stable Diffusion kunne adressere i fremtiden, bør det ikke blot overlades til en version af GFPGAN at forsøge at “forbedre” renderede ansigter i første-instans-renderinger.
GFPGAN’s “forbedringer” er frygteligt generiske, ofte undergraver identiteten af den afbillede person og fungerer udelukkende på et ansigt, der normalt har modtaget lige så lidt proces-tid eller opmærksomhed som noget andet billedelement.
Derfor bør et professionelt-standard-program for Stable Diffusion være i stand til at genkende et ansigt (med en standard og relativt letvægts-bibliotek som YOLO), anvende den fulde vægt af tilgængelig GPU-kraft til at rendre det om, og enten blande det forbedrede ansigt ind i den originale fuld-kontekst-render eller gemme det separat til manuel gensamling. I øjeblikket er dette en ret manuel proces.
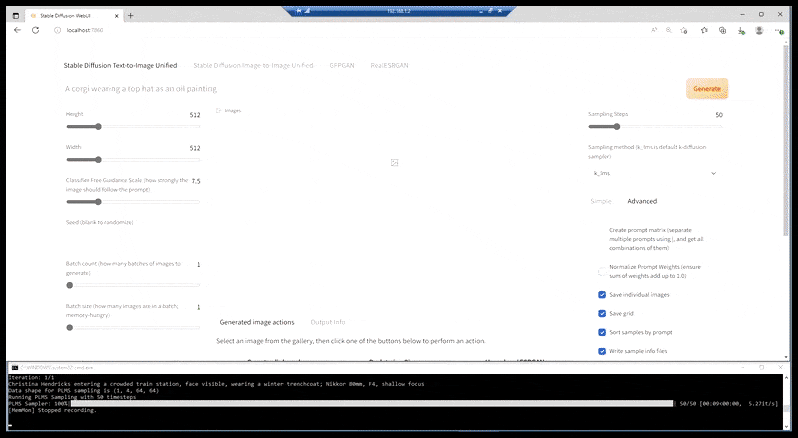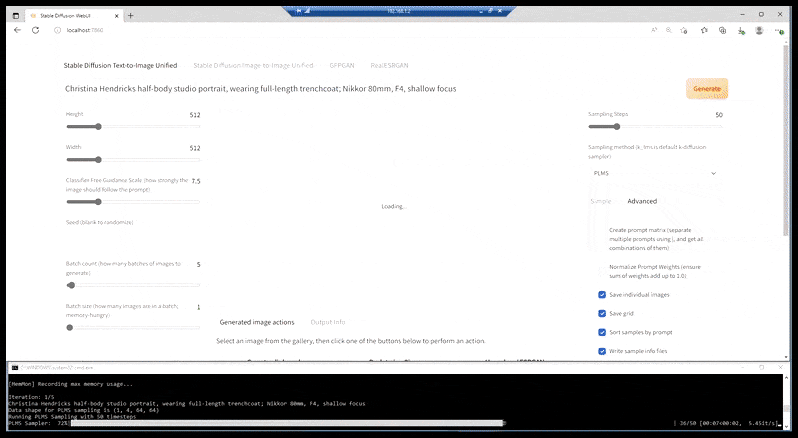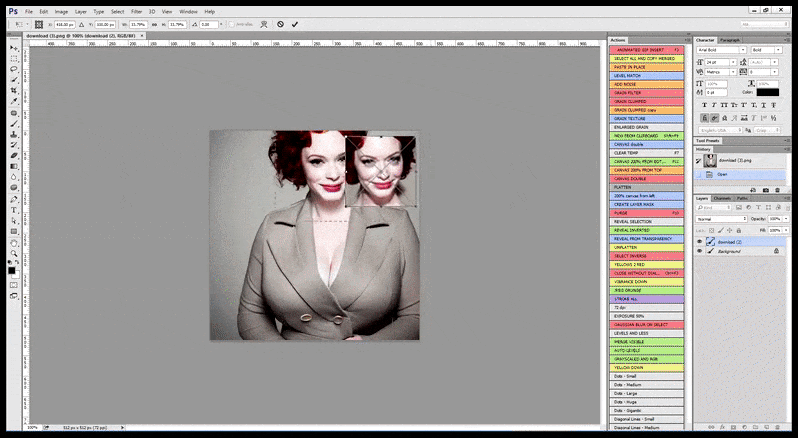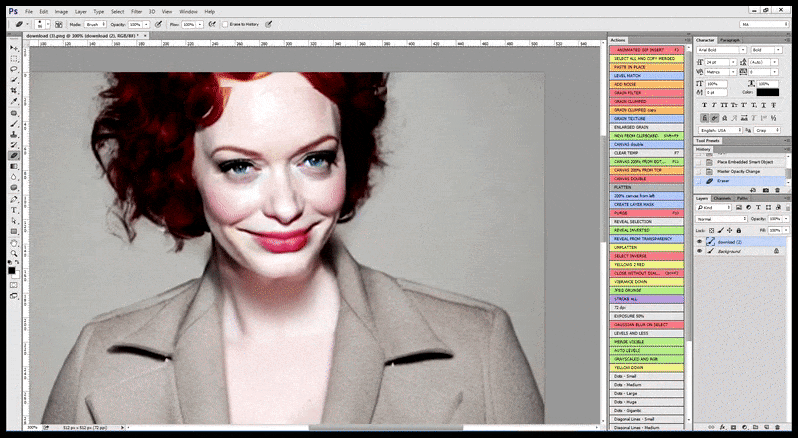
I tilfælde, hvor Stable Diffusion er blevet trænet på et tilstrækkeligt antal billeder af en berømthed, er det muligt at fokusere hele GPU-kapaciteten på en efterfølgende render udelukkende af ansigtet på det renderede billede, hvilket normalt er en bemærkelsesværdig forbedring – og, i modsætning til GFPGAN, trækker på information fra LAION-trænet data, snarere end blot at justere de renderede pixels.
In-app LAION-søgninger
Siden brugere begyndte at indse, at søgning i LAION’s database efter begreber, personer og temaer kunne være en hjælp til bedre brug af Stable Diffusion, er flere online LAION-udforskere blevet oprettet, herunder haveibeentrained.com.

Søgefunktionen på haveibeentrained.com giver brugerne mulighed for at udforske billederne, der driver Stable Diffusion, og opdage, om objekter, personer eller ideer, de måske ønsker at fremkalde fra systemet, sandsynligvis indgik i træningen. Systemerne hjælper også med at opdage beslægtede enheder, såsom grupperinger af berømtheder eller den næste idé, der følger af den nuværende. Kilde: https://haveibeentrained.com/?search_text=bowl%20of%20fruit
Selvom sådanne web-baserede databaser ofte afslører nogle af de tags, der ledsager billederne, indebærer processen med generalisering, der finder sted under model-træning, at det er usandsynligt, at nogen given billede kunne blive fremkaldt ved at bruge dens tag som prompt.
Desuden indebærer fjernelsen af ‘stop-ord’ og praksis med stemming og lemmatisering i naturlig sprogbehandling, at mange af de fraser, der vises, blev delt op eller udeladt, før de blev trænet ind i Stable Diffusion.
Alligevel kan måden, æstetiske grupper binder sammen i disse grænseflader, undervise slutbrugeren meget om logikken (eller måske “personligheden”) af Stable Diffusion og kan være en hjælp til bedre billedproduktion.
Konklusion
Der er mange andre funktioner, jeg gerne ville se i en fuldt udbygget native desktop-implementation af Stable Diffusion, såsom native CLIP-baseret billedanalyse, der omvender den standard Stable Diffusion-proces og giver brugeren mulighed for at fremkalde fraser og ord, som systemet naturligt ville associerer med kilde-billedet eller renderingen.
Desuden ville ægte opskalering baseret på billedfliser være en velkommen tilføjelse, da ESRGAN er næsten lige så klodset et instrument som GFPGAN. Heldigvis er planer om at integrere txt2imghd-implementationen af GOBIG hurtigt ved at gøre dette til virkelighed på tværs af distributionerne, og det synes at være en åbenlys valg til en desktop-iteration.
Nogle andre populære anmodninger fra Discord-samfundene interesserer mig mindre, såsom integrerede prompt-ordbøger og anvendelige lister over kunstnere og stilarter, selvom en in-app-notebook eller en tilpasselig leksikon af fraser ville synes at være en logisk tilføjelse.
Ligeledes er de nuværende begrænsninger for menneske-centreret animation i Stable Diffusion, selvom de er kickstartet af CogVideo og andre projekter, stadig utroligt spæde, og afhængige af grundforskning i tidsmæssig forhåndsviden i relation til ægte menneskeligt bevægelse.
I øjeblikket er Stable Diffusion-video strengt psykedelisk, selvom det måske har en lysere nære fremtid i deepfake-dukke-teater via EbSynth og andre relativt spæde tekst-til-video-initiativer (og det er værd at bemærke manglen på syntetiserede eller “ændrede” mennesker i Runways seneste promotionsvideo).
En anden værdifuld funktionalitet ville være problemfri billedoverførsel til Photoshop og tilbage, der har været etableret i Cinema4D’s tekstur-editor, blandt andre lignende implementationer. Med dette kan billeder let skiftes mellem applikationer og bruges til at udføre transformationer, som hver applikation er særligt god til.
Til sidst, og måske aller vigtigst, bør en fuldt udbygget desktop-Stable Diffusion-program være i stand til ikke blot at skifte let mellem checkpoints (dvs. versioner af den underliggende model, der driver systemet), men også være i stand til at opdatere brugerdefinerede Tekstuelle Inversioner, der fungerede med tidligere officielle model-udgaver, men ellers kan være brudt af senere versioner af modellen (som udviklere på det officielle Discord har indikeret, kan være tilfældet).
Ironisk nok er organisationen i den bedste position til at skabe en sådan kraftfuld og integreret matrix af værktøjer til Stable Diffusion, Adobe, allieret sig så stærkt med Content Authenticity Initiative, at det kan synes et bagudrettet fejltrin i kommunikationen for virksomheden – medmindre det ville være til at lamme Stable Diffusions generative kræfter så grundigt, som OpenAI har gjort med DALL-E 2, og positionere det i stedet som en naturlig udvikling af dets betydelige beholdninger i arkivfotografier.
Først offentliggjort den 15. september 2022.


