Andersons vinkel
AI-billedfrilægning, der forstår scener

 Føj Unite.AI til dine foretrukne kilder på Google
NøglepunkterAI-matting bruger nu sceneunderstanding til at erstatte green screens.
Vis mere
- AI-matting bruger nu sceneunderstanding til at erstatte green screens.
- Den nye SPG-IM-pipeline overgår trimap-frie metoder med stor margin.
- Tekstuelle labels tilbyder et billigt alternativ til dyr pixelannotering.
I den ekstra dokumentar, der fulgte med 2003 DVD‑udgivelsen af Alien3 (1992), huskede visuelleffektelegenden Richard Edlund med rædsel den ‘sumowrestling’ af fotokemisk matteudtrækning, som dominerede VFX‑arbejdet mellem de seneste 1930'ere og slutningen af 1980'erne. Edlund beskrev processens hit‑og‑miss‑karakter som ‘sumowrestling’ i sammenligning med de digitale blå‑/grønskærm‑teknikker, der overtog i begyndelsen af 1990'erne (og han har vendt tilbage til metaforen siden).
Udtrækning af et forgrundselement (såsom en person eller en rumskibsmodel) fra en baggrund, så det udklippede billede kan sammensættes med en baggrundsplade, blev oprindeligt opnået ved at filme forgrundsobjektet foran en ensartet blå eller grøn baggrund.
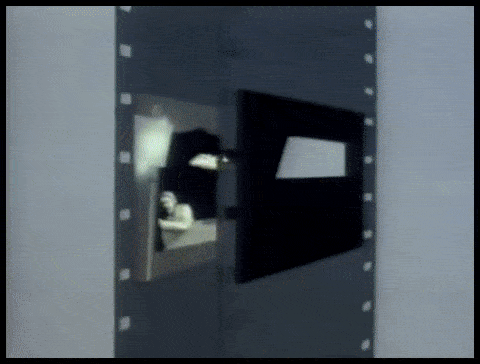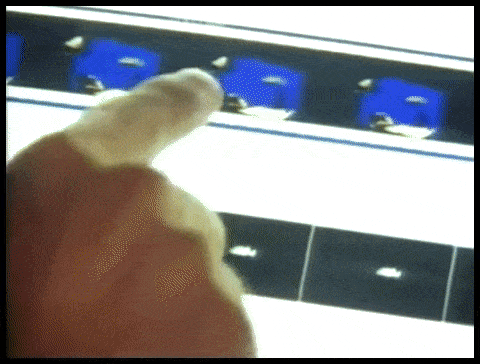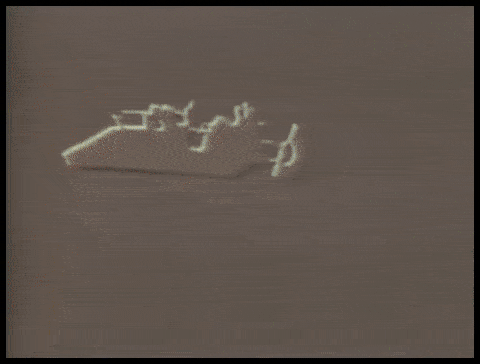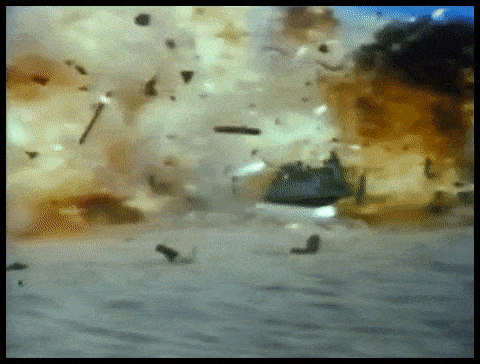
Arbejdskrævende fotokemiske udtrækningsprocesser for et VFX‑shot af ILM til ‘Return of the Jedi’ (1983).
I det resulterende optagelse blev baggrundsfarven efterfølgende isoleret kemisk og brugt som skabelon til at genprinte forgrundsobjektet (eller personen) i en optisk printer som et ‘flydende’ objekt i en ellers gennemsigtig filmcelle.
Processen var kendt som color separation overlay (CSO) – selvom dette udtryk senere blev mere forbundet med de primitive ‘Chromakey’-videoeffekter i lavbudget‑tv‑produktionerne i 1970'erne og 1980'erne, som blev opnået med analoge snarere end kemiske eller digitale metoder.

En demonstration af Color Separation Overlay i 1970 for den britiske børneserie ‘Blue Peter’. Kilde: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Under alle omstændigheder kunne det udtrukne optagelse, uanset om det var til film eller video, derefter indsættes i ethvert andet optagelse.
Selvom Disneys markant dyrere og proprietære natriumdampproces (som nøglede på gul, specifikt, og også blev brugt til Alfred Hitchcocks horrorfilm fra 1963 The Birds) gav bedre definition og skarpere masker, forblev fotokemisk udtrækning omstændelig og upålidelig.

Disneys proprietære udtrækningsproces med natriumdamp krævede baggrunde nær den gule ende af spektret. Her er Angela Lansbury ophængt i wirer under produktionen af en VFX‑fyldt sekvens til ‘Bedknobs and Broomsticks’ (1971). Kilde
Udover digital billedfrilægning
I 1990’erne afskaffede den digitale revolution kemikalierne, men ikke behovet for grønne skærme. Det blev nu muligt at fjerne den grønne (eller hvilken som helst farve) baggrund blot ved at søge efter pixels inden for en toleranceinterval for den farve i pixel‑redigeringssoftware som Photoshop, samt en ny generation af videokompositionspakker, der automatisk kunne keye de farvede baggrunde ud. Næsten over natten blev tres år af den optiske trykkeribranche sendt i historien.
De sidste ti år med GPU‑accelereret computer‑vision‑forskning indleder en tredje æra for matteudtrækning, hvor forskere får til opgave at udvikle systemer, der kan udtrække masker af høj kvalitet uden behov for grønne skærme. På Arxiv alene er artikler om innovationer inden for maskinlæringsbaseret forgrundsudtrækning en ugentlig foreteelse.
Sætter os i billedet
Dette centrum for akademisk og industrielt interesse i AI‑udtrækning har allerede påvirket forbrugerområdet: grove men funktionsdygtige implementeringer er kendte for os alle i form af Zoom og Skype-filtre, der kan erstatte vores stuebaggrunde med tropiske øer mv. i videokonferenceopkald.
Dog kræver de bedste masker stadig en grøn skærm, som Zoom bemærkede sidste onsdag.

Venstre, en mand foran en grøn skærm, med veludtrukket hår via Zooms Virtual Background-funktion. Højre, en kvinde foran en normal hjemmebaggrund, med hår udtrukket algoritmisk, mindre præcist, og med højere beregningskrav. Kilde: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Et yderligere indlæg fra Zoom Support-platformen advarer om, at udtrækning uden grøn skærm også kræver større beregningskraft i optageenheden.
Behovet for at skære det ud
Forbedringer i kvalitet, bærbarhed og ressourceøkonomi for ‘in‑the‑wild’-matteudtrækningssystemer (dvs. isolering af mennesker uden behov for grønne skærme) er relevante for mange flere sektorer og anvendelser end blot videokonference‑filtre.
For datasætudvikling giver forbedret ansigts-, fuld‑hoved‑ og fuld‑kropsgenkendelse mulighed for at sikre, at overflødige baggrundselementer ikke trænes ind i computer‑vision‑modeller af menneskelige subjekter; mere præcis isolering ville i høj grad forbedre semantisk segmentering-teknikker designet til at skelne og assimilere domæner (dvs. ‘kat’, ‘person’, ‘båd’), og forbedre VAE og transformer-baserede billedsyntesesystemer såsom OpenAI’s nye DALL‑E 2; samt bedre udtrækningsalgoritmer ville reducere behovet for dyr manuel rotoscoping i kostbare VFX‑pipeline.
Faktisk er opstigningen af multimodal (normalt tekst/billede) metoder, hvor et domæne som ‘kat’ kodificeres både som et billede og med tilhørende tekstreferencer, allerede ved at gøre fremskridt inden for billedbehandling. Et nyligt eksempel er Text2Live-arkitekturen, som bruger multimodal (tekst/billede) træning til at skabe videoer af, blandt utallige andre muligheder, krystallinske svaner og glasgiraffer.
Scenebevidst billedfrilægning med AI
En stor del af forskningen i AI-baseret automatisk billedfrilægning har fokuseret på kantgenkendelse og evaluering af pixel‑baserede grupperinger inden for et billede eller videobillede. Ny forskning fra Kina tilbyder dog en udtrækningspipeline, der forbedrer afgrænsning og mattekvalitet ved at udnytte tekstbaserede beskrivelser af en scene (en multimodal tilgang, der har fået indpas i computer‑vision‑forskningssektoren i de sidste 3‑4 år), og hævder at have forbedret tidligere metoder på flere måder.

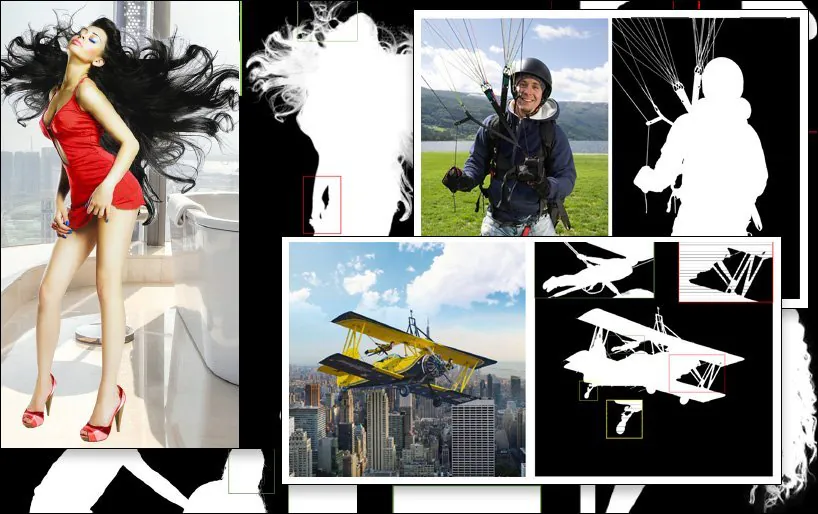
Et eksempel på SPG‑IM‑udtrækning (sidste billede, nederst til højre), sammenlignet med konkurrerende tidligere metoder. Kilde: https://arxiv.org/pdf/2204.09276.pdf
Udfordringen for udtrækningsforskningssubsektoren er at producere arbejdsgange, der kræver et minimum af manuel annotering og menneskelig indgriben – ideelt set ingen. Ud over omkostningsaspekterne observerer forskerne i den nye artikel, at annotationer og manuelle segmenteringer udført af outsourcede crowdworkers på tværs af forskellige kulturer kan få billeder til at blive mærket eller endda segmenteret på forskellige måder, hvilket fører til inkonsistente og utilfredsstillende algoritmer.
Et eksempel på dette er den subjektive fortolkning af, hvad der definerer et ‘forgrundsobjekt’:

Fra den nye artikel: tidligere metoder LFM og MODNet (‘GT’ betyder Ground Truth, et ‘ideelt’ resultat, der ofte opnås manuelt eller ved ikke‑algoritmiske metoder), har forskellige og varierende effektive opfattelser af definitionen af forgrundsindhold, mens den nye SPG‑IM‑metode mere effektivt afgrænser ‘nært indhold’ gennem scene‑kontekst.
For at løse dette har forskerne udviklet en to‑trins pipeline med titlen Situational Perception Guided Image Matting (SPG‑IM). Den to‑trins encoder/decoder‑arkitektur omfatter Situational Perception Distillation (SPD) og Situational Perception Guided Matting (SPGM).

SPG‑IM‑arkitekturen.
Først fortræner SPD transformationer af visuelle træk til tekstlige træk, der genererer billedtekster passende til deres tilknyttede billeder. Derefter aktiveres forgrundsmaskens forudsigelse ved at forbinde pipelinen til en ny saliencyprediktions‑teknik.
Derefter leverer SPGM en estimeret alfa‑matte baseret på den rå RGB‑billedinput og den genererede maske opnået i det første modul.
Målet er vejledning baseret på situationsforståelse, hvor systemet har en kontekstuel forståelse af, hvad billedet indeholder, så det kan indramme – for eksempel – udfordringen med at udtrække komplekst hår fra en baggrund i forhold til kendte karakteristika for en så specifik opgave.

I eksemplet nedenfor forstår SPG‑IM, at snorene er en integreret del af en faldskærm, hvor MODNet ikke formår at bevare og definere disse detaljer. Ligeledes er den komplette struktur af legepladsens udstyr vilkårligt gå tabt i MODNet.
Den nye artikel har titlen Situational Perception Guided Image Matting og kommer fra forskere ved OPPO Research Institute, PicUp.ai og Xmotors.
Intelligente automatiserede masker
SPG‑IM tilbyder også et Adaptive Focal Transformation (AFT) Refinement Network, der kan behandle lokale detaljer og global kontekst separat, hvilket muliggør ‘intelligente masker’.

Forståelse af scene‑kontekst, i dette tilfælde ‘pige med hest’, kan potentielt gøre forgrundsudtrækning lettere end tidligere metoder.
Artiklen siger:
‘Vi mener, at visuelle repræsentationer fra den visuel‑til‑tekstuelle opgave, f.eks. billedtekstning, fokuserer på mere semantisk omfattende signaler mellem a) objekt til objekt og b) objekt til det omgivende miljø for at generere beskrivelser, der kan dække både den globale information og lokale detaljer. Derudover, sammenlignet med den dyre pixel‑annotation af billedfrilægning, kan tekstuelle etiketter indsamles i stort omfang til meget lave omkostninger.’
SPD‑grenen af arkitekturen er fællesfortrænet med University of Michigan’s VirTex transformer‑baserede tekst‑decoder, som lærer visuelle repræsentationer fra semantisk tætte billedtekster.

VirTex træner fælles en ConvNet og Transformers via billed‑tekst‑par, og overfører de opnåede indsigter til efterfølgende vision‑opgaver såsom objektdetektion. Kilde: https://arxiv.org/pdf/2006.06666.pdf
Blandt andre tests og ablationsstudier testede forskerne SPG‑IM mod state‑of‑the‑art trimap-baserede metoder Deep Image Matting (DIM), IndexNet, Context‑Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA og Semantic Image Matting (SIM).
Andre tidligere rammer, der blev testet, omfattede trimap‑fri tilgange LFM, HAttMatting og MODNet. For en retfærdig sammenligning blev testmetoderne tilpasset ud fra de forskellige metodologier; hvor kode ikke var tilgængelig, blev papirernes teknikker gengivet ud fra den beskrevne arkitektur.
Den nye artikel siger:
‘Vores SPG‑IM overgår alle konkurrerende trimap‑fri metoder ([LFM], [HAttMatting] og [MODNet]) med stor margen. Samtidig viser vores model bemærkelsesværdig overlegenhed over state‑of‑the‑art (SOTA) trimap‑baserede og mask‑guidede metoder med hensyn til alle fire metrics på de offentlige datasæt (dvs. Composition‑1K, Distinction‑646 og Human‑2K), samt vores Multi‑Object‑1K benchmark.’
Og fortsætter:
‘Det kan tydeligt observeres, at vores metode bevarer fine detaljer (f.eks. hårspidser, transparente teksturer og kanter) uden trimap‑vejledning. Desuden kan vores SPG‑IM, sammenlignet med andre konkurrerende trimap‑fri modeller, bevare en bedre global semantisk fuldstændighed.’


Først offentliggjort 24. april 2022.