
Grundlæggende AI
Hvad er sentimentanalyse? Metoder, anvendelser og begrænsninger

 Føj Unite.AI til dine foretrukne kilder på Google
Sentimentanalyse estimerer vurderende sprog i tekst, taletransskriptioner eller andet indhold. Et system kan klassificere polaritet såsom positiv, negativ eller neutral; opdage aspekt‑niveau holdninger; estimere intensitet; eller identificere holdning til en bestemt påstand.
Målet skal defineres omhyggeligt. Sentiment er ikke det samme som følelse, intention, giftighed, tilfredshed eller sandhed. En positiv sætning kan beskrive en skadelig begivenhed sarkastisk, mens en negativ produktanmeldelse stadig kan anbefale produktet samlet set.
Vigtige pointer
- Definér enhed, mål, etiketter og kontekst inden indsamling af eksempler.
- Leksika er gennemsigtige grundlinjer; superviserede og transformer‑modeller kan indfange mere kontekst, men kræver repræsentative data.
- Negation, sarkasme, domænespecifik ordforråd, flersproget tekst og aspektgrænser forbliver vanskelige.
- Evaluer per klasse, undergruppe, domæne og tidsperiode; inddrag menneskelig gennemgang ved konsekvensfølsomme anvendelser.
Niveauer og mål
Analyse på dokumentniveau giver én etiket for et helt element. Analyse på sætningsniveau adskiller udsagn, mens aspekt‑baseret analyse knytter sentiment til en entitet eller egenskab – for eksempel positiv om billedkvalitet men negativ om batterilevetid.
Holdning spørger, om en taler støtter en specifik påstand, hvilket kan afvige fra den følelsesmæssige tone. Disse sondringer bør fastlægges i annoteringsguiden, inden tekstklassificerings-metoder anvendes.
Leksika, klassiske modeller og transformere
Et leksikon tildeler ord scores og kombinerer dem med regler for negation eller intensitet. Det er fortolkeligt og billigt, men har svært ved kontekst. Klassiske superviserede modeller bruger ord‑ eller n‑gram‑funktioner, mens transformere lærer kontekstuelle repræsentationer og kan finjusteres.
Få‑skud‑prompting kan være bekvemt, men output afhænger af eksempler og formulering. Sammenlign hver kompleks tilgang med en grundlinje, og brug kun few‑shot‑læring med et hold‑out, versioneret evalueringssæt.
Data‑ og sprogudfordringer
Etiketter kan afspejle annotators perspektiv snarere end en objektiv kendsgerning. Domæneskift er alvorligt: ‘uforudsigelig’ kan være ros for en film og kritik for et køretøj. Kodeskift, dialekt, emojis, citeret tale og ironi komplicerer token‑niveau signaler.
Balancér klasser bevidst og undgå at relaterede forfattere, produkter eller samtaler lækker mellem trænings‑ og test‑sæt. En model, der husker et mærke eller en taler, kan fremstå præcis uden at have lært sentiment.
Evaluering og ansvarlig brug
Rapporter præcision, recall, F1 og en confusion matrix i stedet for kun nøjagtighed. Gennemgå fejl efter aspekt, længde, dialekt og tid, og kalibrér tærskler for den operationelle omkostning ved hver fejl.
Aggregere tendenser kan understøtte forskning eller triage, men at udlede en enkeltpersons tilstand eller træffe beslutninger om beskæftigelse, kredit, sundhed eller politi medfører større risiko. Giv usikkerhed, kilde‑kontekst, privatlivskontroller og menneskelig gennemgang.
Annotering og datasæt‑konstruktion
Skriv en annoteringsguide med mål‑entitet, analyse‑enhed, etiketdefinitioner, håndtering af blandede og neutrale tilfælde, citeringsregler, sarkasme‑politik og eksempler fra domænet. Pilotér med flere annotatorer, beregn enighed, diskuter uenigheder, og revidér opgaven inden du skalerer etiketter.
Udvælgelse bestemmer, hvad modellen lærer. En strøm fra sociale medier kan overrepræsentere meget aktive konti; support‑billetter kan udelade tilfredse kunder; stjerne‑vurderinger kan ikke matche anmeldelsesteksten. Bevar kilde‑ og tids‑metadata, respekter platformens vilkår og privatliv, og opret et testsæt fra den befolkning, hvor beslutninger træffes.
Lækage af etiketter kan forekomme gennem vurderinger, emojis indsat af indsamlingsystemet, skabelon‑signaturer eller produktnavne korreleret med sentiment. Dedupliker næsten identiske opslag og grupper samtaler eller forfattere, så deres sprog ikke forekommer på begge sider af en opdeling.
Modelvalg og kalibrering
Leksikon‑systemer summerer ord‑scores og justerer for negation, intensiveringsord, tegnsætning eller emojis. De giver en nyttig sanity‑check og kan tilpasses med domæne‑termer. Lineære modeller med TF–IDF‑funktioner forbliver konkurrencedygtige på visse datasæt og afslører indflydelsesrige n‑grams.
Kontekstuelle kodere repræsenterer ord i forhold til den omgivende tekst og kan finjusteres for polaritet eller aspekter. Lange dokumenter kan kræve hierarkiske modeller, sætnings‑aggregation eller hentning af relevante udsnit. Flersprogede tilgange kan træne én fælles model, oversætte til et pivot‑sprog eller vedligeholde lokale modeller; hver har dækning og kulturelle afvejninger.
Sandsynlighedskalibrering er vigtig, når scores udløser handling. Pålidelighedsgrafer og forventet kalibreringsfejl viser, om en rapporteret 0,8‑tillid svarer til ca. 80 % korrekthed. Tærskler kan skabe et fraværs‑bånd for menneskelig gennemgang, og separate tærskler kan begrundes, når fejlkostnader varierer – ikke for at skjule ulige kvalitet.
Anvendelser og almindelige misfortolkninger
Aggregert sentiment kan hjælpe med at prioritere temaer, sammenligne kampagnereaktioner eller dirigere hastende service‑meddelelser. Aspekt‑analyse er ofte mere handlingsorienteret end samlet polaritet, fordi den identificerer, hvad folk diskuterer. Trendanalyse kræver stabil udvælgelse og etiketdefinitioner over tid.
Lad ikke udbredelsen af negative opslag blive ligestillet med befolkningens holdning. Post‑adfærd, bots, moderation, platform‑demografi, kampagner og indsamling‑forespørgsler former prøven. En sentiment‑model måler ikke den tavse befolkning, og en ændring i formulering kan fremstå som en holdningsændring.
Ved individuelle beslutninger kan falske etiketter stigmatisere og være svære at bestride. Undgå at bruge sentiment som en erstatning for medarbejderengagement, mental sundhed, kreditværdighed, intention eller bedrag. Når personer påvirkes, vis kilde‑kontekst, tillad korrektion, og kræv en menneskelig beslutningstager med reel skønsbeføjelse.
Praktisk eksempel: sentimentanalyse for kundefeedback
En virksomhed, der analyserer support‑kommentarer, bør definere, om den har brug for dokument‑sentiment, aspekt‑sentiment, følelser, hastighed eller problemklassificering. ‘Leveringen var hurtig, men produktet gik i stykker’ kan ikke troværdigt repræsenteres af én positiv‑eller‑negativ etiket. Opret en annoteringsguide for mål, negation, sarkasme, blandede udsagn, citeret tale og ukendte tilfælde, og mål derefter enighed, før etiketter betragtes som sandhed.
Sammenlign et leksikon‑ eller lineært grundlag med en finjusteret encoder eller en promptet sprogmodel. Del data efter tid eller kunde for at forhindre lækage af næsten identiske eksempler, og bevar klasse‑forekomst. Rapporter præcision, recall, F1, kalibrering og forvirring efter sprog, kanal, produkt og demografiske proxy‑er kun hvor lovligt og berettiget. Gennemgå fejl med høj sikkerhed, da de er farligere i automatiseret routing end usikre output, der eskaleres.
Brug sentiment som et signal for aggregation eller prioritering, ikke som en ubestridelig måling af en persons tilstand. Overvåg ordforråd og produkt‑drift, gen‑træn med gennemgåede eksempler, og lad agenter korrigere etiketter. Udled aldrig beskyttede egenskaber eller disciplinér medarbejdere ud fra uvurderede sentiment‑scores. Til ledelsesrapportering skal du vise stikprøvestørrelse, usikkerhed, manglende data og de emner, der driver ændringer, så en svingende score fører til undersøgelse frem for en simpel konklusion.
Flersproget implementering bør ikke antage, at oversættelse af input bevarer tone, negation, idiom eller kulturel konvention. Valider hver understøttet sprog og blandet‑sprog‑mønster med native‑reviewere, og giv et ukendt resultat, når beviserne er svage. Domæne‑tilpasning betyder også noget: ord der lyder negative i almindelig samtale kan være neutrale tekniske beskrivelser. Oprethold separate tærskler eller modeller kun når operationelle beviser retfærdiggør den ekstra kompleksitet og governance‑byrde.
Praktisk implementerings‑tjekliste
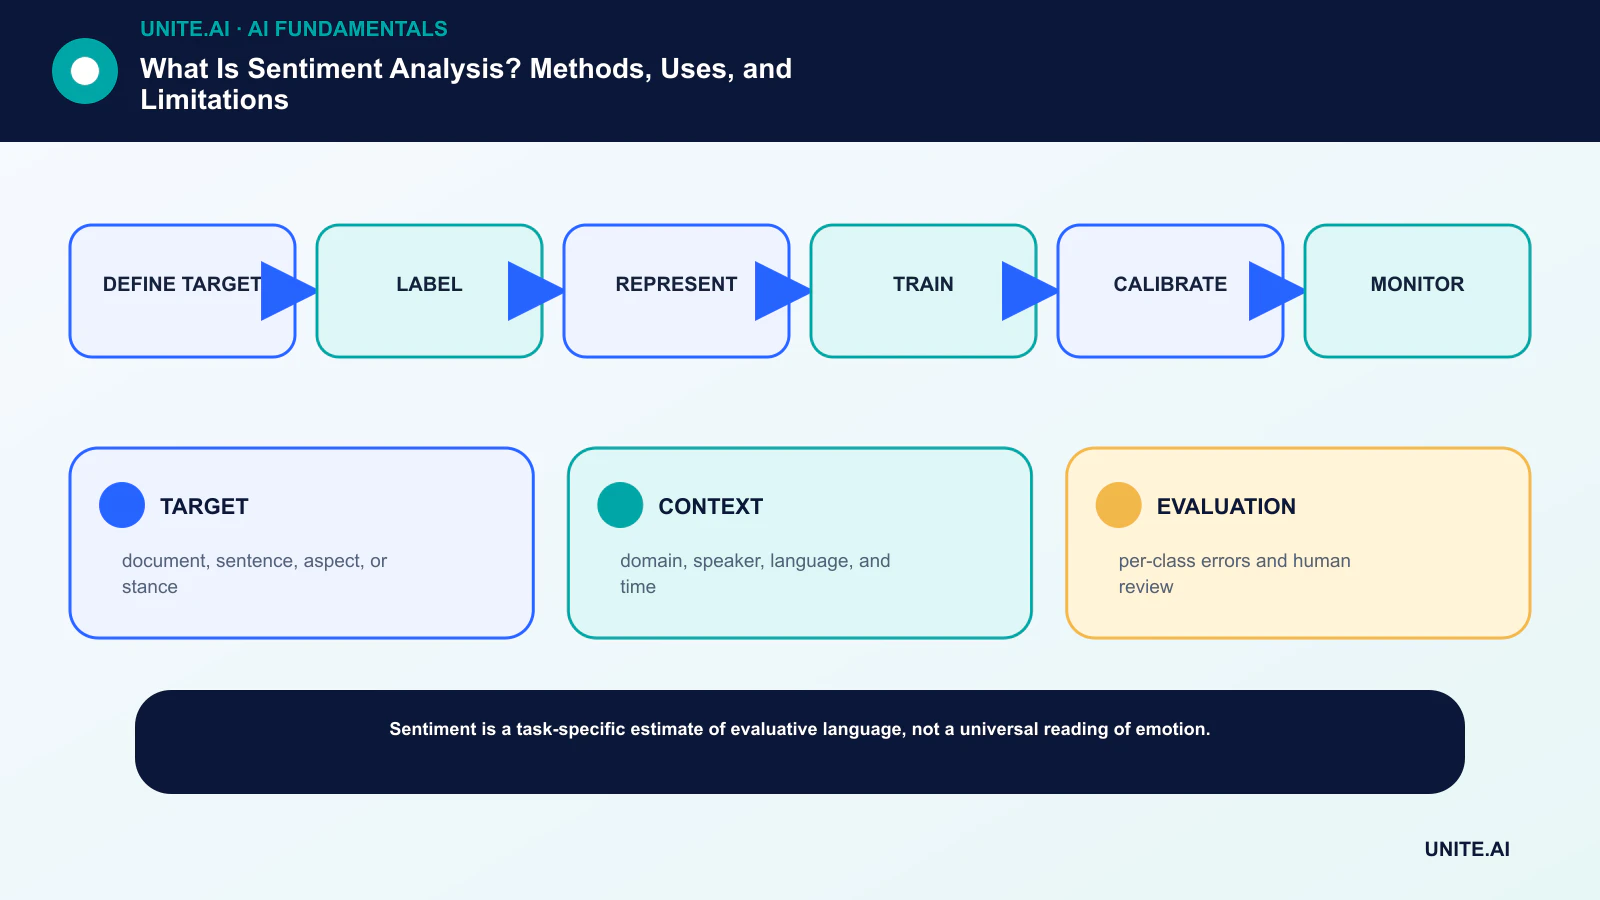
Omform konceptet til en afgrænset, testbar arbejdsproces: definer mål → etiket → repræsentation → træning → kalibrering → overvågning. Udpeg en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel grundlinje, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér overvågning, rollback og gennemgang, før omfanget udvides. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsetilstande, afhængigheds‑fejl og misbrug; bevar beviserne og uafklarede risici. Definér hvem der kan godkende frigivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når data fra den virkelige verden ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- MÅL: dokument, sætning, aspekt eller holdning.
- KONTEKST: domæne, taler, sprog og tid.
- EVALUERING: fejl per klasse og menneskelig gennemgang.
Ofte stillede spørgsmål
Er sentimentanalyse objektiv?
Nej. Den estimerer etiketter defineret af en opgave og annoteringsproces. Nogle tekster er reelt tvetydige, blandede, kontekstafhængige eller fortolkes forskelligt af læsere.
Kan sentimentanalyse opdage sarkasme?
Modeller kan lære nogle mønstre, men sarkasme afhænger ofte af talerens historik, fælles viden og kontekst uden for teksten. Det forbliver en almindelig fejlsituation.
Primære referencer












