
Andersonův úhel
Efektivnější odstraňování objektů z videa pomocí strojového učení

 Přidejte Unite.AI mezi své preferované zdroje na Google
Klíčové bodyE2FGVI sjednocuje tři fáze vyplňování videa do jednoho end-to-end systému, což přináší…
Zobrazit více
- E2FGVI sjednocuje tři fáze vyplňování videa do jednoho end-to-end systému, což přináší výrazné zvýšení efektivity.
- Systém běží patnáctkrát rychleji než předchozí metody optického toku a zároveň dosahuje výsledků na úrovni nejmodernějších přístupů.
- Nový temporální fokální transformer rozšiřuje pozornost z 2D na 3D pro koherentní halucinaci obsahu napříč snímky.
Nový výzkum z Číny hlásí nejlepší výsledky současného stavu – a také působivé zlepšení efektivity – pro nový systém video inpainting, který může zručně odstranit objekty z videa.
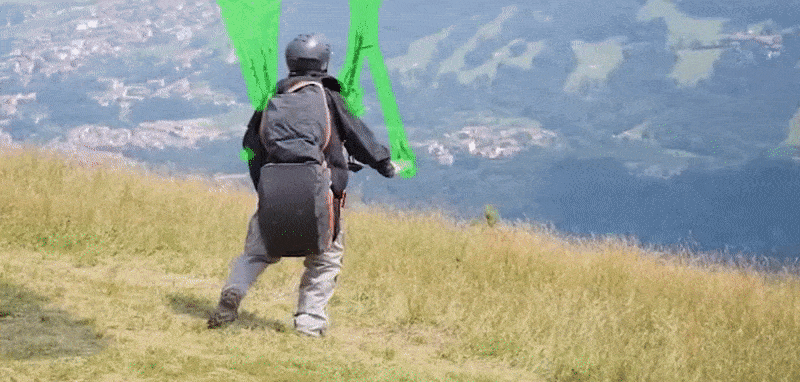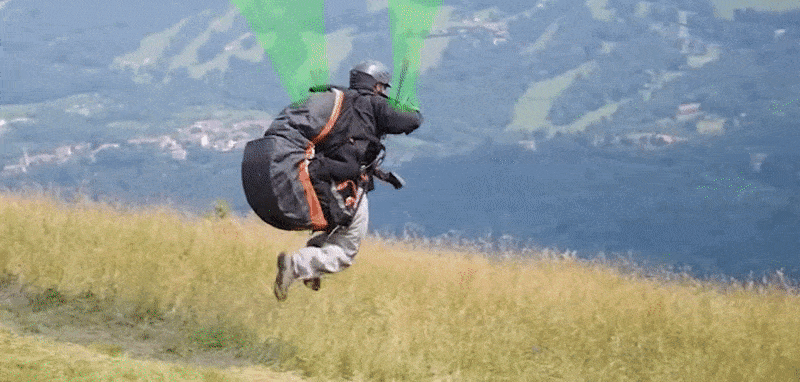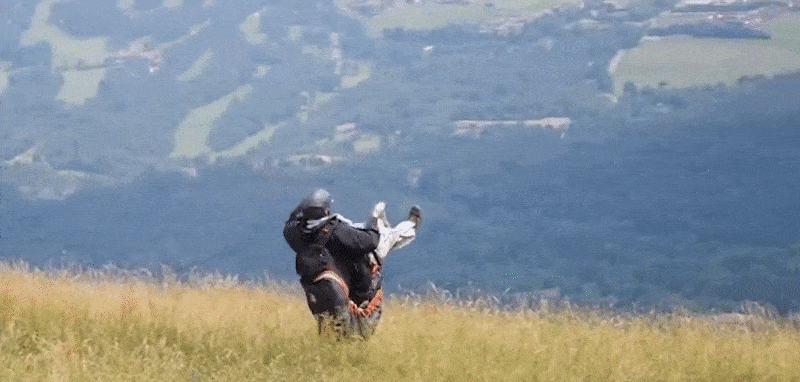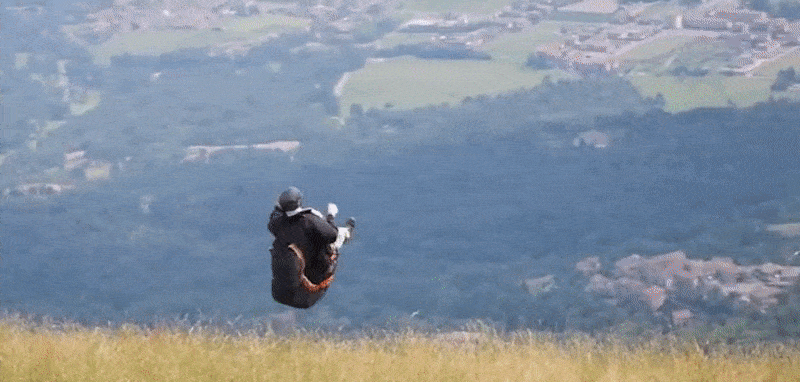
Postroj pilota závěsného kluzáku je odstraněn z obrazu novým postupem. Viz zdroj videa pro lepší rozlišení a další příklady. Zdroj: https://www.youtube.com/watch?v=N–qC3T2wc4
Technika, nazvaná End-to-End framework for Flow-Guided video Inpainting (E2FGVI), je také schopna odstranit vodotisky a různé druhy překryvů z videoobsahu.
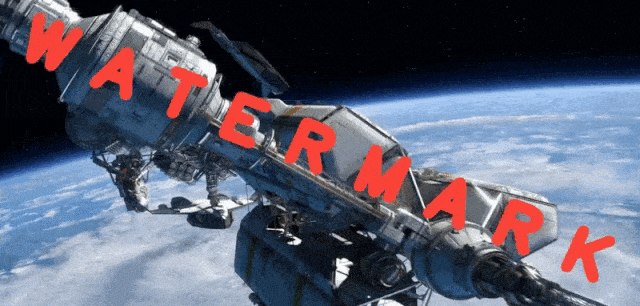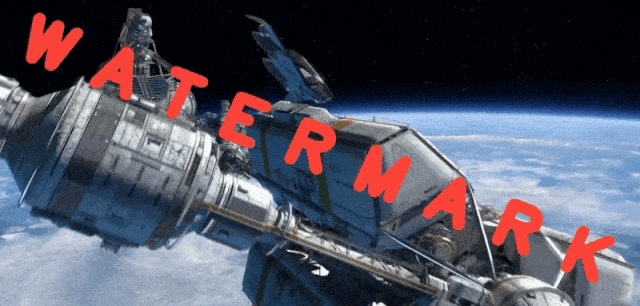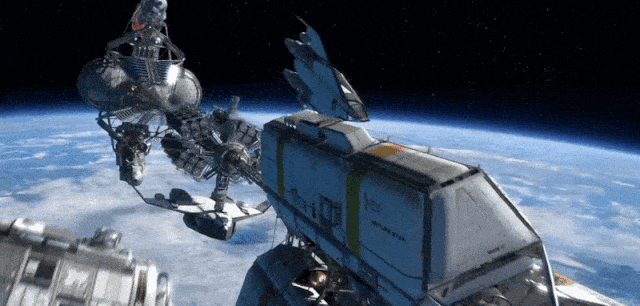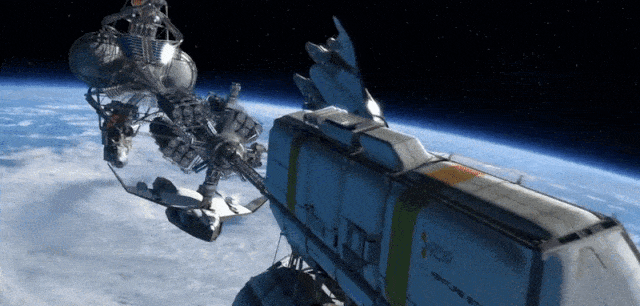
E2FGVI vypočítává předpovědi pro obsah, který se nachází za překryvy, umožňující odstranění i výrazných a jinak obtížně odstranitelných vodoznaků. Zdroj: https://github.com/MCG-NKU/E2FGVI
(Pro více příkladů v lepší kvalitě se podívejte na video)
Navzdory tomu, že model uvedený v publikované práci byl trénován na videích o rozměrech 432px x 240px (obvykle nízké vstupní velikosti, omezené dostupným prostorem GPU ve srovnání s optimálními velikostmi dávek a dalšími faktory), autoři od té doby vydali E2FGVI-HQ, který může zpracovat videa v libovolném rozlišení.
Kód pro aktuální verzi je dostupný na GitHubu, zatímco verze HQ, vydaná minulou neděli, lze stáhnout z Google Drive a Baidu Disk.

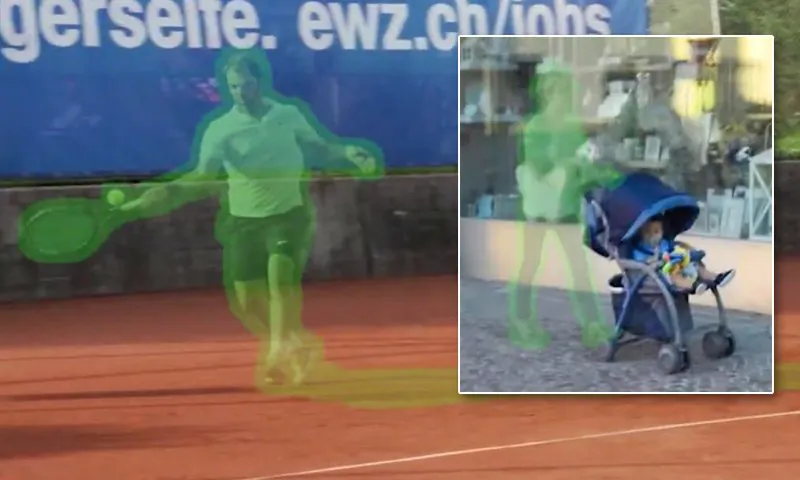
Dítě zůstává na snímku.
E2FGVI může zpracovat video 432×240 za 0,12 sekund na snímek na Titan XP GPU (12GB VRAM) a autoři uvádějí, že systém funguje patnáctkrát rychleji než předchozí špičkové metody založené na optickém toku.
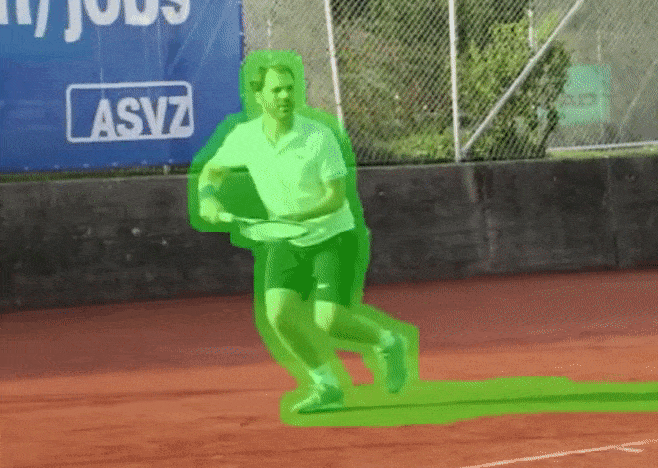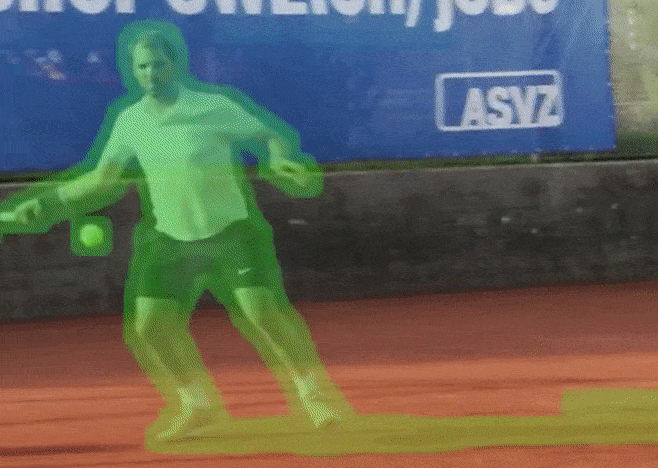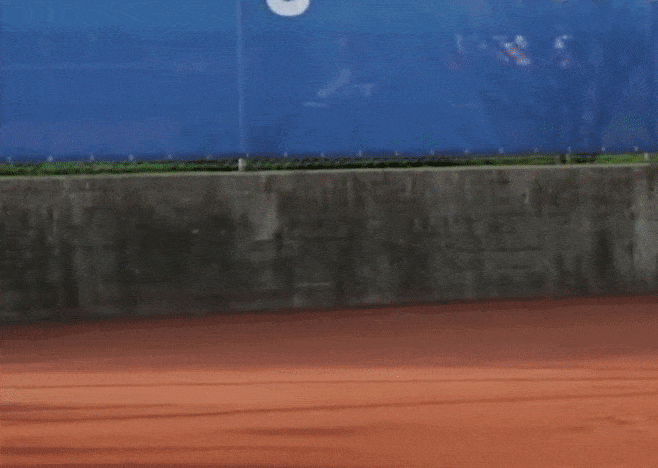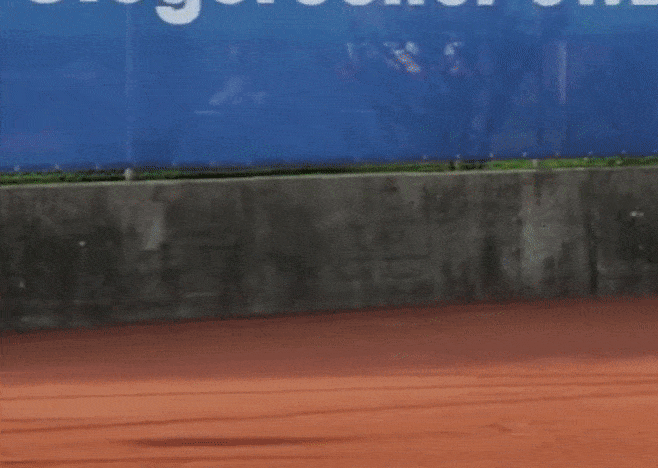
Tenisový hráč udělá nečekaný výstup.
Testována na standardních datech pro tuto podskupinu výzkumu syntézy obrazu, nová metoda dokázala překonat rivaly v kvalitativních i kvantitativních hodnoceních.

Testy proti předchozím přístupům. Zdroj: https://arxiv.org/pdf/2204.02663.pdf
Práce se jmenuje Towards An End-to-End Framework for Flow-Guided Video Inpainting a je spoluprací mezi čtyřmi výzkumníky z Nankai University a výzkumníkem z Hisilicon Technologies.
Co chybí na tomto obrázku
Kromě zřejmých aplikací pro vizuální efekty se kvalitní video inpainting stává klíčovou vlastností nových technologií založených na umělé inteligenci pro syntézu a úpravu obrazu.
To je zejména případ aplikací pro úpravu těla, a dalších rámců, které se snaží ‘ztenčit’ nebo jinak upravit scény v obrazech a videích. V takových případech je nutné přesvědčivě ‘doplnit’ další pozadí, které je odhaleno syntézou.

Z nedávné práce, algoritmus ‘přestavby’ těla je zadán úkolem doplnit nově odhalené pozadí, když se změní velikost zobrazené osoby. Zde je tato mezera reprezentována červeným obrysem, který dříve zabírala skutečná osoba plnější postavy (viz obrázek vlevo). Založeno na zdrojovém materiálu z https://arxiv.org/pdf/2203.10496.pdf
Koherentní optický tok
Optický tok (OF) se stal klíčovou technologií ve vývoji odstranění objektů z videa. Jako atlas, OF poskytuje jednorázovou mapu časové sekvence. Často se používá k měření rychlosti v iniciativách počítačového vidění, OF může také umožnit časově konzistentní doplnění, kde úkol jako celek lze zpracovat jediným průchodem, místo Disneyho stylu ‘na snímek’, který nevyhnutelně vede k časové nespojitosti.
Metody video inpainting do dneška se soustředily na třístupňový proces: dokončení toku, kde je video zásadně mapováno do diskrétní a prozkoumatelné entity; šíření pixelů, kde jsou díry v ‘poškozených’ videích doplněny bidirekcionálním šířením pixelů; a halucinace obsahu (vynález pixelů, který je známý z deepfakes a text-to-image rámců, jako je série DALL-E) kde je odhadnutý ‘chybějící’ obsah vynalezen a vložen do videa.
Centrální inovace E2FGVI spočívá v kombinaci těchto tří stupňů do jednoho systému typu end-to-end, který eliminuje potřebu ručních operací na obsahu nebo procesu.

Práce uvádí, že potřeba ručního zásahu vyžaduje, aby starší procesy nevyužily GPU, což je činí značně časově náročnými. Z práce*:
‘Vzít DFVI jako příklad, dokončení jednoho videa o velikosti 432 × 240 z DAVIS, které obsahuje asi 70 snímků, potřebuje asi 4 minuty, což je nepřípustné ve většině reálných aplikací. Kromě toho, kromě výše zmíněných nedostatků, použití pouze předem natrénované sítě pro doplňování obrazu ve fázi halucinace obsahu ignoruje vztahy mezi obsahem v čase, což vede k nekonzistentnímu generovanému obsahu ve videích.’
Sjednocením tří stupňů video inpainting E2FGVI je možné nahradit druhý stupeň, šíření pixelů, šířením příznaků. Ve více segmentovaných procesech předchozích prací nejsou příznaky tak snadno dostupné, protože každý stupeň je relativně hermetický a workflow pouze semi-automatizovaný.
Kromě toho výzkumníci vytvořili časový fokální transformér pro fázi halucinace obsahu, který zvažuje nejen přímé sousedy pixelů v aktuálním snímku (tj. co se děje v této části snímku v předchozím nebo následujícím obraze), ale také vzdálené sousedy, kteří jsou mnoha snímky daleko, a přesto budou ovlivňovat koherentní efekt jakýchkoli operací provedených na videu jako celku.

Architektura E2FGVI.
Nová centrální část pracovního postupu založená na příznacích dokáže využívat více procesů na úrovni příznaků a učitelné posuny vzorkování. Nový fokální transformer projektu podle autorů rozšiřuje velikost fokálních oken ‘z 2D na 3D’.
Testy a data
Pro testování E2FGVI autoři vyhodnotili systém proti dvěma populárním datasetům pro segmentaci objektů ve videu: YouTube-VOS a DAVIS. YouTube-VOS obsahuje 3741 trénovacích videoklipů, 474 validačních klipů a 508 testovacích klipů, zatímco DAVIS obsahuje 60 trénovacích videoklipů a 90 testovacích klipů.
E2FGVI byl trénován na YouTube-VOS a vyhodnocen na obou datech. Během trénování byly generovány objektové masky (zelené oblasti na obrázcích výše a přidružené YouTube video) pro simulaci dokončení videa.
Pro metriky autoři přijali Peak signál-šumový poměr (PSNR), Strukturní podobnost (SSIM), Fréchetova vzdálenost Inception založená na videu (VFID) a Chyba ohýbání toku – ta poslední pro měření časové stability ve zasaženém videu.
Předchozí architektury, proti kterým byl systém testován, byly VINet, DFVI, LGTSM, CAP, FGVC, STTN a FuseFormer.

Z kvantitativních výsledků práce. Šipky nahoru a dolů označují, zda vyšší nebo nižší čísla jsou lepší, resp. E2FGVI dosahuje nejlepších skórů napříč všemi. Metody jsou vyhodnoceny podle FuseFormer, ale DFVI, VINet a FGVC nejsou systémy typu end-to-end, takže není možné odhadnout jejich FLOPs.
Kromě toho, že dosáhl nejlepších skórů proti všem soupeřícím systémům, autoři provedli kvalitativní uživatelskou studii, ve které videa transformovaná pomocí pěti reprezentativních metod byla zobrazena jednotlivě dvaceti dobrovolníkům, kteří byli požádáni, aby je ohodnotili z hlediska vizuální kvality.

Svislá osa reprezentuje procento účastníků, kteří preferovali výstup E2FGVI z hlediska vizuální kvality.
Autoři uvádějí, že navzdory jednoznačné preferenci pro jejich metodu jeden z výsledků, FGVC, neodráží kvantitativní výsledky, a sugerují, že to naznačuje, že E2FGVI by mohl zavádějícím způsobem generovat ‘vizuálně příjemnější výsledky’.
Z hlediska efektivity autoři uvádějí, že jejich systém výrazně snižuje operace s plovoucí desetinnou čárkou za sekundu (FLOPs) a dobu inference na jednom Titan GPU na datasetu DAVIS, a pozorují, že výsledky ukazují, že E2FGVI běží x15 rychleji než metody založené na toku.
Komentují:
‘[E2FGVI] má nejnižší FLOPs ve srovnání se všemi ostatními metodami. To naznačuje, že navrhovaná metoda je vysoce efektivní pro video inpainting.’
*Můj převod průběžných bibliografických odkazů autorů na odkazy.
Poprvé publikováno 19. května 2022.
Opraveno v úterý 28. října 2025, aby se odstranil chybné vložené video a opravily odkazy na vložené video v článku.


