Andersonův úhel
Oddělování popředí obrazu pomocí AI, která rozumí scéně

 Přidejte Unite.AI mezi své preferované zdroje na Google
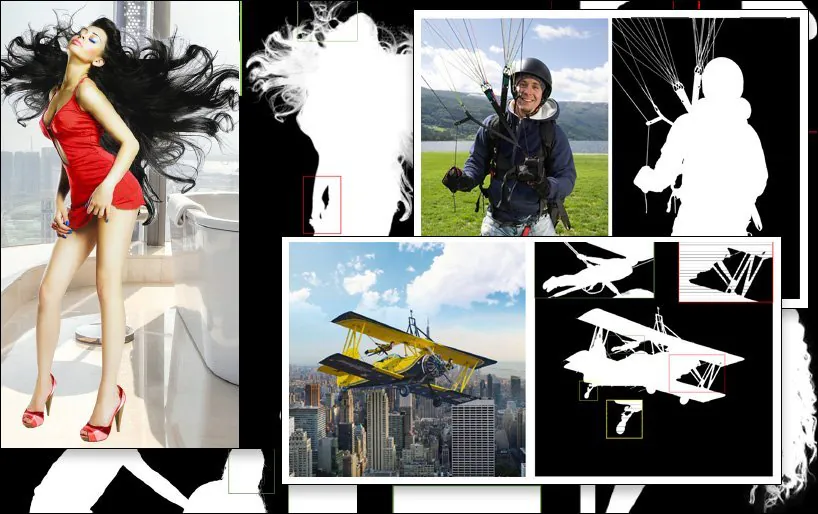
Klíčové bodyAI matting nyní využívá porozumění scéně k nahrazení zelených pláten.
Zobrazit více
- AI matting nyní využívá porozumění scéně k nahrazení zelených pláten.
- Nový pipeline SPG-IM výrazně překonává metody bez trimap.
- Textové popisky nabízejí levnou alternativu k drahé pixelové anotaci.
V dokumentu s bonusovým materiálem k vydání DVD filmu Vetřelec3 (1992) z roku 2003 vzpomínal legenda vizuálních efektů Richard Edlund s hrůzou na „sumo zápasení“ při fotochemickém vytváření masek, které dominovalo práci na vizuálních efektech od pozdních 30. let až do pozdních 80. let. Edlund přirovnal nevyzpytatelnost tohoto procesu k „sumo zápasení“ a srovnával ji s digitálními technikami využívajícími modré a zelené pozadí, které se prosadily na počátku 90. let (k této metafoře se vrátil i později).
Oddělení prvku v popředí (například člověka nebo modelu vesmírné lodi) od pozadí, aby bylo možné vyříznutý obraz složit s další záběrovou vrstvou, se původně provádělo tak, že se objekt v popředí natáčel před jednolitým modrým nebo zeleným pozadím.
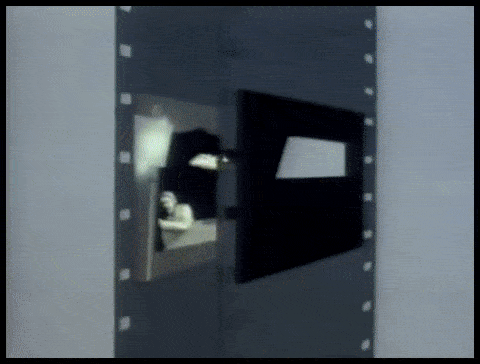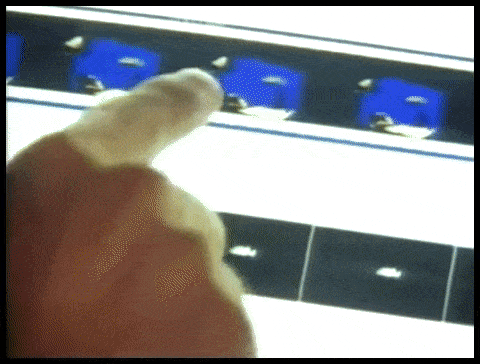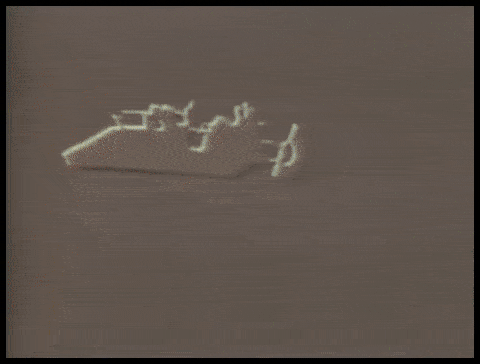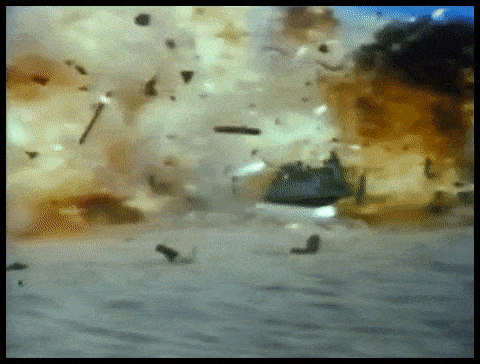
Pracné fotochemické postupy při vytváření masky pro záběr s vizuálními efekty od ILM ve filmu „Návrat Jediho“ (1983).
Na výsledném záznamu se pak barva pozadí chemicky oddělila a použila jako předloha pro opětovné vytištění objektu (nebo osoby) v optické kopírce jako „plovoucího“ objektu na jinak průhledném filmovém políčku.
Tento postup se označoval jako barevná separace a překrytí (CSO) – tento termín se však později spojoval především s hrubými videoefekty klíčování podle barvy v televizních pořadech s nízkým rozpočtem ze 70. a 80. let, které se vytvářely analogově, nikoli chemicky nebo digitálně.

Ukázka barevné separace a překrytí z roku 1970 v britském dětském pořadu „Blue Peter“. Zdroj: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Ať už šlo o filmový, nebo videozáznam, výsledný vyříznutý záběr bylo možné vložit do jakéhokoli jiného záznamu.
Ačkoli Disneyho výrazně dražší a chráněný proces se sodíkovými výbojkami (který využíval konkrétně žlutou barvu a použil se také při natáčení hororu Ptáci Alfreda Hitchcocka z roku 1963) poskytoval přesnější obrysy a ostřejší masky, fotochemické vytváření masek zůstávalo pracné a nespolehlivé.

Disneyho vlastní proces vytváření masek pomocí sodíkových výbojek vyžadoval pozadí v oblasti žlutého konce spektra. Zde je Angela Lansburyová zavěšená na lanech během natáčení sekvence s vizuálními efekty pro film „Bedknobs and Broomsticks“ (1971). Zdroj
Za hranice digitálního oddělování popředí
Digitální revoluce v 90. letech odstranila potřebu chemikálií, nikoli však zeleného pozadí. Nyní bylo možné odstranit zelené (nebo jakékoli jiné) pozadí jednoduše tak, že se v programech pro úpravu pixelů, jako je Photoshop, a v nové generaci nástrojů pro skládání videa, které dokázaly barevné pozadí automaticky odstranit, vyhledaly pixely v určité toleranci dané barvy. Téměř přes noc tak šedesát let průmyslu optického kopírování skončilo v propadlišti dějin.
Posledních deset let výzkumu počítačového vidění s akcelerací pomocí GPU přivádí vytváření masek do třetí éry. Výzkumníci v ní mají za úkol vyvíjet systémy, které dokážou vytvářet kvalitní masky bez potřeby zeleného pozadí. Na Arxiv se každý týden objevují studie o inovacích v oblasti strojového učení pro oddělování objektů v popředí.
Dostaňme se do záběru
Zájem akademické i průmyslové sféry o oddělování objektů pomocí AI už zasáhl také spotřebitelskou oblast: všichni známe jednoduché, ale funkční filtry v aplikacích Zoom a Skype, které při videohovorech dokážou nahradit pozadí našeho obývacího pokoje tropickým ostrovem a podobně.
Nejkvalitnější masky však stále vyžadují zelené pozadí, jak upozornil Zoom minulou středu.

Vlevo muž před zeleným pozadím, jehož vlasy jsou díky funkci Virtuální pozadí v aplikaci Zoom dobře oddělené. Vpravo žena před běžným domácím prostředím; její vlasy jsou oddělené algoritmicky, méně přesně a s vyššími nároky na výpočetní výkon. Zdroj: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Další příspěvek na platformě podpory Zoom upozorňuje, že oddělování objektů bez zeleného pozadí vyžaduje také vyšší výpočetní výkon zařízení, které záznam pořizuje.
Proč je třeba objekt vyříznout
Zlepšení kvality, přenositelnosti a úspornosti z hlediska výpočetních prostředků u systémů pro extrakci popředí „v reálných podmínkách“ (tj. izolaci lidí bez nutnosti použití zeleného plátna) má význam pro mnohem více odvětví a oblastí činnosti než jen pro filtry ve videokonferencích.
Pro vývoj datových sad umožňuje zdokonalené rozpoznávání obličeje, celé hlavy a celého těla zajistit, aby se do modelů počítačového vidění lidských subjektů při trénování nedostaly nadbytečné prvky pozadí; přesnější izolace by výrazně zlepšila techniky sémantické segmentace určené k rozlišování a začleňování kategorií (tj. „kočka“, „osoba“, „loď“) a zdokonalila by systémy pro syntézu obrazu založené na VAE a transformerech, například nový DALL-E 2 od OpenAI; lepší algoritmy extrakce by navíc omezily potřebu nákladného ručního rotoskopování v nákladných procesech tvorby vizuálních efektů.
Prosazování multimodálních (obvykle textových a obrazových) metod, v nichž je oblast, jako je „kočka“, zakódována zároveň jako obraz i prostřednictvím souvisejících textových odkazů, už proniká do zpracování obrazu. Jedním z nedávných příkladů je architektura Text2Live, která pomocí multimodálního (textového a obrazového) trénování vytváří videa s nesčetnými náměty, mimo jiné s křišťálovými labutěmi a skleněnými žirafami.
Oddělování popředí obrazu pomocí AI se zohledněním scény
Značná část výzkumu automatického oddělování popředí pomocí AI se zaměřuje na rozpoznávání hranic a vyhodnocování skupin pixelů v obrazu nebo videosnímku. Nový výzkum z Číny však představuje postup extrakce, který zlepšuje vymezení objektů i kvalitu masky tím, že využívá textové popisy scény (multimodální přístup, který si v oblasti výzkumu počítačového vidění získal za poslední 3–4 roky značnou oblibu). Autoři tvrdí, že jejich metoda v několika ohledech překonává dosavadní postupy.

Příklad extrakce metodou SPG-IM (poslední obrázek vpravo dole) ve srovnání s dřívějšími konkurenčními metodami. Zdroj: https://arxiv.org/pdf/2204.09276.pdf
Výzvou pro výzkum extrakce popředí je vytvářet pracovní postupy, které vyžadují co nejméně ručního anotování a lidských zásahů – ideálně žádné. Kromě nákladů výzkumníci v nové studii upozorňují, že anotace a ruční segmentace prováděné pracovníky z různých kultur najímanými prostřednictvím crowdsourcingu mohou vést k tomu, že jsou obrazy označovány nebo dokonce segmentovány různými způsoby. Výsledkem jsou nekonzistentní a neuspokojivé algoritmy.
Jedním z příkladů je subjektivní výklad toho, co představuje „objekt v popředí“:

Z nové studie: Dřívější metody LFM a MODNet (‚GT‘ označuje Ground Truth, tedy „ideální“ výsledek, kterého se často dosahuje ručně nebo nealgoritmickými metodami) vykládají obsah popředí různě a s různou úspěšností, zatímco nová metoda SPG-IM účinněji vymezuje „blízký obsah“ na základě kontextu scény.
Aby tento problém vyřešili, vyvinuli výzkumníci dvoufázový postup nazvaný Situational Perception Guided Image Matting (SPG-IM). Dvoufázová architektura kodéru a dekodéru se skládá z modulů Situational Perception Distillation (SPD) a Situational Perception Guided Matting (SPGM).

Architektura SPG-IM.
Nejprve modul SPD předtrénuje převod vizuálních příznaků na textové a vytváří popisky odpovídající příslušným obrazům. Poté se propojením postupu s novou technikou predikce nápadnosti umožní předpovídat masku popředí.
Modul SPGM následně vytvoří odhadovanou alfa masku na základě vstupního surového obrazu RGB a masky vygenerované v prvním modulu.
Cílem je navádění pomocí situačního vnímání, při němž systém chápe kontext a obsah obrazu. Díky tomu může například při extrakci složitých vlasů z pozadí zohlednit známé vlastnosti tohoto konkrétního úkolu.

V níže uvedeném příkladu SPG-IM rozpozná, že šňůry jsou nedílnou součástí „padáku“, zatímco MODNet tyto detaily nedokáže zachovat ani vymezit. Stejně tak se v příkladu výše v MODNet libovolně ztrácí celá konstrukce hřištního zařízení.
Nová studie má název Oddělování popředí obrazu řízené situačním vnímáním a jejími autory jsou výzkumníci z OPPO Research Institute, PicUp.ai a Xmotors.
Inteligentní automatické masky
SPG-IM představuje také síť pro zpřesňování Adaptive Focal Transformation (AFT), která dokáže samostatně zpracovávat místní detaily a globální kontext, a umožňuje tak vytvářet „inteligentní masky“.

Porozumění kontextu scény, v tomto případě „dívce s koněm“, může usnadnit extrakci popředí ve srovnání s předchozími metodami.
Studie uvádí:
„Domníváme se, že vizuální reprezentace z úlohy převodu obrazu na text, například popisování obrázků, se zaměřují na sémanticky komplexnější signály ve vztazích a) mezi objekty a b) mezi objektem a okolním prostředím, aby vytvořily popisy, které zachycují globální informace i místní detaily. Navíc lze textové popisky ve velkém množství shromažďovat za velmi nízkou cenu, zatímco anotace jednotlivých pixelů při oddělování popředí obrazu je nákladná.“
Větev SPD této architektury se společně předtrénovává s textovým dekodérem VirTex založeným na transformeru z University of Michigan, který se učí vizuální reprezentace ze sémanticky bohatých popisků.

VirTex společně trénuje konvoluční neuronovou síť a transformery pomocí dvojic obrázků a popisků a získané poznatky přenáší do navazujících úloh počítačového vidění, jako je detekce objektů. Zdroj: https://arxiv.org/pdf/2006.06666.pdf
V rámci dalších testů a ablačních studií výzkumníci porovnali SPG-IM s nejmodernějšími metodami založenými na trimapě: Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA a Semantic Image Matting (SIM).
Mezi testované dřívější rámce patřily také metody bez trimapy LFM, HAttMatting a MODNet. Aby bylo srovnání spravedlivé, byly testovací metody upraveny s ohledem na rozdílné metodiky; pokud nebyl k dispozici kód, autoři studie postupy zreplikovali podle popsané architektury.
Nová studie uvádí:
„Náš model SPG-IM výrazně překonává všechny konkurenční metody bez trimapy ([LFM], [HAttMatting] a [MODNet]). Náš model zároveň vykazuje pozoruhodnou převahu nad nejmodernějšími metodami založenými na trimapě a metodami řízenými maskou ve všech čtyřech metrikách napříč veřejnými datovými sadami (tedy Composition-1K, Distinction-646 a Human-2K) i na našem benchmarku Multi-Object-1K.“
A pokračuje:
„Je zřejmé, že naše metoda zachovává jemné detaily (například konečky vlasů, průhledné textury a hranice) i bez vodítka v podobě trimapy. Ve srovnání s jinými konkurenčními modely bez trimapy navíc náš SPG-IM lépe zachovává globální sémantickou úplnost.“


Poprvé zveřejněno 24. dubna 2022.