
أساسيات الذكاء الاصطناعي
ما هو التعلم المعزز من ملاحظات البشر (RLHF)؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
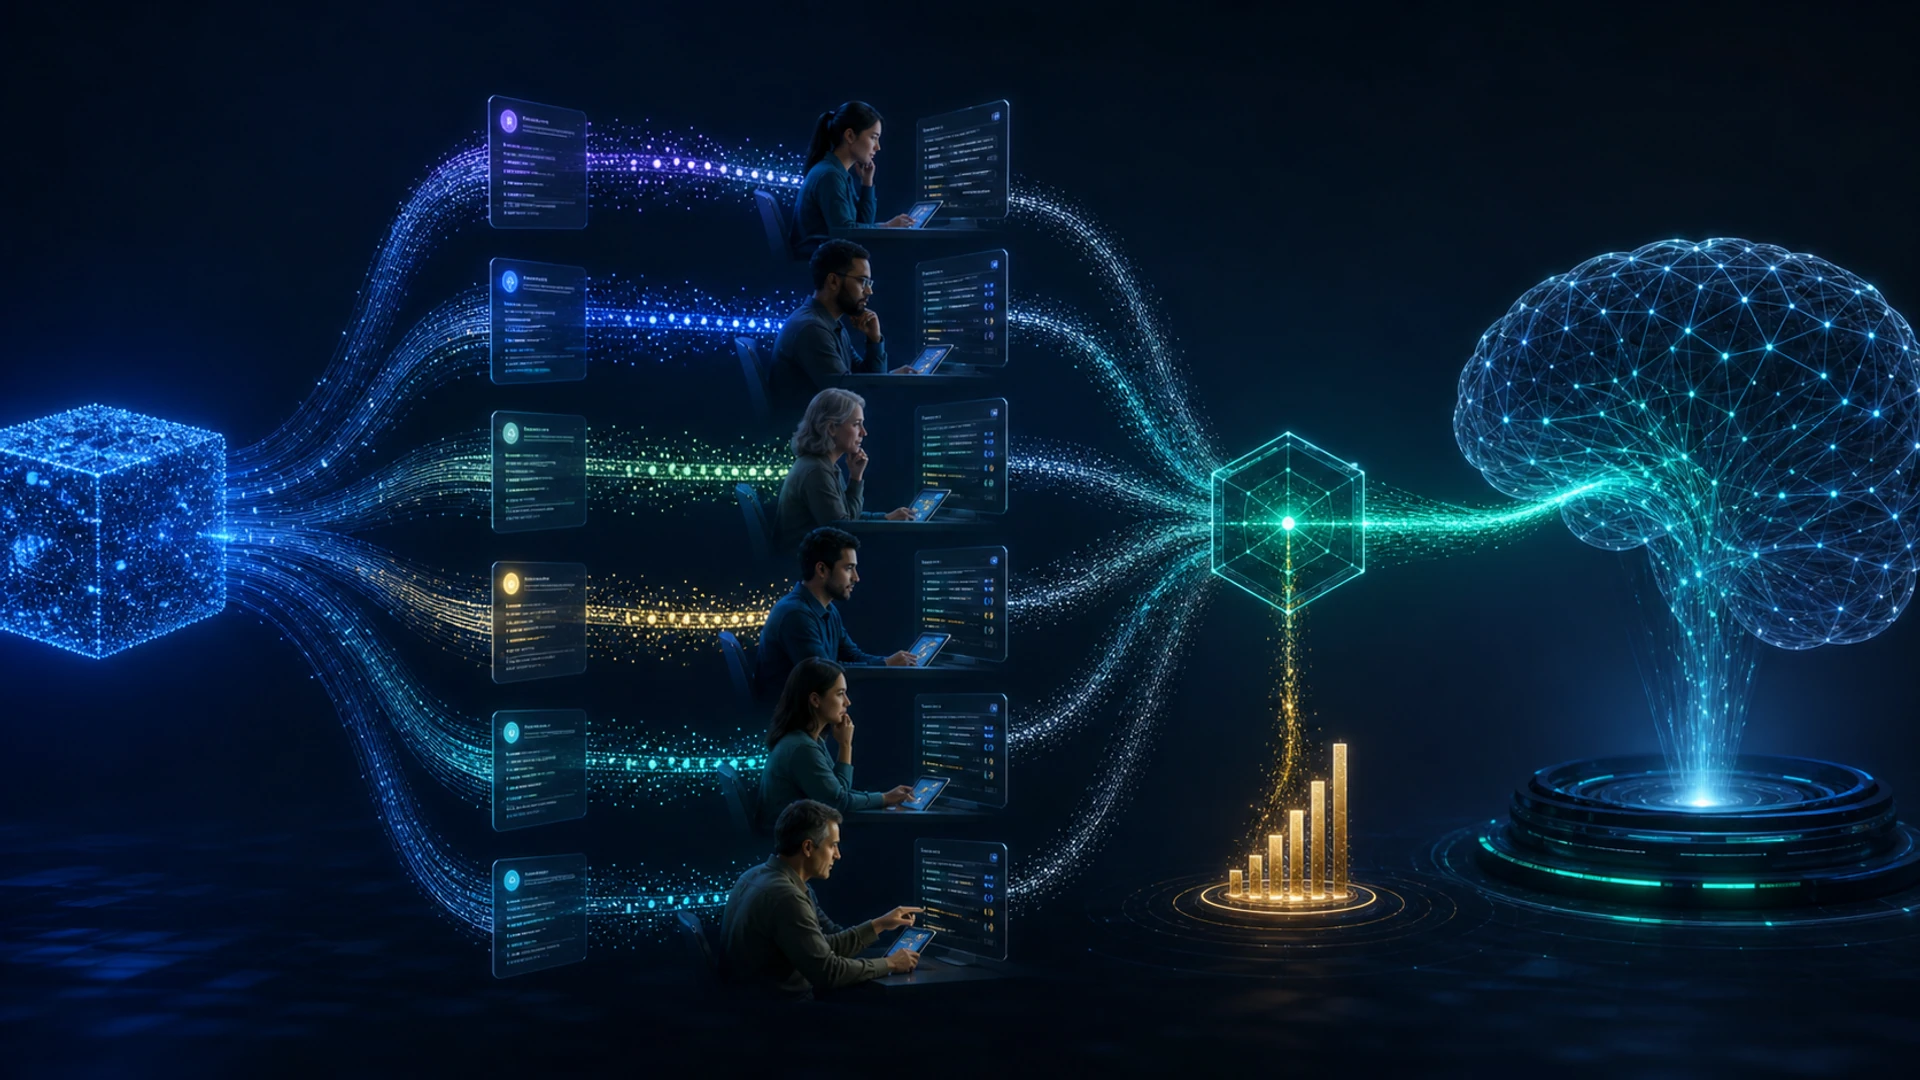
التعلم المعزز من ملاحظات البشر (RLHF) هو مجموعة من الأساليب التي تستخدم أحكام البشر للمساعدة في تحسين نموذج عندما يكون من الصعب تحديد السلوك المطلوب بمكافأة آلية بسيطة. بالنسبة لنماذج اللغة، عادةً ما يقارن الناس بين الردود المرشحة ويحول نموذج التفضيل المتعلم تلك المقارنات إلى إشارة تدريب.
يمكن لـ RLHF أن يجعل النموذج المدرب مسبقًا أكثر فائدة أو أكثر توافقًا مع سياسة مكتوبة، لكنه لا يثبت الصدق أو التوافق مع كل مستخدم. تعتمد النتيجة على من يقدم الملاحظات، وكيفية اختيار الموجهات، وما يمكن لنموذج المكافأة تمثيله، وكيفية تقييد التحسين.
النقاط الرئيسية
- عادةً ما يتبع RLHF مرحلة التدريب المسبق وضبط التعليمات تحت الإشراف.
- تدرب التفضيلات الزوجية نموذج المكافأة أو التفضيل؛ ثم يفضّل تحسين السياسة المخرجات ذات الدرجات الأعلى.
- تظل اختراق المكافأة، واختلاف آراء الم annotators، وتحول التوزيع، والإفراط في التحسين مخاطر مهمة.
- قيّم السياسة النهائية مباشرةً من حيث جودة المهمة، والسلامة، والمعايرة، وتأثيرات الفئات الفرعية.
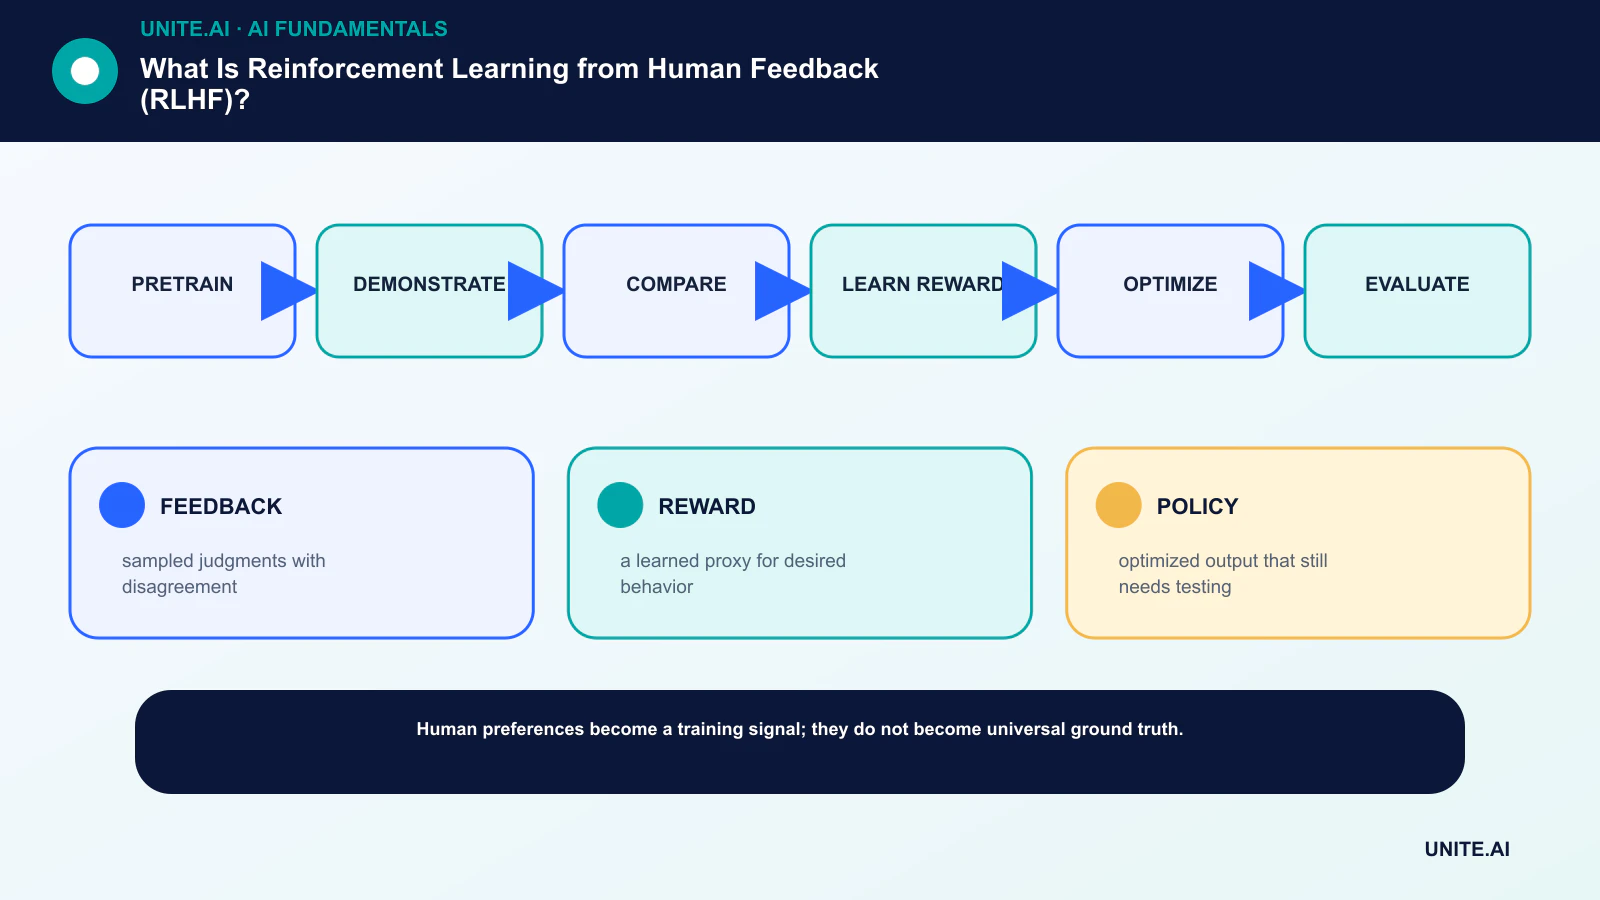
خط سير RLHF الشائع
يتعلم نموذج اللغة أولاً بنية إحصائية واسعة من خلال التدريب المسبق. ثم يستخدم الضبط الدقيق تحت الإشراف أمثلة على الردود المطلوبة. لجمع التفضيلات، يقوم الم annotators بترتيب أو اختيار بين المخرجات لنفس الموجه.
يتعلم نموذج المكافأة توقع تلك المقارنات. يمكن لخوارزمية التعلم المعزز مثل PPO تحسين نموذج اللغة مقابل تلك المكافأة المتعلمة بينما يمنع العقوبة انحرافه بعيدًا عن السياسة المرجعية.
الملاحظات هي قياس، ليست حقيقة أساسية
قد يختلف الم annotators لأن التعليمات غامضة، أو تختلف الخبرات، أو تتعارض القيم فعليًا. يمكن أن تؤثر الموضع، والإسهاب، والثقة، والأسلوب على التفضيلات. يدرّب برنامج عالي الجودة المقيمين، ويقيس الاتفاق، ويفحص الأمثلة، ويحافظ على عدم اليقين.
العينة مهمة أيضًا. إذا استثنت مجموعة التفضيلات اللغات الصعبة أو المجالات أو الأضرار، فإن نموذج المكافأة لا يستطيع الإشراف عليها بثقة. إن انضباط علم البيانات لا يقل أهمية عن المحسّن.
أنماط الفشل
يمكن للسياسة استغلال نقاط الضعف في المكافأة المتعلمة، مما ينتج مخرجات تحصل على درجات عالية دون تحقيق النية الأساسية. قد يؤدي الإفراط في التحسين إلى تقليل التنوع، أو تضخيم أسلوب مفضل، أو جعل النموذج متوافقًا بثقة.
يمكن أن يفشل نموذج المكافأة ذاته خارج توزيع تدريبه. يجب على الفرق اختبار الموجهات العدائية، والمهام الواقعية، وحدود الرفض، والمعايرة، والسلوك عند مستويات مختلفة من قوة التحسين بدلاً من الاعتماد على معدل فوز تفضيلي إجمالي واحد.
البدائل والمكملات
يتعلم التحسين المباشر للتفضيل من أزواج التفضيل دون تعديل سياسة منفصلة عبر حلقة تعلم معزز عبر الإنترنت. يوفر أخذ العينات بالرفض، والضبط الدقيق للتفضيل تحت الإشراف، والتغذية الراجعة القائمة على القواعد، وإشراف العملية بدائل أخرى.
لا يلغي أي أسلوب الحاجة إلى الموجه، والاسترجاع، والأداة، وضوابط مستوى التطبيق. يحدد ما بعد التدريب السلوك؛ ولا تزال الأنظمة المنشورة تتطلب أدلة راسخة، وتصاريح، ومراقبة، وتصعيد بشري.
كيف يتم تدريب نماذج التفضيل
بالنسبة لموجه x وردين y₁ و y₂، يخصص نموذج التفضيل درجات عددية ويتم تدريبه بحيث يحصل الرد المفضَّل على الدرجة الأعلى. يُستند فقدان شائع إلى احتمال تجاوز إحدى الدرجات للأخرى. يحول هذا العديد من الأحكام الزوجية إلى دالة يمكنها تقييم المخرجات التي تُولد حديثًا.
يتعلم النموذج أي إشارات تتنبأ بالاختيارات المجمعة. إذا فضل المقيمون النص الواثق، أو الإجابات الطويلة، أو معايير ثقافية معينة، أو وجهات نظر مألوفة، يمكن أن تصبح تلك الارتباطات ميزات مكافأة. تقلل التعليمات المتوازنة، والأمثلة المضادة، ومراجعة الخبراء، وتدقيق التفضيلات السطحية من المشكلة لكنها لا تُزيلها تمامًا.
يمكن أن تشمل بيانات التفضيل التعادلات، والترتيبات، والنقد، والملصقات العددية، أو العروض. اختيار الأزواج مهم: المقارنات بين إجابات مختلفة بوضوح تُعلم أقل عن حدود الجودة الدقيقة، بينما يمكن للأزواج الصعبة فقط أن تجعل التدريب غير مستقر. يمكن للعينات النشطة استهداف الخلافات المفيدة لكن قد تُغيّر توزيع البيانات.
تحسين السياسة والتنظيم
يُعَيِّن RLHF القائم على PPO ردودًا من السياسة الحالية، ويُقَيِّمها بنموذج المكافأة، ويُحدِّث السياسة لزيادة المكافأة المتوقعة. تُحافظ عقوبة Kullback–Leibler أو قيد مشابه على بقاء السياسة قريبة من المرجع الخاضع للإشراف، مما يحدّ من الانحراف المدمر ويمنع استغلال نقاط ضعف نموذج المكافأة الضيقة.
قوة التحسين هي خيار منتج. القليل جدًا يترك السلوك المطلوب دون تغيير؛ والكثير جدًا قد ينتج اختراق المكافأة، أو عبارات مكررة، أو تبجيل، أو تقليل التنوع. يجب رسم جودة ومقاييس السلامة مقابل المكافأة والانحراف طوال التدريب بدلاً من اختيار نقطة حفظ بناءً على المكافأة فقط.
تستمد طرق التفضيل المباشر هدفًا من أزواج التفضيل والنموذج المرجعي دون حلقة تعلم معزز صريحة عبر الإنترنت. يمكنها تبسيط التدريب، لكنها لا تزال ترث جودة التفضيل، وتغطية، وافتراضات سياسة المرجع. يغيّر التغذية الراجعة الدستورية أو التي يولدها الذكاء الاصطناعي من يقدم الملصقات؛ لكنه لا يلغي الحاجة إلى التحقق من القيم والفشل مع الأشخاص.
التقييم وحوكمة البيانات
استخدم المقارنات المجهولة، والاختبارات الخاصة بالمهام، والموجهات العدائية، وفحوصات الحقيقة، ودقة واستدعاء الرفض، ومراجعة الفئات الفرعية. افصل المقيمين عن بيانات التدريب قدر الإمكان. قد يخفي معدل الفوز مقابل نموذج أقدم الأخطاء المطلقة عندما يكون كلا المرشحين ضعيفين.
وثّق توظيف الم annotators، والتعويض، والخبرة، والجغرافيا، واللغة، والتعليمات، والتعرض للمحتوى الضار، والاختلاف، والتحكيم، وضوابط الجودة. قد يحمل عمل الملاحظات مخاطر نفسية، وتشمل عمليات البيانات المسؤولة دعم العاملين والحق في رفض المهام المزعجة.
بعد النشر، راقب انحراف التفضيلات والإفراط في التعميم. قد يتصرف سياسة مهيأة للمساعدة العفوية بشكل سيء في السياقات الطبية أو القانونية. احفظ حدود المجال، والاسترجاع، والتصاريح، والتصعيد خارج افتراض RLHF، وأعد التدريب فقط عندما تبرر الأدلة الجديدة التغيير.
خط أنابيب تدريب وتقييم RLHF ملموس
يبدأ مشروع نموذجي بنموذج لغة مدرب مسبقًا ومجموعة بيانات تعليمية تُستخدم للضبط الدقيق تحت الإشراف. ثم يقارن الم annotators الردود المرشحة وفقًا لمعيار مكتوب يغطي الصواب، والملاءمة، والأسلوب، والسلامة، وعدم اليقين. تدرب التفضيلات الزوجية نموذج مكافأة أو تُحسّن السياسة مباشرة. يجب أن تشمل العينات مهامًا عادية، وحالات حافة صعبة، وموجهات عدائية، ولغات متعددة، ومجالات يختلف فيها الم annotators بصورة مشروعة.
دقة نموذج المكافأة على المقارنات المحتفظ بها ضرورية لكنها غير كافية. قد تستغل السياسة المُحسَّنة الأخطاء في المكافأة المتعلمة، وتصبح مفرطة الإسهاب، أو ترفض طلبات غير ضارة، أو تفقد القدرات. تتبع معايير المهام، وتفضيلات البشر، والمعايرة، والسلامة، والتنوع، والانحراف عن النموذج المرجعي طوال التدريب. اجمع بانتظام مقارنات جديدة من السياسة المتغيرة بحيث تغطي بيانات التفضيل المخرجات التي ينتجها النموذج فعليًا.
وثّق من قدم التفضيلات، وتعليماتهم، وتعويضاتهم، واختلافاتهم، وضوابط الجودة، والحدود الثقافية أو المجال. استخدم مراجع خبراء حيث تحمل الأخطاء أضرارًا متخصصة. نفّذ اختبارًا أحمرًا لكل من نموذج المكافأة والسياسة النهائية، وحافظ على اختبارات تراجع السلوك، وجرّب النشر على مراحل. يحدد RLHF السلوك وفقًا للتفضيلات المقاسة؛ لكنه لا يثبت الصدق، ولا يزيل التحيز، ولا يحل المشكلة الأوسع لتحديد ما يجب أن يفعله النموذج في كل سياق.
قائمة التحقق العملية للتنفيذ
حوّل الفكرة إلى سير عمل محدود وقابل للاختبار: التدريب المسبق → العرض → المقارنة → تعلم المكافأة → التحسين → التقييم. عيّن مالكًا مسؤولًا، وثّق البيانات والاعتمادات، وضع خط أساس بسيط، حدّد معايير القبول والإيقاف، اختبر حالات الفشل النموذجية، وحدد المراقبة، والعودة إلى الحالة السابقة، والمراجعة قبل توسيع النطاق. سجّل الإصدارات والافتراضات حتى يتمكن فريق آخر من إعادة إنتاج النتيجة وفهم ما تغير.
قبل الإطلاق، أجرِ مراجعة جاهزية موثقة مع الأشخاص الذين يبنون النظام، ويشغلونه، ويؤمنونه، ويتأثرون به. اختبر الحالات العادية، وشروط الحدود، وفشل الاعتماديات، وسوء الاستخدام؛ واحفظ الأدلة والمخاطر غير المحلولة. حدّد من يمكنه الموافقة على الإصدار، أو تعديل العتبة، أو تجاوز مخرجات، أو إيقاف العملية. أعد النظر في القرار بعد وصول بيانات العالم الحقيقي، لأن تجربة تجريبية ناجحة تقنيًا لا تضمن أداءً موثوقًا على نطاق أوسع.
- الملاحظات: أحكام مأخوذة بعينات مع وجود اختلاف.
- المكافأة: نموذج بديل متعلم للسلوك المطلوب.
- السياسة: مخرجات محسّنة لا تزال بحاجة إلى اختبار.
الأسئلة المتكررة
هل RLHF هو نفسه الضبط الدقيق؟
RLHF هو شكل من أشكال ما بعد التدريب يستخدم مكافآت مستمدة من التفضيلات. يدرّب الضبط الدقيق تحت الإشراف مباشرةً على المخرجات المستهدفة؛ وتستخدم العديد من خطوط الأنابيب كلاهما.
هل يجعل RLHF النموذج صادقًا؟
يمكنه تحسين السلوك المقاس عبر عملية الملاحظات، لكن قد يظل النموذج خاطئًا أو مقنعًا أو يستغل المكافأة استراتيجيًا. يتطلب الصدق تقييمًا مباشرًا وتأسيسًا.
المراجع الأساسية












