أساسيات الذكاء الاصطناعي
ما هو التعلم العميق المعزز؟

 أضف Unite.AI إلى مصادرك المفضلة على Google
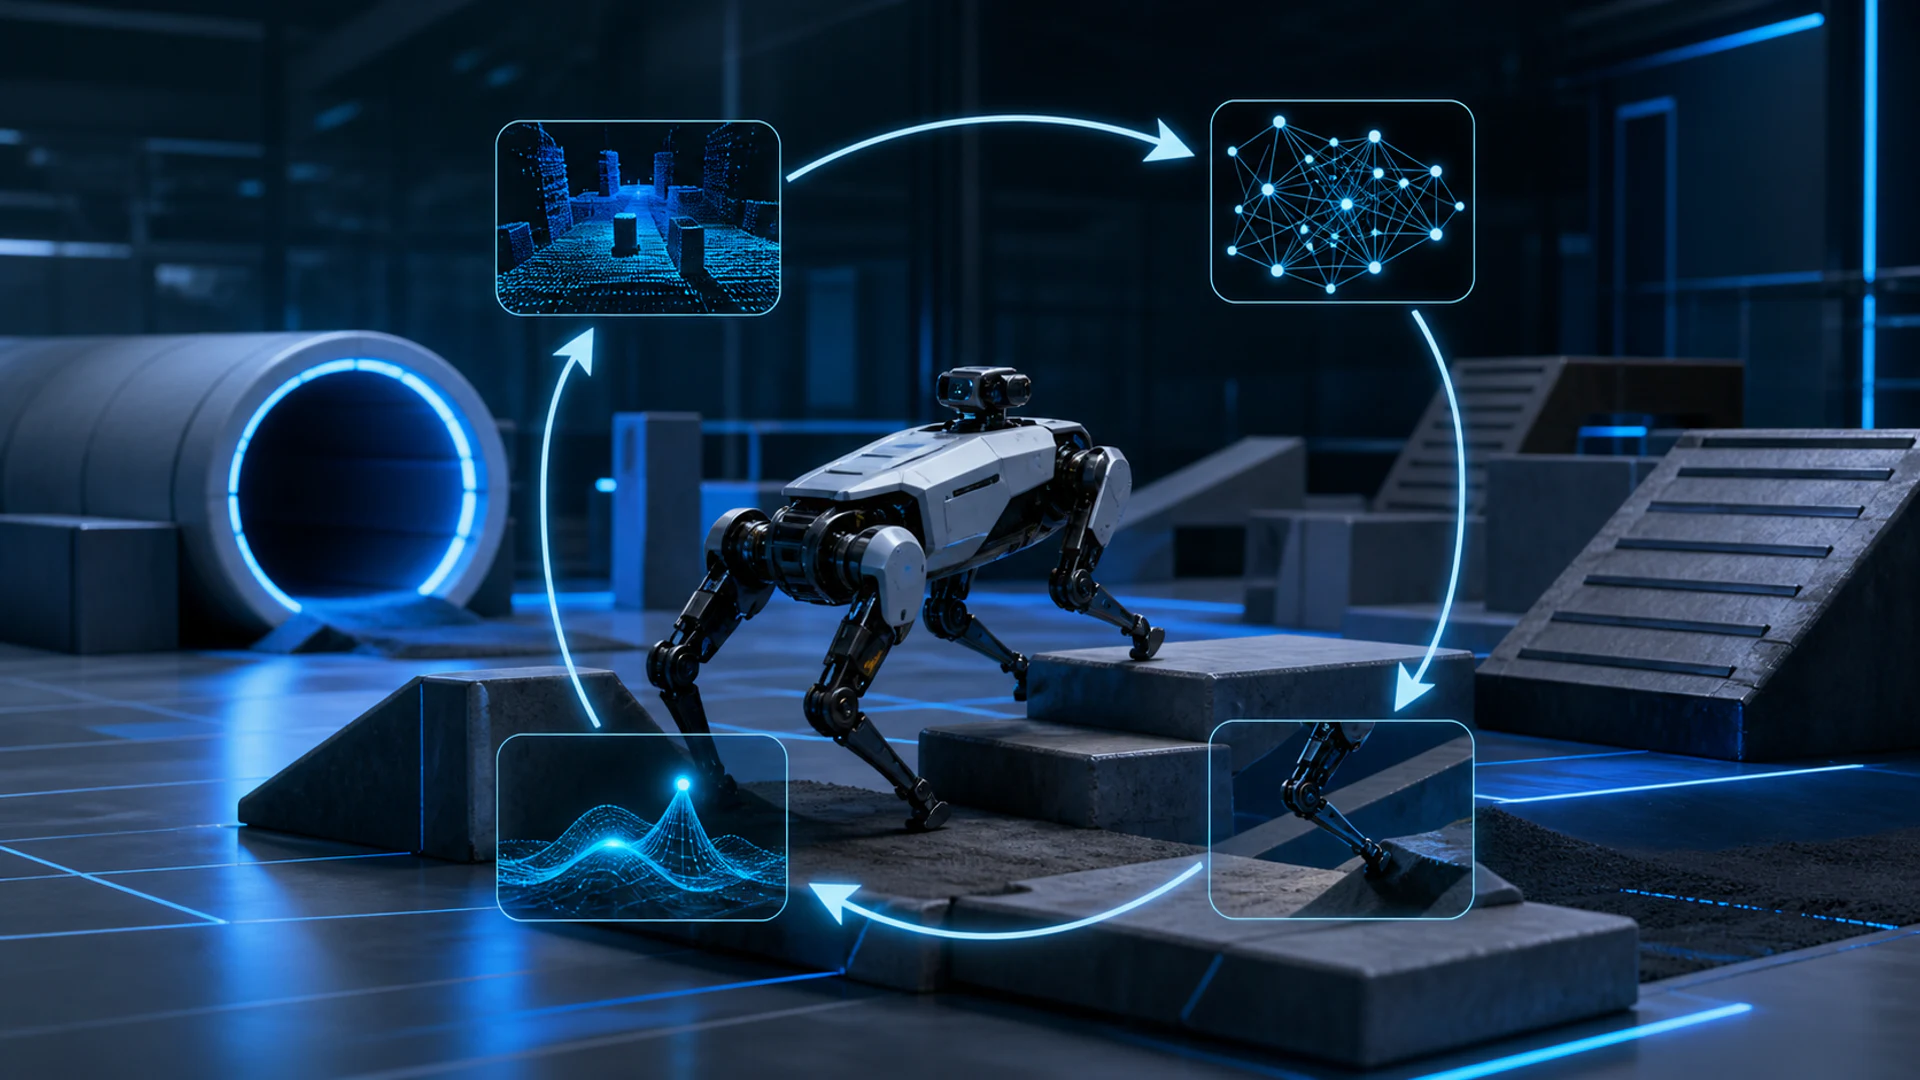
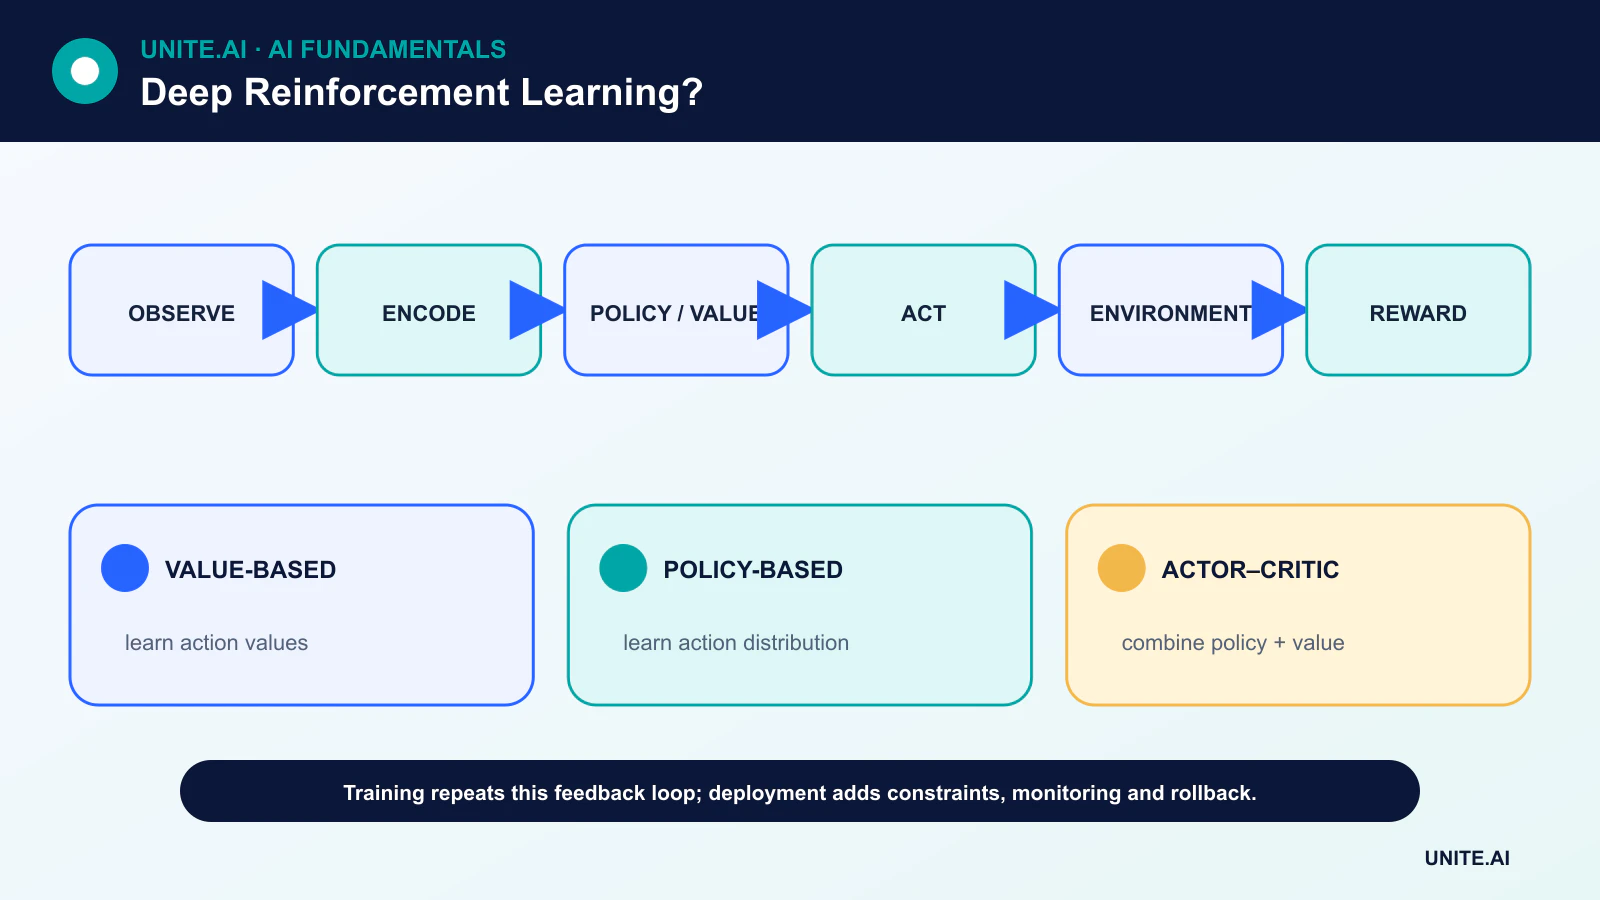
التعلم العميق المعزز (deep RL) يجمع بين التعلم المعزز والشبكات العصبية العميقة. يراقب الوكيل حالةً، يختار إجراءً، يتلقى مكافأة وملاحظة جديدة، ثم يضبط سياسةً أو دالة قيمة لتحسين القرارات المستقبلية.
الشبكة العميقة لا تُزيل الصعوبات الأساسية في التعلم المعزز. إنها توفر وسيلة مرنة لتمثيل الصور، وتدفقات المستشعرات، والمساحات الكبيرة للإجراءات أو دوال القيمة المعقدة. لا يزال الاستكشاف، وتأخير الائتمان، وعدم استقرار التدريب، وتقييم السلامة في العالم الحقيقي من المشكلات الهندسية المركزية.
النقاط الرئيسية
- يتعلم التعلم العميق المعزز اتخاذ القرارات المتسلسلة من خلال التفاعل بدلاً من جدول ثابت من الأمثلة الموسومة.
- تُقدّر طرق القيم مدى جودة الإجراءات؛ وتُعلم طرق السياسات توزيع الإجراءات مباشرة؛ وتجمع طرق الفاعل‑الناقد بينهما.
- يمكن أن تُحسّن مخازن الإعادة، والشبكات الهدف، وتصميم المكافأة الدقيق التدريب، لكن لا شيء يضمن سلوكًا موثوقًا.
- إن الحصول على نتيجة قوية في المحاكي لا يُثبت الصلابة أو السلامة أو نجاح النقل إلى العالم المادي.
مشكلة اتخاذ القرار: الحالات، الإجراءات والمكافآت
تُنمذج العديد من مهام التعلم العميق المعزز كعملية قرار ماركوف. في الوقت t، يتلقى الوكيل حالةً أو ملاحظةً st، يختار إجراءً at، ثم يحصل على مكافأة rt+1 والحالة التالية. الهدف هو العائد المخصوم المتوقع، وليس المكافأة التالية فقط.
عامل الخصم يتحكم في مدى أهمية المكافآت البعيدة. تُعرّف دالة المكافأة ما سيتسعى إليه عملية التحسين، لذا قد ينتج عن نموذج غير مكتمل سلوكًا ينجح تقنيًا لكنه غير مرغوب فيه عمليًا. لهذا السبب يستحق تصميم المكافأة واختبار القيود نفس الاهتمام الذي يُعطى لهندسة النموذج.
طرق القيم، طرق السياسات، وطرق الفاعل‑الناقد
تُقدّر الخوارزمية القائمة على القيم قيمة حالة أو قيمة إجراء. تستخدم شبكات Q العميقة شبكة عصبية لتقريب قيم Q وعادةً ما تختار الإجراء ذي أعلى تقدير مع الحفاظ على بعض الاستكشاف. أما خوارزمية تدرج السياسة فبدلاً من ذلك تُحسّن سياسةً مُعلمة تُخرج توزيعًا للإجراءات.
تحافظ أنظمة الفاعل‑الناقد على كل من الفاعل، الذي يقترح الإجراءات، والناقد، الذي يقدّر قيمتها. يدعم هذا التصميم التحكم المستمر لكنه يُدخل مصادر تفاعل للخطأ في التقدير. لذلك يعتمد التعلم العميق المعزز على نفس الأسس التي يعتمد عليها التعلم العميق، انحدار التدرج والانتشار العكسي.
لماذا تساعد مخازن الإعادة والشبكات الهدف
عينات الخبرة المتتابعة مترابطة، بينما يُغيّر تحديث الشبكة الأهداف المستخدمة في التحديثات اللاحقة. يكسر إعادة تجربة الخبرة بعض هذا الترابط الزمني عبر أخذ عينات من الانتقالات القديمة. تتغير الشبكة الهدف ببطء أكبر من الشبكة المتصلة مباشرة، مما يجعل الأهداف المدعومة أقل تقلبًا.
تحسّن هذه الآليات استقرار التدريب، لكن ضبط المعاملات لا يزال مهمًا. يمكن لمعدل التعلم، جدول الاستكشاف، مقياس المكافأة، تركيبة الإعادة وسعة الشبكة أن تُغيّر النتيجة. يجب الإبلاغ عن عدة بذور عشوائية لأن تشغيلًا واحدًا قد يكون مضللًا.
التعلم المعزز غير المتصل، التعلم المعزز القائم على النموذج، والمحاكاة إلى الواقع
يتعلم التعلم المعزز غير المتصل من مجموعة بيانات مسجلة ثابتة دون جمع تفاعلات جديدة. يمكن أن يكون مفيدًا عندما يكون الاستكشاف مكلفًا أو غير آمن، لكن يجب على السياسة تجنب الإجراءات التي تمثل تمثيلًا ضعيفًا في السجل. يتعلم التعلم المعزز القائم على النموذج أو يستخدم نموذج انتقال للتخطيط، متبادلًا افتراضات إضافية من أجل كفاءة العينة.
غالبًا ما تُدرب الروبوتات في محاكاة، وتُعَدل معلماتها الفيزيائية عشوائيًا، ثم تُضبط أو تُتحقق على الأجهزة الفعلية. لا يزال الفجوة بين الواقع والمحاكاة تكشف عن أخطاء في الإدراك، التوقيت، ديناميكيات التلامس، وحالات الحافة غير النمذجة. يجب تقييم نظام التعلم المعزز تحت اضطرابات، تحول التوزيع، وقيود السلامة الصريحة.
التقييم والنشر
يفصل التقييم المفيد بين بيئات التدريب والاختبار، ويُبلغ عن توزيعات العائد بدلاً من إظهار أفضل نتيجة فقط، ويتحقق من انتهاكات القيود، وتكرار التدخل، والسلوك في أسوأ الحالات. بالنسبة للأنظمة الحقيقية، تحتاج الفرق أيضًا إلى مراقبة، إجراءات إرجاع، فضاءات إجراءات محدودة، وتجاوز بشري.
يكون التعلم العميق المعزز أكثر إقناعًا عندما تكون القرارات متسلسلة، وتتوفر تغذية راجعة، وتكون قواعد التحكم المكتوبة يدويًا غير كافية. يكون خيارًا ضعيفًا عندما تكون العلامات المشرفة وفيرة، أو يُحلّ المشكلة بموّزع تقليدي، أو قد يضع الاستكشاف الأشخاص أو الأصول في خطر.
هياكل التعلم العميق المعزز وإشارات التدريب
يستخدم التعلم العميق المعزز الشبكات العصبية لتمثيل دالة قيمة، أو سياسة، أو نموذج بيئة، أو مزيج منها. تتنبأ شبكة Q العميقة بقيم الإجراءات وتتعلم من أهداف الفارق الزمني؛ يقلل إعادة تجربة الخبرة الترابط بين التحديثات، بينما تُثبّط شبكة الهدف الهدف المتحرك. تُحسّن طرق تدرج السياسة العائد المتوقع مباشرة، وتستخدم طرق الفاعل‑الناقد ناقدًا مُتعلمًا لتقليل تباين التدرج. غالبًا ما تتطلب الإجراءات المستمرة متغيرات فاعل‑ناقد حتمية أو عشوائية، بينما تحتاج الإجراءات المتقطعة ذات الأبعاد العالية إلى استكشاف وتصميم إخراج مدروسين.
التدريب غير ثابت لأن السياسة تُغيّر البيانات التي تجمعها. تصبح بيانات الإعادة خارج السياسة، وتعتمد الأهداف المدعومة على التقديرات الحالية، ويمكن لتقريب الدالة أن يُضاعف الأخطاء—ما يُعرف أحيانًا بـ “الثلاثية المميتة”. تُقلل المُقدّرات المزدوجة من المبالغة في القيمة؛ تُحسّن وظائف الأفضلية تخصيص الائتمان؛ تُشجّع مكافآت الانتروبيا على الاستكشاف؛ وتُقيد الأهداف المقصّرة التحديثات المدمرة للسياسة. يُنصح بتطبيع الملاحظات والمكافآت فقط مع حالة خالية من التسرب، وتسجيل البيئة، والملف المغلف، وتكرار الإجراء، والانتهاء، ومعالجة المكافأة لأن كلًا منها يغيّر المشكلة.
التقييم، والمحاكيات، وسلامة النشر
أبلغ عن توزيعات العائد عبر بذور مستقلة وحالات بيئية، وليس عن أفضل تشغيل. قيّم كفاءة العينة، انتهاكات القيود، النتائج الكارثية، الحساسية لمقياس المكافأة، والصلابة أمام ضوضاء الملاحظة، التأخير، أخطاء المشغل، وتغيّر الديناميكيات. قارن مع التحكم المبرمج، التحكم الكلاسيكي، التقليد الخاضع للإشراف، وRL أبسط. احجز تنوعات البيئة واختبر مقاييس النتائج الخالية من المكافأة، لأن الوكيل قد يستغل المكافأة المبرمجة مع فشل المهمة المقصودة. غالبًا ما يكشف فحص الفيديو والمسار عن سلوك مخفي خلف العائد المجمع.
تمكّن المحاكاة من الاستكشاف لكنها تُدخل فجوة واقع. عَدل الفيزياء والإدراك ذات الصلة عشوائيًا، ووازن ضد قياسات حقيقية، واستخدم نقلًا محافظًا. تتجنب بيانات السجل أو التعلم المعزز غير المتصل الاستكشاف عبر الإنترنت لكنه لا يستطيع تقييم الإجراءات غير المدعومة من قبل سياسة السلوك بثقة. يجب على الأنظمة الإنتاجية تقييد مجموعة الإجراءات، ومعدلها، ومواردها، ونطاق تشغيلها؛ طلب موافقة على الإجراءات ذات الأثر العالي؛ وتضمين متحكم آمن مُتحقق أو إيقاف. راقب مدخلات السياسة، وتوزيع الإجراءات، والمكافأة، والنتائج الفعلية، والتدخلات، مع إرجاع إلى نسخة سياسة مختبرة.
مثال تحكم ملموس
في توجيه روبوت المستودعات، عرّف الحالة من الموقع، الحمولة، مستوى البطارية، حركة المرور القريبة، وطابور المهام؛ والإجراءات من الحركات المسموح بها وقرارات الشحن؛ والمكافأة من العمل المكتمل، الطاقة، الازدحام، وقيود السلامة. درّب أولاً في محاكي مُعَدّ بدقة مع طلب عشوائي وأعطال المستشعر، ثم طِبق على قرارات حقيقية. لا تسمح أبدًا للسياسة المتعلمة بتجاوز تجنب الاصطدام. قيّم الإنتاجية مع الحوادث القريبة، والاختناقات، وحالات طوارئ البطارية، وأسوأ تأخير. ينجح المشروع فقط إذا حسّن النظام الطبقي العمليات دون نقل خطر استكشاف غير مقبول إلى الأشخاص أو المعدات.
مثال عملي: التعلم العميق المعزز لتبريد مراكز البيانات
تقيد مركز البيانات وكيل RL بنقاط ضبط تبريد معتمدة وتدربه في محاكي مُعَدّ من بيانات الطقس التاريخية، وحمل العمل، والحرارات، واستجابة المعدات. تشمل المكافأة الطاقة لكن تُحافظ القيود الصارمة منفصلة على درجة الحرارة، الرطوبة، ودورات تشغيل المعدات. يُعد التحكم التنبؤي النموذجي والقواعد القائمة خطوط أساس. يغطي التقييم الفصول، ضوضاء المستشعر، تأخير المشغل، فقدان المعدات، الأحمال غير العادية، وعدة بذور، مع الإبلاغ عن الطاقة، الانتهاكات، التباين، والاستعادة.
تشغل السياسة المتعلمة في وضع الظل قبل تجربة منطقة محدودة. يقتطع متحكم أمان خارجي الإجراءات ويمكن للمشغلين تجاوزها. تُراقب معدل الإجراءات، تغطية الحالة، عدم يقين النموذج، ونتائج المرفق الفعلية؛ يُؤدي عدم توافق المحاكي أو التدخل المتكرر إلى إرجاع. تُنشئ تحديثات المعدات أو منطق التحكم نسخة بيئة جديدة وتُجرى عملية تحقق. تُقبل وفورات الطاقة فقط عندما تظل الموثوقية، والهامش الحراري، والصيانة، والاستجابة للأعطال على الأقل بنفس قوة الخط الأساسي.
دليل التنفيذ والاستعداد التشغيلي
يتطلب قرار الإنتاج أكثر من عرض توضيحي ناجح. عرّف المستخدمين المستهدفين، بيئة التشغيل، المدخلات، المخرجات، الاعتمادات، المالك، وعواقب كل فشل مهم. أنشئ خط أساس قابل لإعادة الإنتاج ومجموعة تقييم مُصدّرة قبل الضبط. اختبر الحالات العادية، والحدود، والمدخلات المشوهة أو المفقودة، وتحول التوزيع، وانقطاع الاعتماد، وسوء الاستخدام، والمجموعات أو البيئات الأكثر احتمالًا لتكون غير مخدومة. قِس جودة المهمة مع المعايرة أو عدم اليقين، والكمون، والإنتاجية، وتكلفة الموارد، وإمكانية الوصول، والخصوصية، والأمان. سجِّل كل تحويل وعتبة حتى يتمكن مراجع مستقل من إعادة إنتاج النتيجة وتمييز الدليل عن النموذج الأولي الجذاب.
قبل الإطلاق، عيّن سلطة للإصدار، والاستثناءات، والتغييرات، والإرجاع، والتقاعد. استخدم نشرًا متدرجًا، واحفظ نسخة احتياطية آمنة، وتحقق من المراقبة عبر فشل مُحقَّن عمدًا. يجب أن تكشف القياسات التشغيلية عن جودة المدخلات، سلوك المخرجات، نسخة النموذج أو القاعدة، صحة الاعتماد، تجاوزات البشر، والنتائج المؤكدة دون جمع بيانات حساسة غير ضرورية. عيّن عتبات إنذار ومسؤول استجابة، ثم راجع الأدلة الواقعية بعد النشر بدلاً من افتراض استمرار الأداء غير المتصل. أعد التقييم كلما تغيرت مصادر البيانات، أو المستخدمون، أو النماذج، أو البائعون، أو السياسات، أو الأجهزة، أو الأهداف. يحتاج النظام المُصان أيضًا إلى إجراءات موثقة للتعافي، وتعلم الحوادث، والحذف والاحتفاظ، ونقطة واضحة لتعطيله أو استبداله.
الأسئلة المتكررة
هل التعلم العميق المعزز هو نفسه التعلم العميق؟
لا. يوفر التعلم العميق المقاربات الدالية؛ بينما يوفر التعلم المعزز التفاعل، المكافأة، وهدف اتخاذ القرار المتسلسل.
هل تعني المكافأة العالية أن الوكيل تعلم السلوك المقصود؟
ليس بالضرورة. يعني أن السياسة وجدت سلوكًا يحصل على نقاط عالية وفقًا للمكافأة والبيئة المُنفذة. لا يزال الاختبار المستقل للسلامة وتوافق الأهداف مطلوبًا.
المراجع الأساسية