
زاوية Anderson
ثلاثة تحديات أمام Stable Diffusion

 أضف Unite.AI إلى مصادرك المفضلة على Google
النقاط الرئيسيةيواجه Stable Diffusion صعوبة في تصوير أطراف البشر بسبب عدم كفاية التفاصيل الدقيقة في…
عرض المزيد
- يواجه Stable Diffusion صعوبة في تصوير أطراف البشر بسبب عدم كفاية التفاصيل الدقيقة في بيانات التدريب المشروحة.
- تتضمن طرق التكبير القائمة على التجانب خطر إنتاج صور غير مترابطة بسبب افتقادها الوعي السياقي الأوسع.
- يحدد الدقة الأصلية للنموذج البالغة 512x512 من جودة المخرجات ويتطلب حلولًا معقدة للتحايل على هذه المشكلة.
قد يكون إطلاق نموذج تركيب الصور Stable Diffusion من stability.ai، القائم على الانتشار الكامن قبل بضعة أسابيع، من أهم حالات الكشف التقني منذ DeCSS في عام 1999؛ وهو بالتأكيد أكبر حدث في الصور المولدة بالذكاء الاصطناعي منذ عام 2017، حين نُسخ كود deepfakes إلى GitHub وتفرّع إلى ما أصبح لاحقًا DeepFaceLab و FaceSwap، وكذلك برنامج التزييف العميق للبث في الزمن الحقيقي DeepFaceLive.
فجأة تبدد إحباط المستخدمين من قيود المحتوى في واجهة تركيب الصور البرمجية لـ DALL-E 2، بعدما اتضح أن مرشح NSFW في Stable Diffusion يمكن تعطيله بتغيير سطر واحد من الكود. ظهرت مجتمعات Reddit تركز على المحتوى الإباحي المُنشأ باستخدام Stable Diffusion بصورة شبه فورية، وأُغلقت بالسرعة نفسها. وانقسم المطورون والمستخدمون على Discord إلى مجتمعات رسمية وأخرى لمحتوى NSFW، وبدأ Twitter يمتلئ بإبداعات خيالية من Stable Diffusion.
حاليًا يبدو أن كل يوم يأتي بابتكار مذهل من المطورين الذين تبنوا النظام، إذ تُكتب بسرعة إضافات وأدوات تكميلية من أطراف خارجية لتطبيقات Krita, Photoshop, Cinema4D, Blenderوغيرها من منصات التطبيقات.
وفي الأثناء، فإن فن صياغة الأوامر النصية ، أي فن «الهمس للذكاء الاصطناعي» الذي أصبح مهنيًا الآن، وقد ينتهي به الأمر بوصفه أقصر خيار وظيفي عمرًا منذ «منظّم Filofax»، بدأ بالفعل يتحول إلى نشاط تجاري. ويجري تحقيق الدخل المبكر من Stable Diffusion على مستوى Patreon، مع تأكد ظهور عروض أكثر تطورًا لاحقًا لمن لا يريدون التعامل مع عمليات التثبيت المعتمدة على Conda للكود المصدري، أو مرشحات NSFW المقيدة في التطبيقات القائمة على الويب.
يتقدم التطوير وإحساس المستخدمين بحرية الاستكشاف بسرعة مذهلة تجعل استشراف المستقبل البعيد صعبًا. فنحن أساسًا لا نعرف بعد على وجه الدقة ما الذي نتعامل معه، أو ما جميع حدوده وإمكاناته.
ومع ذلك، لنلق نظرة على ثلاثة من أكثر العوائق إثارة للاهتمام وصعوبة التي قد يواجهها مجتمع Stable Diffusion، سريع التشكّل والنمو، والتي نأمل أن يتجاوزها.
1: تحسين مسارات المعالجة القائمة على مقاطع الصور
مع محدودية موارد الأجهزة والقيود الصارمة على دقة صور التدريب، يُرجح أن يجد المطورون طرقًا التفافية لتحسين جودة مخرجات Stable Diffusion ودقتها معًا. وستستغل مشاريع كثيرة حدود النظام، ومنها دقته الأصلية البالغة 512×512 بكسل فقط.
وكما هو مألوف في مشروعات الرؤية الحاسوبية وتركيب الصور، تدرب Stable Diffusion على صور مربعة، أُعيد أخذ عيناتها هنا إلى 512×512، لتوحيد الصور المصدرية وإدخالها ضمن قيود وحدات GPU المستخدمة في تدريب النموذج.
لذلك «يفكر» Stable Diffusion، إن كان يفكر أصلًا، بمقاس 512×512، وبإطار مربع بالتأكيد. ويذكر مستخدمون كثيرون يختبرون حدود النظام أنه يعطي أكثر النتائج موثوقية وأقلها عيوبًا عند نسبة الأبعاد المحدودة هذه (انظر مشكلات الأطراف أدناه).
ورغم أن تطبيقات مختلفة توفر زيادة الدقة عبر RealESRGAN (وتستطيع إصلاح الوجوه سيئة التوليد عبر GFPGAN) ، يطوّر مستخدمون عدة طرقًا لتقسيم الصور إلى مقاطع 512×512 بكسل ثم وصلها لتكوين أعمال مركبة أكبر.

أُنتج هذا التصيير بمقاس 1024×576، وهو دقة مستحيلة عادة في عملية توليد واحدة من Stable Diffusion، بنسخ ملف Python المسمى attention.py من فرع DoggettX لـ Stable Diffusion، وهو إصدار ينفذ التكبير القائم على مقاطع الصور، إلى فرع آخر. المصدر: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
رغم أن بعض المبادرات تستخدم كودًا أصليًا أو مكتبات أخرى، فإن نسخة txt2imghd المنقولة من GOBIG ستوفر هذه الوظيفة للفرع الرئيسي قريبًا. وGOBIG وضع في ProgRockDiffusion الذي يستهلك كثيرًا من VRAM. وبينما txt2imghd نسخة منقولة مخصصة لـ GOBIG، يعمل مطورو المجتمع الآخرون على تطبيقات مختلفة له.

صورة تجريدية ملائمة لهذا المثال في التصيير الأصلي بمقاس 512×512 بكسل (يسارًا والثانية من اليسار)، ثم رُفعت دقتها باستخدام ESGRAN، الذي أصبح شبه مدمج في جميع توزيعات Stable Diffusion، وأُعطيت «انتباهًا خاصًا» بواسطة تطبيق GOBIG. فتنتج تفاصيل تبدو أفضل تكبيرًا، على الأقل داخل حدود مقطع الصورة. المصدر: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
يضم المثال التجريدي أعلاه «ممالك صغيرة» كثيرة من التفاصيل تناسب نهج التكبير المنغلق على كل جزء. لكن إنتاج تكبير متماسك وغير متكرر، لا يبدو كأنه جُمّع من أجزاء كثيرة، قد يحتاج حلولًا برمجية أصعب. وهذا مهم خصوصًا للوجوه البشرية التي نلاحظ فيها التشوهات والآثار المصطنعة المزعجة بحساسية شديدة. لذلك قد تحتاج الوجوه في النهاية إلى حل مخصص.
لا يملك Stable Diffusion حاليًا آلية لتركيز الانتباه على الوجه أثناء التصيير، كما يعطي البشر الأولوية للمعلومات الوجهية. ورغم أن بعض المطورين في مجتمعات Discord يدرسون تنفيذ هذا «الانتباه المعزز»، فالأسهل بكثير الآن تحسين الوجه يدويًا، وربما آليًا مستقبلًا، بعد التوليد الأولي.
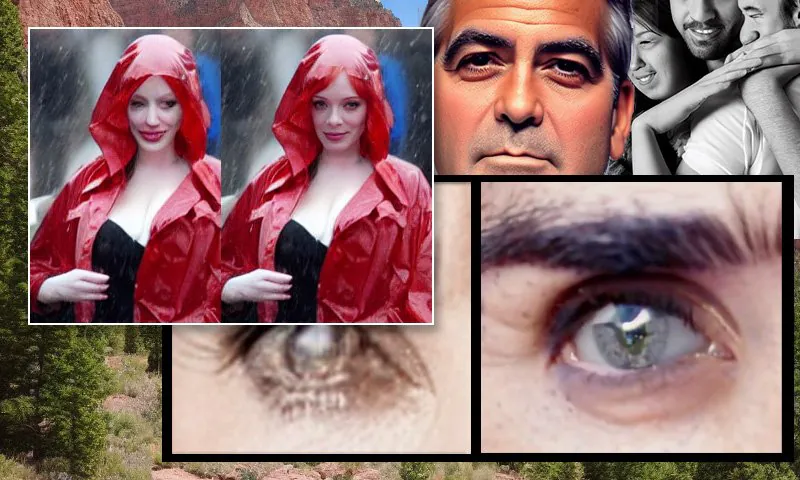
للوجه البشري منطق دلالي داخلي مكتمل لا يوجد في «مقطع» من زاوية مبنى سفلية مثلًا. ولهذا يمكن حاليًا تقريب وجه تخطيطي في مخرجات Stable Diffusion وإعادة توليده بفاعلية كبيرة.

يسارًا: محاولة Stable Diffusion الأولى بالأمر النصي ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. يمينًا: وجه محسّن بإعادة الوجه الضبابي والتخطيطي من النتيجة الأولى عبر Img2Img ليحصل على كامل انتباه Stable Diffusion (انظر الصور المتحركة أدناه).
في غياب حل Textual Inversion مخصص (انظر أدناه)، لن ينجح ذلك إلا مع صور المشاهير الممثلين جيدًا أصلًا في مجموعات LAION الفرعية التي دربت Stable Diffusion. لذلك ينجح مع Tom Cruise وBrad Pitt وJennifer Lawrence وعدد محدود من نجوم الإعلام الحقيقيين الموجودين في صور كثيرة ضمن البيانات المصدرية.
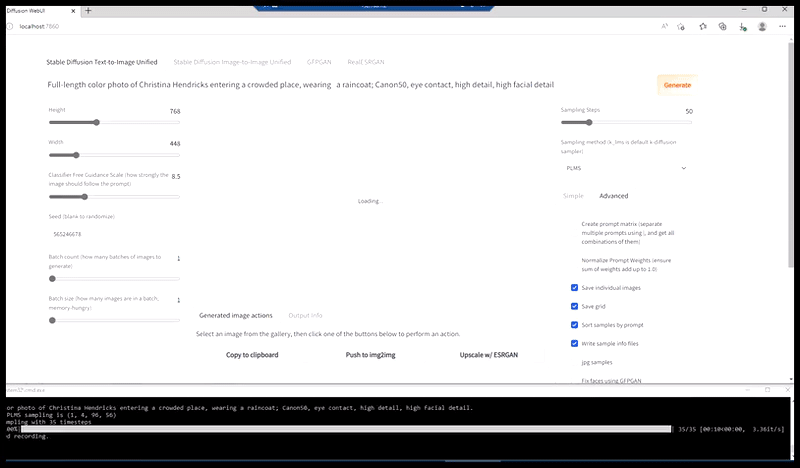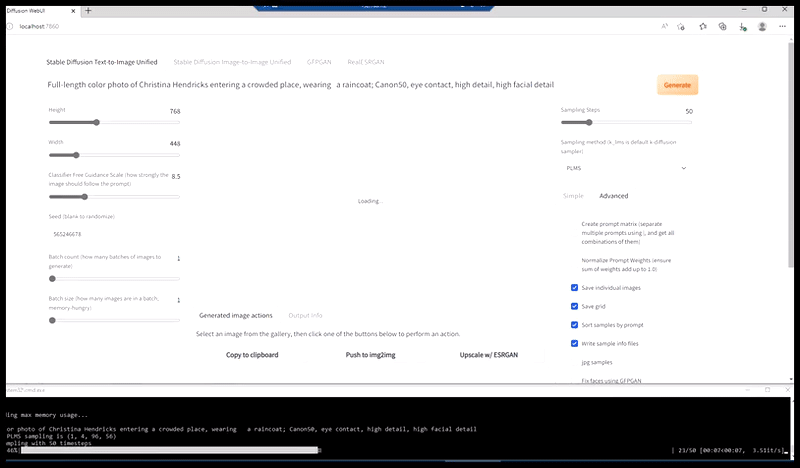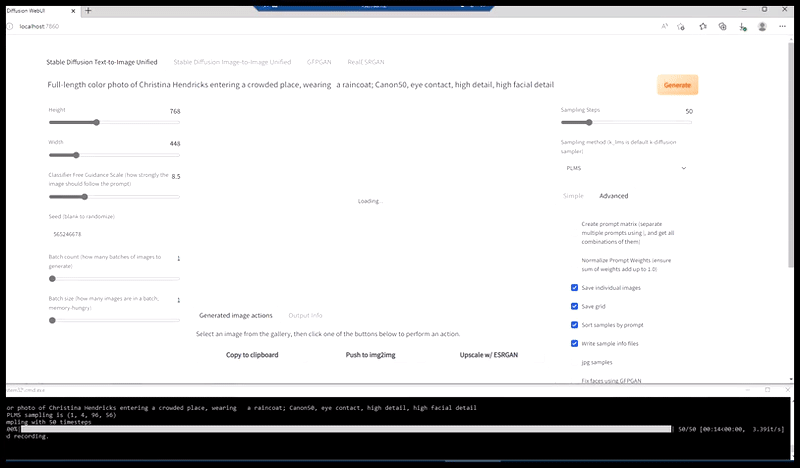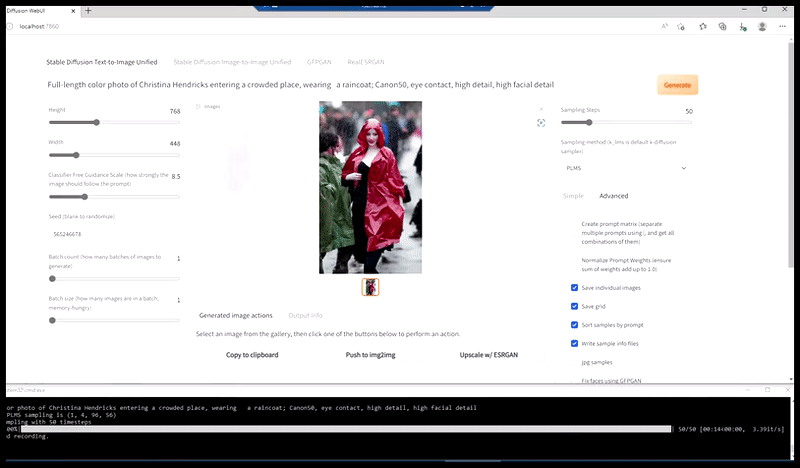
توليد صورة صحفية معقولة بالأمر النصي ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
بالنسبة للمشاهير أصحاب المسيرات الطويلة والمستمرة، يولد Stable Diffusion عادة صورة بعمر حديث، أي أكبر سنًا. ولإنتاج صور أصغر عمرًا يلزم إضافة عبارات للأمر النصي مثل ‘young’ أو ‘in the year [YEAR]’ .

بمسيرة بارزة وكثيرة التصوير ومستمرة لنحو 40 عامًا، تعد الممثلة Jennifer Connelly واحدة من مشاهير قلائل في LAION يتيحون لـ Stable Diffusion تمثيل نطاق من الأعمار. المصدر: حزمة Stable Diffusion معدة مسبقًا ومحلية، نقطة تحقق v1.4، وأوامر مرتبطة بالعمر.
يرجع ذلك أساسًا إلى انتشار التصوير الصحفي الرقمي، بدلًا من التصوير المكلف المعتمد على المستحلب، منذ منتصف العقد الأول من الألفية، ثم زيادة كمية الصور مع ارتفاع سرعات الاتصال عريض النطاق.
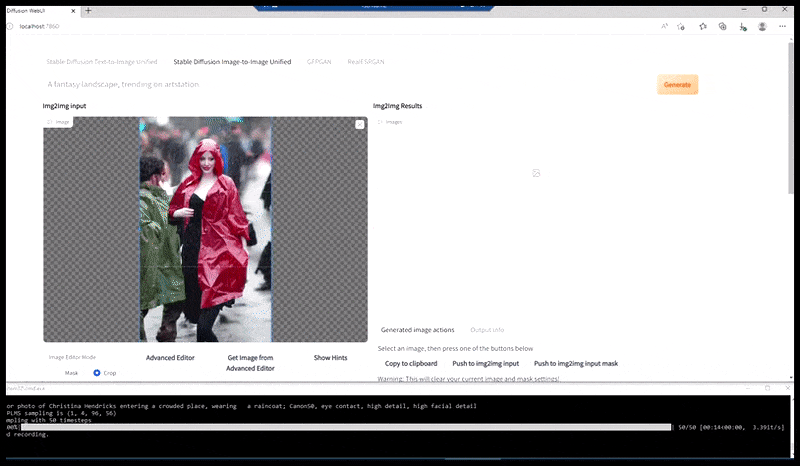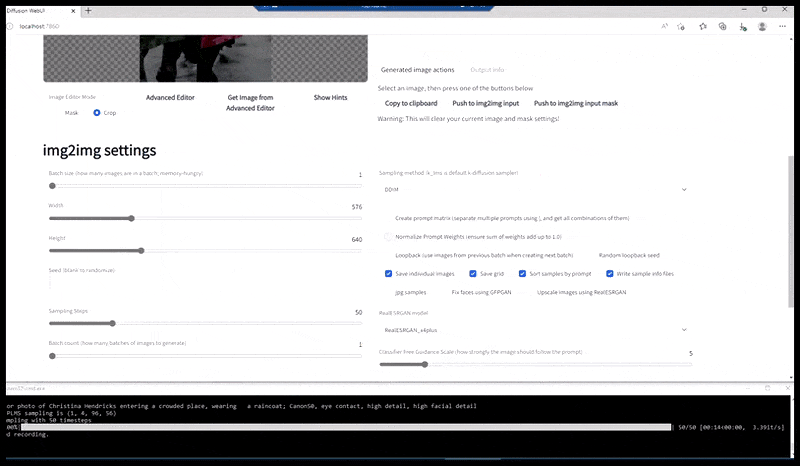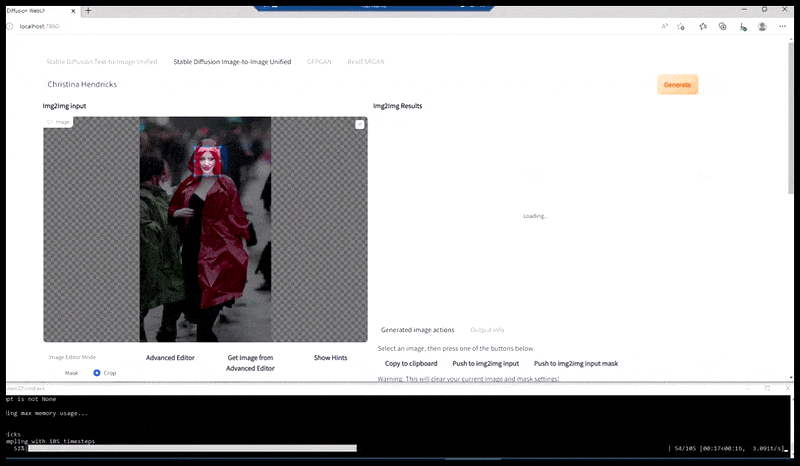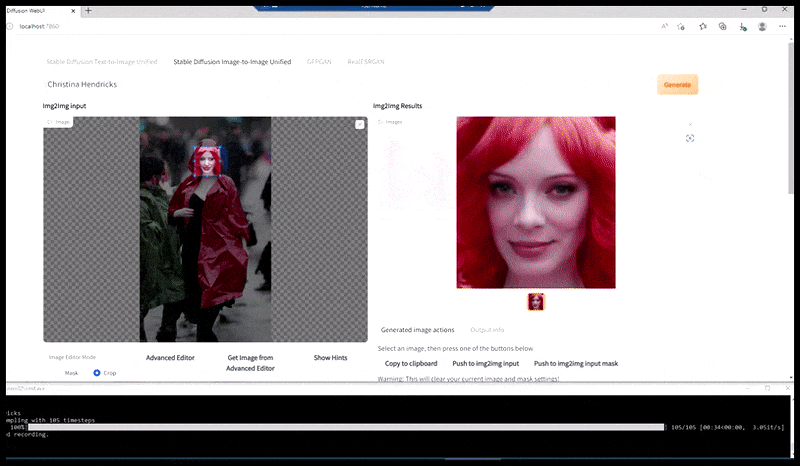
تُمرر الصورة الناتجة إلى Img2Img في Stable Diffusion، وتُختار «منطقة تركيز» ثم يُجرى تصيير جديد بأقصى حجم لهذه المنطقة وحدها. وهذا يتيح تركيز جميع الموارد المتاحة على إعادة إنشاء الوجه.
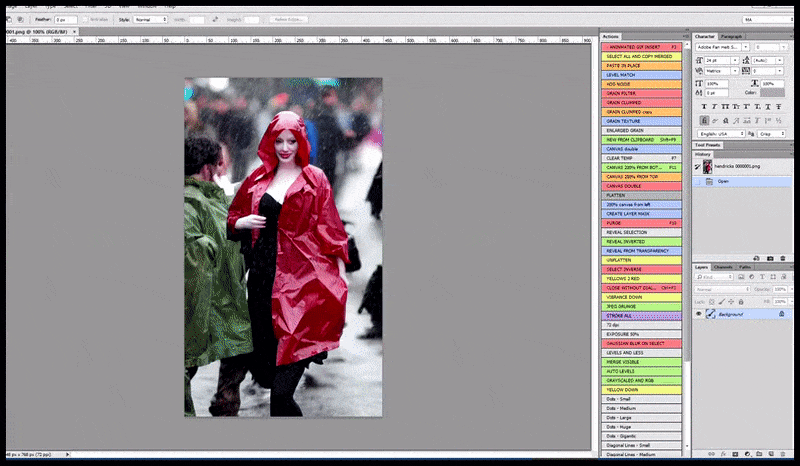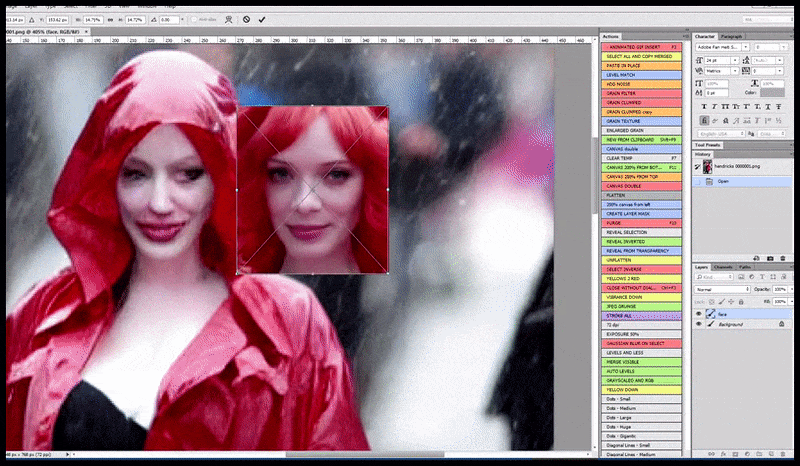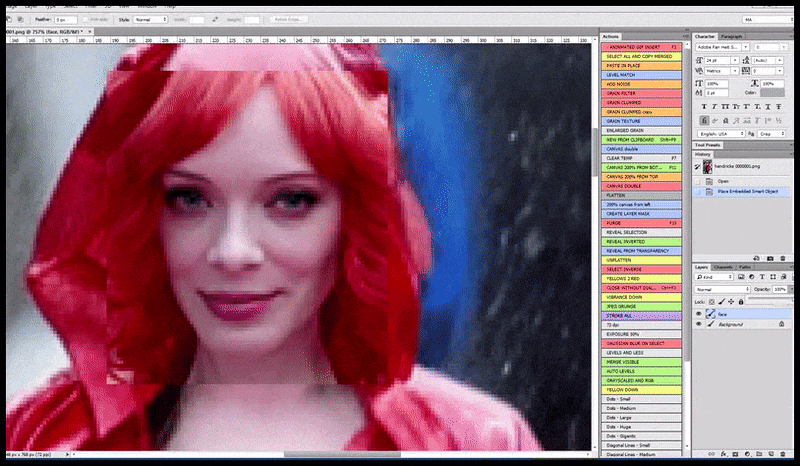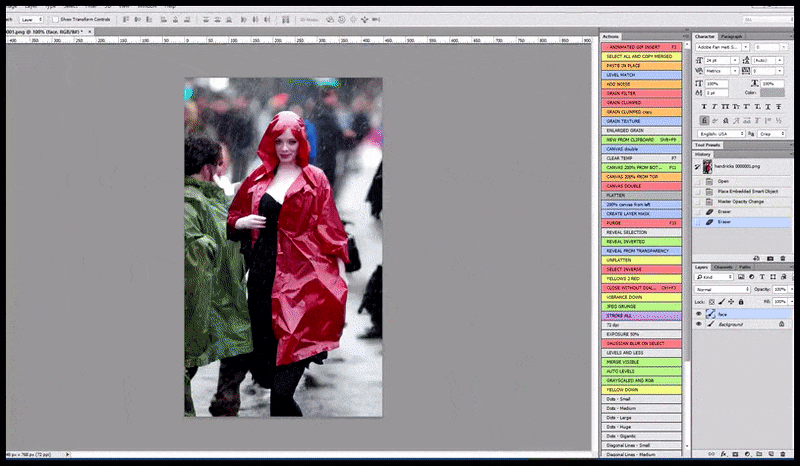
دمج الوجه ذي «الانتباه المرتفع» في الصورة الأصلية. وبخلاف الوجوه، لا ينجح هذا إلا مع كيانات يمكن أن يكون لها مظهر معروف ومتماسك ومكتمل، مثل جزء من الصورة الأصلية يحوي جسمًا واضحًا كساعة أو سيارة. وتكبير جزء من جدار مثلًا سينتج جدارًا معاد التجميع غريبًا جدًا، لأن المقاطع عند توليدها لم تملك السياق الأوسع «لقطعة الأحجية» هذه.
يأتي بعض المشاهير في قاعدة البيانات «مجمّدين» في زمن معين، إما لوفاتهم المبكرة مثل Marilyn Monroe، أو لبلوغهم شهرة واسعة عابرة أنتجت صورًا كثيرة في فترة محدودة. ويمكن اعتبار سؤال Stable Diffusion نوعًا من مؤشر الشعبية «الحالي» للنجوم المعاصرين والقدامى. فبعض المشاهير القدامى والحاليين لا يملكون صورًا مصدرية كافية للحصول على شبه جيد جدًا، بينما تضمن الشعبية المستمرة لنجوم ماتوا منذ زمن طويل أو اختفوا عن الأضواء الحصول على شبه معقول من النظام.

تكشف نتائج Stable Diffusion سريعًا الوجوه الشهيرة الممثلة جيدًا في بيانات التدريب. ورغم الشعبية الهائلة لـ Millie Bobby Brown في أواخر مراهقتها وقت الكتابة، كانت أصغر وأقل شهرة حين جُمعت بيانات LAION المصدرية من الويب، مما يصعّب حاليًا إنتاج شبه عالي الجودة لها.
عندما تتوافر البيانات، قد تتجاوز حلول رفع الدقة بالمقاطع في Stable Diffusion مجرد التركيز على الوجه. فقد تنتج وجوهًا أدق وأكثر تفصيلًا بتفكيك الملامح وتوجيه كامل قوة GPU المحلية إلى كل ملمح بارز على حدة قبل التجميع. وهذه العملية ما زالت يدوية أيضًا.

لا يقتصر هذا على الوجوه، لكنه يقتصر على أجزاء الأجسام التي يكون موضعها متوقعًا على الأقل بالقدر نفسه ضمن السياق الأوسع للجسم الأصلي، وتتوافق مع تمثيلات تضمينية عالية المستوى يُتوقع منطقيًا وجودها في مجموعة بيانات فائقة الضخامة.
الحد الحقيقي هو كمية البيانات المرجعية المتاحة، لأن التفاصيل المكررة بعمق ستصبح في النهاية «مهلوسة» بالكامل، أي مختلقة، وأقل أصالة.
ينجح هذا التكبير الدقيق في حالة Jennifer Connelly لأنها ممثلة جيدًا عبر أعمار متعددة في LAION-aesthetics ، وهي المجموعة الفرعية الرئيسية من LAION 5B التي يستخدمها Stable Diffusion، وفي LAION عمومًا. وفي حالات أخرى كثيرة ستتراجع الدقة لقلة البيانات، مما يستلزم ضبطًا دقيقًا، أي تدريبًا إضافيًا (انظر «التخصيص» أدناه)، أو Textual Inversion (انظر أدناه).
المقاطع وسيلة قوية ورخيصة نسبيًا لتمكين Stable Diffusion من إنتاج صور عالية الدقة. لكن التكبير الخوارزمي بهذه الطريقة، إن افتقر إلى آلية انتباه أوسع وأعلى مستوى، قد لا يحقق المعايير المأمولة عبر أنواع متعددة من المحتوى.
2: معالجة مشكلات الأطراف البشرية
لا يرقى Stable Diffusion إلى اسمه عند تصوير تعقيد نهايات الجسم البشري. فقد تتكاثر الأيدي عشوائيًا، وتندمج الأصابع، وتظهر ساق ثالثة دون طلب، وتختفي أطراف موجودة دون أثر. وللإنصاف فإنه يشارك النماذج المماثلة هذه المشكلة، وبالتأكيد DALL-E 2.

نتائج غير معدلة من DALL-E 2 وStable Diffusion (1.4) في نهاية أغسطس 2022، وكلاهما يظهر مشكلات الأطراف. الأمر النصي هو ‘A woman embracing a man’.
يرجح أن يصاب بخيبة أمل محبو Stable Diffusion الذين يأملون أن تعالج نقطة التحقق 1.5 القادمة، وهي نسخة دُربت بكثافة أكبر ومعلمات محسّنة، ارتباك الأطراف. وسيُطلق النموذج الجديد بعد نحو أسبوعين، ويُعرض حاليًا بصورة أولية في بوابة stability.ai التجارية DreamStudio، التي تستخدم 1.5 افتراضيًا. ويمكن للمستخدمين مقارنة النتائج الجديدة بتصييرات أنظمتهم المحلية أو غيرها من أنظمة 1.4:

المصدر: حزمة 1.4 محلية معدة مسبقًا وhttps://beta.dreamstudio.ai/

المصدر: حزمة 1.4 محلية معدة مسبقًا وhttps://beta.dreamstudio.ai/

المصدر: حزمة 1.4 محلية معدة مسبقًا وhttps://beta.dreamstudio.ai/
كالمعتاد، قد تكون جودة البيانات هي العامل الرئيسي المساهم.
تستطيع قواعد البيانات المفتوحة التي تغذي أنظمة تركيب الصور مثل Stable Diffusion وDALL-E 2 توفير تسميات كثيرة للأفراد وللتفاعلات بين البشر. وتُدرّب هذه التسميات مع الصور المرتبطة بها أو أجزاء الصور على نحو متكامل.

يمكن لمستخدمي Stable Diffusion استكشاف مفاهيم النموذج بالبحث في LAION-aesthetics، وهي مجموعة فرعية من LAION 5B الأكبر الذي يغذي النظام. ولا تُرتب الصور أبجديًا بحسب تسمياتها، بل بحسب «درجة الجمال». المصدر: https://rom1504.github.io/clip-retrieval/
يمكن أن تكون الهرمية الجيدة للتسميات الفردية والفئات التي تسهم في تصوير ذراع بشرية على النحو الآتي: body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

تقسيم دلالي دقيق لأجزاء اليد. وحتى هذا التفكيك المفصل على نحو غير معتاد يترك كل «إصبع» كيانًا واحدًا، ولا يحسب الأقسام الثلاثة للإصبع والقسمين للإبهام. المصدر: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
في الواقع، من غير المرجح أن تكون الصور المصدرية مشروحة بهذا الاتساق عبر مجموعة البيانات كلها. وستتوقف خوارزميات التسمية غير الخاضعة للإشراف غالبًا عند المستوى الأعلى ، مثل «اليد»، وتترك البكسلات الداخلية، التي تتضمن تقنيًا معلومات «الأصابع»، كتلة غير مسماة تُستخلص منها السمات اعتباطيًا، وقد تظهر في النتائج اللاحقة كعنصر مزعج.

ما ينبغي أن يكون (أعلى اليمين، إن لم تكن لكمة صاعدة)، وما يحدث عادة (أسفل اليمين)، بسبب موارد التسمية المحدودة أو طريقة استغلال البنية لهذه التسميات إن وجدت في البيانات.
لذلك، إذا بلغ نموذج الانتشار الكامن توليد ذراع، فسيحاول شبه مؤكد توليد يد في نهايتها، لأن arm>hand هو الحد الأدنى الضروري للهرمية، وعلى مستوى مرتفع نسبيًا مما تعرفه البنية عن «التشريح البشري».
بعد ذلك قد تكون «الأصابع» أصغر تجميع، مع أن هناك 14 جزءًا فرعيًا إضافيًا للأصابع والإبهام يجب مراعاتها عند تصوير اليد البشرية.
إن صحت هذه النظرية، فلا يوجد علاج حقيقي، بسبب غياب الميزانية على مستوى القطاع للشرح اليدوي، وغياب خوارزميات فعالة بما يكفي لأتمتة التسمية بمعدلات خطأ منخفضة. وقد يكون النموذج حاليًا معتمدًا على الاتساق التشريحي للبشر لإخفاء عيوب مجموعة تدريبه.
ومن أسباب أنه لا يستطيع الاعتماد على ذلك احتمال جرى مؤخرًا اقتراحه في Discord الخاص بـ Stable Diffusion: قد يلتبس على النموذج العدد الصحيح لأصابع اليد البشرية الواقعية، لأن قاعدة البيانات المستمدة من LAION تحوي شخصيات كرتونية بأصابع أقل (وهو بحد ذاته اختصار لتوفير الجهد).

اثنان من المشتبه بهم المحتملين في متلازمة «الإصبع المفقود» في Stable Diffusion والنماذج المماثلة. أدناه أمثلة لأيدي كرتونية من LAION-aesthetics الذي يغذي النموذج. المصدر: https://www.youtube.com/watch?v=0QZFQ3gbd6I
إن صح ذلك، فالحل الواضح الوحيد هو إعادة تدريب النموذج مع استبعاد المحتوى البشري غير الواقعي، وضمان تصنيف حالات النقص الحقيقية، كالأشخاص مبتوري الأطراف، استثناءاتٍ بصورة ملائمة. وحتى من منظور تنسيق البيانات وحده فهذا تحدٍّ كبير، خصوصًا لمبادرات المجتمع محدودة الموارد.
والنهج الثاني تطبيق مرشحات تمنع ظهور هذا المحتوى وقت التصيير، مثل «يد بثلاثة/خمسة أصابع»، على نحو مشابه لما فعلته OpenAI بدرجة ما عندما رشحت GPT-3 و DALL-E 2، لتنظيم المخرجات دون إعادة تدريب النماذج المصدرية.

قد يصبح التمييز الدلالي بين الأصابع وحتى الأطراف في Stable Diffusion ضبابيًا على نحو مروع، بما يذكر بتيار «رعب الجسد» في أفلام الثمانينيات لمخرجين مثل David Cronenberg. المصدر: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
لكن ذلك يتطلب مجددًا تسميات قد لا توجد على جميع الصور المتأثرة، فنعود إلى التحدي اللوجستي والمالي نفسه.
يمكن القول إن طريقين يبقيان: إضافة المزيد من البيانات لمعالجة المشكلة، وتطبيق أنظمة تفسير من أطراف خارجية تتدخل حين تُعرض الأخطاء الجسدية المذكورة هنا للمستخدم النهائي. وعلى الأقل، يمنح النهج الأخير OpenAI وسيلة لرد المال عن صور «رعب الجسد»، إذا أرادت الشركة ذلك.
3: التخصيص
من أكثر إمكانات مستقبل Stable Diffusion إثارة أن يطور المستخدمون أو المؤسسات أنظمة معدلة تدمج محتوى خارج مجال LAION المدرّب مسبقًا. والمثالي أن يتحقق ذلك دون تكلفة منفلتة لإعادة تدريب النموذج كله، أو المخاطر المترتبة على تدريب صور جديدة كثيرة في نموذج قائم وناضج وقادر.
للتشبيه: إذا انضم طالبان أقل موهبة إلى فصل متقدم من ثلاثين طالبًا، فإما يندمجان ويلحقان بالمستوى أو يفشلان كاستثناءين. وفي الحالتين لن يتأثر متوسط أداء الفصل على الأرجح. لكن انضمام 15 طالبًا أقل موهبة يرجح أن يضر بمنحنى درجات الفصل كله.
وبالمثل، فإن شبكة العلاقات المتكاملة والحساسة نسبيًا، المبنية بتدريب مستمر ومكلف، قد تتضرر، بل قد تُدمر فعليًا في بعض الحالات، بفعل بيانات جديدة مفرطة، مما يخفض جودة النموذج عمومًا.
والمبرر الأساسي لذلك هو الرغبة في الاستيلاء كليًا على فهم النموذج المفاهيمي للعلاقات والأشياء وتخصيصه حصريًا لإنتاج محتوى شبيه بالمادة الإضافية.
لذلك، فإن تدريب 500,000 إطار من Simpsons في نقطة تحقق Stable Diffusion قائمة سيعطي على الأرجح في النهاية محاكيًا أفضل لـ Simpsons من الإصدار الأصلي، شريطة بقاء علاقات دلالية واسعة كافية خلال العملية، مثل Homer Simpson eating a hotdog، وهو ما قد يتطلب مواد عن الهوت دوغ لم تكن ضمن الإضافة لكنها كانت في نقطة التحقق أصلًا. ويُفترض أيضًا ألا تريد التحول فجأة من محتوى Simpsons إلى إنشاء fabulous landscape by Greg Rutkowski ، لأن النموذج بعد التدريب الإضافي قد انصرف انتباهه بدرجة كبيرة، ولن يجيد هذه الأشياء كما كان سابقًا.
ومن الأمثلة اللافتة waifu-diffusion، الذي نجح في التدريب الإضافي باستخدام 56,000 صورة أنمي داخل نقطة تحقق Stable Diffusion مكتملة ومدربة. لكن ذلك صعب للهواة، إذ يتطلب النموذج حدًا أدنى هائلًا من VRAM قدره 30GB، يتجاوز كثيرًا ما يرجح توافره في فئة المستهلك من سلسلة NVIDIA 40XX القادمة.

تدريب محتوى مخصص في Stable Diffusion عبر waifu-diffusion: احتاج النموذج أسبوعين من التدريب الإضافي لإنتاج هذا المستوى من الرسوم. وتظهر الصور الست يسارًا تقدمه أثناء التدريب في إنتاج مخرجات متسقة مع الموضوع اعتمادًا على البيانات الجديدة. المصدر: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
قد تُبذل جهود كبيرة في هذه الفروع من نقاط تحقق Stable Diffusion، ثم يعيقها الدين التقني. وقد أوضح مطورو Discord الرسمي أن الإصدارات اللاحقة ليست بالضرورة متوافقة رجعيًا، حتى مع منطق أوامر كان يعمل في إصدار أسبق، لأن اهتمامهم الأول الحصول على أفضل نموذج ممكن، لا دعم التطبيقات والعمليات القديمة.
لذلك فالشركة أو الفرد الذي يتفرع من نقطة تحقق إلى منتج تجاري لا يملك فعليًا طريقًا للعودة. فنسخته تصبح «تفرعًا صلبًا» ولا يمكنها استيعاب مزايا التطوير الأصلي من إصدارات stability.ai اللاحقة، وهو التزام كبير.
والأمل الحالي الأكبر لتخصيص Stable Diffusion هو Textual Inversion، حيث يدرب المستخدم باستخدام صور قليلة متوافقة مع CLIP.

يسمح Textual Inversion، وهو تعاون بين جامعة تل أبيب وNVIDIA، بتدريب كيانات جديدة ومحددة دون تدمير قدرات النموذج المصدري. المصدر: https://textual-inversion.github.io/
القيد الرئيسي الظاهر لـ Textual Inversion هو التوصية بعدد ضئيل جدًا من الصور، قد يكون خمس صور فقط. وينتج بذلك كيان محدود قد يكون أنسب لنقل الأسلوب من إدراج أجسام فوتوغرافية واقعية.
ومع ذلك، تُجرى حاليًا تجارب في مجتمعات Discord المختلفة لـ Stable Diffusion تستخدم أعدادًا أكبر بكثير من صور التدريب، ويبقى مدى فاعلية الطريقة غير معلوم. ومجددًا، تتطلب التقنية كثيرًا من VRAM والوقت والصبر.
لهذه العوامل المقيدة، قد ننتظر بعض الوقت لنرى تجارب Textual Inversion الأكثر تطورًا من الهواة، ولنعرف هل يمكن لهذا النهج أن «يضعك في الصورة» بصورة أفضل من القص واللصق في Photoshop، مع الحفاظ على وظائف نقاط التحقق الرسمية المذهلة.
نُشر لأول مرة في 6 سبتمبر 2022.


