
نماذج ومنصات الذكاء الاصطناعي
مجموعات البيانات الجاهزة الجديدة من Appen لتسريع نشر الذكاء الاصطناعي

 أضف Unite.AI إلى مصادرك المفضلة على Google
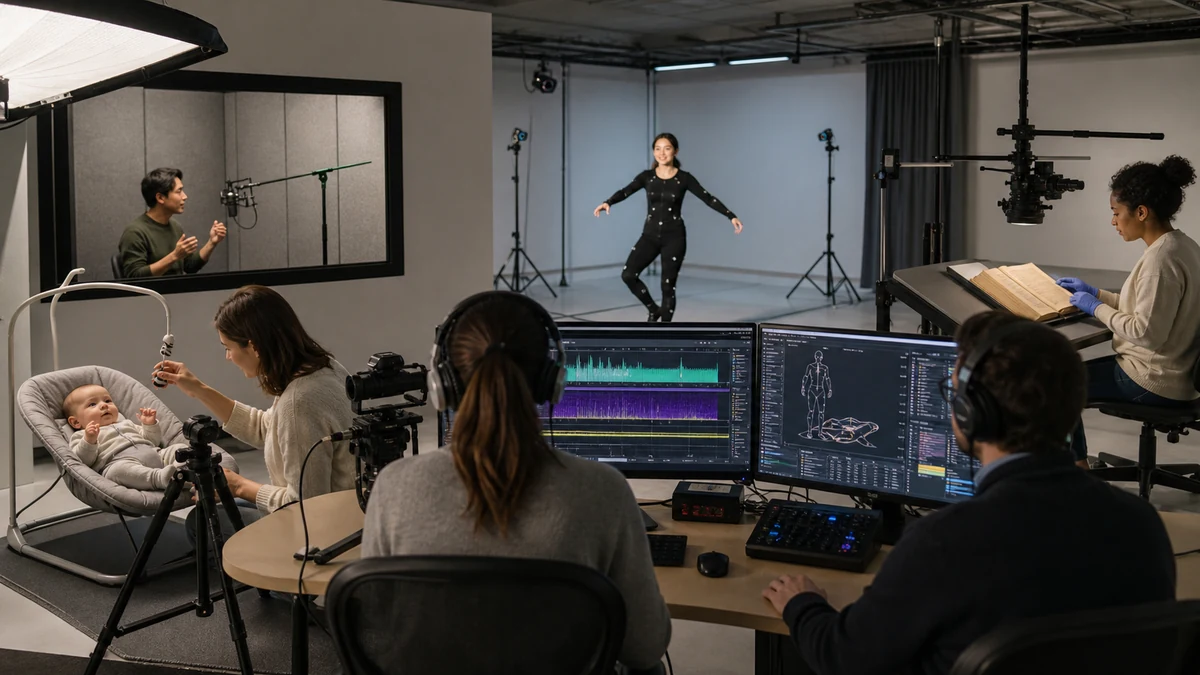
Appen Limited (ASX:APX)، المزود الرائد لمجموعات بيانات التدريب عالية الجودة للمنظمات التي تبني أنظمة ذكاء اصطناعي فعالة على نطاق واسع، أعلنت اليوم عن مجموعات بيانات جديدة جاهزة الاستخدام (OTS). تم تصميم هذه المجموعات لتسهيل عملية الحصول على بيانات التدريب عالية الجودة التي تحتاجها الشركات لتعزيز مشاريع الذكاء الاصطناعي (AI) وتعلم الآلة (ML) الخاصة بهم. تشمل المجموعات الجديدة من OTS حركة الجسم البشري والصوت المبتكر لدموع الأطفال، بالإضافة إلى الكلام المكتوب والصور والنصوص المناسبة للتعرف الضوئي على الحروف (OCR) للغات التي يصعب الحصول عليها، مثل العربية والكرواتية واليونانية والمجرية والتايلاندية وغيرها. مع توسيع المجموعات، تشمل عروض Appen OTS أكثر من 250 مجموعة بيانات، تتكون من أكثر من 11,000 ساعة من الصوت وأكثر من 25,000 صورة وأكثر من 8.7 مليون كلمة عبر 80 لغة ولهجات متعددة.
مجموعات بيانات Appen OTS هي أداة سريعة واقتصادية لبدء مشروع AI أو ML مع بيانات تدريب عالية الجودة ومستمرة. يمكن للفرق التي توسع قدراتها في الذكاء الاصطناعي الاستفادة من مجموعات OTS لتحسين دقة نموذجها وتطوير مهارات جديدة وتضمين تحسينات أخرى في نماذج الذكاء الاصطناعي الخاصة بهم. غالبًا ما يتم تسليم مجموعة OTS في غضون أسبوع، على سبيل المثال، مقارنة بالفترة التي تتراوح من ثمانية إلى اثني عشر أسبوعًا لمشروع جمع بيانات جديد وتنقيحها – أو حتى فترة أطول، حسب التعقيد. يتم تطوير جميع مجموعات بيانات Appen باستخدام منهجية شفافة واختيارية، لذلك يمكن لمختصي الذكاء الاصطناعي التأكد من أن بياناتهم خالية من الشوائب ومطابقة للمواصفات، مما يلغي خطر الردود السلبية وتلف السمعة.
“يمكن لفريق الذكاء الاصطناعي في جميع أنحاء العالم الذي يعمل على مشاريع مع مواعيد نهائية صارمة ومتطلبات بيانات مرنة الاستفادة من استخدام مجموعات البيانات الجاهزة”, قال ويلسون بانج، كبير مسؤولي التكنولوجيا في Appen. “ت缩ص مجموعات OTS الوقت اللازم لتحقيق القيمة وتوفر إمكانية الوصول إلى بيانات عالية الجودة بتكلفة إجمالية أقل من الطرق التقليدية. نحن في Appen نتخذ الإجراءات اللازمة لضمان أن تكون جميع مجموعاتنا مصدرة بطرق أخلاقية وموزعة ديموغرافيًا، مما يسمح للشركات بممارسة مسؤولية الذكاء الاصطناعي عن طريق تقليل الانحياز في نماذجها وضمان معاملة عادلة لمؤلفي البيانات. يمكنك دائمًا معرفة جودة مجموعة OTS بدقة، مما يساعد في بناء الذكاء الاصطناعي الأفضل الذي يعمل في العالم الحقيقي”.
قدمت MediaInterface حلول تكنولوجيا اللغة لمؤسسات الرعاية الصحية في ألمانيا وparts أخرى من أوروبا لمدة 20 عامًا. عندما كان الشركة يتوسع إلى فرنسا، كان لديها برنامج محلي كامل، لكنها افتقرت إلى بيانات قاموس فرنسية، خاصة الأسماء والاماكن الفرنسية، والتي يتم الاستشهاد بها غالبًا في معلومات الصحة المرضية. باستخدام مجموعات بيانات Appen OTS، حصلت MediaInterface على ما يقرب من 21,000 اسم فرنسي و14,000 اسم مكان. “لقد تم دمج البيانات الحاسمة من Appen في قاموسنا الخلفي بنجاح لبدء التشغيل في سوق جديد، وهذا يساعدنا على بناء مفردات جديدة لعملائنا وتعزيز نهجنا لمشاريع إطلاق السوق في المستقبل”، قال إينيس ويندلر، مدير المنتج في MediaInterface.
يجمع الخبراء الأكثر خبرة في الذكاء الاصطناعي مجموعات OTS مع مشاريع جمع بيانات وتنقيحها حسب الطلب لتلبية احتياجاتهم المعقدة لتدريب بيانات نماذج الذكاء الاصطناعي. Appen هي الرائدة في تقديم الدعم المستمر من خلال مجموعة من خدمات جمع البيانات المحددة، مثل التنقيح المستمر والتسمية الذكية، من خلال أدوات قوية مدعومة بالذكاء الاصطناعي وعمليات عمل تلقائية لتعظيم الكفاءة.
“نحن نتفاعل مع الذكاء الاصطناعي من لحظة استيقاظنا حتى لحظة نومنا – من خلال المساعدين الافتراضيين وبرامج الدردشة ومحركات البحث والشبكات الاجتماعية والأجهزة الطبية والسيارات الذكية والتطبيقات الأخرى”، قال جوديث بيشوب، مدير kıdemli في Appen لخبراء الذكاء الاصطناعي، الذي يقود فريقًا من 100 لغوي وخبراء لغة. “اللغة غالبًا ما تكون الواجهة الأساسية للعديد من هذه الحالات التي تثير الاهتمام، لذلك لضمان تجربة رائعة، يجب تدريب النموذج ليعمل للجميع. التزام Appen بالبيانات عالية الجودة وتنمية الذكاء الاصطناعي المسؤولة والأخلاقية يسمح للشركات التي تشتري مجموعات البيانات الجاهزة الخاصة بنا بتعزيز مشاريع الذكاء الاصطناعي بثقة تامة في بياناتها”.
انضمت إلى المئات من مجموعات البيانات الحالية على appen.com، تشمل قائمة مجموعات Appen الجديدة من OTS الآن:
- كلام مخطط للغة العربية (مصر)، العربية (السعودية)، العربية (الإمارات العربية المتحدة)، الوسطى (كمبوديا)، الكرواتية، اليونانية، المجرية، البولندية، الإسبانية (إسبانيا)، والتركية
- OCR للصورة للنص المطبوع بالصينية المبسطة، النص المطبوع بالتايلاندية، والنص المطبوع بالفنلندية – يشمل لافتات مسبقة التسجيل، وعبوات خارجية، ولوحات إعلانية، ومجلات، وقوائم طعام لتدريب وتحديث نماذج OCR للرؤية الحاسوبية
- حركة الجسم البشري (الصين) – تشمل مقاطع فيديو مأخوذة عن أشخاص يتحركون، تم تتبعها على مستوى البكسل، مناسبة لتطوير الألعاب والتطبيقات الرياضية وغيرها
- صوت دموع الأطفال (الصين) – تشمل أصوات مسجلة مسبقًا ومُشروحة للأطفال التي يمكن استخدامها لتدريب نماذج الذكاء الاصطناعي على التعرف على أصوات البكاء المختلفة وتحذير الآباء
لمزيد من المعلومات وطلب عينة من مجموعة بيانات Appen OTS، انقر هنا.


