
مقابلات
د. رام شريهارسا، نائب رئيس الهندسة في Pinecone – سلسلة المقابلات

 أضف Unite.AI إلى مصادرك المفضلة على Google
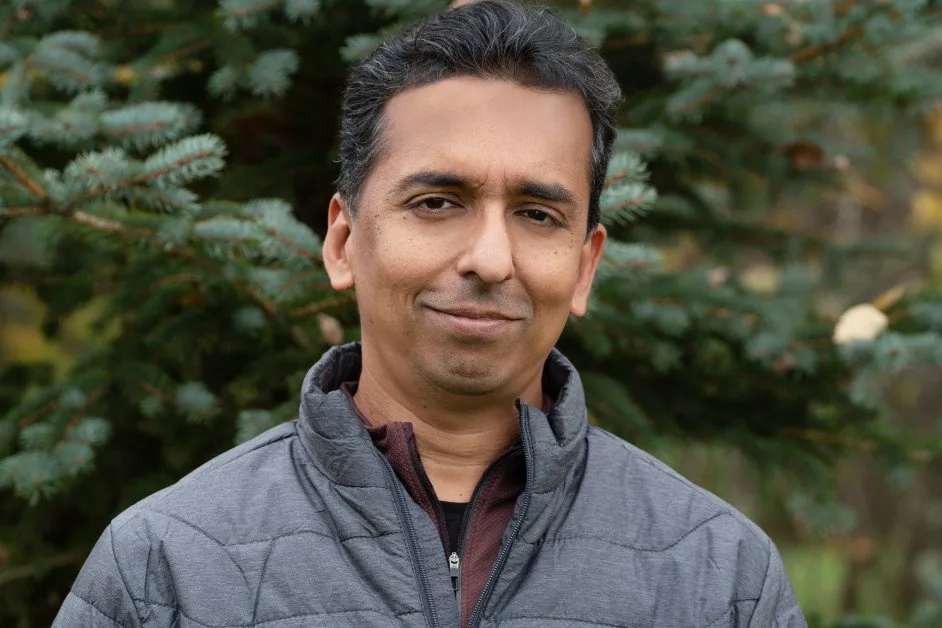
الدكتور رام سريهارشا هو نائب رئيس الهندسة والبحث والتطوير في Pinecone.
قبل انضمامه إلى Pinecone، شغل رام مناصب نائب الرئيس في Yahoo وDatabricks وSplunk. في Yahoo، كان مهندس برمجيات رئيسيًا ثم عالم أبحاث؛ وفي Databricks، قاد المنتج والهندسة لمنصة التحليلات الموحدة الخاصة بعلم الجينوم؛ وخلال سنواته الثلاث في Splunk، شغل عدة أدوار، منها كبير العلماء الرئيسيين، ونائب رئيس الهندسة، ومهندس متميز.
Pinecone قاعدة بيانات متجهية مُدارة بالكامل، تسهّل إضافة البحث المتجهي إلى التطبيقات المستخدمة في بيئات الإنتاج. وهي تجمع بين مكتبات البحث المتجهي، وإمكانات مثل التصفية، وبنية تحتية موزعة لتوفير أداء عالٍ وموثوقية على أي نطاق.
ما الذي جذبك في البداية إلى التعلم الآلي؟
الإحصاء عالي الأبعاد، ونظرية التعلم، وموضوعات من هذا النوع هي ما جذبني إلى التعلم الآلي. فهي محددة رياضيًا بدقة، ويمكن تحليلها بالاستدلال، وتقدم رؤى أساسية حول معنى التعلم وكيفية تصميم خوارزميات تتعلم بكفاءة.
كنت سابقًا نائب رئيس الهندسة في Splunk، وهي منصة بيانات تساعد على تحويل البيانات إلى إجراءات في مجالات قابلية الرصد وتقنية المعلومات والأمن وغيرها. ما أهم الدروس التي خرجت بها من هذه التجربة؟
لم أدرك تنوع حالات استخدام البحث المؤسسي حتى انضممت إلى Splunk: يستخدم الناس Splunk لتحليل السجلات، وقابلية الرصد، والتحليلات الأمنية، ضمن عدد هائل من الاستخدامات الأخرى. وما تشترك فيه كثير من هذه الاستخدامات هو الكشف عن أحداث متشابهة أو شديدة الاختلاف، أي شاذة، في بيانات غير مهيكلة. تبيّن أن هذه مشكلة صعبة، وأن الوسائل التقليدية للبحث في هذه البيانات لا تتوسع بكفاءة. وخلال عملي في Splunk، بدأت أبحاثًا في هذه المجالات حول كيفية استخدام التعلم الآلي والتعلم العميق لاستخراج المعلومات من السجلات والتحليلات الأمنية وغيرها. ومن خلال هذا العمل، أدركت أن التضمينات المتجهية والبحث المتجهي سيصبحان مكوّنًا أساسيًا في المناهج الجديدة لهذه المجالات.
هل يمكنك أن تشرح لنا ما البحث المتجهي؟
في البحث التقليدي، المعروف أيضًا بالبحث بالكلمات المفتاحية، تبحث عن تطابق الكلمات المفتاحية بين استعلام ووثائق، قد تكون تغريدات أو وثائق ويب أو مستندات قانونية أو غير ذلك. ولتحقيق ذلك، تقسّم الاستعلام إلى رموز، وتسترجع الوثائق التي تتضمن الرمز المعني، ثم تدمجها وترتبها لتحديد الوثائق الأكثر صلة بالاستعلام.
المشكلة الأساسية بالطبع هي أن الحصول على نتائج ذات صلة يتطلب تطابق كلمات الاستعلام مع كلمات في الوثيقة. ومن المشكلات التقليدية هنا أنك إذا بحثت عن «pop»، فستطابق «pop music»، لكنك لن تطابق «soda»، إذ لا يوجد تداخل في الكلمات المفتاحية بين «pop» والوثائق التي تحتوي على «soda»، مع أننا نعرف أن كلمة «pop» تُستخدم عاميًا في مناطق أمريكية كثيرة بمعنى المشروبات الغازية نفسه الذي تؤديه كلمة «soda».
في البحث المتجهي، تبدأ بتحويل كل من الاستعلامات والوثائق إلى متجه في فضاء عالي الأبعاد. ويُجرى ذلك عادة بتمرير النص عبر نموذج تعلم عميق، مثل النماذج اللغوية الكبيرة من OpenAI أو نماذج لغوية أخرى. والنتيجة مصفوفة من أعداد الفاصلة العائمة يمكن اعتبارها متجهًا في فضاء عالي الأبعاد.
الفكرة الأساسية هي أن المتجهات المتقاربة في هذا الفضاء العالي الأبعاد تكون متشابهة دلاليًا أيضًا. وبالعودة إلى مثال «soda» و«pop»، إذا دُرّب النموذج على مجموعة النصوص المناسبة، فمن المرجح أن يعدّ الكلمتين متشابهتين دلاليًا، وبالتالي تكون تضميناتهما متقاربة في فضاء التضمين. وعندئذ يصبح استرجاع الوثائق القريبة لاستعلام معين مسألة بحث عن أقرب جيران متجه الاستعلام المقابل في هذا الفضاء العالي الأبعاد.
هل يمكنك شرح ماهية قاعدة البيانات المتجهية وكيف تتيح بناء تطبيقات بحث متجهي عالية الأداء؟
تخزّن قاعدة البيانات المتجهية هذه التضمينات أو المتجهات وتفهرسها وتديرها. وأهم التحديات التي تعالجها هي:
- بناء فهرس بحث فعال للمتجهات للإجابة عن استعلامات أقرب الجيران.
- بناء فهارس مساعدة وهياكل بيانات فعالة لدعم تصفية الاستعلامات. فإذا أردت البحث في مجموعة فرعية فقط من مجموعة النصوص، ينبغي أن تتمكن من استخدام فهرس البحث الموجود دون الحاجة إلى إعادة بنائه.
ودعم التحديثات بكفاءة، والحفاظ على حداثة البيانات وفهرس البحث واتساقهما ومتانتهما وغير ذلك.
ما أنواع خوارزميات التعلم الآلي المستخدمة في Pinecone؟
نعمل عمومًا على خوارزميات البحث التقريبي عن أقرب الجيران، ونطوّر خوارزميات جديدة لتحديث كميات كبيرة من البيانات والاستعلام عنها والتعامل معها بكفاءة وبأقل تكلفة ممكنة.
ونعمل أيضًا على خوارزميات تجمع بين الاسترجاع الكثيف والاسترجاع المتناثر لتحسين صلة نتائج البحث.
ما بعض التحديات التي تواجه بناء بحث قابل للتوسع؟
مع أن البحث التقريبي عن أقرب الجيران خضع للدراسة طوال عقود، نعتقد أنه ما زال هناك الكثير مما لم يُكتشف.
فتصميم بحث واسع النطاق عن أقرب الجيران بتكلفة فعالة، وإجراء تصفية فعالة على نطاق واسع، وتصميم خوارزميات تدعم تحديثات بأحجام كبيرة وتحافظ عمومًا على حداثة الفهارس، كلها مشكلات صعبة اليوم.
ما بعض أنواع حالات الاستخدام المختلفة لهذه التقنية؟
يتسع نطاق استخدام قواعد البيانات المتجهية يومًا بعد يوم. وإلى جانب البحث الدلالي، نراها تُستخدم أيضًا في البحث عن الصور واسترجاعها، والذكاء الاصطناعي التوليدي، والتحليلات الأمنية، وغيرها.
ما رؤيتك لمستقبل البحث؟
أعتقد أن الذكاء الاصطناعي سيقود مستقبل البحث، ولا أرى أن ذلك المستقبل بعيد جدًا. وأتوقع أن تكون قواعد البيانات المتجهية مكوّنًا أساسيًا فيه. ونحب أن ننظر إليها بوصفها الذاكرة طويلة الأمد للذكاء الاصطناعي، أو قاعدة معارفه الخارجية.
شكرًا على هذه المقابلة الرائعة. يمكن للقراء الراغبين في معرفة المزيد زيارة Pinecone.



