
نماذج ومنصات الذكاء الاصطناعي
DIRFA يُحول مقاطع الصوت إلى وجوه رقمية واقعية

 أضف Unite.AI إلى مصادرك المفضلة على Google
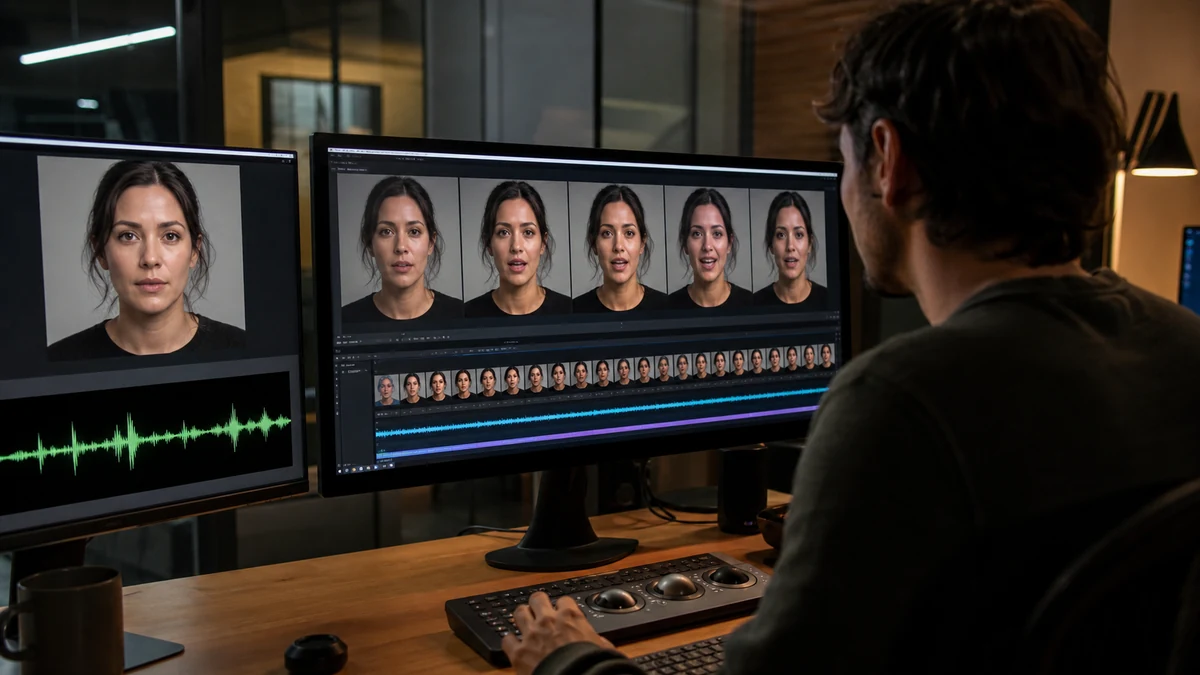
في خطوة كبيرة للأمام في مجال الذكاء الاصطناعي والاتصالات المتعددة، كشف فريق من الباحثين في جامعة نانيانغ التكنولوجية، سنغافورة (NTU سنغافورة) عن برنامج حاسوبي مبتكر يسمى DIRFA (التحريك الواقعي والمتعدد للوجه).
هذا الإنجاز القائم على الذكاء الاصطناعي يظهر قدرة مذهلة: تحويل مقطع صوتي بسيط وصورته الشخصية الثابتة إلى فيديوهات ثلاثية الأبعاد متحركة بشكل واقعي. تعرض هذه الفيديوهات ليس فقط تنسيق شفوي دقيق مع الصوت، ولكن أيضًا مجموعة غنية من التعبيرات الوجهية وحركات الرأس الطبيعية، مما يدفع حدود إنشاء الوسائط الرقمية إلى الأمام.
تطوير DIRFA
تقع الوظيفة الأساسية لبرنامج DIRFA في خوارزميته المتقدمة التي تدمج بسلاسة الإدخال الصوتي مع الصور الفوتوغرافية لإنشاء فيديوهات ثلاثية الأبعاد. من خلال تحليل دقيق للأنماط الصوتية والأصوات في الصوت، يتنبأ برنامج DIRFA بذكاء ويتكرر التعبيرات الوجهية وحركات الرأس. هذا يعني أن الفيديو الناتج يصور المتحدث بدرجة عالية من الواقعية، مع حركات وجهه المتزامنة تمامًا مع دقائق كلماته المنطوقة.
يعد تطوير DIRFA تحسنًا كبيرًا على التكنولوجيا السابقة في هذا المجال، والتي عانت غالبًا من تعقيدات المواقف والتعابير العاطفية المختلفة.
كافحت الأساليب التقليدية عادةً لتحقيق دقة في تكرار دقة التعبيرات البشرية أو كانت محدودة في khảية التعامل مع مواقف رأس مختلفة. ومع ذلك، يمتاز برنامج DIRFA بتقديم مجموعة واسعة من الدقة العاطفية ويمكنه التكيف مع اتجاهات رأس مختلفة، مما يوفر مخرجات أكثر تنوعًا وواقعية.
تعد هذه الخطوة ليس فقط خطوة إلى الأمام في تكنولوجيا الذكاء الاصطناعي، ولكنها também تفتح آفاقًا جديدة في كيفية تفاعلنا واستخدامنا لوسائط رقمية، مما يوفر نظرة على مستقبل حيث تكتسب الاتصالات الرقمية طابعًا أكثر شخصنة وتعبيرًا.
التدريب والتكنولوجيا وراء DIRFA
تعود قدرة DIRFA على تكرار التعبيرات الوجهية وحركات الرأس البشرية بدقة إلى عملية تدريب شاملة. قام فريق NTU سنغافورة بتدريب البرنامج على مجموعة بيانات ضخمة – أكثر من مليون مقطع صوتي-مرئي من مجموعة VoxCeleb2.
تتضمن هذه المجموعة مجموعة متنوعة من التعبيرات الوجهية وحركات الرأس والأنماط الصوتية من أكثر من 6000 فرد. من خلال تعريض DIRFA لمثل هذه المجموعة الواسعة والمتنوعة من البيانات الصوتية-البصرية، تعلم البرنامج تحديد وتكرار الدقة الدقيقة التي تميز التعبيرات والكلام البشري.
شارك الأستاذ المساعد لو شيجيان، المؤلف الرئيسي للدراسة، والدكتور وو رونgliang، المؤلف الأول، في تقديم رؤى قيمة حول أهمية عملهم.
قال الأستاذ لو: “يمكن أن يكون تأثير دراستنا عميقًا ومتعدد التأثيرات، حيث ثوري مجال الاتصالات المتعددة من خلال تمكين إنشاء فيديوهات واقعية عالية الجودة للأفراد الناطقين، باستخدام تقنيات مثل الذكاء الاصطناعي والتعلم الآلي. كما يعتمد برنامجنا على الدراسات السابقة ويمثل تقدمًا في التكنولوجيا، حيث إن الفيديوهات التي تم إنشاؤها باستخدام برنامجنا كاملة مع حركات شفوية دقيقة وتعبيرات وجهية حية وحركات رأس طبيعية، باستخدام فقط تسجيلات الصوت والصور الثابتة”.
أضاف الدكتور وو رونgliang: “يعرض الكلام مجموعة متنوعة من الاختلافات. ينطق الأفراد بنفس الكلمات بشكل مختلف في سياقات مختلفة، بما في ذلك الاختلافات في المدة والصوت والطون وغيرها. بالإضافة إلى محتواها اللغوي، فإن الكلام ينقل معلومات غنية حول حالة المتكلم العاطفية وعوامل الهوية مثل الجنس والعمر والعرق وسمات الشخصية. يعتبر نهجنا جهدًا رائدًا في تحسين الأداء من منظور التعلم التمثيلي للصوت في الذكاء الاصطناعي والتعلم الآلي”.

مقارنة بين DIRFA ونهج توليد وجه النطق المبتكرة الحالية. (NTU سنغافورة)
التطبيقات المحتملة
تعد واحدة من التطبيقات الواعدة لبرنامج DIRFA في مجال الرعاية الصحية، خاصة في تطوير المساعدين الافتراضيين المتقدمين وبرامج الدردشة. مع khảية إنشاء تحريكات وجه واقعية ومتجاوبة، يمكن لبرنامج DIRFA تعزيز تجربة المستخدم بشكل كبير في منصات الرعاية الصحية الرقمية، مما يجعل التفاعلات أكثر شخصنة ومتفاعلة. يمكن أن تكون هذه التكنولوجيا حاسمة في توفير الراحة العاطفية والرعاية الشخصية من خلال الوسائط الافتراضية، وهو جانب حاسم غالبًا ما يفتقر إليه حلول الرعاية الصحية الرقمية الحالية.
كما يمتلك برنامج DIRFA إمكانيات كبيرة في مساعدة الأفراد الذين يعانون من إعاقات في الكلام أو التعبير الوجهي. لأولئك الذين يواجهون تحديات في الاتصال اللفظي أو التعبير الوجهي، يمكن لبرنامج DIRFA أن يكون أداة قوية، تمكنهم من التعبير عن أفكارهم ومشاعرهم من خلال التمثيلات الافتراضية أو الرقمية. يمكنه تعزيز khảيةهم في التواصل بشكل فعال، وغلق الفجوة بين نواياهم وتعبيراتهم. من خلال توفير وسيلة رقمية للتعبير، يمكن لبرنامج DIRFA أن يلعب دورًا حيويًا في تمكين هؤلاء الأفراد، ويوفر لهم طريقًا جديدًا للتفاعل والتعبير عن أنفسهم في العالم الرقمي.
التحديات والاتجاهات المستقبلية
تعد إنشاء تعبيرات وجه واقعية من الإدخال الصوتي فقط تحديًا معقدًا في مجال الذكاء الاصطناعي والاتصالات المتعددة. يعد نجاح برنامج DIRFA الحالي في هذا المجال ملحوظًا، ومع ذلك، فإن دقة التعبيرات البشرية تعني أن هناك دائمًا مجالًا للتحسين. لكل فرد نمط كلام فريد، ويمكن أن تختلف تعبيراته الوجهية بشكل كبير حتى مع نفس الإدخال الصوتي. التقاط هذه التنوع والدقة يبقى تحديًا رئيسيًا لفريق برنامج DIRFA.
يعترف الدكتور وو ببعض القيود في إصدار برنامج DIRFA الحالي. على سبيل المثال، يحتاج واجهة البرنامج ودرجة التحكم الذي يقدمه على الإخراج إلى تحسين. على سبيل المثال، عدم khảية تعديل التعبيرات المحددة، مثل تغيير الحزن إلى ابتسامة، هو قيد يهدفون إلى التغلب عليه. من الضروري معالجة هذه القيود لتوسيع قابلية تطبيق برنامج DIRFA وسهولة استخدامه.
في المستقبل، يخطط فريق NTU لتطوير برنامج DIRFA باستخدام مجموعة بيانات أكثر تنوعًا، بما في ذلك مجموعة أوسع من التعبيرات الوجهية ومقاطع الصوت. من المتوقع أن يزيد هذا التوسيع من دقة وواقعية التحريكات الوجهية التي ينتجها برنامج DIRFA، مما يجعلها أكثر مرونة وتكيفًا مع مختلف السياقات والتطبيقات.
الأثر وإمكانيات برنامج DIRFA
يعد برنامج DIRFA، مع نهجه الرائد في توليد تحريكات وجه واقعية من الصوت، على وشك ثورة مجال الاتصالات المتعددة. هذه التكنولوجيا تمد حدود التفاعل الرقمي، وتلغي الحدود بين العالم الرقمي والفيزيائي. من خلال تمكين إنشاء تمثيلات رقمية دقيقة وواقعية، يعزز برنامج DIRFA جودة وصدق الاتصالات الرقمية.
مستقبل تكنولوجيا مثل برنامج DIRFA في تعزيز الاتصالات الرقمية والتمثيل هو واسع ومثير. مع استمرار تطور هذه التكنولوجيا، توعد بتقديم طرق أكثر غمرة وpersonنة وتعبيرًا للتفاعل في الفضاء الرقمي.
يمكنك العثور على الدراسة المنشورة هنا.


