
المراقبة
وجوه اصطناعية منخفضة الجودة قد تساعد في تحسين التعرف على الوجوه

 أضف Unite.AI إلى مصادرك المفضلة على Google
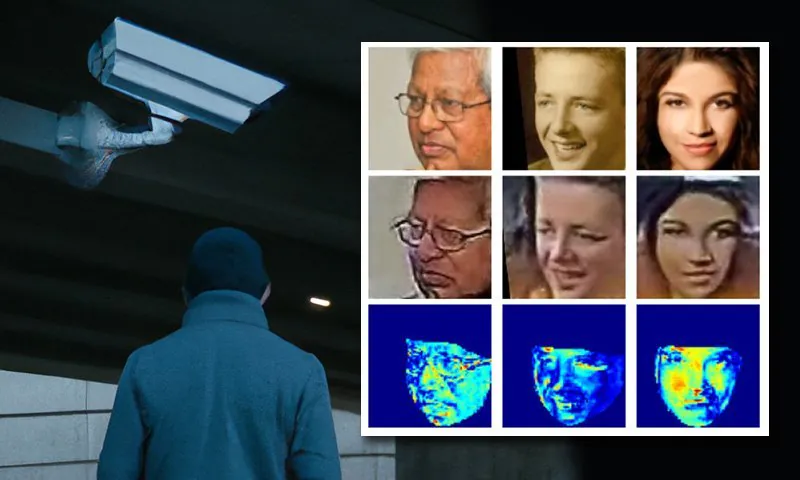
النقاط الرئيسيةيمكن للوجوه الاصطناعية المصممة على غرار لقطات المراقبة الحقيقية أن تسدّ الفجوة بين…
عرض المزيد
- يمكن للوجوه الاصطناعية المصممة على غرار لقطات المراقبة الحقيقية أن تسدّ الفجوة بين النطاقين والتي تُضعف دقة التعرّف.
- تعاني أنظمة الدوائر التلفزيونية المغلقة القديمة من دين تقني يجعلها مصادر بيانات ضعيفة لتدريب أنظمة التعرّف على الوجوه الحديثة.
- يمكن للتقنيات الخصومية أن تعزّز دقة التعرّف بدلاً من أن تهدّدها فقط.
قام باحثون من جامعة ولاية ميشيغان بتصميم طريقة للوجوه الاصطناعية لتأخذ استراحة من مشهد Deepfakes وتفعل الخير في العالم – من خلال مساعدة أنظمة التعرف على الصور في أن تصبح أكثر دقة.
الوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM) التي صممها يمكنها إعادة توليد الوجوه بنمط صور الفيديو المراقبة في العالم الحقيقي ، بدلاً من الاعتماد على الصور ذات الجودة الأعلى المستخدمة في مجموعات البيانات المفتوحة الشهيرة من المشاهير ، والتي لا تعكس جميع العيوب والقصور في أنظمة المراقبة الحقيقية ، مثل ضبابية الوجه وانخفاض الدقة وضوضاء المستشعر، وهي عوامل قد تؤثر في دقة التعرف.

هندسة معمارية مفهومية للوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM). Source: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022.pdf
الوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM) لا تهدف بشكل خاص إلى محاكاة مواقف الرأس أو التعبيرات أو جميع السمات الأخرى التي هي هدف أنظمة Deepfakes ، ولكنها تهدف إلى توليد مجموعة من وجهات النظر البديلة بنمط نظام التعرف على الصور المستهدف ، باستخدام نقل النمط.
النظام مصمم لمحاكاة نمط مجال نظام المستهدف ، وتكييف إخراجها وفقًا للدقة ومدى “الغرابة” فيه. يتضمن استخدام النظام أنظمة موروثة لا يُرجح تحديثها بسبب التكلفة ، ولكنها يمكن أن تساهم حاليًا قليلاً في جيل جديد من تقنيات التعرف على الوجه بسبب جودة الإخراج الرديئة التي قد كانت في يوم من الأيام رائدة.
عند اختبار النظام ، وجد الباحثون أنه حقق مكاسب ملحوظة في أحدث التقنيات في أنظمة التعرف على الصور التي يجب أن تتعامل مع هذا النوع من البيانات الصاخبة وذات الجودة المنخفضة.

تدريب نماذج التعرف على الوجه على التكيف مع قيود أنظمة المستهدف. Source: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022_supp.pdf
كما وجدوا منتجًا مفيدًا للعملية – أن مجموعات البيانات المستهدفة يمكن أن تكون الآن ممثلة ومقارنة ببعضها البعض ، مما يجعل من السهل مقارنة مجموعات البيانات وبناء مجموعات بيانات مخصصة لأنظمة المراقبة المختلفة في المستقبل.
علاوة على ذلك ، يمكن تطبيق الطريقة على مجموعات بيانات موجودة ، مما يؤدي إلى تكييف المجال فعليًا وجعلها أكثر ملاءمة لأنظمة التعرف على الوجه.
الورقة الجديدة بعنوان توليد الوجوه القابل للتحكم والموجّه للتعرّف على الوجوه دون قيود ، مدعومة جزئيًا من مكتب المدير الوطني للاستخبارات (ODNI ، في IARPA) ، وتنشأ من أربعة باحثين في قسم علوم وهندسة الحاسوب في MSU.
المحتوى المميز
أصبح التعرف على الوجه منخفض الجودة (LQFR) مجالًا بارزًا للدراسة خلال السنوات القليلة الماضية. بسبب بناء السلطات المدنية والمحلية لأنظمة المراقبة بالفيديو لتكون متينة وطويلة الأمد (بدلاً من إعادة تخصيص الموارد للمشكلة بشكل دوري) ، أصبحت العديد من شبكات المراقبة “التراثية” ضحايا الديون الفنية ، من حيث قابليتها للتكيف كمصادر بيانات لتعلم الآلة.

مستويات مختلفة من دقة الوجه عبر مجموعة من أنظمة المراقبة بالفيديو التاريخية والأحدث. Source: https://arxiv.org/pdf/1805.11519.pdf
لحسن الحظ، تلائم هذه المهمة نماذج الانتشار وغيرها من النماذج القائمة على الضوضاء بصورة استثنائية. العديد من أنظمة توليد الصور الأكثر شعبية وفعالية في السنوات القليلة الماضية تقوم بتعزيز الصورة منخفضة الدقة كجزء من خط أنابيبها ، بينما يكون هذا ضروريًا أيضًا لتقنيات الضغط العصبي (طرق لحفظ الصور والأفلام كبيانات عصبية بدلاً من بيانات البت).
جزء من تحدي التعرف على الوجه هو الحصول على أقصى دقة ممكنة من أقل عدد من الميزات التي يمكن استخراجها من الصور منخفضة الدقة الأصغر والأقل احتواءً على معلومات مفيدة. هذا القيد موجود ليس فقط لأنه من المفيد أن نتمكن من تحديد (أو إنشاء) وجه عند دقة منخفضة ، ولكن أيضًا بسبب القيود الفنية على حجم الصور التي يمكن أن تعبر عبر الفضاء الكامن الناشئ لنموذج يتدرب في أي VRAM متاح على GPU محلي.
في هذا السياق ، فإن مصطلح “الميزات” مربك ، لأن هذه الميزات يمكن أيضًا الحصول عليها من مجموعة بيانات مقاعد الحديقة. في قطاع الرؤية الحاسوبية ، تشير “الميزات” إلى الخصائص المميزة المستخرجة من الصور – أي صورة ، سواء كانت خطوط الكنيسة أو الجبل أو موضع ميزات الوجه في مجموعة بيانات الوجه.
منذ أن أصبحت خوارزميات الرؤية الحاسوبية ماهرة في تعزيز الصور وأشرطة الفيديو ، تم اقتراح طرق مختلفة لتعزيز مواد المراقبة منخفضة الدقة أو المتدهورة ، إلى الحد الذي قد يكون من الممكن استخدام هذه التعزيزات لأغراض قانونية ، مثل وضع شخص معين في مكان ما ، فيما يتعلق بالتحقيق في الجريمة.
بالإضافة إلى إمكانية سوء التعرف ، الذي جمع عناوين الأخبار من وقت لآخر ، لا ينبغي في النظرية أن يكون من الضروري تعزيز أو تحويل مواد الفيديو منخفضة الدقة من أجل التعرف على شخص معين ، لأن نظام التعرف على الوجه الذي يركز على ميزات منخفضة المستوى لا ينبغي أن يحتاج إلى ذلك المستوى من الدقة والوضوح. علاوة على ذلك ، فإن هذه التحويلات باهظة الثمن في الممارسة ، وتثير أسئلة إضافية ، متكررة حول صلاحيتها وشرعيتها.
الحاجة إلى المزيد من صور المشاهير ذات الجودة المنخفضة
سيكون من المفيد أكثر إذا كان نظام التعرف على الوجه يمكن استخراج ميزات (أي ميزات تعلم الآلة من ميزات الإنسان) من إخراج أنظمة موروثة كما هي ، من خلال فهم أفضل للعلاقة بين “الجودة العالية” الهوية والصور المتدهورة المتاحة في إطارات المراقبة بالفيديو الحقيقية غير القابلة للتعويض (والغالبًا غير القابلة للاستبدال).
المشكلة هنا هي مشكلة المعايير: مجموعات البيانات الشائعة التي يتم جمعها من الويب مثل MS-Celeb-1M و WebFace260M (من بين عدة مجموعات أخرى) ، تبناها مجتمع البحث لأنها توفر معايير متسقة يمكن للباحثين قياس تقدمهم المتزايد أو الكبير عليها.

أمثلة من مجموعة بيانات MS-Celeb1m الشهيرة من مايكروسوفت. Source: https://www.microsoft.com/en-us/research/project/ms-celeb-1m-challenge-recognizing-one-million-celebrities-real-world/
ومع ذلك، يجادل المؤلفون بأن خوارزميات التعرف على الوجه (FR) التي تم تدريبها على هذه المجموعات غير مناسبة للمواد لخروج أنظمة المراقبة القديمة.
تنص الورقة على ما يلي*:
‘نماذج FR من الدرجة الأولى لا تعمل جيدًا على صور المراقبة في العالم الحقيقي (غير مقيدة) بسبب مشكلة التحول في المجال ، أي أن مجموعات البيانات الكبيرة التي تم الحصول عليها من خلال الوجه المشهورة التي تم جمعها من الويب تفتقر إلى التنوع في الظروف الواقعية غير المضبوطة ، مثل الضوضاء الداخلية للجهاز وانخفاض الدقة وضبابية الحركة وتأثير الاضطراب ، إلخ.
‘على سبيل المثال ، دقة التحقق 1: 1 التي أبلغ عنها واحدة من نماذج الدرجة الأولى على مجموعة بيانات IJB-S غير المقيدة هي منخفضة بنسبة 30٪ عن مجموعة بيانات LFW شبه المقيدة.
‘علاج محتمل للفجوة في الأداء هو تجميع مجموعة بيانات الوجه غير المقيدة على نطاق كبير. ومع ذلك ، فإن بناء مثل هذه مجموعة بيانات التدريب مع عشرات الآلاف من الأشخاص هو أمر صعب للغاية بسبب التكلفة العالية للتسمية اليدوية.’
يروي البحث في الورقة عدة طرق سابقة حاولت “مطابقة” أنواع الإخراج المتنوعة لأنظمة المراقبة التاريخية أو منخفضة التكلفة. ومع ذلك ، لاحظوا أن هذه الطرق تعاملت مع “تعزيزات عمياء”. من ناحية أخرى ، تتلقى الوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM) تعليقات مباشرة من إخراج نظام المستهدف الحقيقي خلال التدريب ، وتكيف نفسها من خلال نقل النمط لمحاكاة ذلك المجال.

الممثلة ناتالي بورتمان ، التي ليست غريبة على مجموعة من مجموعات البيانات التي تسيطر على مجتمع الرؤية الحاسوبية ، تظهر بين الهويات في هذا مثال على الوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM) التي تقوم بتعديل المجال المطابق للنمط بناءً على تعليقات من مجال نموذج المستهدف الفعلي.
الهندسة المعمارية التي صممها المؤلفون تستخدم طريقة إشارة التدرج السريع (FGSM) لتحديد وتحويل الأنماط والخصائص المكتسبة من إخراج نظام المستهدف الحقيقي. جزء خط أنابيب توليد الصور سيتحسن ويتطابق بشكل أفضل مع نظام المستهدف مع التدريب. هذه التعليقات من فضاء النمط منخفض الأبعاد لنظام المستهدف هي منخفضة المستوى وتناظرية للمواصفات البصرية المشتقة الأكثر شمولاً.
يقول المؤلفون:
‘مع تعليقات نموذج FR ، الصور المولّدة أكثر فائدة لأداء FR ، مما يؤدي إلى تحسين كبير في قدرات التعميم لنموذج FR الذي تم تدريبه به.’
الاختبارات
استخدم الباحثون العمل السابق كقالب لاختبار نظامهم. بناءً على نفس بروتوكولات الاختبار ، استخدموا MS-Celeb-1m ، التي تتكون حصريًا من صور المشاهير التي تم جمعها من الويب ، ك مجموعة بيانات التدريب المسمى. من أجل العدالة ، أضافوا أيضًا MS1M-V2 ، التي تحتوي على 3.9 مليون صورة تمثل 85,700 فئة.
بيانات المستهدف كانت مجموعة بيانات WiderFace ، من الجامعة الصينية في هونغ كونغ. هذه مجموعة صور متنوعة مصممة لمهام الكشف عن الوجه في ظروف صعبة. وقد استُخدمت 70,000 صورة من هذه المجموعة.
للتقييم ، تم اختبار النظام ضد أربعة معايير للتعرف على الوجه: IJB-B وIJB-C وIJB-S وTinyFace.
تم تدريب الوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM) مع ∼10٪ من بيانات التدريب من MS-Celeb-1m ، حول 0.4 مليون صورة ، ل 125,000 تكرار بحجم دفعة 32 تحت محسّن Adam بمعدل تعلم منخفض جدًا 1e-4.
استخدم نموذج التعرف على الوجه المستهدف تعديلًا من ResNet-50 للنظام الخلفي ، مع تمكين وظيفة الخسارة ArcFace أثناء التدريب. بالإضافة إلى ذلك ، تم تدريب نموذج مع الوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM) كتمارين اختبار وتحليل (مشار إليه باسم “ArcFace” في جدول النتائج أدناه).

نتائج الاختبارات الرئيسية للوحدة الجديدة لتوليد الوجه القابل للتحكم (CFSM). الأرقام الأعلى هي الأفضل.
يقول المؤلفون عن النتائج الرئيسية:
‘نموذج ArcFace يتفوق على جميع الأسس في مهام التعرف على الوجه والتحقق ، ويتحقق من أداء جديد من الدرجة الأولى.’
القدرة على استخراج المجالات من الخصائص المختلفة لأنظمة المراقبة القديمة أو منخفضة المواصفات تمكن المؤلفين أيضًا من مقارنة وتقييم تشابه التوزيع بين هذه الإطارات ، وتمثيل كل نظام بمصطلح نمط بصرية يمكن الاستفادة منه في العمل اللاحق.

أمثلة من مجموعات بيانات مختلفة تظهر اختلافات واضحة في النمط.
يقول المؤلفون أيضًا أن نظامهم يمكن أن يستفيد من بعض التكنولوجيات التي تم اعتبارها حتى الآن مشاكل يجب حلها من قبل مجتمع البحث والرؤية:
‘[CFSM] يظهر أن التلاعب العدائي يمكن أن يتجاوز كونه مهاجمًا ، ويمكن أن يخدم لزيادة دقة التعرف في مهام الرؤية. في غضون ذلك ، نقوم بتعريف مقياس تشابه مجموعة البيانات بناءً على أسس النمط المكتسبة ، والتي تكتسب اختلافات النمط بطريقة لا تعتمد على التسميات أو النموذج المتنبئ.’
‘نعتقد أن بحثنا قد قدم قوة نموذج توليد الوجه القابل للتحكم والموجه للتعرف على الوجه غير المقيد ، ويوفر فهمًا لاختلافات مجموعة البيانات.’
* تحويلي لمراجع المؤلفين إلى روابط.
نشر لأول مرة في 1 أغسطس 2022.


