زاوية Anderson
عزل الصور بالذكاء الاصطناعي مع فهم المشاهد

 أضف Unite.AI إلى مصادرك المفضلة على Google
النقاط الرئيسيةيستخدم إزالة الخلفية بالذكاء الاصطناعي الآن فهم المشهد لاستبدال الشاشات الخضراء.
عرض المزيد
- يستخدم إزالة الخلفية بالذكاء الاصطناعي الآن فهم المشهد لاستبدال الشاشات الخضراء.
- تتفوق منظومة SPG-IM الجديدة على الطرق الخالية من خرائط التثليث بفارق كبير.
- توفر التسميات النصية بديلاً منخفض التكلفة عن وضع العلامات على البكسلات المكلف.
في الفيلم الوثائقي الإضافي المصاحب لإصدار DVD لعام 2003 من Alien3 (1992)، استعاد رائد المؤثرات البصرية Richard Edlund، بامتعاض، «مصارعة السومو» التي اتسمت بها عملية استخراج الأقنعة بطريقة كيميائية ضوئية، والتي هيمنت على أعمال المؤثرات البصرية بين أواخر ثلاثينيات القرن العشرين وأواخر ثمانينياته. ووصف Edlund طبيعة العملية التي تتأرجح بين النجاح والإخفاق بأنها «مصارعة السومو»، مقارنةً بتقنيات الشاشة الزرقاء والخضراء الرقمية التي سادت في أوائل التسعينيات (وقد عاد إلى هذا التشبيه منذ ذلك الحين).
كان استخراج عنصر من المقدمة، مثل شخص أو نموذج مركبة فضائية، من خلفية ما، بهدف دمج الصورة المعزولة في لوحة خلفية، يتم في البداية بتصوير العنصر أمام خلفية موحدة زرقاء أو خضراء.
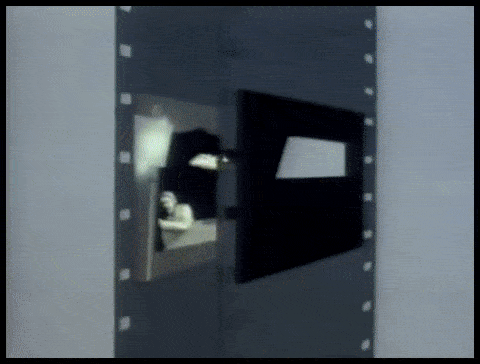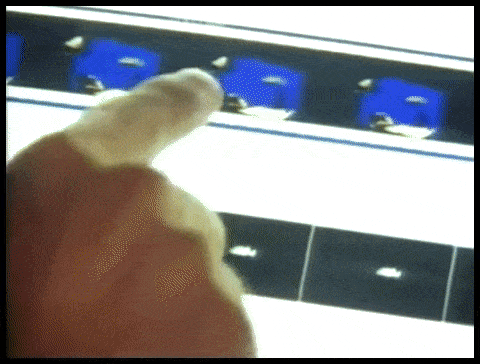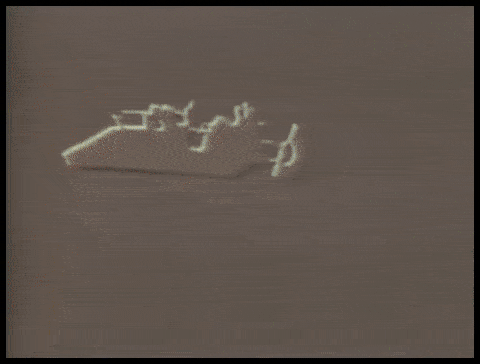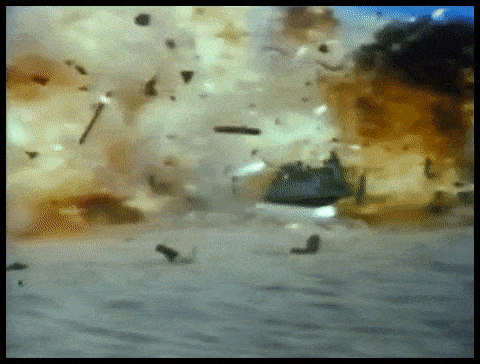
عمليات شاقة لاستخراج الأقنعة بطريقة كيميائية ضوئية من لقطة مؤثرات بصرية نفذتها ILM لفيلم ‘Return of the Jedi’ (1983).
في اللقطات الناتجة، كان يُعزل لون الخلفية كيميائياً، ثم يُستخدم قالباً لإعادة طباعة العنصر الموجود في المقدمة (أو الشخص) بواسطة طابعة بصرية، ليظهر كعنصر «عائم» داخل إطار فيلم شفاف فيما عداه.
عُرفت هذه العملية باسم تراكب فصل الألوان (CSO)، إلا أن المصطلح ارتبط لاحقاً بدرجة أكبر بتأثيرات الفيديو البدائية المسماة «كرومـاكي»، التي ظهرت في الإنتاج التلفزيوني ذي الميزانيات الأقل خلال سبعينيات وثمانينيات القرن العشرين، ونُفذت بوسائل تناظرية لا كيميائية أو رقمية.

عرض توضيحي لتراكب فصل الألوان عام 1970 في برنامج الأطفال البريطاني ‘Blue Peter’. المصدر: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
وفي كل الأحوال، سواء أكانت العناصر مصورة للفيلم أم للفيديو، أمكن بعد ذلك إدراج اللقطات المعزولة في أي لقطات أخرى.
وعلى الرغم من أن عملية بخار الصوديوم التي طورتها Disney وكانت أعلى كلفة وملكيتها حصرية (إذ تعتمد تحديداً على اللون الأصفر، كما استُخدمت في فيلم الرعب The Birds للمخرج Alfred Hitchcock عام 1963) أتاحت تحديداً أفضل وأقنعة أكثر وضوحاً، ظل استخراج الأقنعة بطريقة كيميائية ضوئية شاقاً وغير موثوق.

كانت عملية استخراج الأقنعة ببخار الصوديوم التي تملكها Disney تتطلب خلفيات قريبة من الطرف الأصفر من الطيف. هنا، تظهر Angela Lansbury معلقة بأسلاك أثناء تصوير مشهد حافل بالمؤثرات البصرية لفيلم ‘Bedknobs and Broomsticks’ (1971). المصدر
ما بعد إنشاء الأقنعة الرقمية
في تسعينيات القرن العشرين، تخلّصت الثورة الرقمية من المواد الكيميائية، لكنها لم تُلغِ الحاجة إلى الشاشات الخضراء. وأصبح من الممكن إزالة الخلفية الخضراء (أو أي لون آخر) بمجرد البحث عن وحدات البكسل التي تقع ضمن نطاق تسامح محدد لذلك اللون، وذلك باستخدام برامج تحرير الصور مثل Photoshop، إلى جانب جيل جديد من برامج تركيب الفيديو القادرة على إزالة الخلفيات الملونة تلقائياً. وفي غضون ليلة تقريباً، أُحيلت ستون عاماً من تاريخ صناعة الطباعة البصرية إلى الماضي.
تقود أبحاث الرؤية الحاسوبية المعززة بوحدات معالجة الرسومات، التي أُجريت خلال السنوات العشر الماضية، عملية استخراج الأقنعة إلى حقبة ثالثة، إذ تتولى الأبحاث تطوير أنظمة قادرة على إنشاء أقنعة عالية الجودة من دون الحاجة إلى شاشات خضراء. وعلى Arxiv وحده، تُنشر أبحاث حول الابتكارات في استخراج العناصر الأمامية بالاستناد إلى التعلم الآلي أسبوعياً.
إدخالنا في الصورة
وقد بدأ هذا الاهتمام الأكاديمي والصناعي باستخراج الصور بالذكاء الاصطناعي يؤثر بالفعل في سوق المستهلكين؛ إذ باتت التطبيقات البدائية، وإن كانت عملية، مألوفة لنا جميعاً في صورة مرشحات Zoom وSkype التي تستبدل خلفيات غرف المعيشة لدينا بجزر استوائية وغيرها أثناء مكالمات الفيديو.
لكن أفضل الأقنعة لا تزال تتطلب شاشة خضراء، كما أشارت Zoom الأربعاء الماضي.

يساراً، رجل أمام شاشة خضراء، وقد عُزل شعره بدقة باستخدام ميزة الخلفية الافتراضية في Zoom. يميناً، امرأة أمام مشهد منزلي عادي، عُزل شعرها خوارزمياً بدقة أقل وبمتطلبات حوسبة أعلى. المصدر: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
ويحذر منشور آخر على منصة دعم Zoom من أن استخراج العناصر من دون شاشة خضراء يتطلب أيضاً قدرة حوسبة أكبر في جهاز الالتقاط.
الحاجة إلى إزالة الخلفية
إن تحسين الجودة وسهولة النقل وكفاءة استهلاك الموارد في أنظمة استخراج الأقنعة «في البيئات الواقعية» (أي عزل الأشخاص من دون الحاجة إلى شاشات خضراء) يفيد قطاعات وأنشطة أكثر بكثير من مجرد فلاتر مؤتمرات الفيديو.
في تطوير مجموعات البيانات، يتيح تحسين التعرّف على الوجوه والرأس بالكامل والجسم بالكامل إمكانية ضمان عدم إدخال عناصر الخلفية الدخيلة في تدريب نماذج الرؤية الحاسوبية للأشخاص؛ ومن شأن العزل الأكثر دقة أن يحسّن بدرجة كبيرة تقنيات التقسيم الدلالي المصممة لتمييز المجالات واستيعابها (أي ‘قطة’، و‘شخص’، و‘قارب’)، وأن يحسّن أنظمة توليد الصور القائمة على المشفّر التلقائي التغايري (VAE) والمحوّل، مثل نظام OpenAI الجديد DALL-E 2؛ كما أن خوارزميات الاستخراج الأفضل ستقلل الحاجة إلى عمليات الروتوسكوب اليدوية المكلفة ضمن مسارات عمل المؤثرات البصرية الباهظة.
في الواقع، بدأت منهجيات متعددة الوسائط (النص والصورة عادةً) تكتسب حضورًا في معالجة الصور؛ إذ يُشفَّر فيها مجال مثل «قطة» على هيئة صورة ونصوص مرجعية مرتبطة بها. ومن الأمثلة الحديثة بنية Text2Live، التي تستخدم التدريب متعدد الوسائط (النص والصورة) لإنشاء مقاطع فيديو لأشياء كثيرة، منها بجع من الكريستال وزرافات من الزجاج.
إنشاء أقنعة بالذكاء الاصطناعي تراعي مشهد الصورة
تركّز قدر كبير من الأبحاث المتعلقة بإنشاء الأقنعة تلقائيًا بالذكاء الاصطناعي على التعرّف على الحدود وتقييم التجمعات القائمة على وحدات البكسل داخل الصورة أو إطار الفيديو. لكن أبحاثًا جديدة من الصين تقدّم مسار عمل للاستخراج يحسّن تحديد العناصر وجودة الأقنعة بالاستفادة من الأوصاف النصية للمشهد (وهو نهج متعدد الوسائط اكتسب زخمًا في مجال أبحاث الرؤية الحاسوبية خلال السنوات الثلاث إلى الأربع الماضية)، وتفيد بأنه حقق تحسنًا على الأساليب السابقة من نواحٍ عدة.

مثال على الاستخراج باستخدام SPG-IM (الصورة الأخيرة في أسفل اليمين)، مقارنةً بالأساليب السابقة المنافسة. المصدر: https://arxiv.org/pdf/2204.09276.pdf
يتمثل التحدي الذي يواجه القطاع الفرعي لأبحاث الاستخراج في تطوير مسارات عمل لا تتطلب سوى الحد الأدنى من التعليقات التوضيحية اليدوية والتدخل البشري، ومن الأفضل ألا تتطلب أيًا منهما. وإلى جانب الآثار المترتبة على التكلفة، يشير الباحثون في الورقة الجديدة إلى أن التعليقات التوضيحية وعمليات التجزئة اليدوية التي ينفذها عاملون جماعيون متعاقد معهم من ثقافات مختلفة قد تؤدي إلى وضع تسميات على الصور أو حتى تجزئتها بطرائق متباينة، ما ينتج عنه خوارزميات غير متسقة وغير مرضية.
ومن أمثلة ذلك التفسير الذاتي لماهية «عنصر المقدمة»:

من الورقة الجديدة: تختلف الأساليب السابقة LFM وMODNet في تعريف محتوى المقدمة، وتتفاوت فاعليتها في ذلك (يشير «GT» إلى الحقيقة المرجعية، وهي نتيجة «مثالية» غالبًا ما تتحقق يدويًا أو بوسائل غير خوارزمية)، بينما تحدد طريقة SPG-IM الجديدة «العناصر القريبة» بفاعلية أكبر مستعينةً بسياق المشهد.
ولمعالجة هذه المشكلة، طوّر الباحثون مسار عمل من مرحلتين بعنوان Situational Perception Guided Image Matting (SPG-IM). وتتألف بنية المُرمِّز/مُفكِّك الترميز ذات المرحلتين من Situational Perception Distillation (SPD) وSituational Perception Guided Matting (SPGM).

بنية SPG-IM.
أولًا، تدرّب SPD مسبقًا تحويلات السمات من المرئي إلى النصي، وتولّد أوصافًا ملائمة للصور المرتبطة بها. بعد ذلك، يُتاح التنبؤ بقناع المقدمة من خلال ربط مسار العمل بتقنية جديدة للتنبؤ بالبروز.
ثم تنتج SPGM قناع ألفا تقديريًا استنادًا إلى صورة RGB الخام المدخلة والقناع المُولّد في الوحدة الأولى.
الغاية هي توجيه النظام بإدراك سياقي، بحيث يفهم مكونات الصورة ضمن سياقها، ما يتيح له، مثلًا، معالجة تحدي استخراج الشعر المعقد من خلفية بالاستناد إلى الخصائص المعروفة لهذه المهمة المحددة.

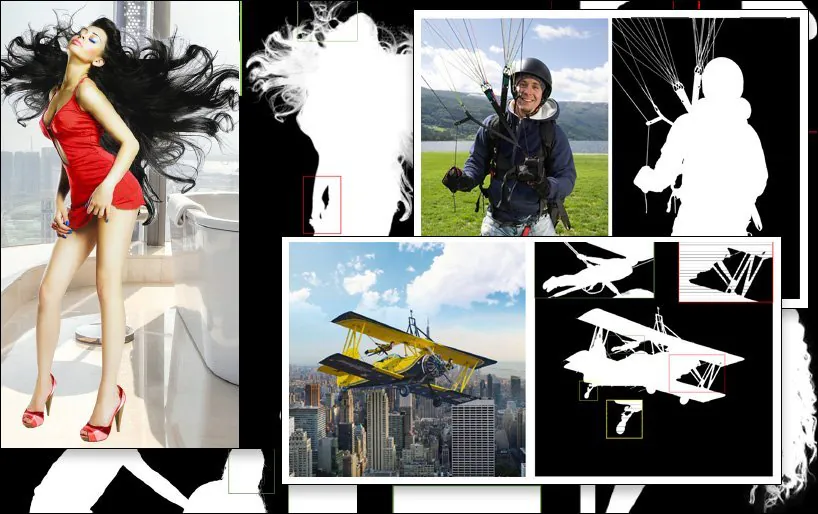
في المثال أدناه، يدرك SPG-IM أن الحبال جزء أصيل من «مظلة الهبوط»، بينما يعجز MODNet عن الاحتفاظ بهذه التفاصيل وتحديدها. وبالمثل، فُقدت اعتباطيًا في الصورة أعلاه البنية الكاملة لمعدات الملعب عند استخدام MODNet.
تحمل الدراسة الجديدة عنوان عزل الصور الموجّه بالإدراك الظرفي، وهي من إعداد باحثين في OPPO Research Institute وPicUp.ai وXmotors.
أقنعة ذكية آلية
كما يقدّم SPG-IM شبكة تنقيح تعتمد على تحويل البؤرة التكيّفي (AFT)، ويمكنها معالجة التفاصيل المحلية والسياق العام كلًّا على حدة، بما يتيح إنشاء «أقنعة ذكية».

قد يساعد فهم سياق المشهد، في هذه الحالة «فتاة مع حصان»، على استخراج المقدّمة بسهولة أكبر مقارنةً بالأساليب السابقة.
وجاء في الدراسة:
«نعتقد أن التمثيلات البصرية المستمدة من مهمة تحويل المرئيات إلى نصوص، مثل وصف الصور، تركّز على إشارات أكثر شمولًا من الناحية الدلالية للعلاقات بين (أ) كائن وكائن، و(ب) كائن والبيئة المحيطة، وذلك لتوليد أوصاف تغطي المعلومات العامة والتفاصيل المحلية معًا. وإضافة إلى ذلك، يمكن جمع التسميات النصية بكميات ضخمة وبتكلفة منخفضة جدًا، مقارنةً بالتعليقات التوضيحية المكلفة على مستوى البكسل في عزل الصور.»
يُدرَّب فرع SPD في البنية تدريبًا مسبقًا مشتركًا مع مفكّك الترميز النصي القائم على المحوّلات VirTex التابع لـ University of Michigan، والذي يتعلم تمثيلات بصرية من تعليقات توضيحية كثيفة دلاليًا.

يدرّب VirTex الشبكات الالتفافية (ConvNet) والمحوّلات معًا باستخدام أزواج من الصور والتعليقات التوضيحية، وينقل المعارف المكتسبة إلى مهام الرؤية اللاحقة، مثل اكتشاف الأجسام. المصدر: https://arxiv.org/pdf/2006.06666.pdf
ومن بين اختبارات أخرى ودراسات استئصالية، اختبر الباحثون SPG-IM مقارنةً بأحدث الأساليب القائمة على القناع الثلاثي، وهي Deep Image Matting (DIM)، وIndexNet، وContext-Aware Image Matting (CAM)، وGuided Contextual Attention (GCA)، وFBA، وSemantic Image Matting (SIM).
وشملت الأطر السابقة الأخرى التي اختُبرت مناهج لا تعتمد على خرائط التقسيم الثلاثي، هي LFM وHAttMatting وMODNet. ولضمان عدالة المقارنة، جرى تكييف أساليب الاختبار وفقًا لاختلاف المنهجيات؛ وحيثما لم تتوفر الشيفرة، أُعيد تنفيذ تقنيات الورقة البحثية استنادًا إلى البنية المعمارية الموصوفة.
وجاء في الدراسة الجديدة:
«يتفوّق SPG-IM الخاص بنا بفارق كبير على جميع الأساليب المنافسة التي لا تعتمد على الخريطة الثلاثية ([LFM], و[HAttMatting], و[MODNet]). وفي الوقت نفسه، يُظهر نموذجنا تفوقًا ملحوظًا على أحدث الأساليب المعتمدة على الخريطة الثلاثية والموجّهة بالأقنعة، وفقًا للمقاييس الأربعة كلها في مجموعات البيانات العامة (أي Composition-1K وDistinction-646 وHuman-2K)، وكذلك في معيارنا Multi-Object-1K.»
وتضيف الدراسة:
«يمكن ملاحظة أن أسلوبنا يحافظ على التفاصيل الدقيقة (مثل أطراف الشعر والقوام الشفاف والحدود) من دون الاستعانة بخريطة ثلاثية. وعلاوة على ذلك، يستطيع SPG-IM الخاص بنا الحفاظ على اكتمال دلالي عام أفضل مقارنةً بنماذج أخرى منافسة لا تعتمد على الخريطة الثلاثية.»


نُشر للمرة الأولى في 24 أبريل 2022.