
زاوية Anderson
تحرير متسق لمحتوى الفيديو بالذكاء الاصطناعي باستخدام مدخلات موجّهة بالنص

 أضف Unite.AI إلى مصادرك المفضلة على Google
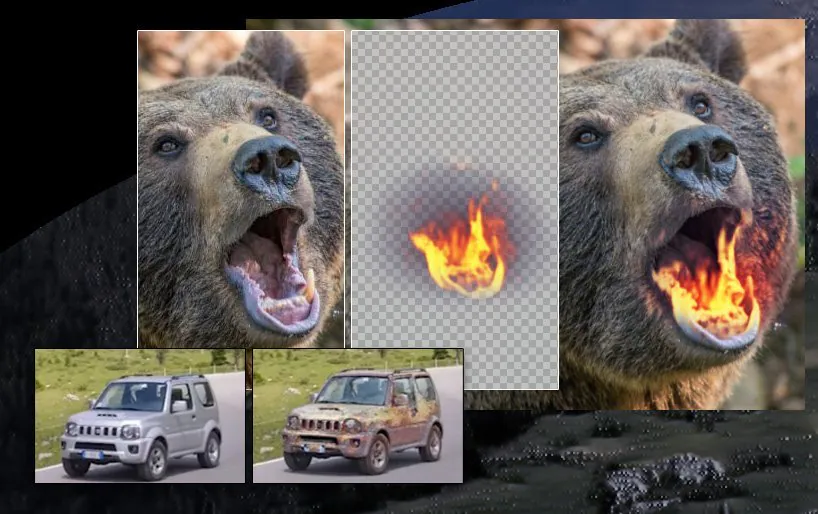
النقاط الرئيسيةيتيح Text2Live إجراء تعديلات متسقة على الفيديو من خلال مطالبات نصية دون معالجة كل إطار…
عرض المزيد
- يتيح Text2Live إجراء تعديلات متسقة على الفيديو من خلال مطالبات نصية دون معالجة كل إطار على حدة.
- يستخدم النظام أطلسًا عصبيًا طبقيًا لتطبيق التعديلات مرة واحدة عبر الجدول الزمني الكامل للفيديو.
- يقوم Text2Live بأتمتة عمليات القناع والتركيب، مما يلغي الحاجة إلى التتبع الدوار أو الشاشات الخضراء.
في حين أن مجتمع التأثيرات البصرية المحترف متشوق – وأحيانًا يشعر بالتهديد – من الابتكارات الجديدة في توليد الصور والفيديو، فإن عدم وجود استمرارية زمنية في معظم مشاريع تحرير الفيديو القائمة على الذكاء الاصطناعي يؤدي إلى حصر العديد من هذه الجهود في المجال «المخدّر» بصريًا، مع أنسجة سطحية وبنى تتلألأ وتتغير سريعًا، وتأثيرات غير متسقة وتعامل تقني خشن يذكّرنا بـالعصر الفوتوكيميائي للتأثيرات البصرية.
إذا كنت تريد تغيير شيء ما في فيديو لا يدخل في نطاق Deepfakes (أي فرض هوية جديدة على لقطات موجودة لشخص)، فإن معظم الحلول الحالية تعمل تحت قيود شديدة، من حيث الدقة المطلوبة للتأثيرات البصرية بجودة الإنتاج الاحترافي.
استثناء واحد هو العمل الجاري لجماعة من الأكاديميين في معهد وايزمان للعلوم. في عام 2021، أعلن ثلاثة من باحثيه، بالتعاون مع Adobe (ADBE )، طريقة جديدة لتفكيك الفيديو وإسقاط خريطة داخلية متسقة، أي أطلس عصبي متعدد الطبقات، على مخرجات مركبة تتضمن قنوات ألفا واتساقًا زمنيًا.
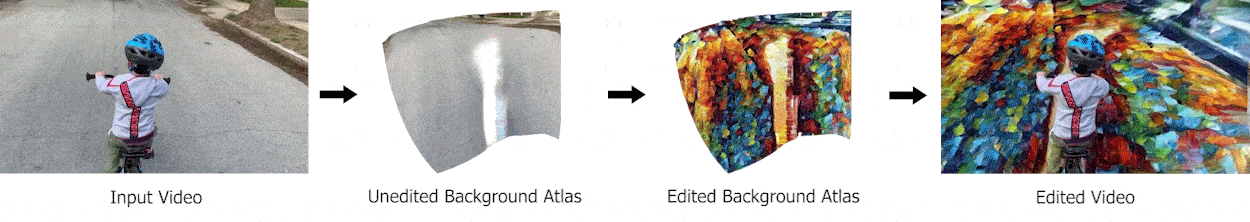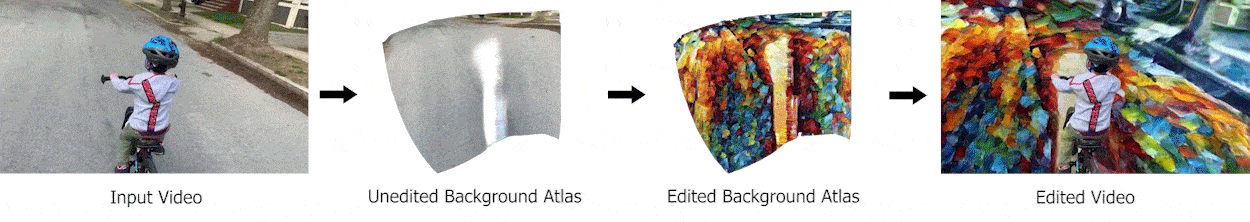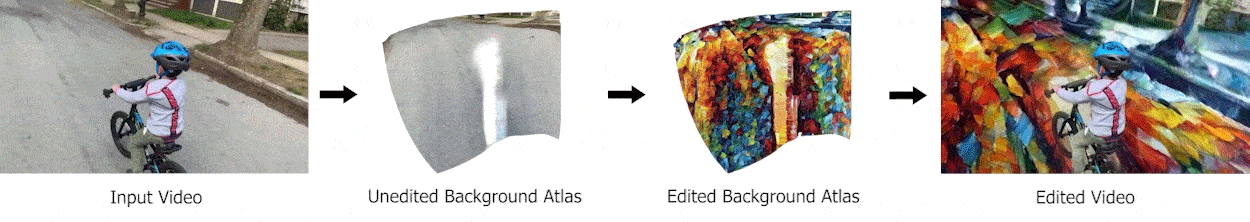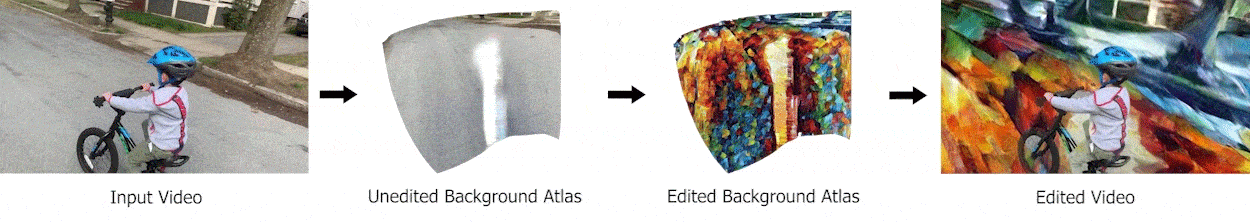
من الورقة البحثية لعام 2021: تقدير لعبور الطريق الكامل في اللقطة الأصلية يتم تحريره بواسطة شبكة عصبية بطريقة تقليدية كانت تتطلب عمل مكثف من التحويط ومطابقة الحركة. ولأن شبكات منفصلة تعالج الخلفية والمقدمة، تكون الأقنعة تلقائية بالفعل. المصدر: https://layered-neural-atlases.github.io/
على الرغم من أن هذا يقع في مجال التدفق البصري في مسارات عمل VFX، إلا أن الخريطة العصبية المتعددة الطبقات لا تملك مكافئ مباشر في خطوط أنابيب CGI التقليدية، لأنها تشكل في الأساس “خريطة للأنسجة السطحية عبر الزمن” يمكن إنتاجها وتحريرها من خلال طرق برمجية تقليدية. في الصورة الثانية في الصورة أعلاه، يتم تمثيل سطح الطريق (بصورة مجازية) على مدار زمني الفيديو بالكامل. التغيير في الصورة الأساسية (الصورة الثالثة من اليسار في الصورة أعلاه) ينتج تغييرًا متسقًا في الخلفية.
تُظهر الصور لخريطة العصبية المطوية أعلاه فقط إطارات فردية تم تفسيرها؛ التغييرات المتسقة في أي إطار فيديو يتم نقشه إلى الإطار الأصلي، مع الحفاظ على أي إخفاء ضروري وتأثيرات أخرى مطلوبة للمشهد، مثل الظلال أو الانعكاسات.
تستخدم الهندسة الأساسية بيرسيبترون متعدد الطبقات (MLP) لتمثيل الخريطة العصبية المبسوطة، قنوات ألفا والخرائط، جميعها يتم تحسينها معًا، وبالكامل في مساحة ثنائية الأبعاد، مما يلغي الحاجة إلى معرفة مسبقة بنقاط الهندسة ثلاثية الأبعاد كما في NeRF، وخرائط العمق، والمصاحب التقليدية لCGI.
يمكن أيضًا تعديل الخريطة المرجعية للأجسام الفردية بطرق موثوقة:
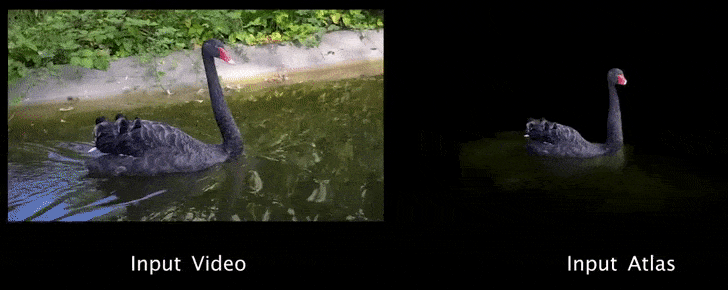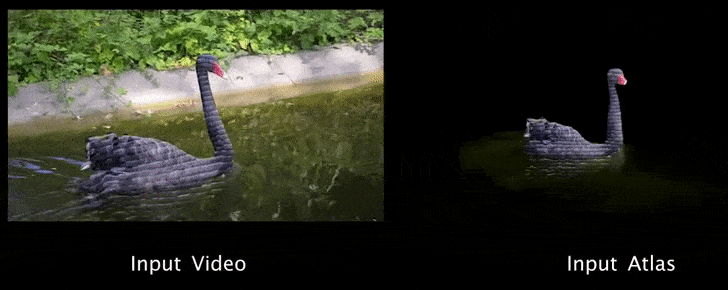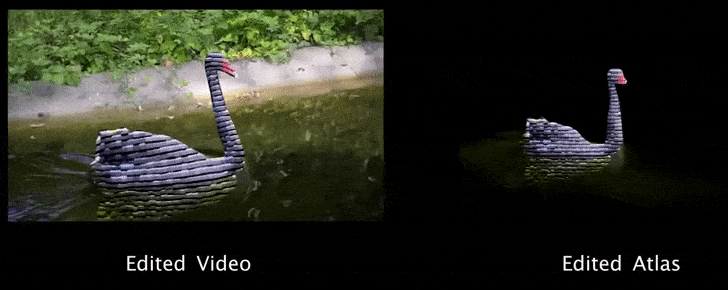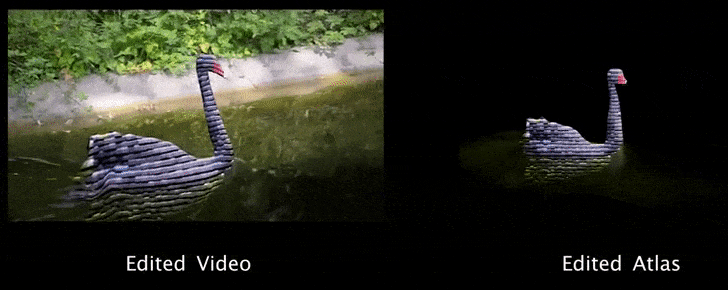
تغيير متسق في كائن متحرك تحت إطار العمل لعام 2021. مصدر: https://www.youtube.com/watch?v=aQhakPFC4oQ
بشكل أساسي، يجمع نظام عام 2021 بين محاذاة الهندسة، ومطابقة الحركة، ورسم الخرائط، وإعادة تطبيق الأنسجة السطحية و روتوسكوبينغ في عملية عصبية منفصلة.
Text2Live
الباحثون الثلاثة الأصليون للورقة البحثية لعام 2021، بالاشتراك مع NVIDIA (NVDA ) Research، من بين المساهمين في ابتكار جديد في التقنية التي تجمع بين قوة الخريطة العصبية المتعددة الطبقات وتكنولوجيا CLIP الموجهة بالنص التي عادت إلى الأضواء هذا الأسبوع مع إطلاق OpenAI لإطار DALL-E 2.
سميت الهندسة الجديدة باسم Text2Live، و تتيح للمستخدم النهائي إنشاء تعديلات محلية على محتوى فيديو حقيقي بناءً على نصوص محفزة:
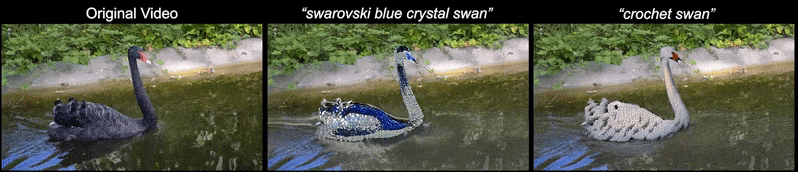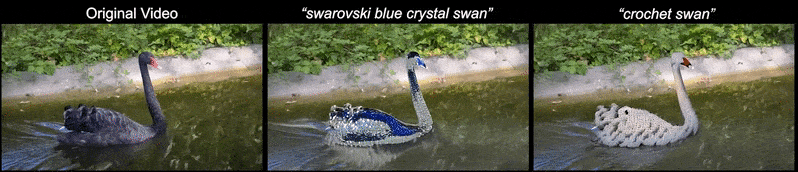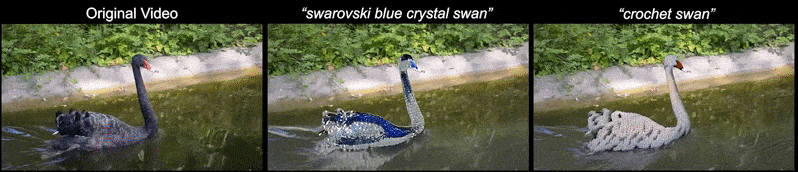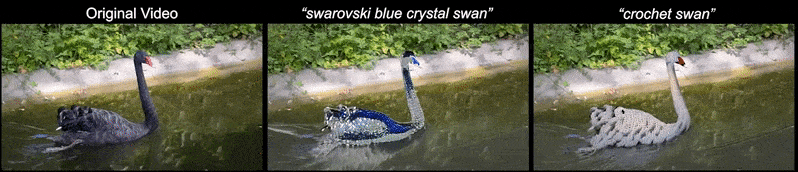
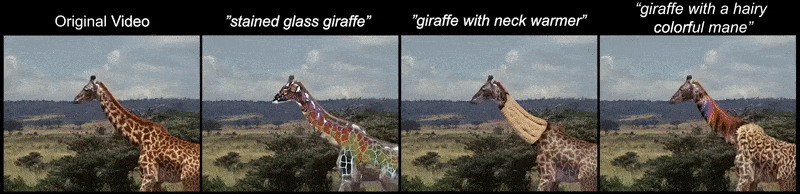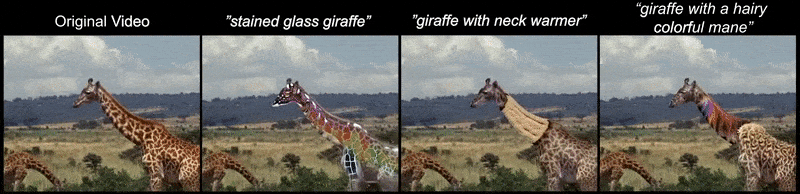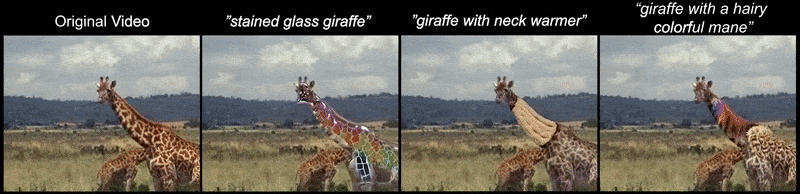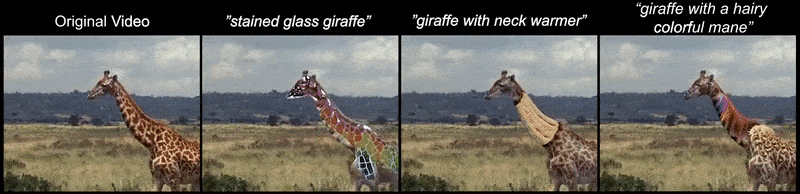
مثالان على تحرير المقدمة. للحصول على دقة ووضوح أفضل، راجع الفيديوهات الأصلية على https://text2live.github.io/sm/pages/video_results_atlases.html
يقدم Text2Live تحريرًا دلاليًا ومحليًا بدرجة عالية دون استخدام مولّد مدرَّب مسبقًا، من خلال استخدام قاعدة بيانات داخلية خاصة بالقطعة الفيديوية المتأثرة.

تحويلات الخلفية والكائن (الأمامي) تحت Text2Live. مصدر: https://text2live.github.io/sm/pages/video_results_atlases.html
لا تتطلب التقنية أقنعة يقدمها المستخدم، كما في مسار العمل المعتاد للتحويط أو الشاشة الخضراء. بل تقدّر خرائط الصلة باستخدام تقنية تمهيد تستند إلى بحث عام 2021 من كلية علوم الحاسوب بجامعة تل أبيب وFacebook AI Research (FAIR).

خرائط الإخراج التي تم إنشاؤها بواسطة نموذج انتباه عام قائم على Transformer.
الورقة البحثية الجديدة بعنوان Text2LIVE: Text-Driven Layered Image and Video Editing. يشارك الفريق الأصلي مع Omer Bar-Tal من Weizmann و Yoni Kasten من NVIDIA Research.
الهندسة
يتكون Text2Live من مولد مدرب على صورة مدخلة واحدة ونصوص محفزة. يوفر نموذج التدريب المسبق التبايني للغة والصورة (CLIP)، المدرّب مسبقًا على 400 مليون زوج نص/صورة مواد بصرية متعلقة التي يمكن من خلالها تفسير التحويلات التي يتم إدخالها من قبل المستخدم.

يقبل المولد صورة مدخلة (إطار) وينتج طبقة RGBA الهدف التي تحتوي على معلومات اللون والتعتيم. ثم يتم تكوين هذه الطبقة في اللقطة الأصلية مع تعديلات إضافية.

توفر قناة ألفا في طبقة RGBA المولدة وظيفة تركيب داخلية دون اللجوء إلى مسارات عمل تقليدية تستخدم برمجيات قائمة على البكسلات، مثل After Effects.
بالتدريب على الصور الداخلية ذات الصلة بالفيديو أو الصورة المستهدفة، يتجنب Text2Live الحاجة إلى إجراء التحويل العكسي للصورة المدخلة إلى الفضاء الكامن لشبكة خصومية توليدية (GAN)، وهي ممارسة لا تزال بعيدة عن الدقة الكافية لمتطلبات تحرير الفيديو الاحترافي. كما يتجنب استخدام نموذج انتشار أكثر دقة وقابلية للضبط، لكنه لا يستطيع الحفاظ على الوفاء للفيديو المستهدف.

تعديلات تحويلية مختلفة بناءً على نصوص محفزة من Text2Live.
اعتمدت المناهج السابقة أساليب قائمة على نشر التعديلات أو أساليب قائمة على التدفق البصري. منذ أن تكون هذه التقنيات في بعض الشكل قائمًا على الإطارات، فإن أي منها غير قادر على إنشاء مظهر زمني متسق للتغييرات في الفيديو الإخراجي. توفر الخريطة العصبية المتعددة الطبقات، بدلاً من ذلك، مساحة واحدة للتعامل مع التغييرات، والتي يمكن أن تظل وفية للتغيير الملتزم مع تقدم الفيديو.
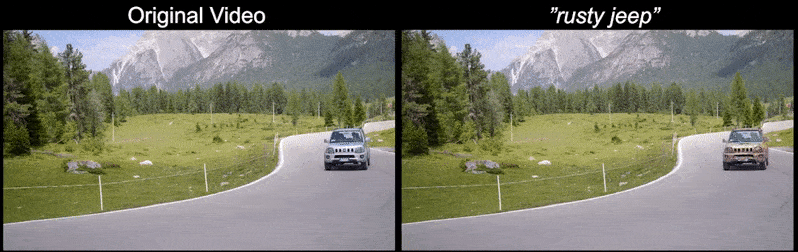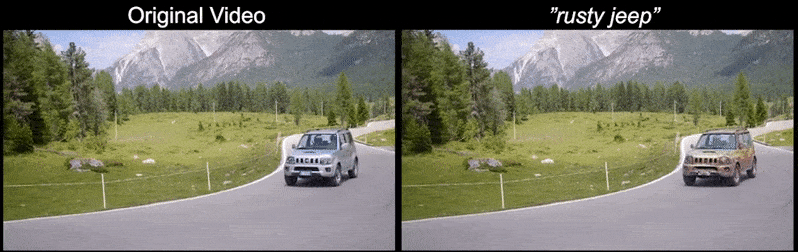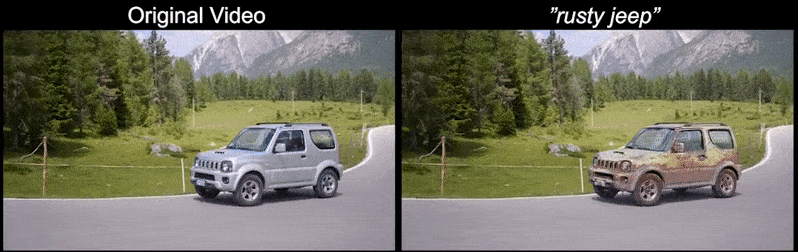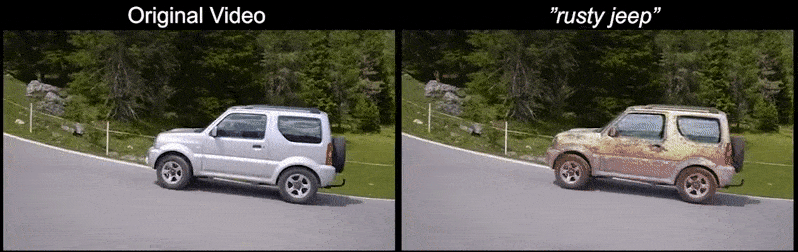
لا توجد وميض أو هلوسات عشوائية: Text2Live يحصل على تفسير للنص المحفز ‘جيب صدئ’، ويطبقه مرة واحدة على الخريطة العصبية المتعددة الطبقات للسيارة في الفيديو، بدلاً من إعادة تشغيل التحويل لكل إطار مفسر.

سير عمل تحويل Text2Live المتسق لجيب إلى حطام صدئ.
Text2Live أقرب إلى تحقيق نقلة في التركيب القائم على الذكاء الاصطناعي منه في مجال توليد الصور من النص، الذي اجتذب اهتمامًا كبيرًا هذا الأسبوع مع إطلاق الجيل الثاني من إطار DALL-E من OpenAI. ويمكن لهذا الإطار إدراج الصور المستهدفة في عملية التحويل، لكن قدرته على تعديل صورة مباشرة تظل محدودة، إلى جانب رقابة بيانات التدريب وتطبيق المرشحات، المصممة لمنع إساءة الاستخدام من جانب المستخدمين.
يتيح Text2Live للمستخدم النهائي استخراج أطلس وتحريره في مرور واحد داخل بيئات قائمة على البكسلات وعالية التحكم، مثل Photoshop، وربما حتى أطر أكثر تجريدًا لتوليد الصور مثل NeRF. ثم يُعاد الأطلس إلى بيئة موجّهة بصورة صحيحة لا تعتمد على التقدير ثلاثي الأبعاد أو أساليب CGI التي تعود إلى الطرق القديمة.
علاوة على ذلك، يزعم مؤلفو Text2Live أنه الإطار المقابل الأول الذي يحقق إنشاء الأقنعة والتركيب بطريقة أوتوماتيكية كاملة.
نُشر لأول مرة في 7 أبريل 2022.





