
زاوية Anderson
يمكن للذكاء الاصطناعي تخمين سنة الصورة من أعمار الأشخاص

 أضف Unite.AI إلى مصادرك المفضلة على Google
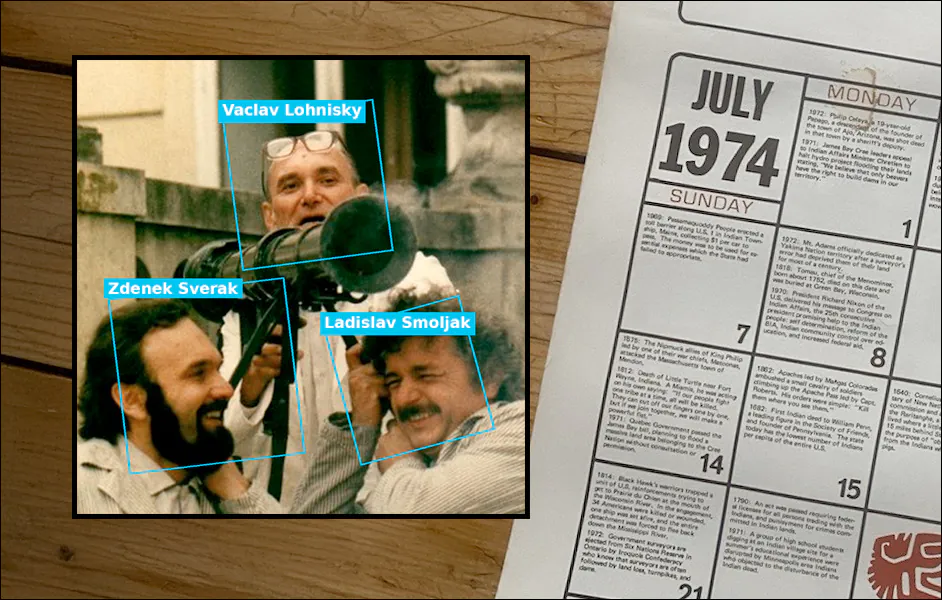
بين تخمين العمر مع السنوات الميلادية المعروفة لتحقيق نتائج أفضل من الطرق القائمة على المشهد. كان من السهل تخمين تاريخ
تظهر الأبحاث الجديدة أن الذكاء الاصطناعي يمكنه استخدام وجوه الأشخاص لتخمين سنة الصورة ، عن طريق الجمع الصورة في الماضي، لأن أسلوب الشعر والملابس كان تتطور المنصة بسرعة.انتهت هذه الدورة السريعة من التغيير منذ حوالي ثلاثين عامًا ، مما يجعل من الصعب تخمين سنة الصورة من خلال النظر إلى الشعر أو الملابس. من الممكن أيضًا تحديد تاريخ الصور والأفلام بناءً على دقة اللون وخصائص الفيلم. لم يكن عليك أن تكون خبيرًا في هذا المجال ، ولكن إذا كنت تشاهد الأفلام القديمة ، سوف تتعرف على الدلالات الثقافية (مثل


العمر الوجهي كمرجع
في مجال رؤية الحاسوب، والعديد من المجالات الأخرى (مثل الطب الشرعي، ومعالجة الأرشيف، والصحافة، وهندسة قواعد البيانات، وغيرها)، يُعدّ تحديد عمر الصورة هدفًا بالغ الأهمية، نظرًا لافتقار العديد من المجموعات الرقمية والمادية إلى بيانات تعريفية دقيقة أو احتوائها على معلومات غير صحيحة. لذا، سيكون من المفيد لو استخدم نظام الذكاء الاصطناعي الاصطناعي يمكنه مراجعةالصور بنفس الطريقة التي ننظر بها إلى مجموعتنا التاريخية ، وقول “نعم ، هذا كان عندما…”. السؤال هو ، ما يمكن أن يكون الحافز ، في غياب الدلالات المعتادة؟ تقدم ورقة بحثية جديدة من جمهورية التشيك نقطة انطلاق أولية لهذا

نماذج حديثة لتقدير العمر وآليات زمنية قائمة على المهنة لتحديد سنة التقاط الصورة. تُظهر تجاربنا أن تجميع الأدلة من وجوه متعددة يُحسّن الأداء باستمرار، لا سيما في الصور.
التي تحتوي على عدة أشخاص يمكن التعرف عليهم.’ الورقة الجديدة بعنوان ، وهي من تأليف باحثَين من جامعة التكنولوجيا
التشيكية في طريق تجميع العمر الوجهيبراغ ، مع وعد بنشر الكود والبيانات في وقت لاحق. تاريخ الصورة عن
الطريقة
لتحديد تاريخ الصورة، يقوم نظام الباحثين بفحص كل وجه مُحدد ومحاولة تخمين هويته، باستخدام قاعدة البيانات المذكورة سابقًا. ثم يعمل النظام عكسيًا لتحديد السنة الأكثر ترجيحًا التي تتوافق مع تلك الأعمار:

الوجه لإنتاج تقدير نهائي لوقت التقاط الصورة. نظرًا لوجود العديد من الاحتمالات، يفترض النظام أن الوجوه مستقلة، وأن مظهر كل وجه يعتمد على فقطعلى هويته وتاريخ الصورة. تقدير تاريخ الصورة ، يستخدم النظام أولاً نموذج cvut-002 لتقدير عمر كل وجه ، ثم يحول هذا التخمين إلى تاريخ الصورة المحتمل bằng cách إضافة العمر إلى سنة الميلاد. كل هوية تمثلها غموشة متوسطة محسوبة من الصور


البيانات والاختبارات
استخدم الباحثون قاعدة بيانات CSFD لإنشاء مجموعة جديدة أسموها CSFD-1.6M. تم بناء هذهالقاعدة من مشاهد تضم عدة أشخاص ، مع كل وجه مصحوب بهوية وسنة. تم استخدام سنوات إصدار الأفلام من قاعدة بيانات الأفلام التشيكية والسلوفاكية لتقدير تاريخ الصورة ، مع مطابقة كل شخص في الصورة لملف عام يحتوي على سنة ميلاده و صورة. بعد ذلك ، تم مطابقة كل وجه في الصورة مع واحدة من الهويات المعروفة ، باستخدام ArcFace لإنشاء غموشات الوجه ، و حساب غموشة متوسطة لكل هوية. ثم تم استخدام خوارزمية Hungarian لتعيين الوجوه للهويات بمقارنة تشابه الغموشات ، مع تعديلات عند عدم مطابقة عدد الوجوه المحتدة مع عدد الأفراد المعروفين. إحصائيات من قاعدة بيانات CSFD-1.6M ، تفاصيل

مجموعة الهويات المتاحة. تم رفض المطابقات إذا كان التشابه منخفضًا جدًا أو إذا كان العمر المقدر يختلف بشكل كبير عن العمر الحقيقي ، مع السماح بتحمل أكبر للأفراد الأكبر سنًا ، و لم يتم فلتر
، مما أثبت أنه فعال بشكل جيد في الممارسة. من ناحية أخرى ، كان هناك نموذج أساسي قام بتعيين كل وجه بشكل مستقل وجمع تقديرات السنة القائمة على العمر ، دون النظر
تحديد الوجوه حسب الجودة أو الحجم. ويشير الباحثون إلى تفوق مجموعتهم على مجموعة IMDB-WIKI: “قاعدة بياناتنا ليست أكبر حجمًا فحسب، بل تتكون أيضًا من مشاهد متعددة الأشخاص، مما يسمح بدراسة تجميع المعلومات من وجوه متعددة.” قارن الباحثون عدة إصدارات من نظام تحديد الهوية لفهم مصدر تحسيناته: افترض أحد إصدارات النموذج معرفة كاملة بهوية الشخص الموجود في الصورة، مما يوفر عتبة أداء أعلى من خلال إزالة أي شك في تحديد الهوية. واختار نموذج أبسط التكوين الأكثر احتمالًا للهوية دون تهميش البدائل. الوجوه ،لتحديد مدى معقولية الهويات المدمجة. اختبار جدوى استخدام بأكمله. تم تدريب نموذج منفصل لتقدير التاريخ مباشرة من المشهد
المقاييس والبيانات
كان متوسط الخطأالمطلق بين السنة المتوقعة والقيمة الحقيقية هو المقياس الرئيسي للتحقيق. تم تقسيم البيانات إلى خمسة أجزاء ، مع الحرص على ضمان الاحتفاظ بجميع الصور من الفيلم نفسه في المقطع نفسه. استُخدمت ثلاثة من هذه المقاطع للتدريب، وواحد للتأكيد، وواحد للاختبار. طُبّق هذا التدوير الخماسي لمنع الإفراط في التحسين. النماذج الوجه لم يتم تدريبها على هذه القاعدة ، لم يكن هناك حاجة لتقسيمها ، وبدلاً من ذلك ، تم تقييمها مباشرة على مجموعة CSFD-1.6M الكاملة. لمدة تم تدريب نموذج المشهد 200 دورة تحت خوارزمية Adam ، مع تصغير الصور إلى384×384.
النتائج
قسم قسم النتائج في الورقة بشكل غير عادي عبر عدة مؤشرات أداء ، بدون اختبار مركزي واحد. ومع ذلك ، سنقدم بعض النتائج الأكثر صلة هنا. أهم نتيجة ليست ، ولكن رقمًا واحدًا النمط: نماذج تجميع الوجوه (إصدارات كاملة خاصة) و Top-1) تتفوق بشكل مستمر على نموذج المشهد القوي في وجود شخصين أو أكثر من الأشخاص المعروفين – حتى لو تم تدريب نموذج المشهد مباشرة على تأثير البيانات.التقييم الباحثون السابقة الزمنية ، قارن عدة إصدارات من نموذجهم

زيادة عدد الوجوه ، ولكن النماذج التي تستخدم سابقة زمنية واقعية مثل السابقة العقدية تتأثر بشكل أقل. من أجل إظهار قيمة قاعدة بيانات CSFD-1.6M فيما وراء تاريخ الصورة ، تم اختبار القاعدة أيضًا كموارد مسبقة لغرض الأوسع لتقدير العمر الوجهي.

الخطأ المطلق (بمايونص و معيارية) على خمسة مجموعات اختبار لتقدير العمر ، مقارنة بين النماذج المسبقة على ImageNet و IMDB-WIKI و CSFD-1.6M. القيم الأقل تدل على أداء أفضل. CSFD-1.6M تنتج نتائج أفضل في جميع المجموعات.
الاستنتاج
على الرغم من أن الورقة الجديدة تصبح كثيفة و غير قابلة للقراءة للقارئ العادي ، فإن الموضوع المعالج هو واحد من أكثر المواضيع إثارة للاهتمام و الأهمية في الأدب حول الرؤية الحاسوبية – لا سيما لأنه يتقاطع بشكل ماهر مع الأنثروبولوجيا و الدراسات الثقافية ، حيث تكون الثوابت صعبة التحديد. * مثل تطور الموسيقى ، الذي تباطأ معدل تغيره. نشر لأولمرة
يوم الإثنين ، 10 نوفمبر 2025


