

Mô hình và nền tảng AI
Zero123++: Mô hình khuếch tán cơ sở tạo ảnh đa góc nhìn nhất quán từ một ảnh

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google

Điểm chínhZero123++ ghép sáu góc nhìn thành một hình ảnh để đảm bảo tính nhất quán 3D trong quá…
Xem thêm
- Zero123++ ghép sáu góc nhìn thành một hình ảnh để đảm bảo tính nhất quán 3D trong quá trình tạo nhiều góc nhìn.
- Nó giới thiệu cơ chế Scaled Reference Attention để bảo toàn kết cấu cục bộ từ hình ảnh đầu vào đơn lẻ.
- Mô hình sử dụng lịch trình nhiễu tuyến tính để cải thiện cấu trúc tổng thể so với lịch trình tỷ lệ tuyến tính.
Những năm gần đây đã chứng kiến sự phát triển nhanh chóng về hiệu suất, hiệu quả và khả năng tạo ra của các mô hình AI tạo sinh mới nổi, những mô hình này tận dụng các tập dữ liệu rộng lớn và các phương pháp tạo sinh khuếch tán 2D. Hiện nay, các mô hình AI tạo sinh có khả năng tạo ra nhiều loại nội dung 2D khác nhau và nội dung 3D ở một mức độ nhất định, bao gồm văn bản, hình ảnh, video, GIF và nhiều hơn nữa.
Trong bài viết này, chúng ta sẽ thảo luận về khuôn khổ Zero123++, một mô hình AI tạo sinh khuếch tán có điều kiện hình ảnh với mục tiêu tạo ra nhiều hình ảnh đa góc nhất quán từ một hình ảnh đầu vào đơn. Để tối đa hóa lợi thế từ các mô hình tạo sinh trước đó, khuôn khổ Zero123++ thực hiện nhiều kỹ thuật đào tạo và điều kiện để giảm thiểu lượng công việc cần thiết để tinh chỉnh từ các mô hình hình ảnh khuếch tán sẵn có. Chúng ta sẽ đi sâu vào kiến trúc, hoạt động và kết quả của khuôn khổ Zero123++ và phân tích khả năng của nó trong việc tạo ra nhiều hình ảnh đa góc chất lượng cao từ một hình ảnh đơn.
Zero123 và Zero123++: Giới Thiệu
Khuôn khổ Zero123++ là một mô hình AI tạo sinh khuếch tán có điều kiện hình ảnh với mục tiêu tạo ra nhiều hình ảnh đa góc nhất quán từ một hình ảnh đầu vào đơn. Khuôn khổ Zero123++ là một sự tiếp tục của khuôn khổ Zero123 hoặc Zero-1-to-3, khuôn khổ này tận dụng kỹ thuật tổng hợp hình ảnh từ góc nhìn mới mà không cần huấn luyện bổ sung trên ví dụ mới (zero-shot), mở đường cho các giải pháp mã nguồn mở chuyển một ảnh thành 3D. Mặc dù khuôn khổ Zero123++ mang lại hiệu suất hứa hẹn, nhưng các hình ảnh được tạo ra bởi khuôn khổ này có sự không nhất quán về mặt hình học và đó là lý do tại sao khoảng cách giữa các cảnh 3D và hình ảnh đa góc vẫn còn tồn tại.
Khuôn khổ Zero-1-to-3 đóng vai trò nền tảng cho nhiều khuôn khổ khác, bao gồm SyncDreamer, One-2-3-45, Consistent123 và nhiều hơn nữa, những khuôn khổ này thêm các lớp bổ sung vào khuôn khổ Zero123 để đạt được kết quả nhất quán hơn khi tạo ra hình ảnh 3D. Các khuôn khổ khác như ProlificDreamer, DreamFusion, DreamGaussian và nhiều hơn nữa theo một cách tiếp cận dựa trên tối ưu hóa để đạt được hình ảnh 3D bằng cách chưng cất một hình ảnh 3D từ các mô hình không nhất quán. Mặc dù các kỹ thuật này hiệu quả và tạo ra hình ảnh 3D thỏa mãn, nhưng kết quả có thể được cải thiện với việc thực hiện một mô hình khuếch tán cơ sở có thể tạo ra ảnh từ nhiều góc nhìn một cách nhất quán. Vì vậy, Zero123++ dựa trên Zero-1-to-3 và tinh chỉnh một mô hình khuếch tán cơ sở đa góc nhìn mới từ Stable Diffusion.
Trong khuôn khổ Zero-1-to-3, mỗi hình ảnh mới được tạo ra độc lập và cách tiếp cận này dẫn đến sự không nhất quán giữa các hình ảnh được tạo ra vì các mô hình khuếch tán có tính chất lấy mẫu. Để giải quyết vấn đề này, khuôn khổ Zero123++ áp dụng một cách tiếp cận bố cục gạch, với đối tượng được bao quanh bởi sáu hình ảnh thành một hình ảnh đơn và đảm bảo mô hình hóa chính xác cho phân phối liên kết của nhiều hình ảnh của một đối tượng.
Một thách thức lớn khác mà các nhà phát triển gặp phải khi làm việc với khuôn khổ Zero-1-to-3 là khuôn khổ này không tận dụng tối đa các khả năng được cung cấp bởi Stable Diffusion và điều này dẫn đến sự không hiệu quả và tăng chi phí. Có hai lý do chính tại sao khuôn khổ Zero-1-to-3 không thể tối đa hóa các khả năng được cung cấp bởi Stable Diffusion
- Khi đào tạo với điều kiện hình ảnh, khuôn khổ Zero-1-to-3 không kết hợp các cơ chế điều kiện cục bộ hoặc toàn cầu được cung cấp bởi Stable Diffusion một cách hiệu quả.
- Trong quá trình đào tạo, khuôn khổ Zero-1-to-3 sử dụng độ phân giải giảm, một cách tiếp cận trong đó độ phân giải đầu ra được giảm xuống dưới độ phân giải đào tạo và điều này có thể giảm chất lượng tạo hình ảnh cho các mô hình Stable Diffusion.
Để giải quyết những vấn đề này, khuôn khổ Zero123++ thực hiện một loạt các kỹ thuật điều kiện để tối đa hóa việc sử dụng tài nguyên được cung cấp bởi Stable Diffusion và duy trì chất lượng tạo hình ảnh cho các mô hình Stable Diffusion.
Cải Thiện Điều Kiện và Nhất Quán
Trong một nỗ lực nhằm cải thiện điều kiện hình ảnh và nhất quán hình ảnh đa góc, khuôn khổ Zero123++ đã thực hiện các kỹ thuật khác nhau, với mục tiêu chính là tái sử dụng các kỹ thuật trước đó từ mô hình Stable Diffusion đã được đào tạo trước.
Tạo Hình Ảnh Đa Góc
Chất lượng không thể thiếu của việc tạo ra nhiều hình ảnh đa góc nhất quán nằm ở việc mô hình hóa phân phối liên kết của nhiều hình ảnh một cách chính xác. Trong khuôn khổ Zero-1-to-3, sự tương quan giữa các hình ảnh đa góc bị bỏ qua vì khuôn khổ này mô hình hóa phân phối biên có điều kiện độc lập và riêng biệt cho mỗi hình ảnh. Tuy nhiên, trong khuôn khổ Zero123++, các nhà phát triển đã chọn một cách tiếp cận bố cục gạch, trong đó sáu hình ảnh được ghép thành một hình ảnh đơn để tạo hình ảnh đa góc nhất quán và quá trình này được trình bày trong hình ảnh sau.
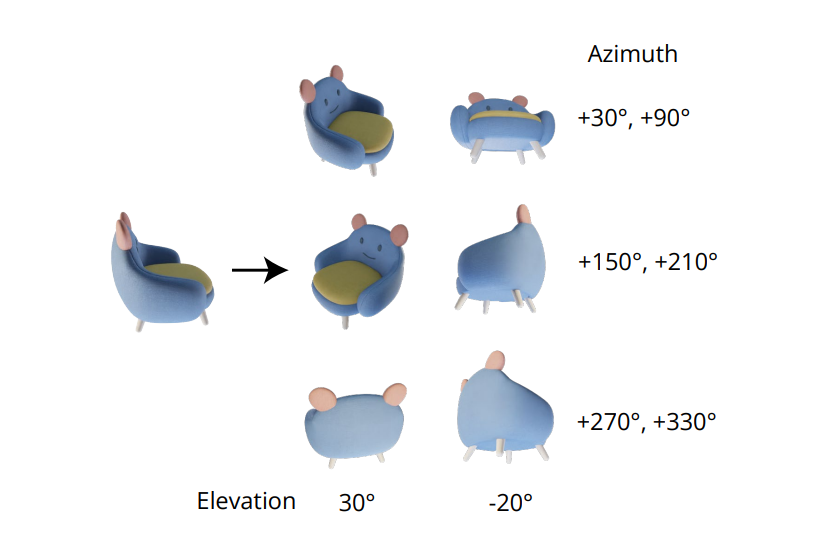

Hơn nữa, đã được nhận thấy rằng hướng đối tượng có xu hướng làm rõ khi đào tạo mô hình trên các tư thế máy ảnh và để ngăn chặn sự làm rõ này, khuôn khổ Zero-1-to-3 đào tạo trên các tư thế máy ảnh với các góc nâng và góc azimut tương đối với đầu vào. Để thực hiện cách tiếp cận này, cần phải biết góc nâng của tầm nhìn của đầu vào và sau đó sử dụng thông tin này để xác định tư thế tương đối giữa góc nhìn mới và góc nhìn đầu vào. Để xác định góc nâng này, các hệ thống thường bổ sung mô-đun ước lượng góc nâng, nhưng cách đó có thể gây thêm sai số trong quy trình xử lý.
Lịch Trình Tiếng Ồn
Lịch trình tuyến tính có tỷ lệ, lịch trình tiếng ồn ban đầu cho Stable Diffusion tập trung chủ yếu vào các chi tiết cục bộ, nhưng như có thể thấy trong hình ảnh sau, nó có rất ít bước với tỷ lệ tín hiệu trên tiếng ồn thấp.


Những bước này có tỷ lệ tín hiệu trên tiếng ồn thấp xảy ra sớm trong giai đoạn làm sạch tiếng ồn, một giai đoạn quan trọng để xác định cấu trúc tần số thấp toàn cầu. Giảm số bước trong giai đoạn làm sạch tiếng ồn, dù trong quá trình suy luận hay huấn luyện, thường dẫn đến sự thay đổi cấu trúc lớn hơn. Mặc dù thiết lập này lý tưởng cho việc tạo hình ảnh đơn, nhưng nó hạn chế khả năng của khuôn khổ trong việc đảm bảo sự nhất quán toàn cục giữa các góc nhìn khác nhau. Để khắc phục, Zero123++ tinh chỉnh mô hình LoRA trên Stable Diffusion 2 v-prediction để thực hiện một tác vụ thử nghiệm đơn giản, với kết quả bên dưới.
Chú Ý Tham Chiếu Có Thang Đổi cho Điều Kiện Cục Bộ
Hình ảnh đầu vào đơn hoặc hình ảnh điều kiện trong khuôn khổ Zero-1-to-3 được kết hợp với các đầu vào tiếng ồn trong chiều đặc trưng để tạo tiếng ồn cho điều kiện hình ảnh.
Sự kết hợp này dẫn đến sự không chính xác về sự tương ứng không gian điểm-điểm giữa hình ảnh mục tiêu và hình ảnh đầu vào. Để cung cấp đầu vào điều kiện cục bộ chính xác, khuôn khổ Zero123++ sử dụng một cách tiếp cận gọi là Chú Ý Tham Chiếu Có Thang Đổi, trong đó chạy một mô hình UNet làm sạch tiếng ồn trên một hình ảnh tham chiếu bổ sung, sau đó thêm các ma trận giá trị và khóa tự chú ý từ ảnh tham chiếu vào các lớp chú ý tương ứng khi đầu vào của mô hình được làm sạch tiếng ồn.

Cách tiếp cận Chú Ý Tham Chiếu Có Thang Đổi có khả năng hướng dẫn mô hình khuếch tán để tạo ra hình ảnh chia sẻ kết cấu giống với hình ảnh tham chiếu, và nội dung ngữ nghĩa mà không cần tinh chỉnh. Với tinh chỉnh, cách tiếp cận Chú Ý Tham Chiếu Có Thang Đổi mang lại kết quả vượt trội khi biểu diễn tiềm ẩn được điều chỉnh theo thang.

Điều Kiện Toàn Cầu: FlexDiffuse
Trong cách tiếp cận Stable Diffusion ban đầu, các bản nhúng văn bản là nguồn duy nhất cho các bản nhúng toàn cầu, và cách tiếp cận này sử dụng khuôn khổ CLIP làm trình mã hóa văn bản để thực hiện chú ý chéo giữa các embedding văn bản và biểu diễn tiềm ẩn của mô hình. Nguyên bản gọi đây là cross-examinations, nhưng trong ngữ cảnh này thuật ngữ chỉ chú ý chéo. Nhờ sự căn chỉnh giữa không gian văn bản và ảnh CLIP, các nhà phát triển có thể dùng tín hiệu đó để điều kiện hóa ảnh ở mức toàn cục.
Khuôn khổ Zero123++ đề xuất sử dụng một biến thể có thể đào tạo của cơ chế hướng dẫn tuyến tính để kết hợp điều kiện hình ảnh toàn cầu vào khuôn khổ với mức tinh chỉnh tối thiểu cần thiết. Khi thiếu điều kiện hóa ảnh toàn cục, nội dung ở vùng nhìn thấy tương ứng với ảnh đầu vào vẫn đạt chất lượng thỏa đáng. Tuy nhiên, chất lượng ở các vùng không nhìn thấy giảm mạnh vì mô hình không suy ra được ngữ nghĩa tổng thể của đối tượng.

Kiến Trúc Mô Hình
Khuôn khổ Zero123++ được đào tạo với mô hình Stable Diffusion 2v làm nền tảng sử dụng các cách tiếp cận và kỹ thuật khác nhau được đề cập trong bài viết. Khuôn khổ Zero123++ được đào tạo trước trên tập dữ liệu Objaverse được kết xuất với ánh sáng HDRI ngẫu nhiên.
Khuôn khổ này cũng áp dụng cách tiếp cận lịch trình đào tạo phân giai đoạn được sử dụng trong khuôn khổ Stable Diffusion Image Variations trong một nỗ lực nhằm giảm thiểu lượng tinh chỉnh cần thiết và bảo tồn càng nhiều càng tốt trong mô hình Stable Diffusion đã huấn luyện trước đó.Quy trình được chia thành các giai đoạn. Ở giai đoạn đầu, hệ thống tinh chỉnh các ma trận khóa và giá trị (KV) trong những lớp chú ý chéo và tự chú ý của Stable Diffusion, dùng AdamW, 1.000 bước warm-up và lịch tốc độ học cosine đạt tối đa 7×10^-5. Giai đoạn hai dùng tốc độ học hằng số rất thận trọng, 2.000 bước warm-up và phương pháp Min-SNR để tăng hiệu quả huấn luyện.
Zero123++: Kết Quả và So Sánh Hiệu Suất
Hiệu Suất Chất Lượng
Để đánh giá hiệu suất của khuôn khổ Zero123++ dựa trên chất lượng tạo ra, nó được so sánh với SyncDreamer và Zero-1-to-3-XL, hai khuôn khổ hàng đầu trong lĩnh vực tạo nội dung. Bốn ảnh đầu vào gồm mèo đồ chơi chạy điện lấy từ Objaverse với phần phía sau khó xác định, bình chữa cháy, chó ngồi trên tên lửa do SDXL tạo và tranh minh họa anime. Góc nâng được ước lượng bằng phương pháp One-2-3-4-5, còn SAM được dùng để xóa nền. Kết quả cho thấy Zero123++ tạo ảnh đa góc nhìn chất lượng cao, nhất quán và khái quát tốt cả với minh họa 2D ngoài phân phối lẫn ảnh do AI tạo.


Phân Tích Định Lượng
Để so sánh định lượng khuôn khổ Zero123++ với các khuôn khổ Zero-1-to-3 và Zero-1-to-3-XL hiện tại, các nhà phát triển đánh giá điểm tương đồng cảm nhận đã học giữa các mảng ảnh (LPIPS) của các mô hình này trên tập dữ liệu phân chia xác thực, một tập con của tập dữ liệu Objaverse. Nhóm phát triển lần lượt ghép các ảnh tham chiếu chuẩn và sáu ảnh được tạo thành lưới rồi tính LPIPS. Kết quả bên dưới cho thấy Zero123++ đạt hiệu suất tốt nhất trên tập kiểm định.

Đánh Giá Từ Văn Bản Sang Đa Góc
Để đánh giá khả năng của khuôn khổ Zero123++ trong việc tạo nội dung từ văn bản sang đa góc, các nhà phát triển đầu tiên sử dụng khuôn khổ SDXL với các lời nhắc văn bản để tạo ra một hình ảnh, sau đó sử dụng khuôn khổ Zero123++ trên hình ảnh được tạo ra. Khác với Zero-1-to-3 vốn không bảo đảm tạo ảnh đa góc nhìn nhất quán, Zero123++ trả về các ảnh nhất quán, chân thực và giàu chi tiết nhờ quy trình văn bản→hình ảnh→đa góc nhìn.

Zero123++ Depth ControlNet
Ngoài khuôn khổ Zero123++ cơ bản, các nhà phát triển cũng đã phát hành Depth ControlNet Zero123++, một phiên bản được kiểm soát độ sâu của khuôn khổ gốc được xây dựng bằng cách sử dụng kiến trúc ControlNet. Các ảnh tuyến tính đã chuẩn hóa được kết xuất tương ứng với những ảnh RGB tiếp theo; ControlNet được huấn luyện để điều khiển hình học của Zero123++ bằng thông tin độ sâu.


Kết Luận
Trong bài viết này, chúng ta đã thảo luận về Zero123++, một mô hình AI tạo sinh khuếch tán có điều kiện hình ảnh với mục tiêu tạo ra nhiều hình ảnh đa góc nhất quán từ một hình ảnh đầu vào đơn. Để tối đa hóa lợi thế từ các mô hình tạo sinh trước đó, khuôn khổ Zero123++ thực hiện nhiều kỹ thuật đào tạo và điều kiện để giảm thiểu lượng công việc cần thiết để tinh chỉnh từ các mô hình hình ảnh khuếch tán sẵn có. Bài viết cũng trình bày các phương pháp và cải tiến giúp Zero123++ đạt kết quả ngang bằng, thậm chí vượt những hệ thống tiên tiến hiện tại.
Tuy nhiên, mặc dù hiệu quả và khả năng tạo ra nhiều hình ảnh đa góc chất lượng cao nhất quán, khuôn khổ Zero123++ vẫn còn một số khoảng trống để cải thiện, với các lĩnh vực nghiên cứu tiềm năng bao gồm một mô hình tinh chỉnh hai giai đoạn có thể giải quyết việc không thể đáp ứng các yêu cầu toàn cầu về nhất quán của Zero123++ và các bản mở rộng bổ sung để tăng cường khả năng tạo ra hình ảnh chất lượng cao hơn.
- Mô Hình Tinh Chỉnh Hai Giai Đoạn có thể giải quyết việc không thể đáp ứng các yêu cầu toàn cầu về nhất quán của Zero123++.
- Các Bản Mở Rộng Bổ Sung để tăng cường khả năng tạo ra hình ảnh chất lượng cao hơn.


