
Nền tảng AI
Học tăng cường từ phản hồi của con người (RLHF) là gì?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Học tăng cường từ phản hồi của con người (RLHF) là một nhóm các phương pháp sử dụng đánh giá của con người để hỗ trợ tối ưu hoá mô hình khi hành vi mong muốn khó có thể xác định bằng một phần thưởng tự động đơn giản. Đối với các mô hình ngôn ngữ, mọi người thường so sánh các phản hồi đề xuất và một mô hình sở thích đã học sẽ biến các so sánh đó thành tín hiệu huấn luyện.
RLHF có thể làm cho một mô hình đã được tiền huấn luyện trở nên hữu ích hơn hoặc phù hợp hơn với một chính sách đã viết, nhưng nó không chứng minh tính trung thực hay sự phù hợp với mọi người dùng. Kết quả phụ thuộc vào người cung cấp phản hồi, cách các lời nhắc được lấy mẫu, những gì mô hình phần thưởng có thể biểu diễn, và cách tối ưu hoá bị giới hạn.
Những điểm chính
- RLHF thường được thực hiện sau giai đoạn tiền huấn luyện và tinh chỉnh hướng dẫn có giám sát.
- Sở thích cặp đôi huấn luyện một mô hình phần thưởng hoặc mô hình sở thích; việc tối ưu chính sách sau đó ưu tiên các đầu ra có điểm cao hơn.
- Việc khai thác phần thưởng, bất đồng của người chú thích, sự dịch chuyển phân phối và tối ưu quá mức vẫn là những rủi ro quan trọng.
- Đánh giá chính sách cuối cùng trực tiếp về chất lượng nhiệm vụ, an toàn, hiệu chuẩn và ảnh hưởng tới các nhóm phụ.
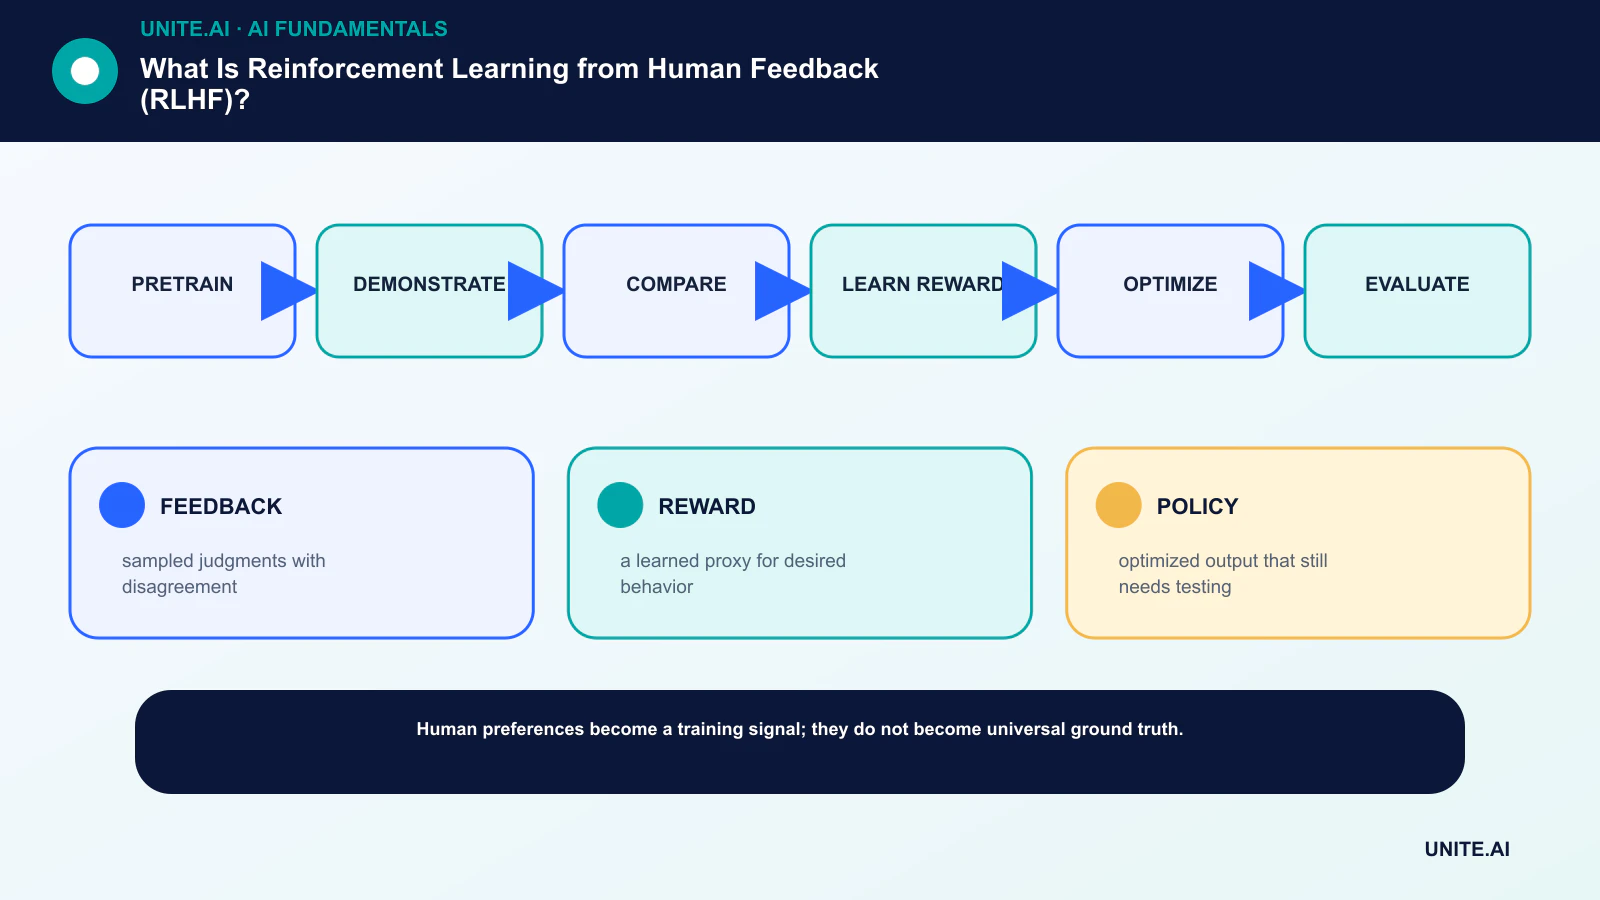
Quy trình RLHF phổ biến
Một mô hình ngôn ngữ đầu tiên học cấu trúc thống kê rộng qua giai đoạn tiền huấn luyện. Tiếp theo, việc tinh chỉnh có giám sát sử dụng các ví dụ về phản hồi mong muốn. Đối với việc thu thập sở thích, các người chú thích xếp hạng hoặc lựa chọn giữa các đầu ra cho cùng một lời nhắc.
Một mô hình phần thưởng học cách dự đoán các so sánh đó. Một thuật toán reinforcement-learning như PPO có thể tối ưu mô hình ngôn ngữ dựa trên phần thưởng đã học trong khi một hình phạt ngăn nó lệch quá xa chính sách tham chiếu.
Phản hồi là đo lường, không phải chân thực tuyệt đối
Các người chú thích có thể không đồng ý vì hướng dẫn mơ hồ, chuyên môn khác nhau, hoặc giá trị thực sự xung đột. Vị trí, độ dài, mức độ tự tin và phong cách có thể gây thiên lệch cho sở thích. Một chương trình chất lượng cao sẽ đào tạo người đánh giá, đo lường mức độ đồng thuận, kiểm tra các ví dụ và giữ lại sự không chắc chắn.
Việc lấy mẫu cũng quan trọng. Nếu tập sở thích loại trừ các ngôn ngữ khó, các lĩnh vực hoặc các nội dung gây hại, mô hình phần thưởng sẽ không thể giám sát chúng một cách đáng tin cậy. Kỷ luật Data-science quan trọng không kém so với bộ tối ưu hoá.
Các chế độ thất bại
Chính sách có thể khai thác những điểm yếu trong phần thưởng đã học, tạo ra các đầu ra có điểm cao mà không đáp ứng được ý định nền tảng. Tối ưu quá mức có thể làm giảm đa dạng, khuếch đại một phong cách ưu tiên, hoặc khiến mô hình đồng ý một cách tự tin.
Mô hình phần thưởng tự nó có thể thất bại khi vượt ra ngoài phân phối huấn luyện. Các nhóm nên kiểm tra các lời nhắc đối kháng, các nhiệm vụ thực tế, giới hạn từ chối, hiệu chuẩn và hành vi ở các mức độ tối ưu khác nhau thay vì chỉ dựa vào một tỷ lệ thắng sở thích tổng hợp.
Các lựa chọn thay thế và bổ trợ
Direct Preference Optimization học từ các cặp sở thích mà không cần tạo một chính sách riêng thông qua vòng lặp học tăng cường trực tuyến. Lấy mẫu loại bỏ, tinh chỉnh sở thích có giám sát, phản hồi dựa trên quy tắc và giám sát quy trình cung cấp các cân nhắc khác.
Không phương pháp nào có thể loại bỏ nhu cầu về prompt, truy xuất, công cụ và các kiểm soát ở mức ứng dụng. Giai đoạn sau huấn luyện định hình hành vi; các hệ thống đã triển khai vẫn cần bằng chứng căn cứ, quyền truy cập, giám sát và việc nâng cấp lên con người.
Cách mô hình sở thích được huấn luyện
Với một lời nhắc x và hai phản hồi y₁ và y₂, mô hình sở thích gán các điểm số vô hướng và được huấn luyện sao cho phản hồi được ưu tiên nhận điểm cao hơn. Một hàm mất phổ biến dựa trên xác suất một điểm số vượt qua điểm số còn lại. Điều này chuyển đổi nhiều đánh giá cặp đôi thành một hàm có thể chấm điểm các đầu ra mới sinh.
Mô hình học bất kỳ tín hiệu nào dự đoán các lựa chọn đã thu thập. Nếu người đánh giá ưu tiên văn phong tự tin, câu trả lời dài hơn, các chuẩn mực văn hoá cụ thể, hoặc quan điểm quen thuộc, những tương quan đó có thể trở thành các đặc trưng phần thưởng. Các hướng dẫn cân bằng, ví dụ phản chứng, đánh giá của chuyên gia và kiểm tra các sở thích hời hợt giảm thiểu nhưng không loại bỏ hoàn toàn vấn đề.
Dữ liệu sở thích có thể bao gồm các trường hợp hòa, xếp hạng, phê bình, nhãn vô hướng hoặc các ví dụ. Việc lựa chọn cặp quan trọng: các so sánh giữa các câu trả lời rõ ràng khác nhau ít dạy về các ranh giới chất lượng tinh tế, trong khi chỉ các cặp khó có thể làm cho quá trình huấn luyện không ổn định. Lấy mẫu chủ động có thể nhắm vào các bất đồng có thông tin nhưng có thể làm thay đổi phân phối dữ liệu.
Tối ưu chính sách và chuẩn hoá
RLHF dựa trên PPO lấy mẫu các phản hồi từ chính sách hiện tại, chấm điểm chúng bằng mô hình phần thưởng và cập nhật chính sách để tăng phần thưởng kỳ vọng. Một hình phạt Kullback–Leibler hoặc ràng buộc liên quan giữ cho chính sách gần với tham chiếu có giám sát, hạn chế sự lệch phá hủy và ngăn chặn việc khai thác những điểm yếu hẹp của mô hình phần thưởng.
Mức độ tối ưu hoá là một lựa chọn sản phẩm. Quá ít sẽ không thay đổi hành vi mong muốn; quá nhiều có thể tạo ra việc khai thác phần thưởng, lặp lại câu cú, xu hướng vỗ ve, hoặc giảm đa dạng. Hãy vẽ các chỉ số chất lượng và an toàn so với phần thưởng và độ lệch trong suốt quá trình huấn luyện thay vì chỉ chọn một điểm kiểm tra dựa trên phần thưởng.
Các phương pháp sở thích trực tiếp suy ra một mục tiêu từ các cặp sở thích và một mô hình tham chiếu mà không có vòng lặp RL trực tuyến rõ ràng. Chúng có thể đơn giản hoá việc huấn luyện, nhưng vẫn kế thừa chất lượng sở thích, phạm vi bao phủ và các giả định về chính sách tham chiếu. Phản hồi theo dạng hiến pháp hoặc do AI tạo ra thay đổi người cung cấp nhãn; nó không loại bỏ nhu cầu xác thực các giá trị và thất bại với con người.
Đánh giá và quản trị dữ liệu
Sử dụng các so sánh mù, kiểm tra đặc thù nhiệm vụ, lời nhắc đối kháng, kiểm tra tính thực tế, độ chính xác và độ thu hồi khi từ chối, và đánh giá theo nhóm phụ. Tách các nhà đánh giá khỏi dữ liệu huấn luyện khi có thể. Tỷ lệ thắng so với mô hình cũ có thể che giấu các thất bại tuyệt đối khi cả hai ứng cử viên đều kém.
Ghi chép quá trình tuyển dụng người chú thích, tiền thù lao, chuyên môn, địa lý, ngôn ngữ, hướng dẫn, tiếp xúc với nội dung gây hại, bất đồng, giải quyết tranh chấp và các biện pháp kiểm soát chất lượng. Công việc phản hồi có thể mang rủi ro tâm lý, và các hoạt động dữ liệu có trách nhiệm bao gồm hỗ trợ người lao động và quyền từ chối các nhiệm vụ gây khó chịu.
Sau khi triển khai, giám sát sự trôi dạt của sở thích và việc tổng quát hoá quá mức. Một chính sách được tinh chỉnh cho hỗ trợ thông thường có thể hành xử kém trong các bối cảnh y tế hoặc pháp lý. Giữ các ranh giới lĩnh vực, truy xuất, quyền truy cập và việc nâng cấp ra ngoài giả định RLHF, và chỉ tái huấn luyện khi bằng chứng mới biện minh cho sự thay đổi.
Một quy trình đào tạo và đánh giá RLHF cụ thể
Một dự án điển hình bắt đầu với một mô hình ngôn ngữ đã được tiền huấn luyện và một tập dữ liệu hướng dẫn dùng cho việc tinh chỉnh có giám sát. Các người chú thích sau đó so sánh các phản hồi đề xuất theo một tiêu chuẩn viết bao gồm độ chính xác, tính liên quan, phong cách, an toàn và độ không chắc chắn. Sở thích cặp đôi huấn luyện một mô hình phần thưởng hoặc trực tiếp tối ưu chính sách. Việc lấy mẫu phải bao gồm các nhiệm vụ thông thường, các trường hợp biên khó, lời nhắc đối kháng, đa ngôn ngữ và các lĩnh vực mà người chú thích hợp pháp không đồng ý.
Độ chính xác của mô hình phần thưởng trên các so sánh giữ lại là cần thiết nhưng không đủ. Chính sách đã tối ưu có thể khai thác lỗi trong phần thưởng đã học, trở nên quá dài dòng, từ chối các yêu cầu vô hại, hoặc mất khả năng. Theo dõi các tiêu chuẩn nhiệm vụ, sở thích của con người, hiệu chuẩn, an toàn, đa dạng và độ lệch so với mô hình tham chiếu trong suốt quá trình huấn luyện. Định kỳ thu thập các so sánh mới từ chính sách đang thay đổi để dữ liệu sở thích bao phủ các đầu ra mà mô hình thực sự tạo ra.
Ghi chép người cung cấp sở thích, hướng dẫn của họ, tiền thù lao, bất đồng, các biện pháp kiểm soát chất lượng và các giới hạn văn hoá hoặc lĩnh vực. Sử dụng các chuyên gia đánh giá khi lỗi có thể gây hại chuyên biệt. Thực hiện red‑team cho cả mô hình phần thưởng và chính sách cuối cùng, duy trì các kiểm tra hồi quy hành vi, và triển khai theo giai đoạn. RLHF định hình hành vi dựa trên các sở thích đã đo lường; nó không chứng minh tính trung thực, không loại bỏ thiên lệch, và không giải quyết vấn đề rộng hơn về việc xác định mô hình nên làm gì trong mọi bối cảnh.
Danh sách kiểm tra triển khai thực tiễn
Biến khái niệm thành một quy trình làm việc có giới hạn, có thể kiểm thử: tiền huấn luyện → trình diễn → so sánh → học phần thưởng → tối ưu → đánh giá. Chỉ định một người chịu trách nhiệm, ghi chép dữ liệu và các phụ thuộc, thiết lập một tiêu chuẩn cơ bản đơn giản, đặt tiêu chí chấp nhận và dừng, kiểm tra các lỗi đại diện, và xác định việc giám sát, quay lại và rà soát trước khi mở rộng phạm vi. Ghi lại các phiên bản và giả định để đội khác có thể tái tạo kết quả và hiểu những gì đã thay đổi.
Trước khi ra mắt, thực hiện một cuộc rà soát sẵn sàng được ghi chép với những người xây dựng, vận hành, bảo mật và bị ảnh hưởng bởi hệ thống. Kiểm tra các trường hợp bình thường, điều kiện biên, lỗi phụ thuộc và việc lạm dụng; bảo quản bằng chứng và các rủi ro chưa giải quyết. Xác định người có thể phê duyệt phát hành, thay đổi ngưỡng, ghi đè đầu ra hoặc dừng hoạt động. Xem lại quyết định sau khi dữ liệu thực tế xuất hiện, vì một dự án thí điểm thành công về mặt kỹ thuật không đảm bảo hiệu suất đáng tin cậy ở quy mô lớn hơn.
- PHẢN HỒI: các đánh giá được lấy mẫu có bất đồng.
- PHẦN THƯỞNG: một đại diện đã học cho hành vi mong muốn.
- CHÍNH SÁCH: đầu ra đã tối ưu nhưng vẫn cần kiểm tra.
Câu hỏi thường gặp
RLHF có giống với việc tinh chỉnh không?
RLHF là một dạng sau‑huấn luyện sử dụng phần thưởng xuất phát từ sở thích. Việc tinh chỉnh có giám sát huấn luyện trực tiếp trên các đầu ra mục tiêu; nhiều quy trình sử dụng cả hai.
RLHF có làm cho mô hình trung thực không?
Nó có thể cải thiện hành vi được đo bằng quá trình phản hồi, nhưng mô hình vẫn có thể sai, thuyết phục hoặc khai thác phần thưởng một cách chiến lược. Tính trung thực cần được đánh giá trực tiếp và có nền tảng thực tế.
Tài liệu tham khảo chính












