
Góc nhìn Anderson
Ba thách thức phía trước đối với Stable Diffusion

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Điểm chínhStable Diffusion gặp khó khăn trong việc tạo chi tiết chân tay con người do dữ liệu…
Xem thêm
- Stable Diffusion gặp khó khăn trong việc tạo chi tiết chân tay con người do dữ liệu huấn luyện được chú thích không đủ chi tiết.
- Các phương pháp phóng to ảnh dựa trên ô (tile) có nguy cơ tạo ra hình ảnh rời rạc, thiếu sự liên kết tổng thể về ngữ cảnh.
- Độ phân giải gốc 512x512 của mô hình hạn chế chất lượng đầu ra và đòi hỏi các giải pháp xử lý phức tạp.
Sự phát hành của mô hình tổng hợp hình ảnh Stable Diffusion latent diffusion của stability.ai cách đây vài tuần có thể là một trong những tiết lộ công nghệ quan trọng nhất từ DeCSS vào năm 1999; nó chắc chắn là sự kiện lớn nhất trong lĩnh vực hình ảnh được tạo ra bởi AI kể từ khi mã deepfakes năm 2017 được sao chép vào GitHub và fork thành DeepFaceLab và FaceSwap, cũng như phần mềm phát trực tuyến deepfake thời gian thực DeepFaceLive.
Đồng thời, sự thất vọng của người dùng về các giới hạn nội dung trong API tổng hợp hình ảnh DALL-E 2 đã bị xóa bỏ, vì nó đã được phát hiện ra rằng bộ lọc NSFW của Stable Diffusion có thể bị tắt bằng cách thay đổi một dòng mã. Các cộng đồng Reddit về nội dung khiêu dâm tạo bằng Stable Diffusion đã xuất hiện gần như ngay lập tức, và sau đó đã bị loại bỏ, trong khi các nhà phát triển và người dùng đã chia rẽ trên Discord thành các cộng đồng chính thức và NSFW, và Twitter bắt đầu lấp đầy với các tác phẩm Stable Diffusion tuyệt vời.
Hiện tại, mỗi ngày dường như mang lại một số đổi mới tuyệt vời từ các nhà phát triển đã áp dụng hệ thống, với các plugin và phụ kiện của bên thứ ba được viết nhanh chóng cho Krita, Photoshop, Cinema4D, Blender, và nhiều nền tảng ứng dụng khác.
Trong khi đó, promptcraft – nghệ thuật chuyên nghiệp của ‘AI whispering’, có thể trở thành một trong những lựa chọn nghề nghiệp ngắn nhất kể từ ‘Filofax binder’ – đã trở thành thương mại hóa, trong khi việc kiếm tiền từ Stable Diffusion đang diễn ra tại mức Patreon, với sự chắc chắn của các dịch vụ phức tạp hơn sẽ đến, cho những người không muốn điều hướng cài đặt Conda của mã nguồn hoặc các bộ lọc NSFW nghiêm ngặt của các triển khai dựa trên web.
Tốc độ phát triển và cảm giác khám phá tự do từ người dùng đang diễn ra với tốc độ chóng mặt đến mức khó có thể nhìn thấy xa hơn. Về cơ bản, chúng ta vẫn chưa biết chính xác chúng ta đang đối mặt với điều gì, hoặc những hạn chế hoặc khả năng có thể là gì.
Tuy nhiên, hãy cùng xem xét ba trong số những thách thức thú vị và đầy thách thức nhất mà cộng đồng Stable Diffusion đang hình thành và phát triển nhanh chóng phải đối mặt và hy vọng vượt qua.
1: Tối ưu hóa quy trình xử lý dựa trên các ô ảnh
Khi được trình bày với các tài nguyên phần cứng hạn chế và giới hạn cứng về độ phân giải của hình ảnh đào tạo, có vẻ như các nhà phát triển sẽ tìm ra các giải pháp để cải thiện cả chất lượng và độ phân giải của đầu ra Stable Diffusion. Nhiều dự án này sẽ liên quan đến việc khai thác các hạn chế của hệ thống, chẳng hạn như độ phân giải gốc chỉ là 512×512 pixel.
Giống như mọi trường hợp với các sáng kiến tổng hợp hình ảnh và tầm nhìn máy tính, Stable Diffusion được đào tạo trên hình ảnh tỷ lệ vuông, trong trường hợp này được lấy mẫu lại thành 512×512, để các hình ảnh nguồn có thể được chuẩn hóa và phù hợp với các hạn chế của GPU đã đào tạo mô hình.
Do đó, Stable Diffusion ‘nghĩ’ (nếu nó nghĩ) theo các thuật ngữ 512×512, và chắc chắn theo các thuật ngữ vuông. Nhiều người dùng hiện đang kiểm tra các giới hạn của hệ thống báo cáo rằng Stable Diffusion tạo ra kết quả đáng tin cậy và ít bị lỗi nhất tại tỷ lệ khung hình bị giới hạn này (xem phần xử lý các chi dưới đây).
Mặc dù các triển khai khác nhau có tính năng upscale qua RealESRGAN (và có thể sửa chữa các khuôn mặt được kết xuất kém qua GFPGAN) một số người dùng hiện đang phát triển các phương pháp để chia hình ảnh thành các phần 512x512px và khâu chúng lại với nhau để tạo thành các tác phẩm tổng hợp lớn hơn.

Hình này 1024×576, độ phân giải thông thường không thể trong một bản kết xuất duy nhất của Stable Diffusion, được tạo bằng cách sao chép và dán tệp Python attention.py từ nhánh DoggettX của Stable Diffusion (một phiên bản thực hiện upscaling dựa trên tile) vào một fork khác. Nguồn: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Mặc dù một số sáng kiến của loại này sử dụng mã gốc hoặc các thư viện khác, bản chuyển đổi txt2imghd của GOBIG (một chế độ trong ProgRockDiffusion vốn tiêu tốn nhiều VRAM) dự kiến sớm đưa chức năng này vào nhánh chính. Trong khi txt2imghd là bản chuyển đổi riêng của GOBIG, những nỗ lực khác của các nhà phát triển cộng đồng sử dụng những cách triển khai GOBIG khác nhau.

Một hình ảnh trừu tượng tiện lợi trong bản kết xuất 512x512px gốc (trái và thứ hai từ trái); được upscale bởi ESGRAN, hiện đã trở thành bản địa trên tất cả các phân phối Stable Diffusion; và được chú ý đặc biệt qua một triển khai của GOBIG, tạo ra chi tiết mà, ít nhất trong phạm vi phần hình ảnh, dường như được upscale tốt hơn. Nguồn: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Loại hình ảnh trừu tượng được giới thiệu ở trên có nhiều ‘vương quốc nhỏ’ của chi tiết phù hợp với cách tiếp cận upscaling này, nhưng có thể yêu cầu các giải pháp mã phức tạp hơn để tạo ra upscaling không lặp lại và gắn kết mà không trông như được lắp ráp từ nhiều phần. Điều này đặc biệt quan trọng với khuôn mặt người, nơi chúng ta rất nhạy với những sai lệch hoặc chi tiết bất thường gây chướng mắt. Vì vậy, cuối cùng khuôn mặt có thể cần một giải pháp chuyên biệt.
Stable Diffusion hiện không có cơ chế để tập trung chú ý vào khuôn mặt trong quá trình kết xuất theo cách mà con người ưu tiên thông tin khuôn mặt. Mặc dù một số nhà phát triển trong các cộng đồng Discord đang xem xét các phương pháp để thực hiện loại ‘chú ý nâng cao’ này, nhưng hiện tại nó dễ dàng hơn nhiều để tự tay (và cuối cùng là tự động) nâng cao khuôn mặt sau khi quá trình kết xuất ban đầu đã diễn ra.
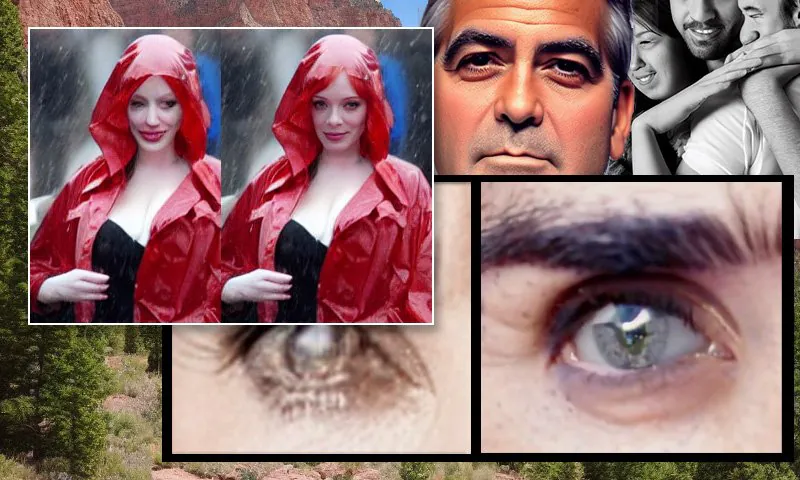
Khuôn mặt con người có một logic ngữ nghĩa nội bộ và hoàn chỉnh mà sẽ không được tìm thấy trong một ’tile’ của góc dưới cùng của (ví dụ) một tòa nhà, và do đó, hiện tại có thể rất hiệu quả để ‘thu phóng’ và kết xuất lại một khuôn mặt còn phác thảo sơ sài trong đầu ra của Stable Diffusion.

Trái, nỗ lực ban đầu của Stable Diffusion với lời nhắc ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’. Phải, khuôn mặt được cải thiện thu được bằng cách đưa khuôn mặt mờ và sơ sài từ bản kết xuất đầu tiên trở lại vào sự chú ý đầy đủ của Stable Diffusion bằng Img2Img (xem hình ảnh động dưới đây).
Trong trường hợp không có giải pháp Textual Inversion chuyên dụng (xem dưới đây), điều này chỉ hoạt động với hình ảnh của những người nổi tiếng mà đã được đại diện tốt trong các tập dữ liệu LAION đã đào tạo Stable Diffusion. Do đó, nó sẽ hoạt động với những người như Tom Cruise, Brad Pitt, Jennifer Lawrence, và một loạt các nhân vật truyền thông thực sự nổi tiếng có mặt trong số lượng lớn hình ảnh trong dữ liệu nguồn.
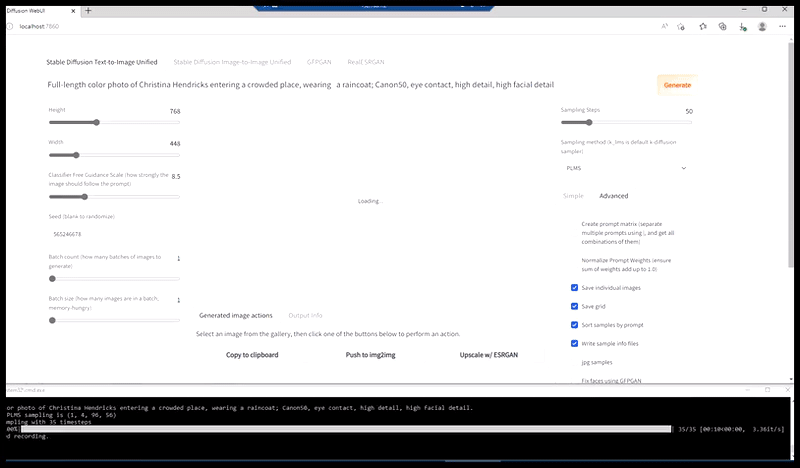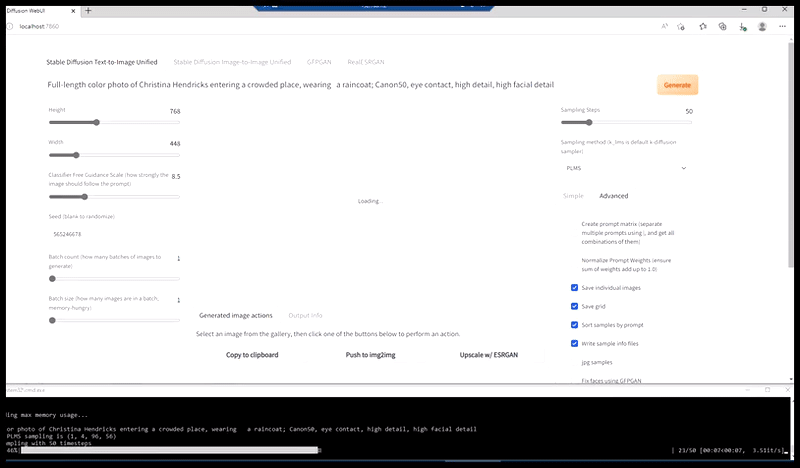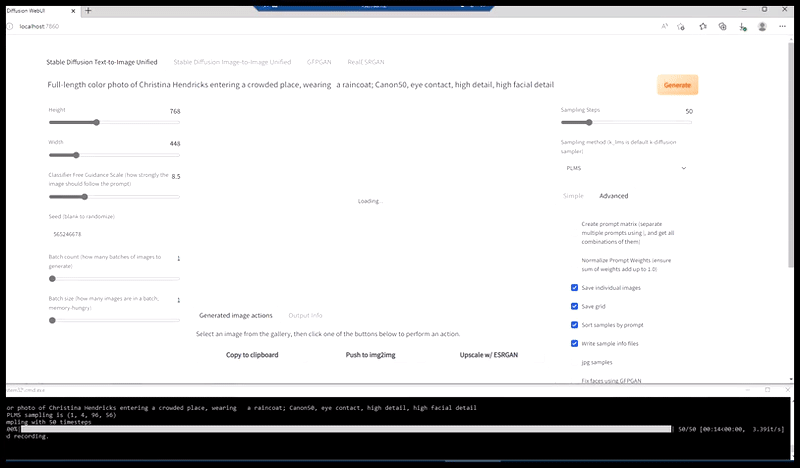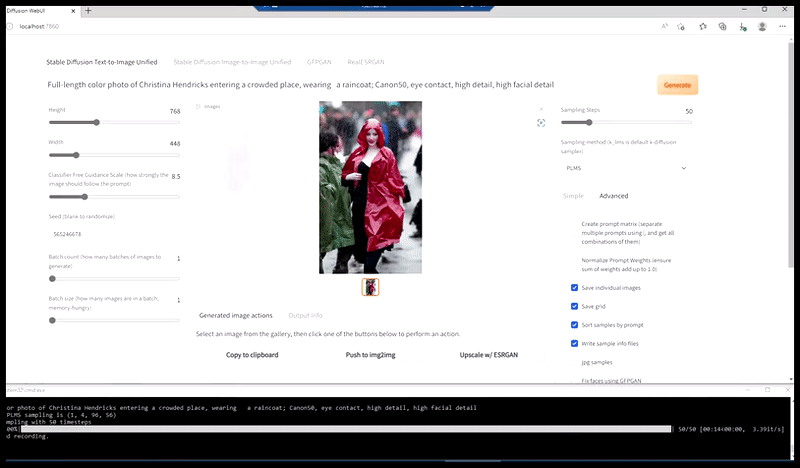
Tạo một hình ảnh báo chí hợp lý với lời nhắc ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’.
Đối với những người nổi tiếng có sự nghiệp lâu dài và bền vững, Stable Diffusion thường sẽ tạo ra một hình ảnh của người đó ở độ tuổi gần đây (tức là già hơn), và nó sẽ cần thiết phải thêm các lời nhắc bổ sung như ‘young’ hoặc ‘in the year [YEAR]’ để tạo ra hình ảnh trẻ hơn.

Với sự nghiệp nổi bật và được chụp ảnh rộng rãi trong gần 40 năm, nữ diễn viên Jennifer Connelly là một trong số ít những người nổi tiếng trong LAION cho phép Stable Diffusion thể hiện một loạt các độ tuổi. Nguồn: Stable Diffusion trước, cục bộ, v1.4 điểm kiểm tra; lời nhắc liên quan đến độ tuổi.
Điều này chủ yếu là do sự phổ biến của nhiếp ảnh báo chí kỹ thuật số (thay vì dựa trên phim) từ giữa những năm 2000, và sự tăng trưởng sau đó về khối lượng hình ảnh do tốc độ băng thông rộng tăng lên.
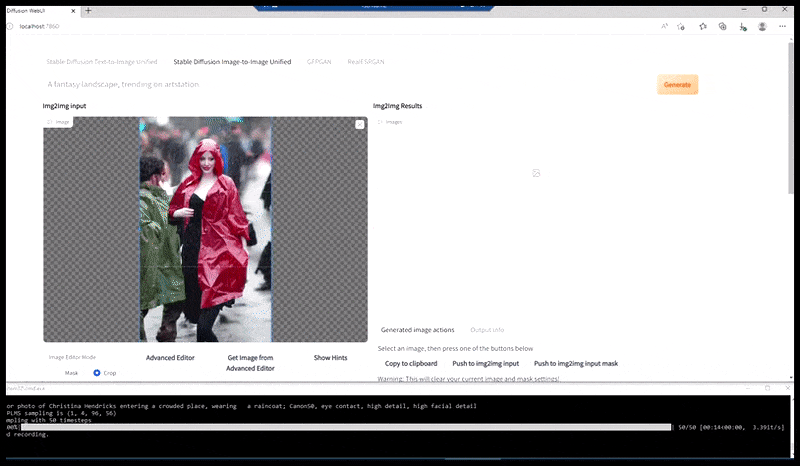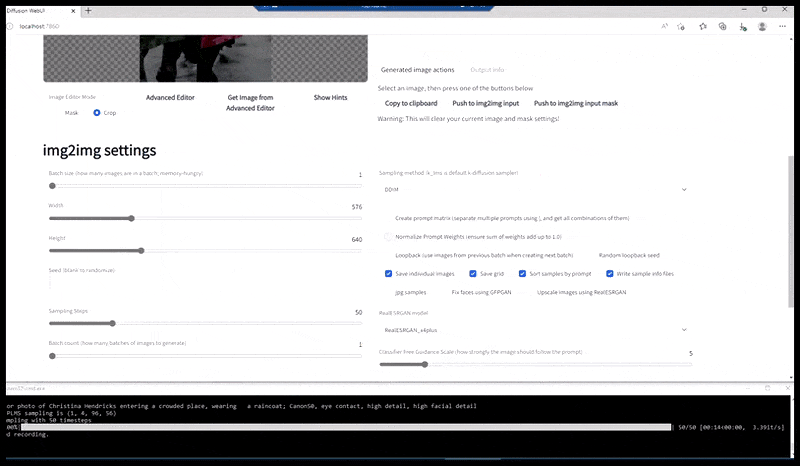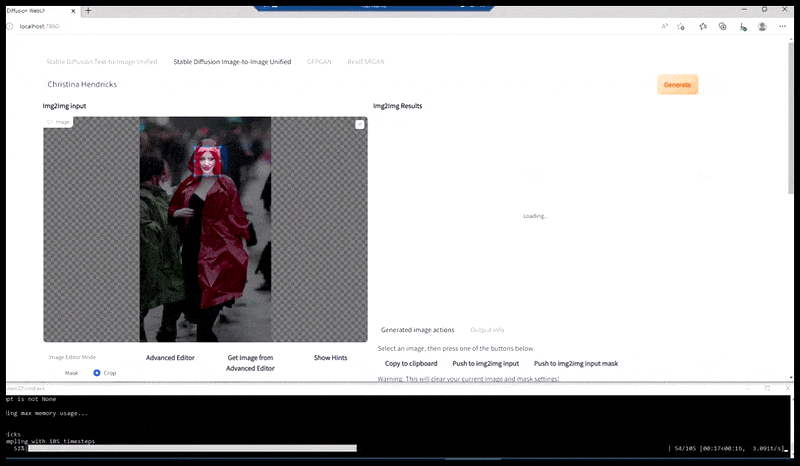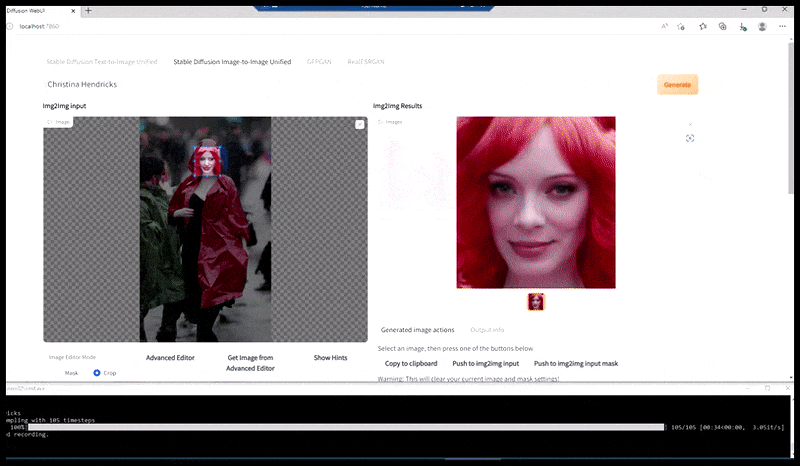
Hình ảnh kết xuất được chuyển qua Img2Img trong Stable Diffusion, nơi một ‘khu vực tập trung’ được chọn, và một bản kết xuất mới với kích thước tối đa được thực hiện chỉ cho khu vực đó, cho phép Stable Diffusion tập trung tất cả tài nguyên có sẵn vào việc tái tạo khuôn mặt.
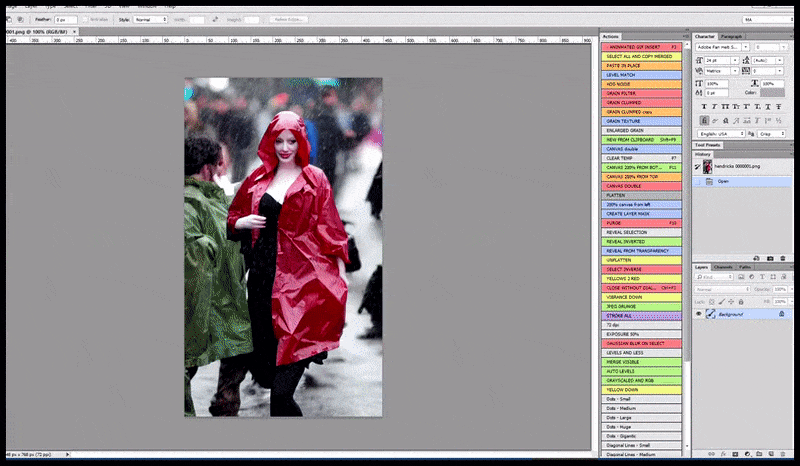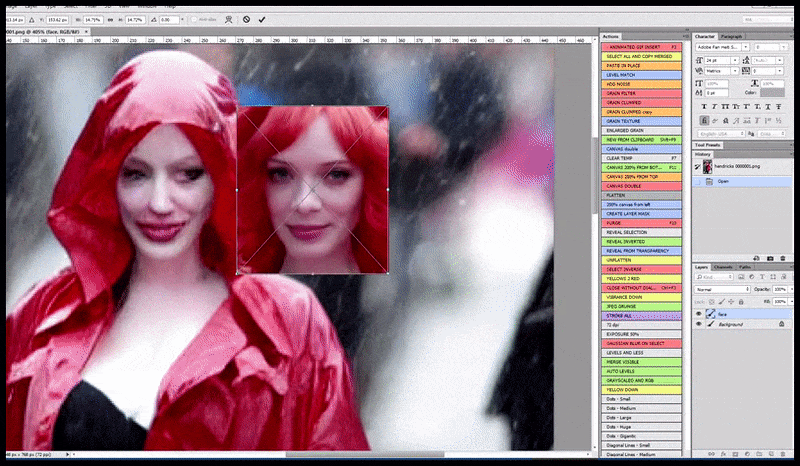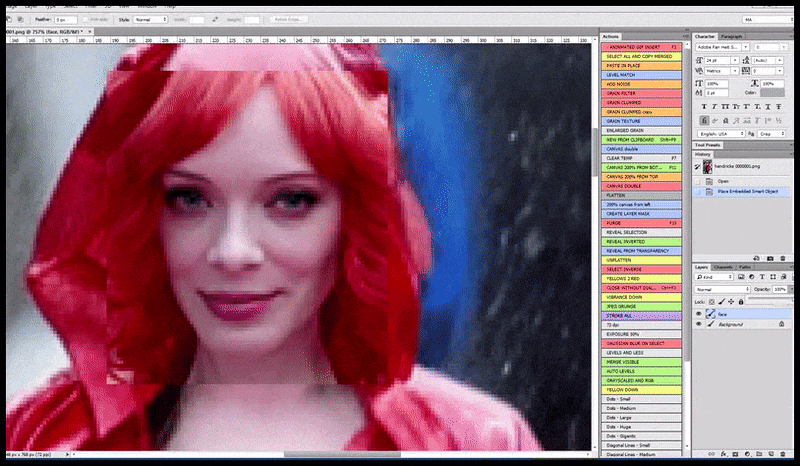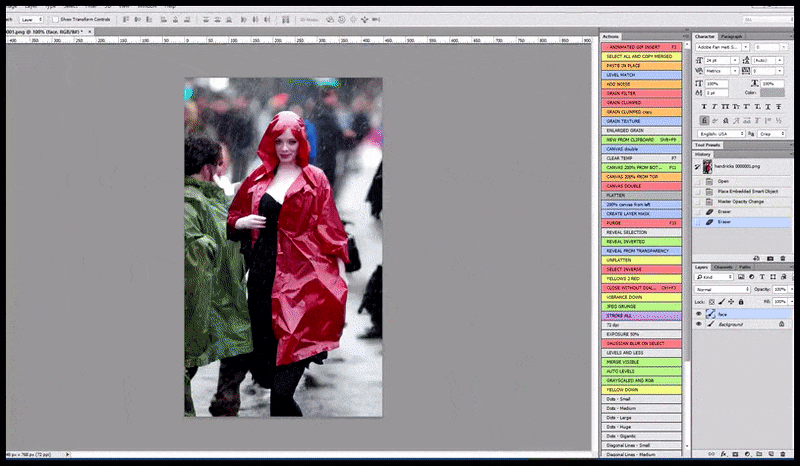
Ghép khuôn mặt được tập trung chú ý trở lại vào bản kết xuất ban đầu. Ngoài khuôn mặt, quy trình này chỉ hiệu quả với những thực thể có hình dạng tổng thể đã biết và nhất quán, chẳng hạn một phần ảnh gốc chứa vật thể riêng biệt như đồng hồ hoặc ô tô. Phóng to một phần của bức tường chẳng hạn sẽ tạo ra bức tường ghép lại rất kỳ lạ, vì khi kết xuất từng ô, hệ thống không có ngữ cảnh rộng hơn cho “mảnh ghép” đó.
Một số người nổi tiếng trong cơ sở dữ liệu đến ‘đông lạnh’ trong thời gian, hoặc vì họ đã chết sớm (như Marilyn Monroe), hoặc vì họ đã nổi tiếng trong thời gian ngắn, tạo ra một lượng lớn hình ảnh trong một khoảng thời gian hạn chế. Việc thăm dò Stable Diffusion có thể cung cấp một loại ‘chỉ số phổ biến hiện tại’ cho các ngôi sao hiện đại và trước đây. Với một số người nổi tiếng thuộc cả thế hệ cũ lẫn hiện tại, dữ liệu nguồn không có đủ ảnh để tạo hình thật giống; trong khi sự nổi tiếng bền bỉ của một số ngôi sao đã qua đời từ lâu hoặc không còn được chú ý giúp hệ thống vẫn tái hiện họ tương đối giống.

Stable Diffusion kết xuất nhanh chóng tiết lộ những khuôn mặt nổi tiếng nào được đại diện tốt trong dữ liệu đào tạo. Dù rất nổi tiếng khi ở cuối tuổi thiếu niên vào thời điểm viết bài, Millie Bobby Brown còn nhỏ hơn và ít được biết đến hơn khi các bộ dữ liệu nguồn LAION được thu thập từ web, khiến việc tạo hình giống cô với chất lượng cao bằng Stable Diffusion hiện còn khó khăn.
Trong trường hợp dữ liệu có sẵn, các giải pháp up-res dựa trên tile trong Stable Diffusion có thể đi xa hơn bằng cách tập trung vào khuôn mặt: chúng có thể cho phép tạo ra khuôn mặt chính xác và chi tiết hơn bằng cách chia các đặc điểm khuôn mặt thành các phần và tập trung toàn bộ tài nguyên của GPU cục bộ vào từng phần riêng biệt, trước khi tái lắp ráp – một quá trình hiện tại vẫn là thủ công.

Điều này không giới hạn ở khuôn mặt, nhưng nó bị giới hạn ở các phần của đối tượng có vị trí dự đoán được trong ngữ cảnh rộng lớn hơn của đối tượng chủ và phù hợp với các bản nhúng cấp cao mà người ta có thể hợp lý mong đợi tìm thấy trong một tập dữ liệu quy mô lớn.
Giới hạn thực sự là lượng dữ liệu tham chiếu có sẵn trong tập dữ liệu, vì cuối cùng, chi tiết được lặp lại sâu sẽ trở nên hoàn toàn ‘ảo giác’ (tức là hư cấu) và ít chân thực.
Cách phóng to đến từng chi tiết nhỏ này hoạt động trong trường hợp của Jennifer Connelly, vì cô được đại diện rộng rãi trên nhiều độ tuổi trong LAION-aesthetics (phần phụ của LAION 5B mà Stable Diffusion sử dụng), và nói chung trên LAION; trong nhiều trường hợp khác, độ chính xác sẽ bị ảnh hưởng bởi sự thiếu dữ liệu, đòi hỏi phải tinh chỉnh (đào tạo thêm, xem ‘Tùy chỉnh’ dưới đây) hoặc Textual Inversion (xem dưới đây).
Các tile là một cách mạnh mẽ và tương đối rẻ tiền để Stable Diffusion có thể tạo ra đầu ra độ phân giải cao, nhưng upscaling thuật toán của loại này, nếu nó thiếu một số loại cơ chế chú ý cấp cao hơn, có thể không đạt được tiêu chuẩn mong muốn trên nhiều loại nội dung.
2: Xử lý vấn đề với tay chân con người
Stable Diffusion không xứng với tên gọi của mình khi mô tả sự phức tạp của các chi của con người. Tay có thể nhân lên một cách ngẫu nhiên, ngón tay hợp nhất, chân thứ ba xuất hiện không mong muốn, và các chi hiện có biến mất mà không để lại dấu vết. Để bảo vệ Stable Diffusion, nó chia sẻ vấn đề này với các mô hình cùng loại, và chắc chắn là với DALL-E 2.

Kết quả không chỉnh sửa từ DALL-E 2 và Stable Diffusion (1.4) vào cuối tháng 8 năm 2022, cả hai đều cho thấy vấn đề với tay chân. Lời nhắc là ‘A woman embracing a man’.
Những người hâm mộ Stable Diffusion hy vọng điểm kiểm tra 1.5 sắp tới (phiên bản mô hình được huấn luyện kỹ hơn, với tham số cải tiến) sẽ giải quyết sự nhầm lẫn về tay chân có lẽ sẽ thất vọng. Mô hình mới, sẽ được phát hành khoảng hai tuần, hiện đang được công chiếu tại cổng thương mại stability.ai DreamStudio, vốn dùng 1.5 theo mặc định và là nơi người dùng có thể so sánh đầu ra với các bản kết xuất từ hệ thống cục bộ hoặc các hệ thống khác 1.4:

Nguồn: 1.4 cục bộ và https://beta.dreamstudio.ai/

Nguồn: 1.4 cục bộ và https://beta.dreamstudio.ai/

Nguồn: 1.4 cục bộ và https://beta.dreamstudio.ai/
Nguyên nhân có thể là do chất lượng dữ liệu.
Các cơ sở dữ liệu mã nguồn mở cung cấp nhiên liệu cho các hệ thống tổng hợp hình ảnh như Stable Diffusion và DALL-E 2 có thể cung cấp nhiều nhãn cho cả con người và hành động giữa người. Những nhãn này được đào tạo cùng với hình ảnh hoặc đoạn hình ảnh của chúng.

Người dùng Stable Diffusion có thể khám phá các khái niệm được đào tạo vào mô hình bằng cách truy vấn tập dữ liệu LAION-aesthetics, một phần của tập dữ liệu LAION 5B lớn hơn, cung cấp dữ liệu cho hệ thống. Các ảnh không được sắp xếp theo thứ tự chữ cái của nhãn mà theo “điểm thẩm mỹ”. Nguồn: https://rom1504.github.io/clip-retrieval/
Một hệ thống phân cấp tốt của các nhãn và lớp góp phần mô tả một cánh tay của con người sẽ là thứ gì đó như thân thể > cánh tay > tay > ngón tay > [phần ngón tay + ngón cái] > [phần ngón tay] > Móng tay.

Phân đoạn ngữ nghĩa chi tiết các phần của bàn tay. Ngay cả cách phân tách chi tiết bất thường này vẫn coi mỗi “ngón tay” là một thực thể đơn lẻ, không tính đến ba đốt của một ngón tay thường và hai đốt của ngón cái. Nguồn: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
Trên thực tế, khó có khả năng các hình ảnh nguồn được chú thích nhất quán như vậy trên toàn bộ tập dữ liệu, và các thuật toán dán nhãn không giám sát sẽ có thể dừng lại ở cấp độ cao hơn – ví dụ, ‘tay’, và để lại các pixel bên trong (về mặt kỹ thuật có chứa thông tin ‘ngón tay’) như một khối pixel không được dán nhãn, từ đó các tính năng sẽ được suy diễn một cách tùy ý, và có thể biểu hiện trong các bản kết xuất sau này như một yếu tố gây sốc.

Nó nên như thế này (phía trên bên phải, nếu không phải cú đấm móc lên), và nó thường như thế này (phải, dưới), do hạn chế về nguồn lực cho việc dán nhãn, hoặc khai thác kiến trúc của các nhãn này nếu chúng tồn tại trong tập dữ liệu.
Vì vậy, nếu một mô hình khuếch tán ẩn nhận được một cánh tay, nó gần như chắc chắn sẽ cố gắng kết xuất một bàn tay ở cuối cánh tay đó, vì cánh tay > tay là hệ thống phân cấp tối thiểu, khá cao trong kiến trúc biết về ‘giải phẫu học của con người’.
Sau đó, ‘ngón tay’ có thể là nhóm nhỏ nhất, mặc dù có 14 phần ngón tay / ngón cái nhỏ hơn để xem xét khi mô tả bàn tay của con người.
Nếu lý thuyết này đúng, thì không có giải pháp thực sự, do sự thiếu hụt ngân sách cho việc dán nhãn thủ công, và sự thiếu hụt các thuật toán hiệu quả có thể tự động dán nhãn trong khi tạo ra tỷ lệ lỗi thấp. Về cơ bản, mô hình có thể hiện tại đang dựa vào sự nhất quán về giải phẫu học của con người để che giấu những điểm yếu của tập dữ liệu nó được đào tạo.
Một lý do có thể tại sao nó không thể dựa vào điều này, gần đây được đề xuất tại Discord của Stable Diffusion, là mô hình có thể bị nhầm lẫn về số lượng ngón tay mà một bàn tay con người (hiện thực) nên có, vì cơ sở dữ liệu LAION cung cấp năng lượng cho nó có các nhân vật hoạt hình có thể có ít ngón tay hơn (điều này tự nó là một cách tiết kiệm lao động).

Hai trong số những kẻ tình nghi có thể góp phần vào “hội chứng mất ngón tay” trong Stable Diffusion và các mô hình tương tự. Bên dưới là ví dụ về tay hoạt hình từ bộ dữ liệu LAION-aesthetics dùng cho Stable Diffusion. Nguồn: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Nếu điều này đúng, thì giải pháp duy nhất là đào tạo lại mô hình, loại bỏ nội dung không thực tế về con người, và đảm bảo rằng các trường hợp thiếu sót thực sự (tức là những người bị cụt tay) được dán nhãn như các trường hợp ngoại lệ. Từ góc độ kiểm tra dữ liệu, điều này sẽ là một thách thức khá lớn, đặc biệt là đối với các nỗ lực của cộng đồng có nguồn lực hạn chế.
Cách tiếp cận thứ hai sẽ là áp dụng các bộ lọc loại trừ nội dung như vậy (ví dụ, ‘tay có ba / năm ngón tay’) khỏi việc hiển thị tại thời điểm kết xuất, giống như cách OpenAI đã phần nào lọc GPT-3 và DALL-E 2, để rằng đầu ra của chúng có thể được điều chỉnh mà không cần đào tạo lại mô hình nguồn.

Đối với Stable Diffusion, sự phân biệt ngữ nghĩa giữa các ngón tay và thậm chí là chi có thể trở nên mờ nhòe một cách kinh hoàng, gợi nhớ đến dòng phim kinh dị ‘body horror’ của những năm 1980 từ những người như David Cronenberg. Nguồn: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Tuy nhiên, một lần nữa, điều đó đòi hỏi những nhãn có thể không tồn tại trên tất cả các ảnh liên quan, nên vẫn gặp cùng thách thức về hậu cần và ngân sách.
Có thể lập luận rằng còn hai hướng đi: ném nhiều dữ liệu hơn vào vấn đề, và áp dụng các hệ thống giải thích của bên thứ ba có thể can thiệp khi các lỗi vật lý như mô tả ở đây được trình bày cho người dùng cuối (ít nhất, điều sau sẽ cung cấp cho OpenAI một phương pháp để cung cấp hoàn tiền cho các bản kết xuất ‘kinh dị’, nếu công ty có động lực để làm như vậy).
3: Tùy chỉnh
Một trong những khả năng thú vị nhất cho tương lai của Stable Diffusion là khả năng người dùng hoặc tổ chức phát triển các hệ thống sửa đổi; các sửa đổi cho phép nội dung ngoài phạm vi LAION được đào tạo trước có thể được tích hợp vào hệ thống – lý tưởng là mà không cần chi phí không thể kiểm soát được của việc đào tạo lại toàn bộ mô hình, hoặc rủi ro khi đào tạo một lượng lớn hình ảnh mới vào một mô hình hiện có, trưởng thành và có khả năng.
Ví dụ so sánh: nếu hai sinh viên ít tài năng hơn tham gia một lớp học nâng cao của 30 sinh viên, họ sẽ hoặc hòa nhập và theo kịp, hoặc thất bại như những kẻ ngoại lệ; trong cả hai trường hợp, hiệu suất trung bình của lớp học có thể sẽ không bị ảnh hưởng. Nếu 15 sinh viên ít tài năng hơn tham gia, tuy nhiên, đường cong điểm của toàn bộ lớp học có thể sẽ bị ảnh hưởng.
Tương tự, mạng lưới các mối quan hệ đồng bộ và khá tinh tế được xây dựng trong quá trình đào tạo mô hình kéo dài và tốn kém có thể bị tổn thương, trong một số trường hợp bị phá hủy, bởi dữ liệu mới quá mức, làm giảm chất lượng đầu ra của mô hình trên toàn bộ.
Trường hợp cho việc làm này chủ yếu là khi lợi ích của bạn nằm ở việc hoàn toàn thay đổi sự hiểu biết của mô hình về các mối quan hệ và sự vật, và chiếm đoạt nó để sản xuất nội dung tương tự như vật liệu bổ sung mà bạn đã thêm.
Vì vậy, đào tạo 500.000 khung hình Simpsons vào một điểm kiểm tra Stable Diffusion hiện có có thể sẽ giúp bạn có được một mô hình Simpsons tốt hơn so với bản build ban đầu có thể cung cấp, giả sử rằng đủ mối quan hệ ngữ nghĩa rộng rãi tồn tại trong quá trình (ví dụ: Homer Simpson ăn một chiếc hot dog, điều này có thể yêu cầu vật liệu về hot dog không có trong vật liệu bổ sung của bạn, nhưng đã tồn tại trong điểm kiểm tra), và giả sử rằng bạn không muốn đột ngột chuyển từ nội dung Simpsons sang tạo phong cảnh tuyệt đẹp của Greg Rutkowski – vì mô hình của bạn đã bị phân tâm mạnh mẽ, và sẽ không tốt trong việc làm điều đó như nó đã từng.
Một ví dụ đáng chú ý về điều này là waifu-diffusion, đã thành công huấn luyện bổ sung bằng 56.000 hình ảnh anime vào một điểm kiểm tra Stable Diffusion đã hoàn thành và được đào tạo. Đây là một triển vọng khó khăn cho một người đam mê, vì mô hình yêu cầu tối thiểu 30GB VRAM, vượt quá khả năng của người tiêu dùng trong các bản phát hành 40XX sắp tới của NVIDIA.

Đào tạo nội dung tùy chỉnh vào Stable Diffusion qua waifu-diffusion: mô hình đã mất hai tuần huấn luyện bổ sung để tạo ra hình minh họa ở mức độ này. Sáu ảnh bên trái cho thấy tiến bộ của mô hình trong quá trình huấn luyện, nhằm tạo ra đầu ra nhất quán về chủ thể dựa trên dữ liệu mới. Nguồn: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
Nhiều nỗ lực có thể được chi cho các ‘fork’ của các điểm kiểm tra Stable Diffusion, chỉ để bị cản trở bởi nợ kỹ thuật. Các nhà phát triển tại Discord chính thức đã chỉ ra rằng các bản phát hành điểm kiểm tra sau này có thể không tương thích ngược, thậm chí với logic lời nhắc có thể đã hoạt động với phiên bản trước, vì lợi ích chính của họ là trong việc có được mô hình tốt nhất có thể, chứ không phải hỗ trợ các ứng dụng và quy trình di sản.
Vì vậy, một công ty hoặc cá nhân quyết định tạo một nhánh từ một điểm kiểm tra thành một sản phẩm thương mại hiệu quả có không có cách nào quay lại; phiên bản của họ của mô hình là, tại thời điểm đó, một ‘hard fork’, và sẽ không thể tận dụng được các lợi ích từ các bản phát hành sau này từ stability.ai – điều này là một cam kết khá lớn.
Hiện tại, và hy vọng lớn hơn cho việc tùy chỉnh Stable Diffusion là Textual Inversion, nơi người dùng huấn luyện bằng một vài hình ảnh được căn chỉnh với CLIP.

Một sự hợp tác giữa Đại học Tel Aviv và NVIDIA, textual inversion cho phép đào tạo các thực thể rời rạc và mới mà không phá hủy khả năng của mô hình nguồn. Nguồn: https://textual-inversion.github.io/
Giới hạn rõ ràng của textual inversion là số lượng hình ảnh được khuyến nghị rất thấp – có thể chỉ năm. Điều này hiệu quả tạo ra một thực thể hạn chế có thể hữu ích hơn cho các nhiệm vụ chuyển đổi phong cách hơn là chèn các đối tượng chân thực như ảnh chụp.
Mặc dù vậy, các thí nghiệm đang diễn ra trong các Discord khác nhau của Stable Diffusion đang sử dụng số lượng hình ảnh đào tạo cao hơn, và vẫn phải chờ xem phương pháp này có thể mang lại hiệu quả đến đâu. Một lần nữa, kỹ thuật này cần rất nhiều VRAM, thời gian và sự kiên nhẫn.
Do những yếu tố hạn chế này, chúng ta có thể phải đợi một thời gian để xem một số thí nghiệm textual inversion tinh vi hơn từ những người đam mê Stable Diffusion – và liệu phương pháp này có thể ‘đặt bạn vào hình ảnh’ theo cách trông tốt hơn so với một bản cắt và dán Photoshop, trong khi vẫn giữ chức năng đáng kinh ngạc của các điểm kiểm tra chính thức.
Được xuất bản lần đầu vào ngày 6 tháng 9 năm 2022.


