

Mô hình và nền tảng AI
SEER: Đột phá trong các mô hình thị giác máy tính tự giám sát?

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Trong thập kỷ qua, trí tuệ nhân tạo (AI) và học máy (ML) đã tiến bộ vượt bậc. Các mô hình ngày nay chính xác, hiệu quả và có năng lực hơn bao giờ hết. Chúng nhận dạng đối tượng trong ảnh hoặc video một cách trơn tru, chính xác, đồng thời tạo văn bản và lời nói tương đương năng lực trí tuệ con người.
Các mô hình AI và ML hiện phụ thuộc nhiều vào huấn luyện trên dữ liệu có nhãn để học cách diễn giải văn bản, nhận dạng đối tượng trong ảnh hoặc khung hình video và thực hiện nhiều nhiệm vụ khác.
Tuy nhiên, chúng chưa hoàn hảo. Các nhà nghiên cứu muốn xây dựng mô hình học từ thông tin được cung cấp mà không nhất thiết phải dựa vào dữ liệu có nhãn hay chú thích. Cách tiếp cận này gọi là học tự giám sát, một phương pháp hiệu quả để tạo mô hình có “tri thức thông thường” hay kiến thức nền nhằm giải quyết vấn đề vượt quá khả năng của AI hiện tại.
Học tự giám sát đã đem lại kết quả trong xử lý ngôn ngữ tự nhiên, cho phép huấn luyện mô hình lớn trên lượng dữ liệu khổng lồ và tạo đột phá về suy luận ngôn ngữ tự nhiên, dịch máy và trả lời câu hỏi.
SEER của Facebook (META ) AI muốn khai thác tối đa học tự giám sát trong thị giác máy tính. SEER, viết tắt của SElf SupERvised , là mô hình thị giác máy tính tự giám sát với hơn một tỷ tham số. Nó có thể tìm mẫu và học ngay cả từ nhóm ảnh ngẫu nhiên trên internet không có nhãn hay chú thích thích hợp.
Vì sao thị giác máy tính cần học tự giám sát?
Chú thích hay gắn nhãn dữ liệu là bước tiền xử lý khi phát triển mô hình AI và ML. Dữ liệu thô như ảnh hoặc khung hình được xác định và thêm nhãn để cung cấp ngữ cảnh cho mô hình, giúp nó dự đoán chính xác.
Một trở ngại lớn với nhà phát triển mô hình thị giác máy tính là tìm dữ liệu chú thích chất lượng cao. Các mô hình hiện dựa vào dữ liệu có nhãn để học mẫu nhận dạng đối tượng.
Chú thích và sử dụng dữ liệu đặt ra những thách thức sau:
Duy trì chất lượng dữ liệu nhất quán
Khó tiếp cận liên tục các tập dữ liệu chất lượng cao. Nhãn đúng và ảnh rõ giúp mô hình học tốt, chính xác hơn, nhưng bảo đảm nguồn dữ liệu như vậy cũng có những khó khăn riêng.
Quản lý nhân lực
Cần nhiều người xử lý và gắn nhãn lượng lớn dữ liệu phi cấu trúc, chưa có nhãn, đồng thời bảo đảm chất lượng. Vì vậy phải cân bằng giữa chất lượng và số lượng.
Hạn chế tài chính
Chi phí có thể là trở ngại lớn nhất. Việc gắn nhãn thường chiếm tỷ lệ đáng kể trong tổng chi phí dự án.
Chú thích dữ liệu là rào cản đối với mô hình thị giác máy tính tiên tiến, nhất là mô hình phức tạp cần rất nhiều dữ liệu. Vì thế lĩnh vực này cần học tự giám sát để xử lý nhiệm vụ vượt khả năng hiện có.
Nhiều mô hình tự giám sát đã hoạt động tốt trong môi trường kiểm soát, chủ yếu trên ImageNet. Tuy vậy, chúng chưa đáp ứng điều kiện chính: học từ tập dữ liệu không giới hạn hay ảnh ngẫu nhiên, thay vì chỉ một tập được xác định rõ. Khi thực hiện lý tưởng, học tự giám sát giúp tạo mô hình chính xác, có năng lực, tiết kiệm và khả thi hơn.
Giới thiệu SEER: SElf-supERvised
Xu hướng AI và ML cho thấy tiền huấn luyện bán giám sát, giám sát yếu và tự giám sát có thể cải thiện đáng kể hiệu suất của mô hình học sâu trên các tác vụ tiếp theo.
Có hai yếu tố chính thúc đẩy sự cải thiện.
Tiền huấn luyện trên tập dữ liệu khổng lồ
Dữ liệu khổng lồ cung cấp nhiều dạng thông tin, giúp mô hình hiểu mẫu tốt hơn và thường cải thiện độ chính xác cùng hiệu suất thực tế.
Các mô hình mạnh như GPT-3 và Wav2vec 2.0 cũng được huấn luyện với dữ liệu rất lớn. GPT-3 dùng hơn 300 tỷ từ cho tiền huấn luyện, còn Wav2vec 2.0 nhận dạng tiếng nói dùng hơn 53 nghìn giờ âm thanh.
Mô hình có dung lượng lớn
Nhiều tham số thường cho kết quả chính xác hơn vì mô hình tập trung vào đối tượng cần thiết thay vì nhiễu hoặc thông tin gây cản trở.
Các thử nghiệm trước đây đã dùng dữ liệu chưa gắn nhãn hay chưa tuyển chọn để học tự giám sát, nhưng chỉ có vài triệu ảnh. Liệu mô hình tự giám sát có chính xác khi huấn luyện trên lượng lớn dữ liệu chưa gắn nhãn, chưa tuyển chọn không? Đó chính là câu hỏi SEER muốn trả lời.
SEER là khung học sâu nhằm xử lý ảnh trên internet mà không phụ thuộc tập dữ liệu đã tuyển chọn hoặc gắn nhãn. Nhà phát triển có thể huấn luyện mô hình lớn, phức tạp trên dữ liệu ngẫu nhiên không cần giám sát: mô hình tự phân tích, học mẫu và thông tin mà không thêm đầu vào thủ công.
Mục tiêu cuối cùng là phát triển chiến lược tiền huấn luyện dùng dữ liệu chưa tuyển chọn để đạt hiệu suất hàng đầu trong học chuyển giao. Ngoài ra, SEER hướng tới hệ thống có thể liên tục học tự giám sát từ luồng dữ liệu vô tận.
SEER huấn luyện mô hình dung lượng cao trên hàng tỷ ảnh ngẫu nhiên, không bị giới hạn, lấy từ internet. Nó không dùng siêu dữ liệu hay chú thích để huấn luyện hoặc lọc ảnh. Gần đây, mô hình tự giám sát trên dữ liệu chưa tuyển chọn đạt kết quả tác vụ tiếp theo tốt hơn tiền huấn luyện có giám sát.
SEER và RegNet liên hệ thế nào?
Để phân tích SEER, nghiên cứu tập trung vào RegNet với hơn 700 triệu tham số, phù hợp mục tiêu tự giám sát trên dữ liệu chưa tuyển chọn vì hai lý do:
- Cân bằng tốt giữa hiệu suất và hiệu quả.
- Linh hoạt, có thể mở rộng số tham số.

SEER: nghiên cứu trước đây từ nhiều lĩnh vực
SEER khám phá giới hạn của việc học tự giám sát với kiến trúc lớn trên dữ liệu chưa tuyển chọn hoặc chưa có nhãn, dựa trên các nghiên cứu trước.
Tiền huấn luyện không giám sát các đặc trưng thị giác
Học tự giám sát trong thị giác máy tính đã sử dụng bộ tự mã hóa, phân biệt ở cấp mẫu và phân cụm. Các phương pháp học tương phản gần đây cho thấy tiền huấn luyện không giám sát có thể tốt hơn giám sát trên tác vụ tiếp theo.
Kết luận quan trọng là không cần nhãn giám sát nếu huấn luyện trên dữ liệu đã lọc. SEER tìm hiểu liệu kiến trúc lớn có học biểu diễn chính xác từ lượng lớn ảnh ngẫu nhiên, chưa tuyển chọn và chưa có nhãn hay không.
Học đặc trưng thị giác ở quy mô lớn
Các mô hình trước hưởng lợi từ tiền huấn luyện giám sát yếu, giám sát và bán giám sát trên tập lớn có nhãn cùng hàng triệu ảnh đã lọc. Phân tích cũng cho thấy tiền huấn luyện trên hàng tỷ ảnh thường chính xác hơn huấn luyện từ đầu.
Huấn luyện quy mô lớn thường lọc ảnh để khớp khái niệm mục tiêu. Bước lọc dùng dự đoán của bộ phân loại đã tiền huấn luyện hoặc hashtag tương ứng với nhóm từ đồng nghĩa của các lớp ImageNet . SEER học đặc trưng từ ảnh ngẫu nhiên nên không tuyển chọn dữ liệu để khớp tập khái niệm hay đặc trưng định trước.
Mở rộng kiến trúc nhận dạng ảnh
Kiến trúc lớn có thể học đặc trưng tốt hơn. Khi tiền huấn luyện với dữ liệu lớn, mô hình dung lượng hạn chế dễ khớp thiếu nên cần kiến trúc lớn. Điều này càng quan trọng với học tương phản, vì phải phân biệt các mẫu để học biểu diễn tốt hơn.
Mở rộng nhận dạng ảnh không chỉ là thay chiều sâu và chiều rộng. Xây mô hình dung lượng cao mà mở rộng hiệu quả cần nhiều nghiên cứu. SEER cho thấy lợi ích của họ mô hình RegNets đối với học tự giám sát quy mô lớn.
Phương pháp và thành phần của SEER
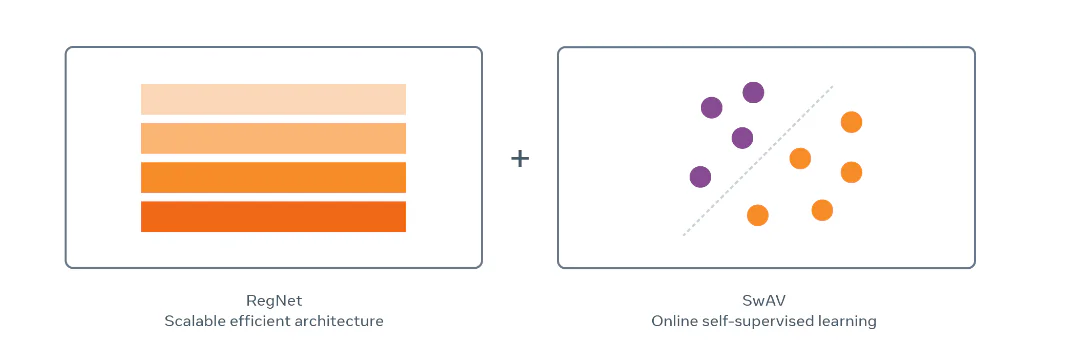
SEER dùng nhiều phương pháp để tiền huấn luyện biểu diễn thị giác. Hai thành phần chính là RegNet và SwAV. Hãy xem ngắn gọn từng phần.
Tiền huấn luyện tự giám sát với SwAV
SEER được tiền huấn luyện bằng SwAV, cách học tự giám sát trực tuyến. SwAV là phương pháp phân cụm trực tuyến để huấn luyện mạng tích chập không cần chú thích. Nó học embedding tạo gán cụm nhất quán giữa các góc nhìn của cùng ảnh, rồi học biểu diễn ngữ nghĩa từ cụm bất biến trước tăng cường dữ liệu.
SwAV so sánh đặc trưng của các góc nhìn bằng cách gán cụm độc lập. Nếu các gán này nắm bắt đặc trưng giống hoặc tương tự nhau, đặc trưng của một góc nhìn có thể dự đoán gán cụm của góc nhìn kia.
SEER xét K cụm, mỗi cụm gắn với một vectơ có thể học, kích thước d , ký hiệu vk. Với một lô gồm B ảnh, mỗi ảnh i được biến đổi thành hai góc nhìn: xi1 và xi2. Mạng tích chập trích đặc trưng thành hai tập: (f11, …, fB2) và (f12, …, fB2). Mỗi tập được gán độc lập vào nguyên mẫu cụm bằng bộ giải vận chuyển tối ưu .
Bộ giải phân bố đều đặc trưng giữa các cụm, tránh nghiệm tầm thường khi mọi biểu diễn đều ánh xạ về một nguyên mẫu. Sau đó hoán đổi gán cụm giữa hai tập: gán yi1 của góc nhìn xi1 phải được dự đoán bằng biểu diễn đặc trưng fi2 của góc nhìn xi2, và ngược lại.
Trọng số nguyên mẫu và mạng tích chập được huấn luyện để tối thiểu hóa mất mát trên mọi mẫu. Mất mát dự đoán cụm l về bản chất là entropy chéo giữa softmax của tích vô hướng của f và gán cụm.

RegNetY: họ mô hình mở rộng hiệu quả
Mở rộng dung lượng và dữ liệu cần kiến trúc hiệu quả cả về bộ nhớ lẫn thời gian chạy. RegNets được thiết kế cho mục đích đó.
Không gian thiết kế RegNet gồm mạng tích chập bốn giai đoạn; mỗi giai đoạn là chuỗi khối giống nhau với cấu trúc cố định, chủ yếu là khối nút thắt phần dư.
SEER tập trung vào RegNetY và thêm Squeeze-and-Excitation vào RegNets chuẩn để cải thiện hiệu suất. Năm tham số giúp tìm cấu hình tốt với số FLOPs cố định và tài nguyên hợp lý. SEER áp dụng RegNetY trực tiếp cho tiền huấn luyện tự giám sát.
Kiến trúc RegNetY 256GF SEER chủ yếu dùng RegNetY 256GF, với tham số tuân theo quy tắc mở rộng RegNets. Cấu hình như sau.

Bốn giai đoạn có chiều rộng (528, 1056, 2904, 7392), chiều sâu (2, 7, 17, 1), tổng hơn 696 triệu tham số. Trên 512 GPU NVIDIA V100 32 GB, một vòng với lô 8.704 ảnh mất khoảng 6.125 ms. Huấn luyện hơn một tỷ ảnh với lô này trên hơn 512 GPU cần 114.890 vòng, khoảng tám ngày.
Tối ưu hóa và huấn luyện quy mô lớn
SEER đề xuất các điều chỉnh để áp dụng phương pháp tự giám sát ở quy mô lớn:
- Lịch tốc độ học.
- Giảm bộ nhớ trên mỗi GPU.
- Tối ưu tốc độ huấn luyện.
- Dữ liệu tiền huấn luyện quy mô lớn.
Hãy xem ngắn gọn.
Lịch tốc độ học
SEER xét hai lịch: lịch tốc độ học cosin và lịch tốc độ học cố định.
Lịch cosin thích ứng với số cập nhật nên giúp so sánh công bằng giữa mô hình. Tuy nhiên, nó ít phù hợp quy mô lớn vì gán trọng số khác nhau theo thời điểm ảnh xuất hiện và dùng tổng số cập nhật để lập lịch.
Lịch cố định giữ tốc độ học cho đến khi mất mát không còn giảm, rồi chia đôi. Phân tích cho thấy lịch này linh hoạt và tốt hơn. Nhưng vì mô hình lớn nhất chỉ huấn luyện một tỷ ảnh, SEER vẫn dùng cosin cho RegNet 256GF.
Giảm bộ nhớ trên mỗi GPU
Độ chính xác hỗn hợp và lưu điểm kiểm tra gradient giúp giảm tài nguyên GPU. Mức tối ưu O1 của NVIDIA Apex thực hiện tích chập và GEMM ở dấu phẩy động 16 bit. Gradient checkpointing của PyTorch đổi thêm tính toán lấy tiết kiệm bộ nhớ.
Các kích hoạt trung gian ở lượt truyền xuôi bị bỏ và được tính lại trong lượt truyền ngược.
Tối ưu tốc độ huấn luyện
Độ chính xác hỗn hợp cũng tăng thông lượng. Bộ tăng tốc tận dụng FP16 nhỏ hơn FP32, giảm nút thắt băng thông bộ nhớ.
SEER đồng bộ lớp BatchNorm giữa GPU theo nhóm tiến trình thay cho đồng bộ toàn cục chậm hơn. Bộ nạp dữ liệu lấy trước nhiều lô, đạt thông lượng cao hơn bộ nạp của PyTorch .
Dữ liệu tiền huấn luyện quy mô lớn
SEER dùng hơn một tỷ ảnh và lấy mẫu ngẫu nhiên trực tiếp từ internet, Instagram. Vì huấn luyện trực tuyến trên ảnh thực tế nên không tiền xử lý, loại ảnh trùng hay lọc hashtag.
Tập dữ liệu không cố định: ảnh được cập nhật ba tháng một lần. Việc cập nhật không ảnh hưởng hiệu suất.
Triển khai SEER
RegNetY 256GF được tiền huấn luyện với SwAV, sáu phần cắt mỗi ảnh, độ phân giải 2×224 + 4×96. MLP ba lớp có các đầu chiếu kích thước 10444×8192, 8192×8192 và 8192×256.
Thay vì BatchNorm ở đầu, SEER dùng 16.000 nguyên mẫu với nhiệt độ t bằng 0,1. Tham số chính quy hóa Sinkhorn là 0,05 và thuật toán chạy mười vòng. Thống kê BatchNorm đồng bộ giữa GPU qua các nhóm tiến trình kích thước 64.
Mô hình dùng bộ tối ưu LARS, tức Layer-wise Adaptive Rate Scaling, suy giảm trọng số 10-5, điểm kiểm tra kích hoạt và độ chính xác hỗn hợp O1. SGD huấn luyện với lô 8.192 ảnh ngẫu nhiên trên 512 GPU NVIDIA, tức 16 ảnh/GPU.
Trong 8.000 cập nhật đầu, tốc độ học tăng tuyến tính từ 0,15 lên 9,6. Sau khởi động, lịch cosin giảm về 0,0096. Tổng cộng SEER học hơn một tỷ ảnh trong 122.000 vòng.
Kết quả của SEER
Chất lượng đặc trưng tự giám sát được đánh giá trên nhiều chuẩn và tác vụ tiếp theo. Mô hình cũng xét trường hợp ít mẫu, với quyền truy cập ảnh và nhãn hạn chế.
Tinh chỉnh mô hình tiền huấn luyện lớn
Mô hình tiền huấn luyện trên dữ liệu ngẫu nhiên được chuyển sang phân loại đối tượng ImageNet để đo chất lượng, theo các điều kiện sau.
Thiết lập thí nghiệm
Tiền huấn luyện sáu kiến trúc khác dung lượng: RegNetY-{8,16,32,64,128,256}GF bằng SwAV trên hơn một tỷ ảnh Instagram công khai, ngẫu nhiên. Sau đó tinh chỉnh trên ImageNet với hơn 1,28 triệu ảnh huấn luyện có nhãn đúng và hơn 50 nghìn ảnh kiểm định.
Dùng tăng cường dữ liệu như SwAV và tinh chỉnh 35 epoch bằng SGD, lô 256, tốc độ học 0,0125 giảm mười lần sau 30 epoch. Động lượng 0,9 và suy giảm trọng số 10-4. Báo cáo độ chính xác top-1 trên tập kiểm định với phần cắt giữa 224×224.
So sánh các cách tiền huấn luyện tự giám sát khác
Bảng so sánh mô hình lớn nhất RegNetY-256GF với các mô hình tự giám sát tiền huấn luyện hiện có.

SEER đạt 84,2% top-1 trên ImageNet, cao hơn SimCLRv2, mô hình tốt nhất trước đó, 1%.
Hình tiếp theo so sánh nhiều dung lượng. Dù dung lượng nào, kết hợp RegNet với SwAV cho kết quả tiền huấn luyện chính xác.

SEER dùng ảnh ngẫu nhiên chưa tuyển chọn với RegNet và SwAV. Nó được so sánh với SimCLRv2 và ViT có kiến trúc khác, sau đó tinh chỉnh ImageNet và báo cáo top-1.
Ảnh hưởng của dung lượng mô hình
Dung lượng ảnh hưởng đáng kể đến tiền huấn luyện. Hình so sánh tác động với huấn luyện từ đầu.

Mô hình tiền huấn luyện có top-1 cao hơn, và khoảng cách tăng khi số tham số tăng. Dung lượng lớn giúp cả hai cách, nhưng tác động mạnh hơn đối với mô hình tiền huấn luyện khi có nhiều tham số.
Tập ImageNet nhỏ có thể là lý do mô hình huấn luyện từ đầu bị quá khớp.
Học với ít mẫu
Đánh giá SEER trong trường hợp ít mẫu, tức tác vụ tiếp theo chỉ dùng một phần tổng dữ liệu.
Thiết lập thí nghiệm
Hai tập dữ liệu được dùng là Places205 và ImageNet. Khi học chuyển giao, cả ảnh lẫn nhãn đều bị hạn chế. Điều này khác thiết lập tự giám sát thường thấy, nơi xem được mọi ảnh và chỉ giới hạn nhãn.
-
Kết quả trên Places205
Hình cho thấy tác động của tiền huấn luyện với các tỷ lệ dữ liệu Places205 khác nhau.

So với cùng RegNetY-128GF tiền huấn luyện có giám sát trên ImageNet, cách này tăng top-1 ổn định khoảng 2,5%, bất kể tỷ lệ dữ liệu dùng để tinh chỉnh Places205.
Khác biệt có thể do tính chất dữ liệu: đặc trưng từ ảnh thực tế ngẫu nhiên phù hợp hơn với phân loại cảnh. Phân bố khái niệm không đồng đều cũng có thể có lợi trên tập mất cân bằng như Places205.
Kết quả trên ImageNet

Bảng so sánh SEER với các cách tự giám sát và bán giám sát ít mẫu. Những cách kia dùng toàn bộ 1,2 triệu ảnh ImageNet để tiền huấn luyện và chỉ hạn chế nhãn. SEER chỉ xem 1–10% ảnh của tập này.
Xem nhiều ảnh cùng phân bố mang lại lợi thế lớn cho phương pháp khác. Dù chỉ xem 1–10% ImageNet, SEER vẫn đạt top-1 khoảng 80%, chỉ thấp hơn một chút so với các cách trong bảng.
Ảnh hưởng của dung lượng mô hình
Hình phân tích dung lượng trong học ít mẫu với 1%, 10% và 100% ImageNet.

Tăng dung lượng có thể cải thiện độ chính xác khi giảm quyền truy cập cả ảnh và nhãn.
Chuyển sang các chuẩn khác
Để đánh giá sâu hơn, đặc trưng tiền huấn luyện được chuyển sang các tác vụ tiếp theo khác.
Đánh giá tuyến tính phân loại ảnh

Bảng so sánh đặc trưng RegNetY-256GF của SEER với RegNetY-128GF cùng kiến trúc được tiền huấn luyện trên ImageNet, có và không giám sát. Giữ cố định trọng số và huấn luyện bộ phân loại tuyến tính trên đặc trưng bằng dữ liệu tác vụ tiếp theo. Các chuẩn là Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) và Pascal VOC (VOC).
Phát hiện và phân đoạn
Hình tiếp theo so sánh, đánh giá đặc trưng tiền huấn luyện cho phát hiện và phân đoạn.

SEER huấn luyện Mask-RCNN trên COCO với RegNetY-64GF và RegNetY-128GF tiền huấn luyện làm thành phần. Cả hai kiến trúc và tác vụ đều tốt hơn huấn luyện có giám sát 1,5–2 điểm AP.
So sánh tiền huấn luyện giám sát yếu
Ảnh internet thường có mô tả, văn bản thay thế hoặc vị trí để hỗ trợ tiền huấn luyện. Nghiên cứu trước cho thấy dự đoán tập hashtag được tuyển chọn hay gắn nhãn có thể nâng chất lượng đặc trưng. Nhưng cách này cần lọc ảnh và tốt nhất khi có siêu dữ liệu văn bản.
Hình so sánh top-1 của ResNetXt101-32dx8d huấn luyện trên ảnh ngẫu nhiên với cùng kiến trúc trên ảnh có nhãn, hashtag và siêu dữ liệu.

Dù không dùng siêu dữ liệu khi tiền huấn luyện, SEER có độ chính xác tương đương mô hình có dùng.
Nghiên cứu loại bỏ thành phần
Loại hẳn một thành phần rồi đo hiệu suất giúp hiểu ảnh hưởng của nó đối với toàn mô hình.
Ảnh hưởng của kiến trúc
Kiến trúc tác động mạnh đến hiệu suất, nhất là khi mở rộng hoặc thay đặc điểm dữ liệu tiền huấn luyện.
Hình dùng đánh giá tuyến tính ImageNet để đo thay đổi chất lượng đặc trưng theo kiến trúc. Có thể khảo sát trực tiếp vì đánh giá không ưu ái mô hình đạt độ chính xác cao khi học từ đầu trên ImageNet.

Với cấu hình hiện tại, đặc trưng tầng áp chót tốt hơn ở ResNeXt và ResNet; RegNet vượt các kiến trúc khác.
Tăng dung lượng nhìn chung cải thiện đặc trưng, với mức tăng hiệu suất theo logarit.
Mở rộng dữ liệu tiền huấn luyện
Hai lý do tăng dữ liệu có thể cải thiện đặc trưng là nhiều ảnh riêng biệt hơn và nhiều tham số hơn. Hãy xét tác động của chúng.
Tăng số ảnh riêng biệt

Hình so sánh RegNet8 và RegNet16 với cùng số tham số nhưng số ảnh riêng biệt khác nhau. SEER dùng số cập nhật tương ứng một epoch trên một tỷ ảnh hoặc 32 epoch trên 32 ảnh riêng biệt, với lịch tốc độ học nửa sóng cosin.
Để có hiệu suất tốt, lý tưởng là số ảnh riêng biệt cao. Trong trường hợp này, mô hình tốt khi số đó vượt số ảnh ImageNet.
Nhiều tham số hơn
Hình cho thấy RegNet-128GF học trên một tỷ ảnh. Hiệu suất tăng đều khi tăng số tham số.

Thị giác máy tính tự giám sát trong thực tế
Sau phần lý thuyết, hãy xem cách hoạt động thực tế và vì sao SEER là hướng tương lai của thị giác máy tính tự giám sát.
SEER sánh với tiến bộ xử lý ngôn ngữ tự nhiên, nơi mô hình hàng đầu dùng hàng nghìn tỷ tập dữ liệu và tham số cùng hàng nghìn tỷ từ khi tiền huấn luyện. Nhiều dữ liệu đầu vào hơn thường cải thiện tác vụ tiếp theo, kể cả trong thị giác máy tính.
Tuy nhiên, văn bản và ảnh khác nhau. Khái niệm ngữ nghĩa của văn bản thường chia thành từ riêng; với ảnh, mô hình phải quyết định điểm ảnh nào thuộc khái niệm nào.
Ảnh có góc nhìn khác nhau; cùng đối tượng nhưng khái niệm thay đổi. Một con mèo có thể đứng yên ở ảnh này và chơi bóng ở ảnh khác. Cần xem nhiều ảnh để hiểu các khác biệt quanh cùng khái niệm.
Mở rộng hiệu quả với dữ liệu ảnh phức tạp, nhiều chiều cần hai yếu tố:
- Mạng nơ-ron tích chập (CNN) đủ lớn để nắm bắt và học khái niệm thị giác từ lượng ảnh rất lớn.
- Thuật toán học mẫu từ nhiều ảnh mà không cần nhãn, chú thích hay siêu dữ liệu.
SEER đưa hai yếu tố vào thị giác máy tính. Nó khai thác SwAV, dùng phân cụm trực tuyến để nhóm hoặc ghép ảnh có khái niệm thị giác tương tự và tận dụng điểm giống nhau để tìm mẫu tốt hơn.
SwAV giúp tự giám sát hiệu quả hơn và giảm thời gian huấn luyện tới sáu lần.
Huấn luyện hơn một tỷ ảnh đòi hỏi kiến trúc hiệu quả cả thời gian, bộ nhớ và độ chính xác. RegNet là mạng tích chập có thể mở rộng tới hàng nghìn tỷ tham số và tối ưu theo giới hạn bộ nhớ, thời gian chạy.
Kết luận: tương lai tự giám sát
Học tự giám sát được quan tâm vì mô hình học trực tiếp từ lượng lớn dữ liệu ngẫu nhiên trên internet, thay vì chỉ dựa vào tập được tuyển chọn, gắn nhãn riêng cho huấn luyện AI.
Nó quan trọng với tương lai AI và ML vì có thể tạo mô hình thích ứng thực tế, dùng cho nhiều việc thay vì một mục đích. SEER là cột mốc triển khai trong thị giác máy tính.
SEER là bước đầu thay đổi lĩnh vực và giảm phụ thuộc dữ liệu có nhãn. Loại nhu cầu chú thích giúp nhà phát triển dùng dữ liệu đa dạng, lớn hơn, đặc biệt hữu ích ở lĩnh vực ít ảnh hoặc siêu dữ liệu như y tế.
Bỏ chú thích thủ công cũng giúp phát triển, triển khai nhanh hơn và phản ứng chính xác, kịp thời với tình huống thay đổi.



