
Góc nhìn Anderson
Xác định Deepfake của Người nổi tiếng từ Vùng mặt ngoài

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
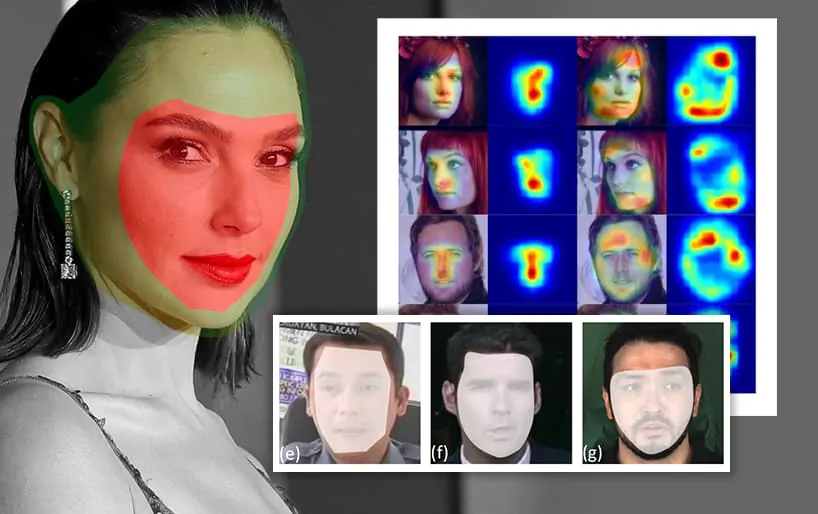
Một sự hợp tác mới giữa Microsoft (MSFT ) và một trường đại học Trung Quốc đã đề xuất một phương pháp mới để xác định deepfake của người nổi tiếng, bằng cách tận dụng những hạn chế của các kỹ thuật deepfake hiện tại để nhận ra các bản sắc đã được ‘đặt’ lên người khác.
Phương pháp này được gọi là Transformer Đồng nhất Hóa (ICT), và hoạt động bằng cách so sánh các phần ngoài cùng của khuôn mặt (cằm, gò má, đường chân tóc, và các đường nét ngoài khác) với phần bên trong của khuôn mặt. Hệ thống này khai thác dữ liệu hình ảnh công khai sẵn có của những người nổi tiếng, điều này hạn chế hiệu quả của nó đối với những người nổi tiếng, những hình ảnh của họ có sẵn với số lượng lớn trong các tập dữ liệu tầm nhìn máy tính và trên internet.

Các vùng phủ của khuôn mặt giả mạo trên bảy kỹ thuật: DeepFake trong FF+; DeepFake trong Google DeepFake Detection; DeepFaceLab; Face2Face; FSGAN; và DF-VAE. Các gói phổ biến như DeepFaceLab và FaceSwap cung cấp vùng phủ tương tự. Nguồn: https://arxiv.org/pdf/2203.01318.pdf
Como hình ảnh trên cho thấy, các phương pháp phổ biến hiện tại để tạo deepfake khá hạn chế về tài nguyên, và phụ thuộc vào các khuôn mặt chủ (hình ảnh hoặc video của một người sẽ có bản sắc được thay thế bằng deepfake) để giảm thiểu bằng chứng về việc thay thế khuôn mặt.
Mặc dù các phương pháp khác nhau có thể bao gồm toàn bộ trán và một phần lớn của cằm và gò má, nhưng tất cả đều bị giới hạn trong khuôn mặt chủ.

Một bản đồ saliency nhấn mạnh các bản sắc ‘bên trong’ và ‘bên ngoài’ được tính toán bởi ICT. Khi một bản sắc khuôn mặt bên trong được thiết lập nhưng bản sắc bên ngoài không tương ứng, ICT đánh giá hình ảnh là giả mạo.
Trong các thử nghiệm, ICT đã chứng minh khả năng phát hiện nội dung deepfake trong các điều kiện thuận lợi cho deepfake như video độ phân giải thấp, nơi nội dung của toàn bộ video bị suy giảm bởi các artifact nén, giúp che giấu bằng chứng còn lại của quá trình deepfake – một tình huống mà nhiều phương pháp phát hiện deepfake khác bị bối rối.

ICT vượt trội trong việc nhận ra nội dung deepfake. Xem video nhúng ở cuối bài viết để có thêm ví dụ và độ phân giải tốt hơn. Xem video nguồn nhúng ở cuối bài viết để có thêm ví dụ. Nguồn: https://www.youtube.com/watch?v=zgF50dcymj8
Bài báo này có tiêu đề Bảo vệ Người nổi tiếng với Transformer Đồng nhất Hóa, và đến từ chín nhà nghiên cứu thuộc các trường đại học khác nhau, bao gồm Đại học Khoa học và Công nghệ Trung Quốc, Microsoft Research Asia, và Microsoft Cloud + AI.
Khoảng cách Tin cậy
Có ít nhất một vài lý do tại sao các thuật toán thay thế khuôn mặt phổ biến như DeepFaceLab và FaceSwap bỏ qua vùng ngoài cùng của các bản sắc khuôn mặt được thay thế.
Thứ nhất, việc đào tạo mô hình deepfake tốn thời gian và tài nguyên, và việc áp dụng các khuôn mặt chủ/bodies phù hợp giúp giải phóng các chu kỳ và kỷ của GPU để tập trung vào các vùng bên trong khuôn mặt tương đối không đổi, mà chúng ta sử dụng để phân biệt bản sắc (vì các biến như sự thay đổi trọng lượng và lão hóa ít có khả năng thay đổi các đặc điểm khuôn mặt cốt lõi trong thời gian ngắn).
Thứ hai, hầu hết các phương pháp deepfake (và đây là trường hợp với DeepFaceLab, phần mềm được sử dụng bởi các nhà thực hành nổi tiếng hoặc tai tiếng nhất) có khả năng hạn chế trong việc sao chép các vùng ‘cuối khuôn mặt’ như gò má và cằm, và bị giới hạn bởi thực tế rằng mã nguồn thượng游 (2017) không giải quyết rộng rãi vấn đề này.
Trong các trường hợp mà các bản sắc không phù hợp, thuật toán deepfake phải ‘tô màu’ các vùng nền xung quanh khuôn mặt, điều mà nó làm một cách vụng về, thậm chí trong tay của những người tạo deepfake giỏi nhất, như Ctrl Shift Face, những người đã sử dụng trong các nghiên cứu của bài báo.

Những người giỏi nhất: ảnh tĩnh từ video deepfake của Ctrl-Shift-Face, thay thế Jim Carrey lên Gary Oldman. Công việc này có thể đại diện cho một số kết quả tốt nhất hiện có thông qua DeepFaceLab và các kỹ thuật hậu xử lý. Tuy nhiên, các swap vẫn bị giới hạn ở vùng ngoài khuôn mặt mà DFL dành sự chú ý tương đối ít, đòi hỏi một nỗ lực khổng lồ về thu thập và đào tạo dữ liệu để giải quyết các đường nét ngoài cùng. Nguồn: https://www.youtube.com/watch?v=x8igrh1eyLk
Sự ‘mánh lới’ này, hoặc sự chuyển hướng chú ý, phần lớn thoát khỏi sự chú ý của công chúng trong mối quan tâm hiện tại về sự phát triển của deepfake, vì các khả năng phân biệt của chúng ta về deepfake vẫn đang phát triển vượt qua giai đoạn ‘sốc và kinh ngạc’.
Bản sắc Phân chia
Bài báo mới lưu ý rằng hầu hết các phương pháp phát hiện deepfake trước đó dựa vào các artifact mà phản ánh quá trình swap, như đầu tư không nhất quán và chớp mắt, trong số nhiều kỹ thuật khác. Chỉ trong tuần này, một bài báo phát hiện deepfake mới đã đề xuất sử dụng ‘chữ ký’ của các loại mô hình khác nhau trong khuôn khổ FaceSwap để giúp xác định video giả mạo được tạo ra với nó (xem hình ảnh dưới đây).

Xác định deepfake bằng cách đặc trưng hóa các chữ ký của các loại mô hình khác nhau trong khuôn khổ FaceSwap. Nguồn: https://arxiv.org/pdf/2202.12951.pdf
Ngược lại, kiến trúc của ICT tạo ra hai bản sắc phân chia riêng biệt cho một người, mỗi bản sắc phải được xác minh trước khi toàn bộ bản sắc được kết luận là ‘thật’ hoặc ‘giả mạo’.

Kiến trúc cho các giai đoạn đào tạo và thử nghiệm của ICT.
Sự phân chia bản sắc được tạo điều kiện bởi một bộ chuyển đổi tầm nhìn Transformer, thực hiện xác định khuôn mặt trước khi chia các vùng được khảo sát thành các token thuộc về bản sắc bên trong hoặc bên ngoài.

Phân phối các patch trong hai bản sắc song song.
Bài báo tuyên bố:
‘Thật không may, các phương pháp xác thực khuôn mặt hiện có thường đặc trưng hóa vùng phân biệt nhất, tức là khuôn mặt bên trong để xác thực và không thể nắm bắt thông tin bản sắc trong khuôn mặt bên ngoài. Với Transformer Đồng nhất Hóa, chúng tôi đào tạo một mô hình để học một cặp vector bản sắc, một cho khuôn mặt bên trong và một cho khuôn mặt bên ngoài, bằng cách thiết kế một Transformer để các bản sắc bên trong và bên ngoài có thể được học đồng thời trong một mô hình thống nhất.’
Vì không có mô hình hiện có cho giao thức xác định này, các tác giả đã tạo ra một loại tổn thất nhất quán mới có thể hoạt động như một thước đo cho tính xác thực. Các token ‘bên trong’ và ‘bên ngoài’ kết quả từ mô hình trích xuất bản sắc được thêm vào các patch embeddings được tạo ra bởi các khuôn khổ xác định khuôn mặt.
Dữ liệu và Đào tạo
Mạng ICT được đào tạo trên tập dữ liệu MS-Celeb-1M của Microsoft Research, chứa 10 triệu hình ảnh khuôn mặt của người nổi tiếng, bao gồm các diễn viên, chính trị gia và nhiều loại người nổi tiếng khác. Theo thủ tục của phương pháp trước đó Face X-ray (một sáng kiến khác của Microsoft Research), quy trình tạo giả của ICT hoán đổi các vùng bên trong và bên ngoài của khuôn mặt từ tập dữ liệu này để tạo ra vật liệu để thử nghiệm thuật toán.
Để thực hiện các hoán đổi bên trong, ICT xác định hai hình ảnh trong tập dữ liệu có tư thế đầu và các điểm mốc khuôn mặt tương tự, tạo ra một vùng mặt nạ của các đặc điểm trung tâm (vào đó một hoán đổi có thể được thực hiện), và thực hiện một hoán đổi deepfake với chỉnh sửa màu RGB.
Lý do tại sao ICT bị giới hạn ở việc xác định người nổi tiếng là vì nó phụ thuộc (trong biến thể hiệu quả nhất) vào một tập dữ liệu tham chiếu mới kết hợp các vector khuôn mặt được dẫn xuất từ một tập dữ liệu trung tâm (trong trường hợp này là MS-Celeb-1M, mặc dù việc tham chiếu có thể được mở rộng đến hình ảnh có sẵn trên mạng, điều này chỉ có khả năng tồn tại với số lượng và chất lượng đủ cho các nhân vật công chúng nổi tiếng).
Các vector đôi này hoạt động như các token xác thực để xác minh các vùng khuôn mặt bên trong và bên ngoài đồng thời.
Các tác giả lưu ý rằng các token thu được từ các phương pháp này đại diện cho các tính năng ‘cấp cao’, dẫn đến một quá trình phát hiện deepfake có khả năng sống sót trong các môi trường đầy thách thức như video độ phân giải thấp hoặc bị suy giảm khác.
Quan trọng là, ICT không tìm kiếm bằng chứng dựa trên artifact, mà tập trung vào các phương pháp xác thực bản sắc hơn, phù hợp với các kỹ thuật nhận dạng khuôn mặt – một cách tiếp cận khó khăn với dữ liệu khối lượng thấp, như trong trường hợp điều tra các vụ deepfake trả thù chống lại các mục tiêu không nổi tiếng.
Thử nghiệm
Được đào tạo trên MS-Celeb-1M, ICT sau đó được chia thành các phiên bản hỗ trợ tham chiếu và ‘mù’ của thuật toán, và được thử nghiệm trên một loạt các tập dữ liệu và phương pháp cạnh tranh. Những thử nghiệm này bao gồm FaceForensics++ (FF++), một tập dữ liệu gồm 1000 video xác thực và deepfake được tạo ra trên bốn phương pháp bao gồm Face2Face và FaceSwap; Phát hiện Deepfake (DFD) của Google, cũng bao gồm hàng nghìn video deepfake được tạo ra bởi Google; Celeb-DeepFake v1 (CD1), có 408 video thực và 795 video được tổng hợp, độ phân giải thấp; Celeb-DeepFake v2, một mở rộng của V1 chứa 590 video thực và 5.639 video giả; và Deeper-Forensics (Deeper) của Trung Quốc năm 2020.
Các phương pháp phát hiện trong các thử nghiệm bao gồm Nhiều nhiệm vụ, MesoInc4, Capsule, Xception-c0, c2 (một phương pháp được sử dụng trong FF++), FWA/DSP-FW từ Đại học Albany, Hai nhánh, PCL+I2G, và phương pháp không đồng nhất ngữ cảnh của Yuval Nirkin.
Các phương pháp phát hiện này nhằm mục đích phát hiện các loại thao túng khuôn mặt cụ thể. Ngoài ra, các tác giả của bài báo mới đã thử nghiệm các phương pháp phát hiện deepfake chung hơn Face X-ray, FFD của Đại học Michigan, CNNDetection, và Patch-Forensics từ MIT CSAIL.
Kết quả rõ ràng nhất từ thử nghiệm là các phương pháp cạnh tranh giảm hiệu quả đáng kể khi độ phân giải và chất lượng video giảm. Vì một số khả năng xâm nhập sâu của deepfake vào khả năng phân biệt của chúng ta nằm (không chỉ ở thời điểm hiện tại) trong video không phải HD hoặc bị suy giảm chất lượng khác, điều này dường như là một kết quả quan trọng.

Trong đồ thị kết quả trên, các đường màu xanh và đỏ chỉ ra khả năng chống suy giảm của các phương pháp ICT trong tất cả các lĩnh vực ngoại trừ chướng ngại vật của nhiễu Gaussian (không phải là khả năng trong các cảnh quay Zoom và webcam), trong khi độ tin cậy của các phương pháp cạnh tranh giảm mạnh.
Trong bảng kết quả dưới đây, chúng ta thấy hiệu quả của các phương pháp phát hiện deepfake khác nhau trên các tập dữ liệu không nhìn thấy. Các kết quả màu xám và có dấu hoa thị chỉ ra so sánh từ các kết quả được xuất bản ban đầu trong các dự án mã nguồn đóng, không thể được xác minh bên ngoài. Trên hầu hết các khuôn khổ so sánh, ICT vượt trội so với các phương pháp phát hiện deepfake đối thủ (được hiển thị in đậm) trên các tập dữ liệu được thử nghiệm.

Để thử nghiệm thêm, các tác giả đã chạy nội dung từ kênh YouTube của Ctrl Shift Face, và tìm thấy các phương pháp cạnh tranh đạt được điểm nhận dạng thấp hơn đáng kể:

Đáng chú ý là các phương pháp FF++ (Xception-c23) và FFD, đạt được một số điểm cao nhất trên một số dữ liệu thử nghiệm trong các thử nghiệm chung của bài báo, ở đây đạt điểm thấp hơn nhiều so với ICT trong một bối cảnh ‘thế giới thực’ của nội dung deepfake có nỗ lực cao.
Các tác giả kết thúc bài báo với hy vọng rằng kết quả của nó sẽ hướng dẫn cộng đồng phát hiện deepfake tập trung vào các sáng kiến tương tự tập trung vào các tính năng cấp cao dễ dàng khái quát hóa hơn, và tránh xa ‘chiến tranh lạnh’ của phát hiện artifact, trong đó các phương pháp mới nhất thường bị làm cho kém hiệu quả bởi các phát triển trong các khuôn khổ deepfake, hoặc bởi các yếu tố khác làm cho các phương pháp như vậy kém hiệu quả hơn.
Xem video bổ sung dưới đây để có thêm ví dụ về ICT xác định nội dung deepfake thường vượt trội so với các phương pháp thay thế.
Được xuất bản lần đầu vào ngày 4 tháng 3 năm 2022.


