
Phỏng vấn
Fabiana Clemente, Đồng sáng lập và Giám đốc Dữ liệu tại YData – Loạt phỏng vấn

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
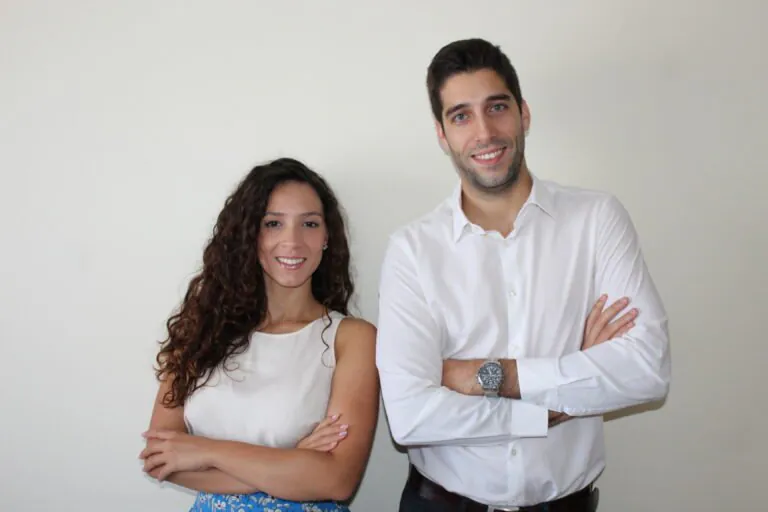
Fabiana Clemente là Đồng sáng lập và Giám đốc Dữ liệu tại YData. YData là một công ty khởi nghiệp về trí tuệ nhân tạo đã tạo ra giải pháp phát triển dựa trên dữ liệu đầu tiên để kết hợp khám phá dữ liệu, cải thiện và mở rộng quy mô trên một nền tảng duy nhất.
Điều gì ban đầu thu hút bạn đến với trí tuệ nhân tạo và học máy?
Nền tảng của tôi là Toán học Ứng dụng, nơi tôi có cơ hội học và hiểu cách chúng ta có thể trích xuất thông tin từ dữ liệu cũng như thực hiện nó bằng cách sử dụng mã. Vào thời điểm đó, nó không được coi là “sexy” như Học máy nhưng nó chắc chắn là điều đã khơi dậy niềm đam mê của tôi với lĩnh vực này.
Có thể bạn chia sẻ câu chuyện về sự ra đời của Ydata?
Là một Nhà khoa học Dữ liệu đã từng làm việc cho cả các công ty khởi nghiệp và doanh nghiệp, tôi đã phải đối mặt với không ít khó khăn – đôi khi việc tiếp cận dữ liệu bị chặn vì lý do bảo mật hoặc quyền riêng tư, và đôi khi việc tiếp cận dữ liệu dễ dàng nhưng chất lượng dữ liệu không gần với mức cần thiết để xây dựng các giải pháp dựa trên trí tuệ nhân tạo. Biết rằng những khó khăn này rất phổ biến trong hầu hết các tổ chức, đã truyền cảm hứng cho chúng tôi bắt đầu công ty với mục tiêu giúp các đội này vượt qua những chướng ngại vật này bằng cách tăng tốc phát triển trí tuệ nhân tạo với dữ liệu được cải thiện.
Có thể bạn mô tả cho khán giả của chúng tôi về dữ liệu tổng hợp là gì?
Dữ liệu tổng hợp được coi là bất kỳ dữ liệu nào không được tạo ra trong thế giới thực, tức là bất kỳ dữ liệu nào được tạo ra một cách nhân tạo. Có các phương pháp cho phép tạo ra dữ liệu tổng hợp – từ các chiến lược dựa trên quy tắc đến việc sử dụng các mô hình Học máy hoặc Học sâu để học các “quy tắc” đó cho chúng tôi. Tại YData, chúng tôi đã áp dụng và chuyên môn hóa một chiến lược dựa trên Học sâu để tạo ra dữ liệu mới giữ lại hành vi từ các sự kiện trong thế giới thực mà không có mối quan ngại về quyền riêng tư.
Điều gì làm cho dữ liệu tổng hợp trở nên quan trọng?
Càng nhiều tổ chức nhận ra tầm quan trọng của dữ liệu để thúc đẩy kinh doanh của họ, tầm quan trọng và vai trò của dữ liệu tổng hợp sẽ được hiểu rõ hơn. Việc thu thập dữ liệu thực không chỉ tốn thời gian và tốn kém mà đôi khi còn không thể thực hiện được. Để xây dựng các ứng dụng trí tuệ nhân tạo, dữ liệu là một yêu cầu khó khăn – đó là nơi dữ liệu tổng hợp đến để giải cứu. Khả năng tạo ra các kịch bản chưa từng thấy hoặc chỉ đơn giản là mở khóa truy cập vào dữ liệu là chìa khóa để phát triển trong một thế giới mà những người tiên phong như Andrew Ng tuyên bố rằng trở thành trung tâm dữ liệu là chìa khóa cho việc áp dụng trí tuệ nhân tạo thành công.
Trong các hoạt động tự lái xe hoặc tự động hóa máy móc khác, chúng ta đã có thể nhận thấy tầm quan trọng của dữ liệu tổng hợp, vì vậy tôi sẽ nói rằng đó là điều tự nhiên khi sự hiểu biết này lan rộng khắp tất cả các lĩnh vực công nghiệp.
Làm thế nào Ydata tạo ra dữ liệu tổng hợp?
YData tận dụng chủ yếu các mô hình Phát sinh Deep để học các thuộc tính thống kê và mối tương quan giữa các biến của dữ liệu ban đầu. Điều này cho phép mô hình tạo ra một tập dữ liệu có liên quan về mặt thống kê có giá trị kinh doanh tương tự như dữ liệu ban đầu, mà không cho phép theo dõi lại các bản ghi ban đầu.
YData đang thúc đẩy công nghệ này tiến về phía trước và là công ty đứng sau Cộng đồng Dữ liệu Tổng hợp – một nhóm các chuyên gia khoa học dữ liệu cam kết truyền bá và giúp bất kỳ ai muốn học và sử dụng công nghệ này.
Làm thế nào nền tảng Ydata giúp khám phá và mở khóa các nguồn dữ liệu mới?
Nền tảng YData bao gồm các kết nối tích hợp sẵn đến bất kỳ loại cơ sở dữ liệu, kho dữ liệu hoặc hồ dữ liệu nào, cho phép người dùng dễ dàng truy cập vào siêu dữ liệu liên quan và hiểu liệu dữ liệu hiện có có hữu ích để trả lời câu hỏi kinh doanh mà họ đang gặp phải – mà không cần phải xem xét các bản ghi thực tế.
Có thể bạn chia sẻ một số chi tiết về Cộng đồng Dữ liệu Tổng hợp Mở?
Dữ liệu tổng hợp chỉ mới đang trong những ngày đầu và vì lý do đó, sự nhận thức về cách nó được tạo ra, lợi ích và hạn chế của nó vẫn còn chưa rõ ràng đối với khán giả lớn hơn. Vì lý do đó, tại YData, chúng tôi đã quyết định đi theo con đường giáo dục bằng cách tạo ra Cộng đồng Dữ liệu Tổng hợp – ngoài việc là một nơi để trao đổi ý tưởng hoặc nhận được sự giúp đỡ từ các chuyên gia trong lĩnh vực dữ liệu tổng hợp, nó cũng là một nơi mà các nhà khoa học dữ liệu và các chuyên gia công nghệ khác có thể bắt đầu hành trình của họ vào dữ liệu tổng hợp, với một số thuật toán thú vị nhất từ văn học.
Hơn nữa, chúng tôi cũng cung cấp một quan điểm về chất lượng dữ liệu, để các nhà khoa học dữ liệu có thể hiểu dữ liệu họ đang làm việc với trước khi tổng hợp hoặc cải thiện tổng hợp dữ liệu. Chúng tôi cam kết giúp các đội dữ liệu trở nên trung tâm dữ liệu hơn.
YData gần đây đã công bố 2,7 triệu đô la tiền vốn để nhanh chóng mở rộng quốc tế. Bạn có thể chia sẻ một số chi tiết về ý nghĩa của điều này đối với tương lai của công ty và chiến lược mở rộng của họ?
YData đã ra đời là một công ty quốc tế – chúng tôi biết rằng loại công nghệ này cần những người áp dụng sớm thường ở các quốc gia tinh vi nhất. Vì lý do đó, khách hàng đầu tiên của chúng tôi đã ở ngoài Bồ Đào Nha, khắp châu Âu và hiện chúng tôi đang thiết lập sự hiện diện ở Bắc Mỹ. Vốn này sẽ cho phép chúng tôi củng cố sự hiện diện của mình ở cả hai lục địa này, không chỉ về mặt thương mại mà còn về việc phát triển đội ngũ: chúng tôi là một đội hoàn toàn phân tán, điều này cho phép chúng tôi tuyển dụng những người có tài năng nhất, bất kể họ ở đâu.
Có điều gì khác mà bạn muốn chia sẻ về YData?
YData đang thúc đẩy rào cản của trí tuệ nhân tạo trung tâm dữ liệu và tạo ra một thể loại mới: DataPrepOps – mặc dù đó là một cái tên không đẹp, nhưng đó là một nỗi đau mà hầu hết các công ty đang phải đối mặt ngày nay khi nói đến phát triển khoa học dữ liệu. Xu hướng Chất lượng Dữ liệu tiếp tục phát triển và sau Data Pipelines và Data Observability, Chất lượng Dữ liệu cho các đội Khoa học Dữ liệu vẫn còn trong giai đoạn sơ sinh và YData đang nổi lên như một nhà lãnh đạo tư tưởng trong lĩnh vực chuẩn bị dữ liệu.
Cảm ơn vì cuộc phỏng vấn tuyệt vời, độc giả muốn tìm hiểu thêm nên truy cập YData.


