
Phỏng vấn
Tiến sĩ Jaime Bland, Đồng sáng lập và CEO của Aquila Health – Loạt phỏng vấn

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
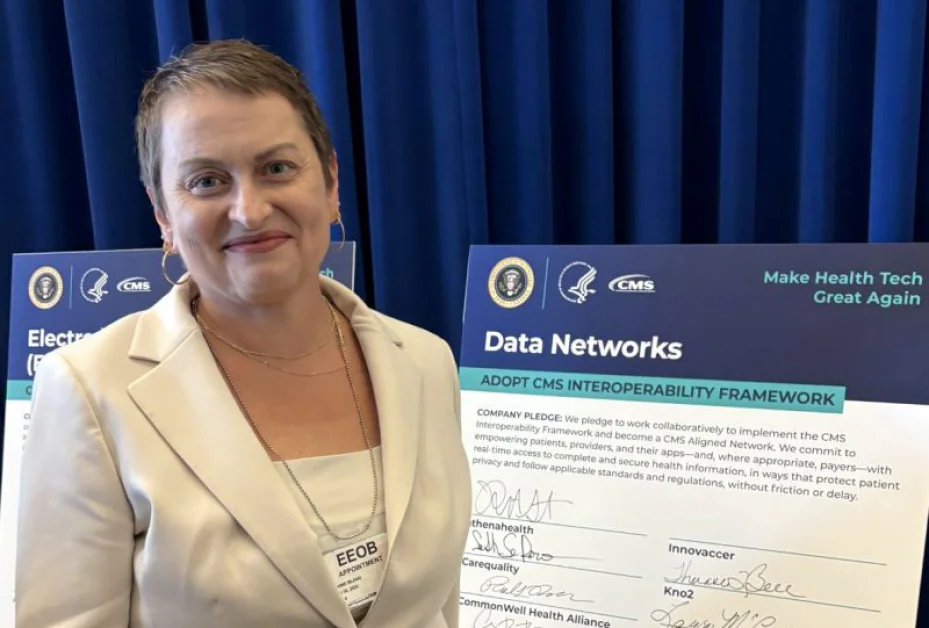
Tiến sĩ Jaime Bland, Đồng sáng lập và CEO của Aquila Health, là một nhà lãnh đạo công nghệ y tế tập trung vào việc giải quyết một trong những thách thức dai dẳng nhất của ngành: dữ liệu phân mảnh và không thể tiếp cận. Cô đồng sáng lập Aquila Health để xây dựng một cơ sở hạ tầng dữ liệu thống nhất cho phép các tổ chức y tế vượt qua các hệ thống bị cô lập, tận dụng học máy và phân tích cấu trúc để tạo ra các thông tin có thể hành động trong khi vẫn duy trì giám sát lâm sàng. Công việc của cô tập trung vào việc cải thiện khả năng tương tác, cho phép thông tin sức khỏe ở cấp độ dân số và hỗ trợ việc phát hiện sớm các mối đe dọa sức khỏe mới nổi thông qua các hệ thống dữ liệu lâm sàng, yêu cầu và di truyền tích hợp.
Aquila Health là một nền tảng dữ liệu y tế được thúc đẩy động bởi AI, được thiết kế để thống nhất các nguồn dữ liệu khác nhau vào một hệ thống tương tác duy nhất, hỗ trợ cả hiệu quả hoạt động và phân tích nâng cao. Nền tảng này tiêu thụ các định dạng dữ liệu y tế có khối lượng lớn như HL7 và FHIR, cho phép tích hợp liền mạch trên các bệnh viện, hệ thống y tế công cộng và các bên liên quan khác. Bằng cách kết hợp các phương pháp học máy có cấu trúc với mô hình xác thực con người trong vòng lặp, Aquila tập trung vào việc cung cấp thông tin đáng tin cậy cho quản lý sức khỏe dân số, phát hiện bất thường và ra quyết định thời gian thực, thay vì chỉ dựa vào các hệ thống AI không rõ ràng. Điều này đặt công ty tại điểm giao nhau của cơ sở hạ tầng dữ liệu và AI ứng dụng, nơi cải thiện chất lượng và khả năng tiếp cận dữ liệu là nền tảng để mở khóa toàn bộ tiềm năng của trí tuệ y tế.
Bạn đã dẫn dắt CyncHealth qua sự tăng trưởng lớn, mở rộng khả năng tương tác trên hàng triệu hồ sơ bệnh nhân và nhiều tiểu bang, trước khi thành lập Aquila Health. Những hạn chế hoặc thất bại hệ thống quan trọng nào bạn đã gặp phải trong suốt hành trình đó mà cuối cùng đã thúc đẩy bạn xây dựng Aquila từ đầu?
Tại CyncHealth, chúng tôi đã dành nhiều năm để xây dựng cơ sở hạ tầng kết nối các tổ chức y tế trên toàn Nebraska và Iowa. Chúng tôi đã kết nối hơn 1.100 địa điểm chăm sóc và hàng triệu hồ sơ bệnh nhân, bao gồm một dân số hơn năm triệu người.
Tuy nhiên, điều chúng tôi liên tục gặp phải là việc kết nối hệ thống và thực sự làm cho dữ liệu có thể sử dụng được là hai vấn đề hoàn toàn khác nhau. Ví dụ, chúng tôi đã làm việc để tạo ra một bảng điều khiển quá liều opioid mà phối hợp dữ liệu chúng tôi nhận được từ nhiều nguồn. Nó đã mất vài tháng với hàng trăm giờ làm việc và phối hợp trên nhiều bên liên quan để làm cho một điểm dữ liệu đơn này có thể hiểu được trong một bối cảnh y tế công cộng và chăm sóc sức khỏe. Và sau tất cả những điều đó, bức tranh vẫn còn chưa hoàn chỉnh.
Kinh nghiệm đó là hạt giống cho Aquila. Cách truyền thống của việc kết nối giao diện mà không hiểu được sự hoàn chỉnh và chất lượng của dữ liệu xuất sẽ không đáp ứng được nhu cầu với những tiến bộ trong AI mà chúng tôi đã thấy trong những năm gần đây. Khi AI có thể thực hiện trong vài giờ những gì trước đây mất một đội vài tháng, và làm điều đó với chất lượng cao hơn tại một phần nhỏ chi phí, bạn phải sử dụng kiến thức đó để xây dựng lại từ một nền tảng mới. Đó là những gì chúng tôi đã làm với Aquila, chúng tôi đang tập trung vào các công cụ hiện đại giảm chi phí kết nối để chúng tôi có thể tập trung vào việc hoàn thiện toàn bộ bức tranh về sức khỏe – không chỉ dữ liệu có nguồn gốc từ các nguồn EHI truyền thống, mà là toàn bộ bức tranh.
Aquila gần đây đã xuất hiện từ chế độ bí mật với một nền tảng tập trung vào việc thống nhất dữ liệu y tế phân mảnh vào một lớp AI sẵn sàng duy nhất. Những đột phá kỹ thuật cốt lõi nào đã làm cho điều này trở nên khả thi bây giờ, so với chỉ vài năm trước?
Khả năng của AI đã thúc đẩy sự thay đổi này gần như hoàn toàn.
Tôi đã dành nhiều năm để theo dõi các kỹ sư có tay nghề cao phải điều chỉnh thủ công các tiêu chuẩn dữ liệu, từng nguồn một. Nó đã hoạt động, nhưng mô hình đó không bao giờ có thể mở rộng quy mô. Bạn không thể thuê đủ nhanh để theo kịp khối lượng và sự đa dạng của dữ liệu mà y tế tạo ra.
Điều khác biệt bây giờ là AI có thể thực hiện công việc chuẩn hóa liên tục tại lớp dữ liệu khi thông tin di chuyển qua hệ thống. Nó không phải là một quá trình xử lý hàng loạt chạy qua đêm. Nó xảy ra trong thời gian gần thực.
Đối với các nhóm lâm sàng và y tế công cộng, điều đó có nghĩa là dữ liệu họ cần đã được cấu trúc và xác thực trước khi nó đến với họ.
Chúng tôi đã xây dựng TREUE ™ như một khuôn khổ tổ chức dữ liệu lâm sàng có nguồn gốc từ hồ sơ y tế, phòng thí nghiệm, y tế công cộng, yêu cầu và dữ liệu xã hội thành một cấu trúc thống nhất. AI không thay thế quản trị dữ liệu tốt; nó làm cho quản trị dữ liệu tốt trở nên có thể mở rộng quy mô lần đầu tiên.
Bạn đã nhấn mạnh rằng thách thức thực sự trong AI y tế không phải là các mô hình, mà chính là dữ liệu. Những khoảng trống quan trọng nhất trong cơ sở hạ tầng dữ liệu y tế hiện nay là gì, điều gì ngăn cản AI mang lại kết quả có ý nghĩa?
Ngành công nghiệp đang nói về mô hình AI, nhưng mô hình không phải là phần khó.
Phần khó là một bệnh nhân có thể đi vào ba cơ sở khác nhau trong một ngày và xuất hiện như ba người khác nhau trong ba hệ thống khác nhau. Các phòng thí nghiệm không khớp với các ghi chú lâm sàng. Hồ sơ của người trả tiền có một định danh khác với hồ sơ bệnh viện và y tế công cộng sử dụng một định danh hoàn toàn khác. Bằng thời gian bạn sắp xếp tất cả những điều đó thủ công, cửa sổ lâm sàng đã đóng lại.
Các kết nối kỹ thuật mạnh mẽ không thể sửa chữa các bản ghi không đầy đủ hoặc không theo thứ tự. AI không thể phát hiện một mẫu mà không có trong dữ liệu, và nó không thể đưa ra một khuyến nghị đáng tin cậy từ một bản ghi thiếu một nửa thông tin lịch sử hoặc hiện tại mà nó nên chứa.
Khoảng trống không phải là khả năng xử lý, mà là niềm tin vào dữ liệu cơ bản. Đó là điều phải được giải quyết trước, và giải quyết nó ở quy mô là nơi AI thực sự có thể kiếm được vị trí của nó.
Aquila tự định vị mình là “lớp chuẩn bị dữ liệu” trước khi tiêu thụ AI. Bạn có thể giải thích những gì lớp đó thực sự làm trong thực tế, đặc biệt là khi đối phó với các đầu vào dị thường như hồ sơ lâm sàng, dữ liệu yêu cầu và nguồn cấp dữ liệu thời gian thực?
Sử dụng ví dụ từ trước, hãy xem xét những gì đến khi một cuộc chạm trán bệnh nhân tạo ra dữ liệu. Bạn nhận được một tin nhắn HL7 từ bệnh viện, một hồ sơ yêu cầu từ người bảo hiểm, một kết quả phòng thí nghiệm từ một phòng thí nghiệm tham chiếu sử dụng một định danh khác, và một báo cáo y tế công cộng được nộp trên một thời biểu hoàn toàn khác. Không có cái nào trong số đó được thiết kế để được hòa giải với nhau.
Lớp chuẩn bị của chúng tôi, TREUE ™, là những gì nằm giữa các đầu vào và bất kỳ phân tích hoặc ứng dụng AI nào tiếp theo. Công việc của nó là đánh giá từng bản ghi khi nó đến, khớp các định danh trên các nguồn, chuẩn hóa các định dạng và cờ những gì bị thiếu hoặc không nhất quán trước khi dữ liệu di chuyển thêm.
Trong thực tế, điều đó có nghĩa là một bác sĩ lâm sàng đang xem một bệnh nhân đang làm việc từ một hồ sơ đã được xác thực và căn chỉnh trên các nguồn, thay vì phải hòa giải thủ công bốn cái nhìn hệ thống khác nhau trong một cuộc gặp gỡ chăm sóc.
Đối với các nhóm y tế công cộng, điều đó có nghĩa là các tín hiệu của đợt bùng phát không bị chậm lại bởi dữ liệu đến trong các định dạng khác nhau từ các khu vực pháp lý khác nhau.
Đó là công việc cơ sở hạ tầng. Nó không phải là công việc hấp dẫn, nhưng không có gì hoạt động mà không có nó.
Các tiêu chuẩn tương tác như Fast Healthcare Interoperability Resources (FHIR) và United States Core Data for Interoperability (USCDI) đã tồn tại trong nhiều năm, nhưng sự phân mảnh vẫn tiếp tục. Những gì vẫn còn thiếu từ quan điểm tiêu chuẩn, và Aquila đang giải quyết những khoảng trống đó khác biệt như thế nào?
FHIR và USCDI đã mang lại cho ngành công nghiệp một ngôn ngữ chung để trao đổi dữ liệu. Đó là một tiến bộ quan trọng.
Tuy nhiên, một ngôn ngữ chung để gửi dữ liệu không phải là dữ liệu hoạt động nhất quán khi nó đến.
Khoảng trống ở đây là: dữ liệu y tế không đến từ một miền. Các hệ thống lâm sàng, đăng ký y tế công cộng, phòng thí nghiệm và nguồn dữ liệu xã hội mỗi cái có các yêu cầu quản trị, thời biểu và định nghĩa về ý nghĩa của một trường khác nhau. FHIR không cho bạn biết cách hòa giải một tập dữ liệu về các yếu tố quyết định xã hội với một hồ sơ lâm sàng từ một khu vực pháp lý khác.
Điều gì TREUE ™ thêm vào là một khuôn khổ thống nhất về cách dữ liệu từ tất cả các miền đó có thể được tổ chức và xác thực cùng nhau, đồng thời vẫn tôn trọng các quy tắc quản trị áp dụng cho từng nguồn.
Aquila hoạt động trong các môi trường có hậu quả cao nơi thất bại không phải là một lựa chọn. Bạn thiết kế các hệ thống AI như thế nào để cân bằng hiệu suất thời gian thực với các yêu cầu nghiêm ngặt về quản trị, khả năng kiểm toán và niềm tin?
Bạn phải xây dựng quản trị vào kiến trúc trước khi bạn viết dòng mã ứng dụng đầu tiên. Nó không nên là một lớp bạn thêm vào sau.
Trong các môi trường y tế và chính phủ, các quyết định được thông báo bởi dữ liệu này ảnh hưởng đến chăm sóc bệnh nhân, phản ứng với đợt bùng phát và cách phân bổ nguồn lực công. Mọi hành động trên dữ liệu phải có thể theo dõi được, và quyền truy cập phải được kiểm soát chặt chẽ.
Đối với Aquila, điều đó có nghĩa là hoạt động trong cơ sở hạ tầng đám mây cấp chính phủ, kiểm soát truy cập không tin cậy và các thực hành bảo mật được căn chỉnh với các tiêu chuẩn HIPAA và liên bang.
Thành phần con người trong vòng lặp cũng quan trọng không kém. AI có thể nổi bật các tín hiệu, nhưng các chuyên gia lâm sàng xác thực các bất thường trước khi chúng thông báo các quyết định hoạt động.
Nền tảng của bạn hỗ trợ triển khai AI an toàn, trên thiết bị và chủ quyền dữ liệu. Sự phân cấp đang trở nên quan trọng như thế nào trong AI y tế, đặc biệt là khi xem xét các lo ngại ngày càng tăng về quyền riêng tư dữ liệu và tuân thủ quy định?
Nó đang trở nên thiết yếu, và tôi nghĩ ngành công nghiệp chỉ mới bắt đầu nhận ra tại sao.
Các tổ chức y tế hoạt động dưới các nghĩa vụ bảo mật nghiêm ngặt. Dữ liệu bệnh nhân nhạy cảm không thể đơn giản được tập trung và xử lý trong một môi trường được chia sẻ.
Hướng đi thực sự hoạt động là tạo ra thông tin gần hơn với nơi dữ liệu đã sống. Các tổ chức có thể đóng góp vào phân tích được chia sẻ mà không từ bỏ quyền kiểm soát dữ liệu cơ bản của họ.
Nền tảng của chúng tôi được xây dựng để hoạt động trong một môi trường được quản lý, phi tập trung như vậy – quản trị đi cùng với dữ liệu chứ không phải được áp dụng tại một điểm duy nhất.
Nhiều công ty khởi nghiệp AI dựa vào các mô hình hộp đen, trong khi Aquila kết hợp xác thực con người trong vòng lặp. Bạn nhìn thấy ranh giới giữa tự động hóa và giám sát con người trong các hệ thống AI lâm sàng ở đâu?
Tôi bắt đầu sự nghiệp của mình với tư cách là một y tá trực tiếp. Kinh nghiệm đó định hình cách tôi nghĩ về nơi AI thuộc về trong một môi trường lâm sàng và nơi nó không.
AI rất tốt trong việc tìm kiếm các mẫu trong các tập dữ liệu lớn. Nó không tốt trong việc biết một mẫu có ý nghĩa gì đối với một bệnh nhân cụ thể với một lịch sử cụ thể trong một bối cảnh cộng đồng cụ thể.
Vai trò phù hợp của AI trong các hệ thống lâm sàng là nổi bật các tín hiệu mà con người có thể bỏ lỡ ở khối lượng, không phải thay thế lý luận lâm sàng theo sau.
Ở Aquila, các bất thường và thông tin được hệ thống đánh dấu đi đến các bác sĩ lâm sàng và chuyên gia lĩnh vực để xem xét trước khi chúng thông báo các quyết định hoạt động.
Aquila đang làm việc trên y tế công cộng, hệ thống chính phủ và các ngành công nghiệp được quản lý. Các yêu cầu về cơ sở hạ tầng AI khác nhau như thế nào giữa các môi trường này so với các triển khai AI doanh nghiệp truyền thống?
Trong một triển khai AI doanh nghiệp truyền thống, bạn thường làm việc trong một môi trường dữ liệu của một tổ chức, một bộ quy tắc quản trị, một khuôn khổ tuân thủ.
Các môi trường y tế công cộng và chính phủ là cấu trúc khác nhau. Bạn đang phối hợp trên nhiều khu vực pháp lý, nhiều cơ quan, nhiều môi trường lâm sàng, mỗi cái hoạt động trên các thời biểu báo cáo khác nhau và dưới các khuôn khổ pháp lý khác nhau.
Cơ sở hạ tầng phải hỗ trợ xử lý khối lượng lớn trong khi vẫn duy trì khả năng kiểm toán nghiêm ngặt trên tất cả các ranh giới đó.
Đó là sự phức tạp khiến chúng tôi bắt đầu Aquila với những môi trường đó thay vì thị trường doanh nghiệp truyền thống.
Các khả năng AI tiếp tục tiến bộ nhanh hơn các khuôn khổ quản trị. Những người sáng lập và những người xây dựng nền tảng có những trách nhiệm gì để đảm bảo các hệ thống này được triển khai một cách đạo đức và an toàn từ ngày đầu tiên?
Tôi nghĩ trách nhiệm là thẳng thắn, ngay cả khi việc đáp ứng nó là không.
Nếu bạn đang xây dựng AI ảnh hưởng đến quyết định lâm sàng hoặc kết quả y tế công cộng, bạn không được phép coi quản trị như một mục trên đường dẫn sản phẩm mà bạn sẽ thực hiện cuối cùng.
Điều đó có nghĩa là mọi hành động trên dữ liệu phải có thể kiểm toán được. Các mô hình phải có thể giải thích đủ để một bác sĩ lâm sàng có thể hiểu tại sao một tín hiệu được đánh dấu.
Tổ chức phải trung thực về những gì hệ thống có thể và không thể làm một cách đáng tin cậy.
Tôi đã dành sự nghiệp của mình trong các môi trường nơi thất bại dữ liệu có hậu quả thực sự cho những người thực sự.
Khả năng đang tiến bộ nhanh, và trách nhiệm giải trình về cách chúng được triển khai không được phép chậm lại. Những người sáng lập xây dựng các hệ thống này phải tự áp dụng tiêu chuẩn đó, không chờ đợi quy định áp đặt nó.
Cảm ơn bạn vì cuộc thảo luận sâu sắc. Những người đọc quan tâm đến việc khám phá nền tảng và cách tiếp cận cơ sở hạ tầng dữ liệu y tế có thể tìm hiểu thêm bằng cách truy cập Aquila Health.




