
Góc nhìn Anderson
Chỉnh sửa nội dung video AI nhất quán với đầu vào được hướng dẫn bằng văn bản

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Điểm chínhText2Live cho phép chỉnh sửa video nhất quán từ các gợi ý văn bản mà không cần xử lý…
Xem thêm
- Text2Live cho phép chỉnh sửa video nhất quán từ các gợi ý văn bản mà không cần xử lý từng khung hình.
- Hệ thống sử dụng một tập bản đồ phân lớp thần kinh để áp dụng các chỉnh sửa một lần trên toàn bộ dòng thời gian video.
- Text2Live tự động hóa việc tạo mặt nạ và ghép hình, loại bỏ nhu cầu về kỹ thuật quay vẽ hoặc màn hình xanh.
Trong khi cộng đồng VFX chuyên nghiệp bị thu hút – và đôi khi cảm thấy bị đe dọa – bởi những đổi mới mới trong tổng hợp hình ảnh và video, sự thiếu tính liên tục thời gian trong hầu hết các dự án chỉnh sửa video dựa trên AI khiến nhiều nỗ lực này thuộc về lĩnh vực ảo giác, với các kết cấu bề mặt và cấu trúc lung linh, thay đổi nhanh chóng và các hiệu ứng không nhất quán và công nghệ thô sơ giống như thời kỳ quang hóa của hiệu ứng hình ảnh.
Nếu bạn muốn thay đổi một điều gì đó rất cụ thể trong một video không thuộc phạm vi của deepfakes (tức là áp đặt một bản sắc mới lên cảnh quay hiện có của một người), hầu hết các giải pháp hiện tại hoạt động dưới các hạn chế nghiêm trọng, về độ chính xác cần thiết cho hiệu ứng hình ảnh chất lượng sản xuất.
Một ngoại lệ là công việc đang diễn ra của một liên minh lỏng lẻo của các học giả từ Viện Khoa học Weizmann. Vào năm 2021, ba nhà nghiên cứu của nó, liên kết với Adobe (ADBE ), đã công bố một phương pháp mới để phân hủy video và áp dụng một bản đồ nội bộ nhất quán – một atlas thần kinh phân lớp – vào một đầu ra tổng hợp, hoàn chỉnh với các kênh alpha và đầu ra nhất quán theo thời gian.
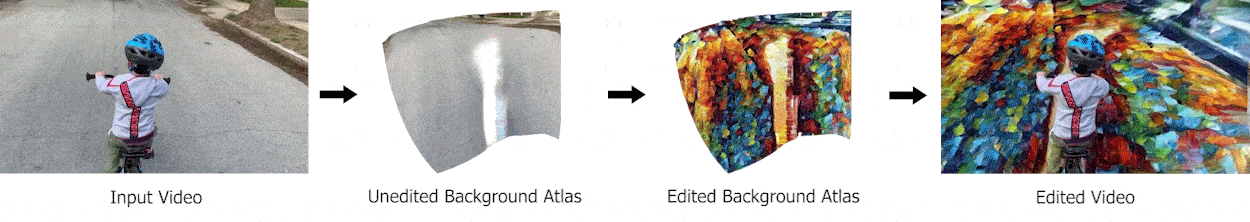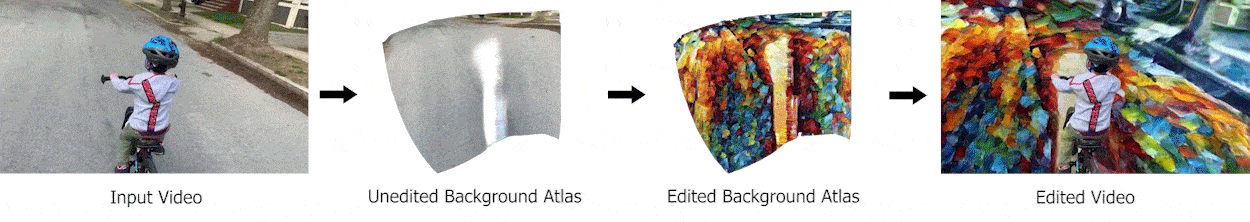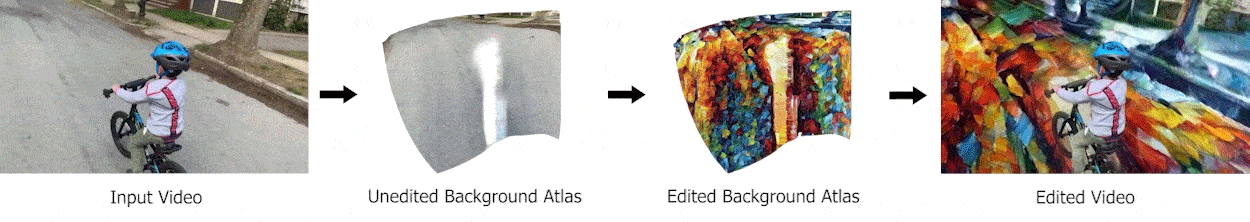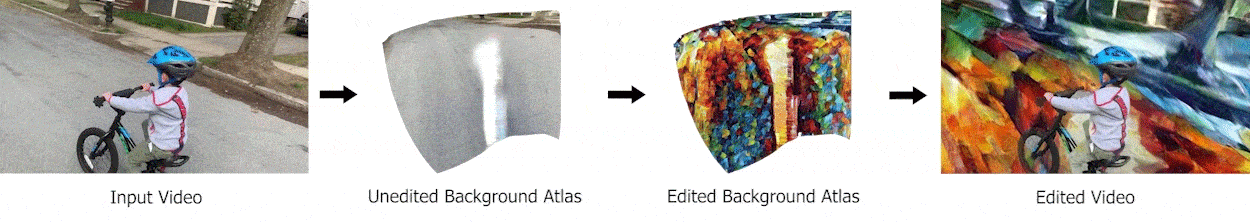
Từ bài báo năm 2021: một ước tính của toàn bộ hành trình của con đường trong clip nguồn được chỉnh sửa thông qua một mạng thần kinh theo cách truyền thống sẽ yêu cầu xử lý rotoscope và khớp chuyển động trên quy mô lớn. Vì các yếu tố nền và tiền cảnh được xử lý bởi các mạng khác nhau, các mặt nạ thực sự là ‘tự động’. Nguồn: https://layered-neural-atlases.github.io/
Mặc dù nó rơi vào một lĩnh vực được bao phủ bởi luồng quang học trong các pipeline VFX, atlas phân lớp không có tương đương trực tiếp trong các công việc CGI truyền thống, vì nó cơ bản cấu thành một ‘bản đồ kết cấu bề mặt theo thời gian’ có thể được sản xuất và chỉnh sửa thông qua các phương pháp phần mềm truyền thống. Trong hình ảnh thứ hai trong hình minh họa trên, nền của bề mặt đường được đại diện (tượng trưng) trên toàn bộ thời gian chạy của video. Thay đổi hình ảnh cơ sở (hình ảnh thứ ba từ trái trong hình minh họa trên) tạo ra một thay đổi nhất quán trong nền.
Các hình ảnh của ‘atlas mở rộng’ trên chỉ đại diện cho các khung hình riêng lẻ được giải thích; các thay đổi nhất quán trong bất kỳ khung hình mục tiêu nào được ánh xạ lại đến khung hình gốc, giữ lại bất kỳ che khuất cần thiết nào và các hiệu ứng cảnh khác, chẳng hạn như bóng hoặc phản xạ.
Cấu trúc cốt lõi sử dụng một perceptron đa lớp (MLP) để đại diện cho các atlas mở rộng, kênh alpha và ánh xạ, tất cả đều được tối ưu hóa cùng nhau, và hoàn toàn trong không gian 2D, loại bỏ nhu cầu về kiến thức có trước về các điểm hình học 3D như ở NeRF, bản đồ độ sâu và các yếu tố CGI khác.
Atlas tham chiếu của các đối tượng riêng lẻ cũng có thể được thay đổi một cách đáng tin cậy:
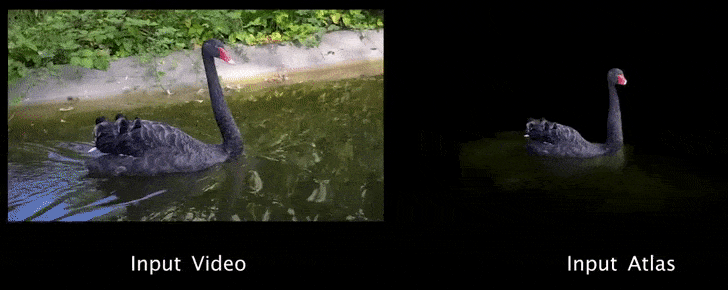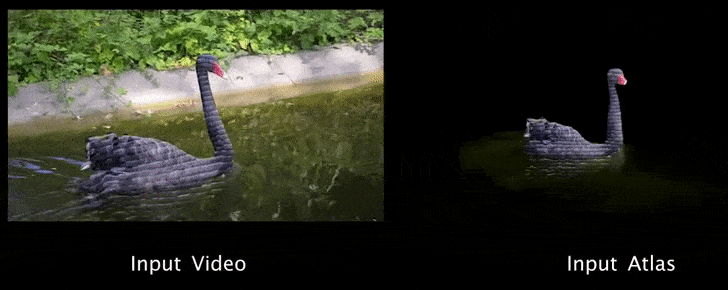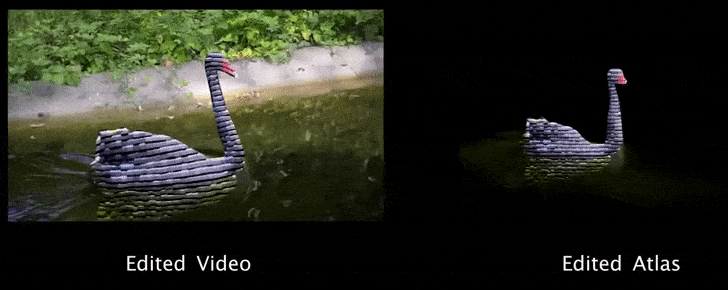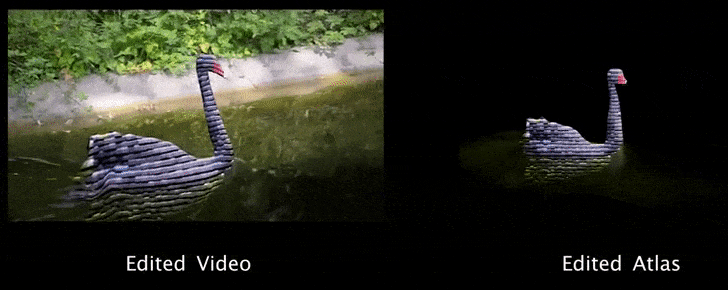
Thay đổi nhất quán đối với một đối tượng di chuyển theo khuôn khổ năm 2021. Nguồn: https://www.youtube.com/watch?v=aQhakPFC4oQ
Về bản chất, hệ thống năm 2021 kết hợp căn chỉnh hình học, khớp chuyển động, ánh xạ, thay kết cấu bề mặt và rotoscope thành một quy trình mạng nơ-ron riêng biệt.
Text2Live
Ba nhà nghiên cứu gốc của bài báo năm 2021, cùng với nghiên cứu của NVIDIA (NVDA ), là những người đóng góp cho một đổi mới mới về kỹ thuật kết hợp sức mạnh của các atlas phân lớp với loại công nghệ hướng dẫn văn bản CLIP đã trở lại nổi bật vào tuần này với phát hành khuôn khổ DALL-E 2 của OpenAI.
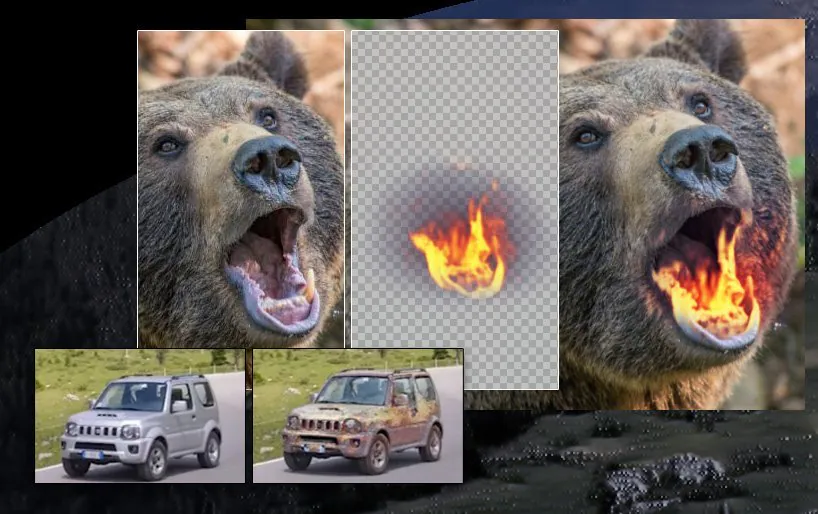
Kiến trúc mới, có tên Text2Live, cho phép người dùng cuối tạo các chỉnh sửa cục bộ cho nội dung video thực dựa trên các lệnh văn bản:
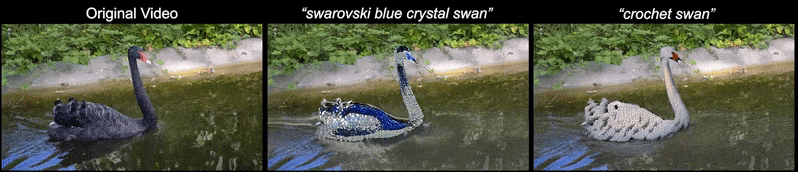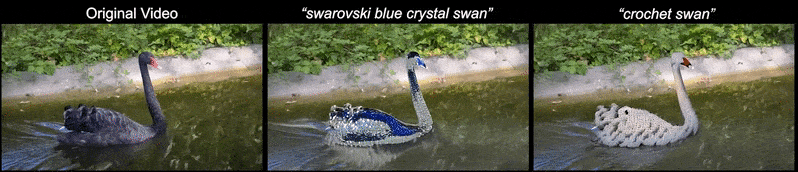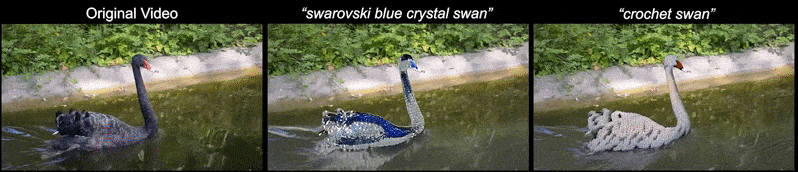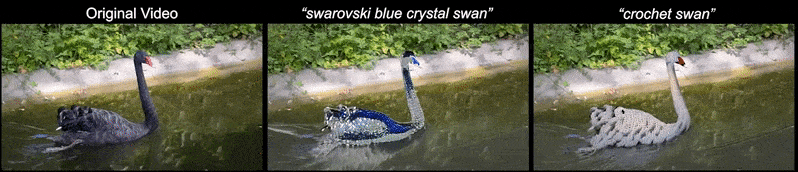
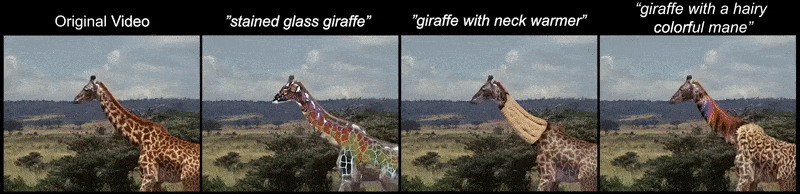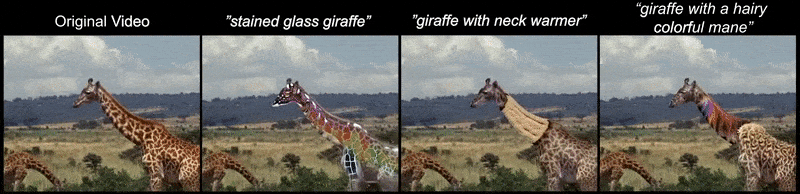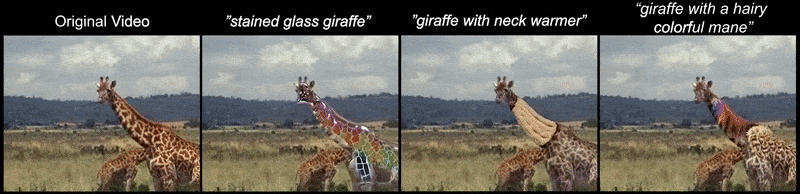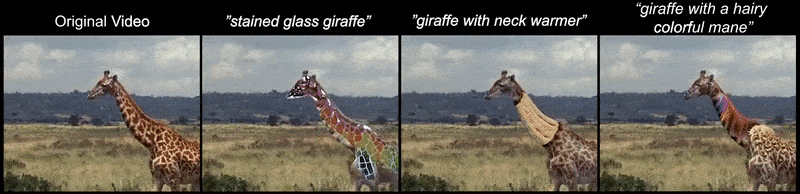
Hai ví dụ về chỉnh sửa tiền cảnh. Để có độ phân giải và độ rõ nét tốt hơn, hãy xem các video gốc tại https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live cho phép chỉnh sửa theo ngữ nghĩa và tại những vùng rất cụ thể mà không cần bộ sinh đã được huấn luyện trước, nhờ sử dụng cơ sở dữ liệu nội bộ dành riêng cho đoạn video đang chỉnh sửa.

Biến đổi nền và tiền cảnh (đối tượng) dưới Text2Live. Nguồn: https://text2live.github.io/sm/pages/video_results_atlases.html
Kỹ thuật này không yêu cầu người dùng cung cấp mặt nạ, chẳng hạn như quy trình rotoscope hoặc phông xanh thông thường, mà thay vào đó ước tính bản đồ liên quan thông qua một kỹ thuật khởi động dựa trên nghiên cứu năm 2021 từ Trường Khoa học Máy tính tại Đại học Tel Aviv và Nghiên cứu Trí tuệ Nhân tạo Facebook (FAIR).

Bản đồ đầu ra được tạo ra thông qua mô hình chú ý tổng quát dựa trên transformer.
Bài báo mới có tên Text2LIVE: Chỉnh sửa hình ảnh và video phân lớp theo chỉ dẫn văn bản. Omer Bar-Tal thuộc Weizmann và Yoni Kasten thuộc NVIDIA Research tham gia cùng nhóm nghiên cứu gốc năm 2021.
Kiến trúc
Text2Live bao gồm một bộ sinh được huấn luyện trên một hình ảnh đầu vào duy nhất và các lệnh văn bản mục tiêu. Một mô hình tiền huấn luyện tương phản ngôn ngữ–hình ảnh (CLIP) được huấn luyện trước trên 400 triệu cặp văn bản/hình ảnh cung cấp tài liệu trực quan liên quan mà các biến đổi người dùng có thể được giải thích.

Bộ sinh nhận một hình ảnh đầu vào (khung hình) và đầu ra một lớp RGBA mục tiêu chứa thông tin màu sắc và độ đục. Lớp này sau đó được tổng hợp vào cảnh quay gốc với các tăng cường thêm.

Kênh alpha trong lớp RGBA được tạo ra cung cấp một chức năng tổng hợp nội bộ mà không cần đến các pipeline truyền thống liên quan đến phần mềm dựa trên pixel như After Effects.
Bằng cách đào tạo trên các hình ảnh nội bộ liên quan đến video hoặc hình ảnh mục tiêu, Text2Live tránh yêu cầu phải đảo ngược hình ảnh đầu vào vào không gian tiềm ẩn của một Mạng Đối nghịch Sinh (GAN), một thực hành hiện tại chưa chính xác cho yêu cầu chỉnh sửa video sản xuất, hoặc sử dụng một mô hình khuếch tán mà chính xác và có thể định cấu hình hơn, nhưng không thể duy trì độ trung thực với video mục tiêu.

Nhiều phép biến đổi dựa trên chỉ dẫn văn bản của Text2Live.
Các phương pháp trước đây đã sử dụng phương pháp dựa trên sự lan truyền hoặc các phương pháp dựa trên luồng quang học. Vì những kỹ thuật này là dựa trên khung hình theo một mức độ nào đó, không có khả năng tạo ra một ngoại hình nhất quán theo thời gian của các thay đổi trong video đầu ra. Thay vào đó, một atlas thần kinh phân lớp cung cấp một không gian duy nhất để giải quyết các thay đổi, có thể vẫn trung thành với thay đổi đã cam kết khi video tiến triển.
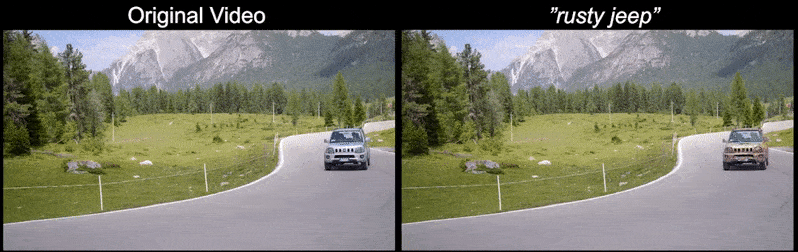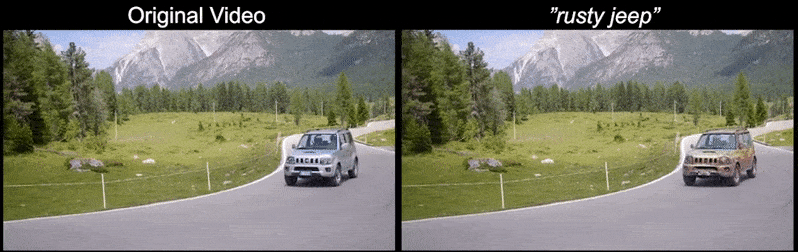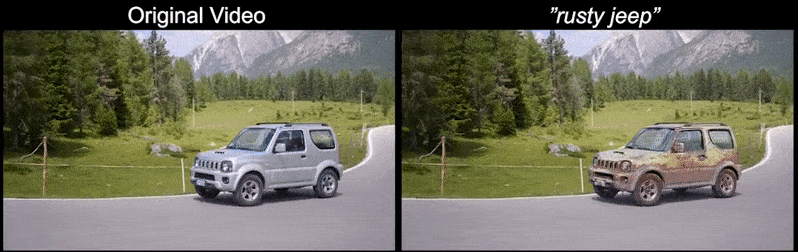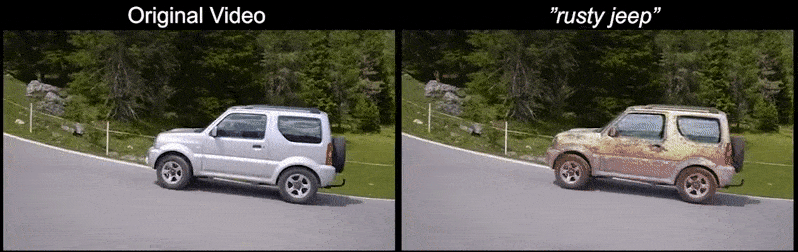
Không có hiện tượng chớp rung hoặc ảo giác ngẫu nhiên: Text2Live thu được một giải thích của lệnh văn bản ‘xe jeep gỉ sét’, và áp dụng nó một lần vào atlas thần kinh phân lớp của xe trong video, thay vì khởi động lại biến đổi cho mỗi khung hình được giải thích.

Quy trình biến đổi nhất quán của Text2Live đối với một chiếc Jeep thành một chiếc xe cũ gỉ sét.
Text2Live gần hơn với một bước đột phá trong lĩnh vực ghép hình dựa trên AI, hơn là trong không gian văn bản-sang-hình ảnh phong phú đã thu hút sự chú ý lớn vào tuần này với việc phát hành thế hệ thứ hai của khuôn khổ DALL-E của OpenAI (có thể kết hợp hình ảnh mục tiêu như một phần của quá trình biến đổi, nhưng vẫn bị giới hạn trong khả năng can thiệp trực tiếp vào một bức ảnh, ngoài các hạn chế về dữ liệu đào tạo nguồn và áp dụng các bộ lọc được thiết kế để ngăn chặn lạm dụng người dùng).
Thay vào đó, Text2Live cho phép người dùng cuối trích xuất một atlas và sau đó chỉnh sửa nó trong một lần trong các môi trường pixel có kiểm soát cao như Photoshop (và có thể thậm chí là các khung tổng hợp hình ảnh trừu tượng hơn như NeRF), trước khi đưa nó trở lại vào một môi trường được định hướng đúng cách mà không dựa vào ước tính 3D hoặc các phương pháp CGI quay lại lối làm cũ.
Hơn nữa, Text2Live, theo các tác giả, là khuôn khổ đầu tiên trong nhóm có thể so sánh thực hiện tạo mặt nạ và ghép hình hoàn toàn tự động.
Được xuất bản lần đầu vào ngày 7 tháng 4 năm 2022.





