Góc nhìn Anderson
Tách nền ảnh bằng AI có khả năng hiểu bối cảnh

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google
Điểm chínhTính năng tách nền bằng AI hiện sử dụng khả năng hiểu bối cảnh để thay thế phông xanh.
Xem thêm
- Tính năng tách nền bằng AI hiện sử dụng khả năng hiểu bối cảnh để thay thế phông xanh.
- Quy trình SPG-IM mới vượt trội hơn hẳn các phương pháp không cần trimap.
- Nhãn văn bản mang lại một giải pháp thay thế chi phí thấp cho việc chú thích điểm ảnh đắt đỏ.
Trong phim tài liệu phần nội dung bổ sung đi kèm bản DVD phát hành năm 2003 của Alien3 (1992), huyền thoại về kỹ xảo hình ảnh Richard Edlund kinh hãi nhớ lại cảnh «đấu vật sumo» trong quá trình tách matte bằng phương pháp quang hóa, vốn thống trị công việc kỹ xảo từ cuối thập niên 1930 đến cuối thập niên 1980. Edlund mô tả tính chất lúc được lúc không của quy trình này là «đấu vật sumo», khi so sánh với các kỹ thuật màn hình xanh lam/xanh lục kỹ thuật số lên ngôi vào đầu thập niên 1990 (và sau này ông đã trở lại với phép ẩn dụ đó).
Ban đầu, để tách một đối tượng tiền cảnh (chẳng hạn như một người hoặc mô hình tàu vũ trụ) khỏi hậu cảnh, nhằm ghép hình ảnh đã tách vào một cảnh nền, người ta quay đối tượng tiền cảnh trước phông nền màu xanh lam hoặc xanh lục đồng nhất.
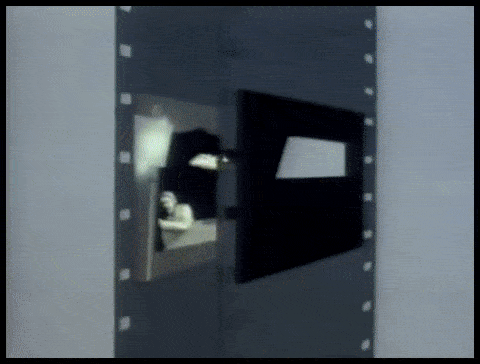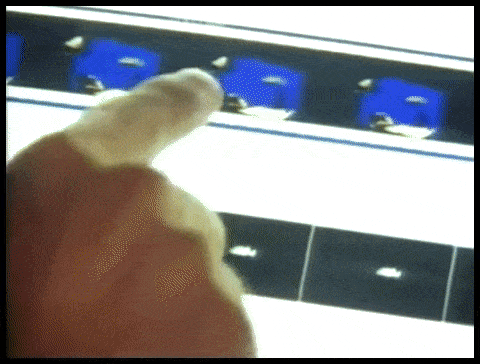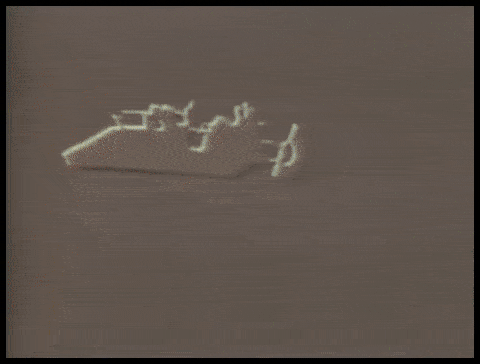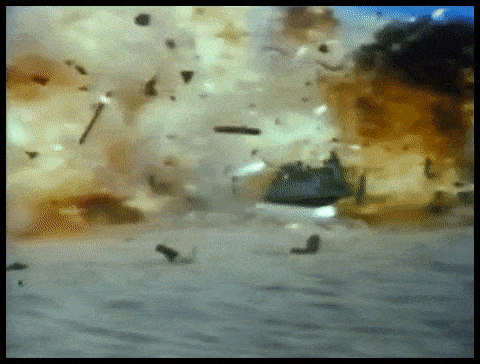
Quy trình tách hình ảnh quang hóa tốn nhiều công sức cho một cảnh kỹ xảo hình ảnh do ILM thực hiện trong phim ‘Return of the Jedi’ (1983).
Trong cảnh phim thu được, màu nền sau đó sẽ được tách riêng bằng phương pháp hóa học và dùng làm khuôn để in lại đối tượng tiền cảnh (hoặc người) bằng máy in quang học, tạo thành một vật thể «lơ lửng» trên một khuôn phim trong suốt.
Quy trình này được gọi là chồng hình tách màu (CSO) – dù về sau, thuật ngữ này thường gắn với các hiệu ứng video khóa màu thô sơ trong các chương trình truyền hình kinh phí thấp vào thập niên 1970 và 1980, vốn được thực hiện bằng phương pháp analog chứ không phải bằng hóa chất hay kỹ thuật số.

Phần trình diễn kỹ thuật chồng hình tách màu năm 1970 trong chương trình thiếu nhi Anh ‘Blue Peter’. Nguồn: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Dù là các cảnh phim hay video, sau khi được tách ra, đoạn phim đó đều có thể được chèn vào bất kỳ cảnh quay nào khác.
Dù quy trình hơi natri độc quyền và đắt đỏ hơn đáng kể của Disney (chỉ lấy màu vàng làm màu khóa, và cũng được sử dụng trong phim kinh dị The Birds năm 1963 của Alfred Hitchcock) cho hình ảnh rõ nét hơn và matte sắc gọn hơn, việc tách hình ảnh bằng phương pháp quang hóa vẫn tốn nhiều công sức và thiếu tin cậy.

Quy trình tách hình ảnh bằng hơi natri độc quyền của Disney đòi hỏi phông nền có màu gần với đầu vàng của quang phổ. Trong ảnh, Angela Lansbury được treo bằng dây trong lúc quay một phân cảnh có nhiều kỹ xảo hình ảnh cho phim ‘Bedknobs and Broomsticks’ (1971). Nguồn
Vượt ra khỏi kỹ thuật tách nền kỹ thuật số
Trong thập niên 1990, cuộc cách mạng kỹ thuật số loại bỏ nhu cầu dùng hóa chất, nhưng không loại bỏ nhu cầu sử dụng màn hình xanh. Khi đó, phần mềm chỉnh sửa ảnh như Photoshop và thế hệ mới của các bộ công cụ ghép video đã có thể tự động loại bỏ phông nền có màu bằng cách tìm các điểm ảnh có màu đó trong một khoảng dung sai nhất định. Chỉ trong chớp mắt, sáu mươi năm của ngành in quang học đã trở thành dĩ vãng.
Mười năm gần đây, nghiên cứu thị giác máy tính được tăng tốc bằng GPU đang đưa kỹ thuật tách matte bước vào thời kỳ thứ ba, đặt ra cho các nhà nghiên cứu nhiệm vụ phát triển những hệ thống có thể tạo matte chất lượng cao mà không cần màn hình xanh. Riêng trên Arxiv, các bài báo về những đổi mới trong lĩnh vực tách tiền cảnh bằng học máy được đăng hằng tuần.
Đưa chúng ta vào khung hình
Mối quan tâm của giới học thuật và ngành công nghiệp đối với việc tách nền bằng AI đã tác động đến thị trường tiêu dùng: hẳn ai trong chúng ta cũng quen thuộc với những ứng dụng còn thô sơ nhưng dùng được, chẳng hạn như các bộ lọc của Zoom và Skype, có thể thay phông nền phòng khách bằng những hòn đảo nhiệt đới, v.v. trong các cuộc gọi video hội nghị.
Tuy nhiên, như Zoom lưu ý vào thứ Tư tuần trước, để có được matte tốt nhất, vẫn cần màn hình xanh.

Bên trái là một người đàn ông đứng trước màn hình xanh; tóc được tách nền rõ nét bằng tính năng Virtual Background của Zoom. Bên phải là một phụ nữ đứng trước khung cảnh trong nhà bình thường; tóc được tách bằng thuật toán, kém chính xác hơn và đòi hỏi năng lực tính toán cao hơn. Nguồn: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Một bài đăng khác trên nền tảng Zoom Support cảnh báo rằng việc tách nền không dùng màn hình xanh cũng đòi hỏi thiết bị ghi hình có năng lực tính toán cao hơn.
Nhu cầu tách đối tượng
Những cải tiến về chất lượng, tính linh hoạt và khả năng tiết kiệm tài nguyên của các hệ thống tách nền trong môi trường thực tế (tức là tách người khỏi nền mà không cần phông xanh) có ý nghĩa với nhiều lĩnh vực và hoạt động hơn hẳn các bộ lọc dùng trong hội nghị truyền hình.
Trong quá trình phát triển bộ dữ liệu, khả năng nhận diện khuôn mặt, toàn bộ đầu và toàn thân được cải thiện giúp tránh việc các yếu tố nền không liên quan bị đưa vào quá trình huấn luyện mô hình thị giác máy tính về con người; khả năng tách đối tượng chính xác hơn sẽ cải thiện đáng kể các kỹ thuật phân đoạn ngữ nghĩa được thiết kế để phân biệt và tiếp nhận các miền (tức là “mèo”, “người”, “thuyền”), đồng thời nâng cao các hệ thống tổng hợp hình ảnh dựa trên VAE và transformer, chẳng hạn như DALL-E 2 mới của OpenAI; các thuật toán tách đối tượng tốt hơn cũng sẽ giảm nhu cầu thực hiện thủ công công đoạn rotoscoping tốn kém trong quy trình kỹ xảo hình ảnh (VFX).
Trên thực tế, các phương pháp đa phương thức (thường kết hợp văn bản và hình ảnh) đang ngày càng phổ biến và đã bắt đầu được ứng dụng trong xử lý hình ảnh. Với các phương pháp này, một miền như “mèo” được mã hóa vừa dưới dạng hình ảnh, vừa bằng các tham chiếu văn bản đi kèm. Một ví dụ gần đây là kiến trúc Text2Live, sử dụng phương pháp huấn luyện đa phương thức (văn bản và hình ảnh) để tạo video về vô vàn chủ thể, chẳng hạn như thiên nga pha lê và hươu cao cổ bằng thủy tinh.
Tách nền bằng AI có nhận biết bối cảnh
Phần lớn nghiên cứu về tách nền tự động bằng AI tập trung vào việc nhận diện đường biên và đánh giá các nhóm điểm ảnh trong ảnh hoặc khung hình video. Tuy nhiên, nghiên cứu mới từ Trung Quốc đề xuất một quy trình tách nền giúp cải thiện khả năng phân định và chất lượng mặt nạ bằng cách tận dụng mô tả bằng văn bản về cảnh (một phương pháp đa phương thức đã trở nên phổ biến trong lĩnh vực nghiên cứu thị giác máy tính trong 3-4 năm qua); nghiên cứu cho biết phương pháp này cải thiện nhiều mặt so với các phương pháp trước đó.

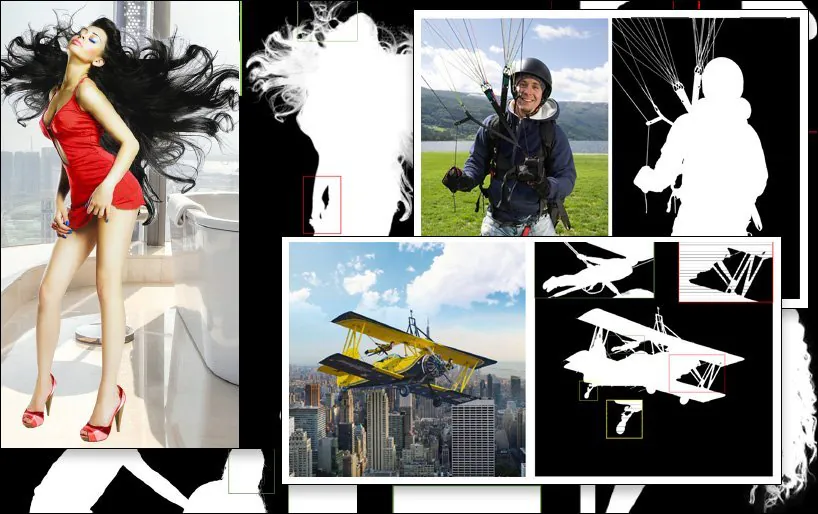
Ví dụ về kết quả tách nền bằng SPG-IM (ảnh cuối, phía dưới bên phải), so sánh với các phương pháp trước đây. Nguồn: https://arxiv.org/pdf/2204.09276.pdf
Thách thức đặt ra cho lĩnh vực nghiên cứu tách nền là tạo ra các quy trình đòi hỏi ít nhất có thể việc gán nhãn thủ công và sự can thiệp của con người — lý tưởng nhất là không cần đến những việc này. Ngoài vấn đề chi phí, các nhà nghiên cứu trong bài báo mới nhận xét rằng việc người lao động thuê ngoài trên các nền tảng cộng đồng, thuộc nhiều nền văn hóa khác nhau, thực hiện gán nhãn và phân đoạn thủ công có thể khiến hình ảnh được gắn nhãn hoặc thậm chí được phân đoạn theo nhiều cách khác nhau, dẫn đến các thuật toán thiếu nhất quán và không đạt yêu cầu.
Một ví dụ là cách diễn giải mang tính chủ quan về điều gì được xem là “đối tượng tiền cảnh”:

Trích từ bài báo mới: các phương pháp trước đây LFM và MODNet (“GT” là viết tắt của Ground Truth, tức kết quả “lý tưởng” thường đạt được bằng cách làm thủ công hoặc bằng các phương pháp phi thuật toán) đưa ra những cách xác định nội dung tiền cảnh khác nhau, với mức độ hiệu quả khác nhau; trong khi đó, phương pháp SPG-IM mới phân định “nội dung ở gần” hiệu quả hơn nhờ dựa vào ngữ cảnh của cảnh.
Để giải quyết vấn đề này, các nhà nghiên cứu đã phát triển một quy trình gồm hai giai đoạn mang tên Situational Perception Guided Image Matting (SPG-IM). Kiến trúc mã hóa/giải mã hai giai đoạn này gồm Situational Perception Distillation (SPD) và Situational Perception Guided Matting (SPGM).

Kiến trúc SPG-IM.
Trước tiên, SPD tiền huấn luyện các phép biến đổi đặc trưng từ hình ảnh sang văn bản, tạo chú thích phù hợp với từng hình ảnh tương ứng. Sau đó, quy trình có thể dự đoán mặt nạ tiền cảnh nhờ được kết nối với một kỹ thuật dự đoán độ nổi bật mới.
Tiếp theo, SPGM tạo ra mặt nạ alpha ước tính dựa trên ảnh RGB đầu vào thô và mặt nạ được tạo ở mô-đun đầu tiên.
Mục tiêu là cung cấp hướng dẫn dựa trên nhận thức tình huống, để hệ thống hiểu được những gì có trong ảnh và từ đó đặt ra bài toán — chẳng hạn như tách mái tóc phức tạp khỏi nền — dựa trên những đặc điểm đã biết của tác vụ cụ thể đó.

Trong ví dụ bên dưới, SPG-IM hiểu rằng các sợi dây là bộ phận không thể thiếu của một chiếc “dù”, trong khi MODNet không giữ lại và xác định được những chi tiết này. Tương tự, ở hình phía trên, MODNet làm mất đi một cách tùy tiện toàn bộ cấu trúc của thiết bị sân chơi.
bài báo mới có tiêu đề Phân tách nền ảnh có hướng dẫn nhận thức tình huống, do các nhà nghiên cứu tại OPPO Research Institute, PicUp.ai và Xmotors thực hiện.
Tạo mặt nạ thông minh tự động
SPG-IM còn đề xuất một Mạng tinh chỉnh Adaptive Focal Transformation (AFT), có khả năng xử lý riêng biệt các chi tiết cục bộ và ngữ cảnh toàn cục, qua đó tạo điều kiện cho việc tạo ra “mặt nạ thông minh”.

Hiểu được ngữ cảnh cảnh vật—trong trường hợp này là “cô gái và con ngựa”—có thể giúp việc tách tiền cảnh dễ dàng hơn so với các phương pháp trước đây.
Bài báo viết:
“Chúng tôi cho rằng các biểu diễn hình ảnh thu được từ tác vụ chuyển đổi hình ảnh thành văn bản, chẳng hạn như mô tả hình ảnh, tập trung vào những tín hiệu có ý nghĩa toàn diện hơn giữa (a) các đối tượng với nhau và (b) đối tượng với môi trường xung quanh, từ đó tạo ra các mô tả bao quát cả thông tin tổng thể lẫn chi tiết cục bộ. Ngoài ra, so với việc gán nhãn từng điểm ảnh tốn kém trong tác vụ phân tách nền ảnh, có thể thu thập hàng loạt nhãn văn bản với chi phí rất thấp.”
Nhánh SPD của kiến trúc được tiền huấn luyện đồng thời với bộ giải mã văn bản dựa trên Transformer VirTex của University of Michigan, bộ giải mã học các biểu diễn thị giác từ những chú thích giàu ngữ nghĩa.

VirTex huấn luyện đồng thời một ConvNet và các Transformer thông qua các cặp hình ảnh–chú thích, sau đó chuyển những hiểu biết thu được sang các tác vụ thị giác ở bước tiếp theo, chẳng hạn như phát hiện đối tượng. Nguồn: https://arxiv.org/pdf/2006.06666.pdf
Trong số các thử nghiệm và nghiên cứu cắt bỏ thành phần khác, các nhà nghiên cứu đã thử nghiệm SPG-IM với những phương pháp tiên tiến nhất dựa trên bản đồ ba vùng: Deep Image Matting (DIM), IndexNet, Phân tách ảnh nhận biết ngữ cảnh (CAM), Guided Contextual Attention (GCA), FBA và Semantic Image Matting (SIM).
Các khuôn khổ trước đây khác được đưa vào thử nghiệm bao gồm những phương pháp không cần bản đồ ba vùng LFM, HAttMatting và MODNet. Để so sánh công bằng, các phương pháp thử nghiệm được điều chỉnh cho phù hợp với những phương pháp luận khác nhau; ở những trường hợp không có mã nguồn, các kỹ thuật trong bài báo được tái hiện dựa trên kiến trúc đã mô tả.
Bài báo mới viết:
“SPG-IM của chúng tôi vượt trội đáng kể so với tất cả các phương pháp cạnh tranh không dùng bản đồ ba mức ([LFM], [HAttMatting] và [MODNet]). Đồng thời, mô hình của chúng tôi cũng thể hiện ưu thế vượt trội rõ rệt so với các phương pháp tiên tiến nhất (SOTA) dựa trên bản đồ ba mức và được hướng dẫn bằng mặt nạ, xét trên cả bốn thước đo ở các bộ dữ liệu công khai (gồm Composition-1K, Distinction-646 và Human-2K) cũng như bộ chuẩn Multi-Object-1K của chúng tôi.”
Bài báo viết tiếp:
“Có thể dễ dàng nhận thấy phương pháp của chúng tôi giữ lại các chi tiết tinh vi (chẳng hạn như đầu sợi tóc, kết cấu trong suốt và đường biên) mà không cần hướng dẫn từ bản đồ ba mức. Hơn nữa, so với các mô hình cạnh tranh khác không dùng bản đồ ba mức, SPG-IM của chúng tôi bảo toàn tính toàn vẹn ngữ nghĩa tổng thể tốt hơn.”


Được đăng lần đầu ngày 24 tháng 4 năm 2022.