
Góc nhìn Anderson
Chỉnh sửa đối tượng bằng AI với Imagic của Google và Erase and Replace của Runway

 Thêm Unite.AI vào các nguồn ưu tiên của bạn trên Google

Điểm chínhImagic tinh chỉnh các mô hình khuếch tán để thực hiện chỉnh sửa đối tượng ở mức chi…
Xem thêm
- Imagic tinh chỉnh các mô hình khuếch tán để thực hiện chỉnh sửa đối tượng ở mức chi tiết, khác với Erase and Replace của Runway vốn chỉ thay thế.
- Erase and Replace của Runway thay thế đối tượng một cách nhanh chóng nhưng không thể chỉnh sửa nội dung hiện có, mà chỉ thay thế nó.
- Quá trình tối ưu hóa theo từng hình ảnh của Imagic mất tám phút trên hai chip TPUV4, khiến nó chỉ phù hợp để sử dụng qua API.
Tuần này, hai thuật toán đồ họa dựa trên AI mới, nhưng có tính đối lập, đang cung cấp những cách mới cho người dùng cuối thực hiện các thay đổi cực kỳ chi tiết và hiệu quả đối với các đối tượng trong ảnh.
Đầu tiên là Imagic, thuộc Google Research, hợp tác với Viện Công nghệ Israel và Viện Khoa học Weizmann. Imagic cung cấp khả năng chỉnh sửa đối tượng dựa trên văn bản, với độ chi tiết cao thông qua việc tinh chỉnh các mô hình khuếch tán.

Thay đổi những gì bạn muốn và giữ nguyên phần còn lại: Imagic hứa hẹn chỉnh sửa chi tiết chỉ những phần bạn muốn thay đổi. Nguồn: https://arxiv.org/pdf/2210.09276.pdf
Ai đã từng cố gắng thay đổi chỉ một yếu tố trong bản tái tạo bằng Stable Diffusion đều biết rằng mỗi lần chỉnh sửa thành công, hệ thống sẽ thay đổi năm yếu tố khác mà bạn muốn giữ nguyên. Đây là một nhược điểm khiến nhiều người đam mê SD phải liên tục chuyển đổi giữa Stable Diffusion và Photoshop để khắc phục loại ‘thiệt hại phụ’ này. Chỉ từ góc nhìn này, những thành tựu của Imagic đã trở nên đáng chú ý.
Tại thời điểm viết bài, Imagic vẫn chưa có video quảng cáo nào, và với thái độ thận trọng của Google trong việc công bố các công cụ tổng hợp hình ảnh không bị hạn chế, không rõ chúng ta sẽ có cơ hội thử nghiệm hệ thống này ở mức độ nào, nếu có.
Sản phẩm thứ hai là tính năng Erase and Replace dễ tiếp cận hơn của Runway ML, một tính năng mới trong mục ‘AI Magic Tools’ của bộ công cụ hiệu ứng hình ảnh dựa trên máy học chỉ có trực tuyến.
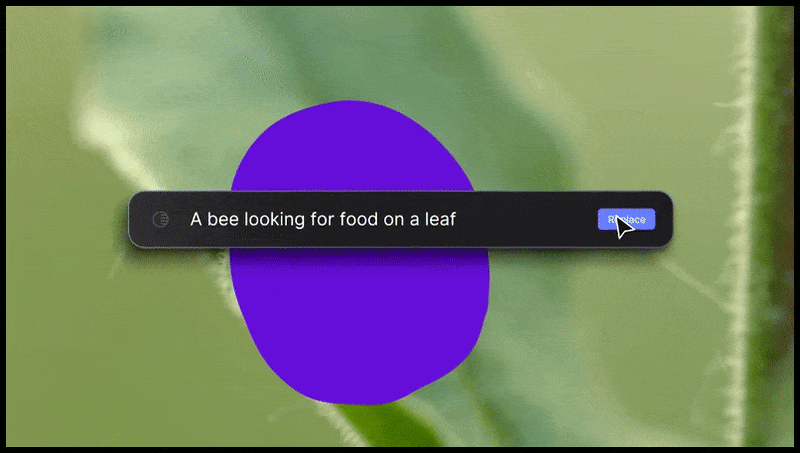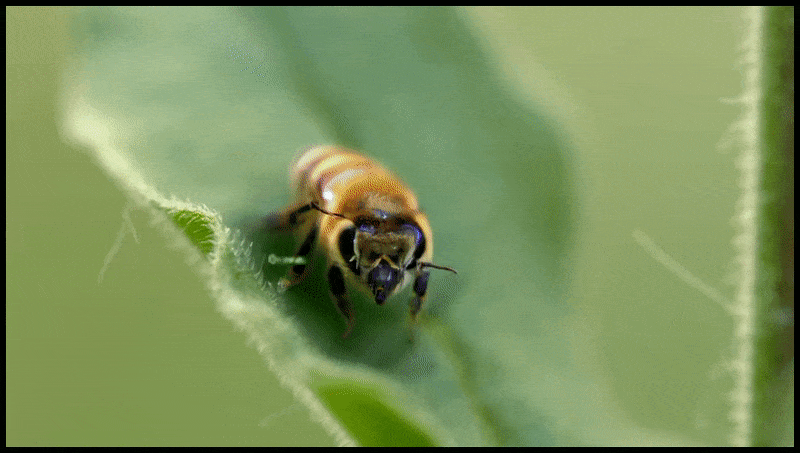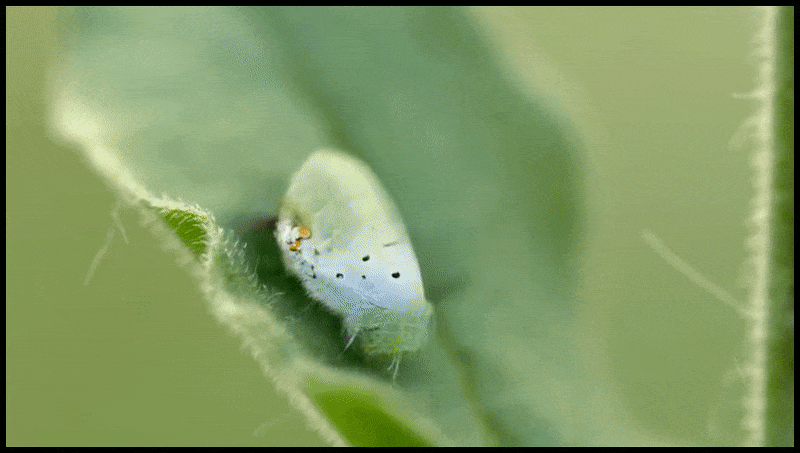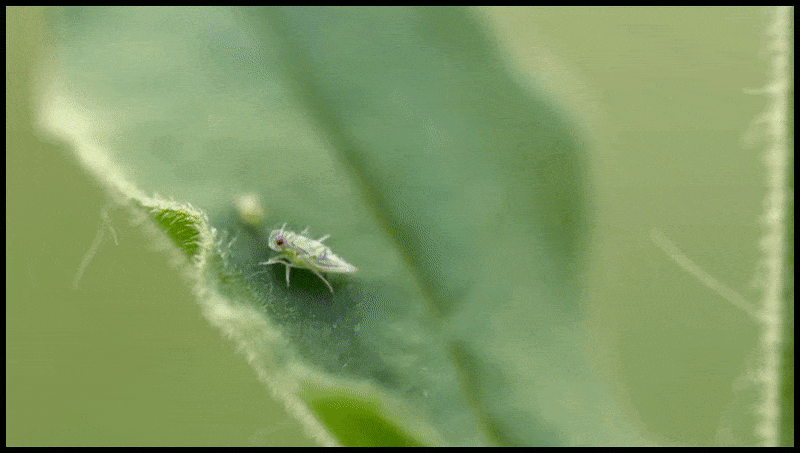
Tính năng Erase and Replace của Runway ML đã xuất hiện trong bản xem trước hệ thống chỉnh sửa video bằng văn bản.
Hãy cùng xem phần trình bày của Runway trước tiên.
Xóa và Thay Thế
Giống như Imagic, Xóa và Thay Thế chỉ làm việc với hình ảnh tĩnh, mặc dù Runway đã trình diễn cùng chức năng trong một giải pháp chỉnh sửa văn bản thành video chưa được phát hành:
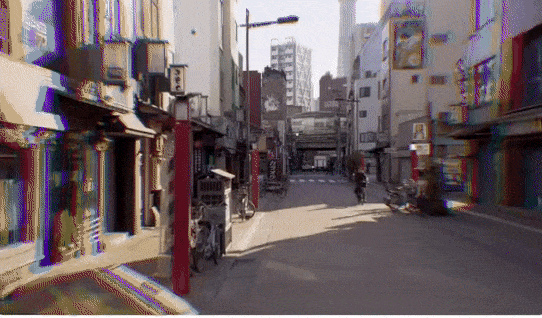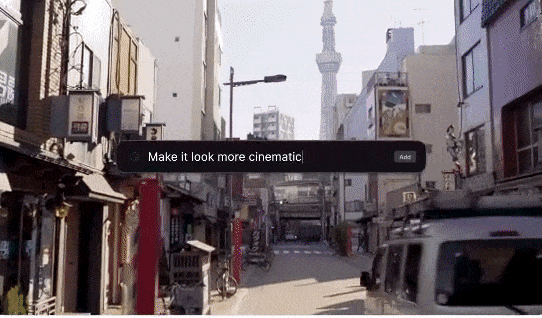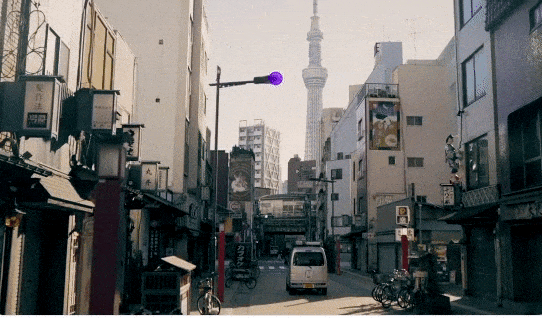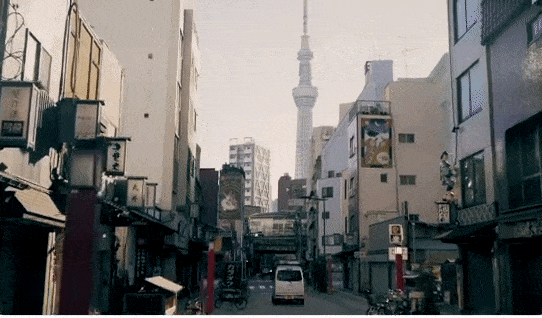
Bất kỳ ai cũng có thể thử Erase and Replace mới trên ảnh, nhưng phiên bản video vẫn chưa được cung cấp công khai. Nguồn: https://twitter.com/runwayml/status/1568220303808991232
Mặc dù Runway ML chưa công bố chi tiết công nghệ phía sau Xóa và Thay Thế, tốc độ thay thế một cây cảnh trong nhà bằng một bức tượng bán thân Ronald Reagan tương đối thuyết phục cho thấy một mô hình khuếch tán như Stable Diffusion (hoặc có khả năng thấp hơn nhiều, một phiên bản được cấp phép của DALL‑E 2) là động cơ tái tạo đối tượng bạn chọn trong Xóa và Thay Thế.

Thay cây cảnh trong nhà bằng tượng bán thân của The Gipper không nhanh hẳn như thế này, nhưng vẫn khá nhanh. Nguồn: https://app.runwayml.com/
Hệ thống có một số hạn chế kiểu DALL‑E 2 – các hình ảnh hoặc văn bản kích hoạt bộ lọc Xóa và Thay Thế sẽ gây ra cảnh báo về khả năng bị đình chỉ tài khoản nếu vi phạm tiếp – thực chất là một bản sao tiêu chuẩn của chính sách hiện hành của OpenAI cho DALL‑E 2.
Nhiều kết quả thiếu những khuyết điểm điển hình của Stable Diffusion. Runway ML là nhà đầu tư và đối tác nghiên cứu trong SD, và có khả năng họ đã huấn luyện một mô hình độc quyền vượt trội hơn các trọng số checkpoint 1.4 mã nguồn mở mà phần còn lại chúng ta đang phải vật lộn (khi nhiều nhóm phát triển, cả nghiệp dư và chuyên nghiệp, hiện đang huấn luyện hoặc tinh chỉnh các mô hình Stable Diffusion).
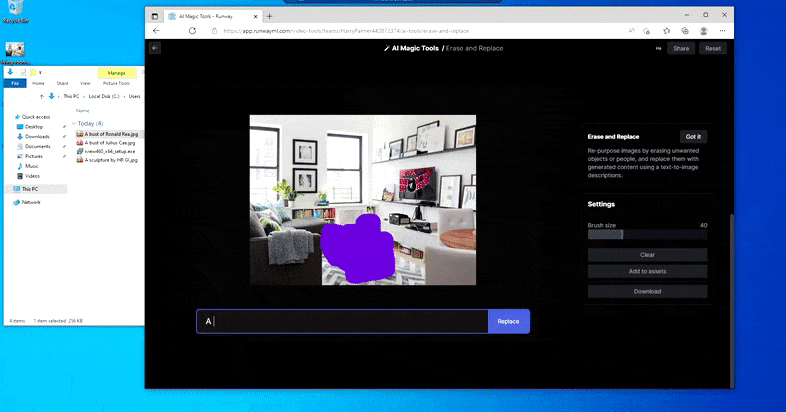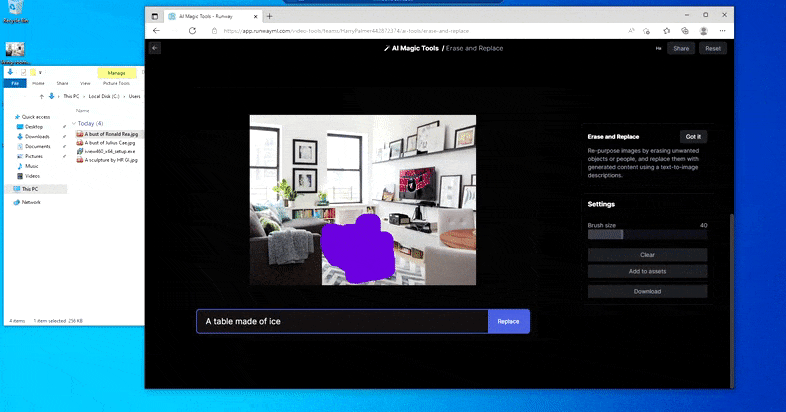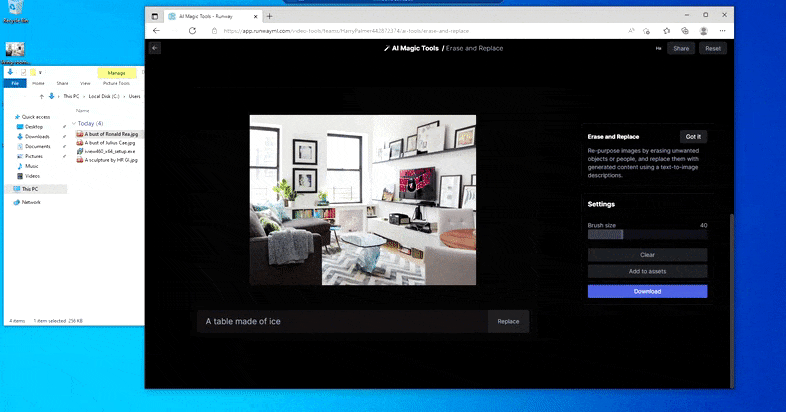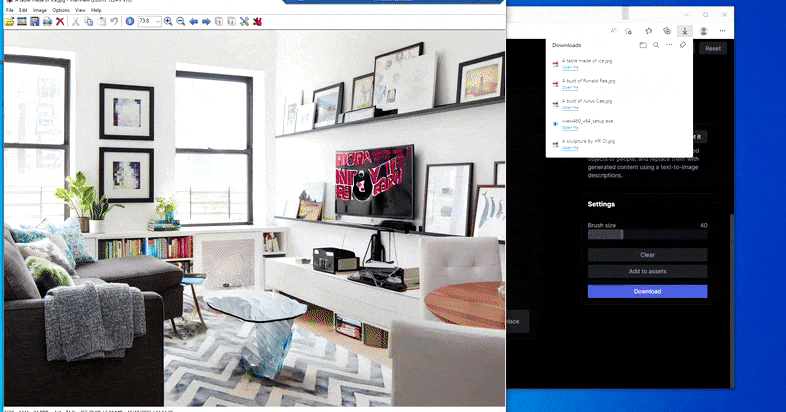
Thay bàn trong nhà bằng một chiếc bàn làm bằng băng trong Erase and Replace của Runway ML.
Giống như Imagic (xem bên dưới), Xóa và Thay Thế là ‘định hướng đối tượng’ – bạn không thể chỉ xóa một phần ‘trống’ của bức ảnh và tái tạo vùng ảnh bằng kết quả từ lời nhắc văn bản; trong trường hợp đó, hệ thống sẽ chỉ truy vết đối tượng gần nhất dọc theo đường nhìn của mặt nạ (như tường hoặc TV) và áp dụng biến đổi ở đó.
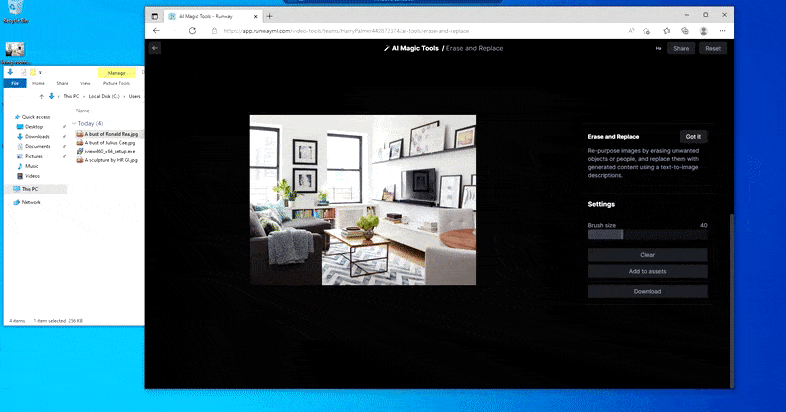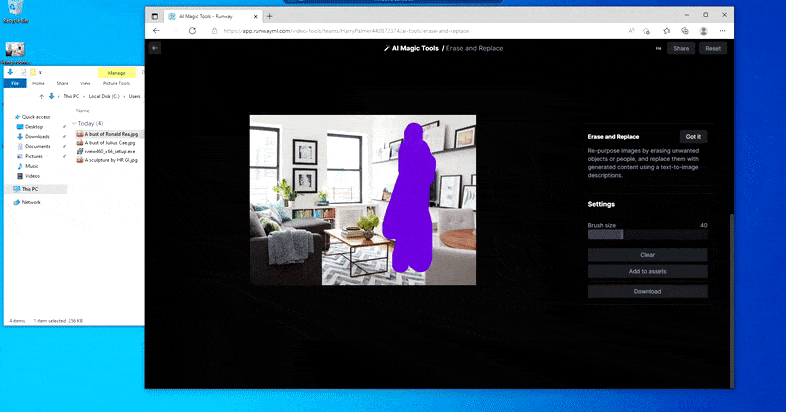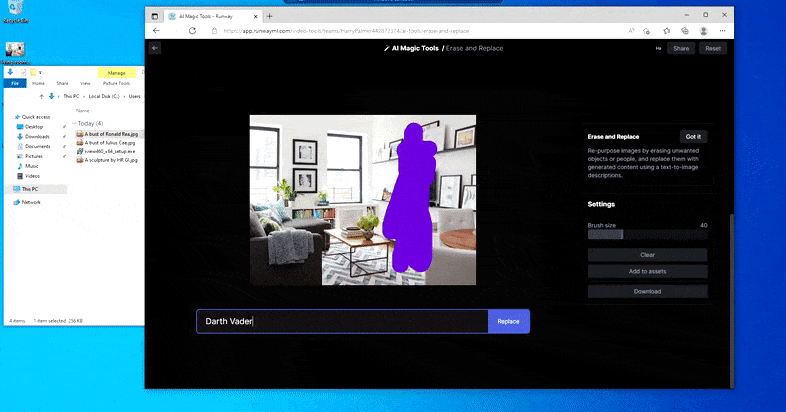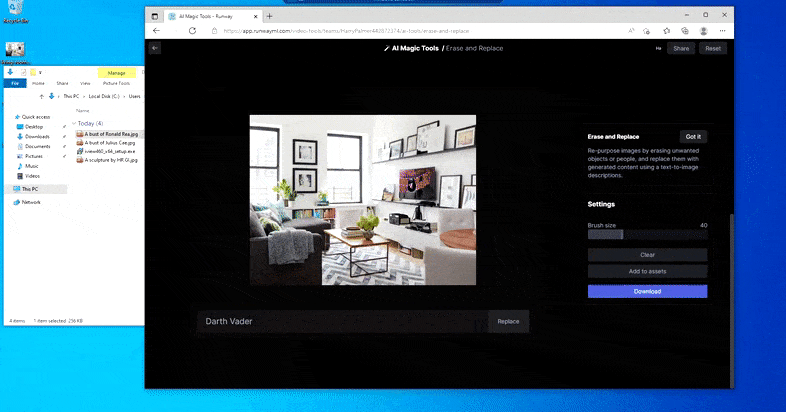
Đúng như tên gọi, Erase and Replace không thể đưa vật thể vào khoảng trống. Ở đây, nỗ lực gọi ra chúa tể Sith nổi tiếng nhất tạo thành bức tranh tường kỳ lạ về Vader trên TV, gần vị trí vùng thay thế được vẽ.
Rất khó để xác định liệu Xóa và Thay Thế có đang né tránh việc sử dụng hình ảnh có bản quyền (vẫn bị hạn chế đáng kể, dù thành công khác nhau, trong DALL‑E 2) hay mô hình được sử dụng trong engine dựng hình phía sau chỉ không được tối ưu cho loại trường hợp này.

Bức tranh tường Nicole Kidman hơi nhạy cảm cho thấy mô hình được cho là dựa trên khuếch tán không có cơ chế từ chối có hệ thống trước đây của DALL-E 2 đối với việc tạo khuôn mặt chân thực hay nội dung gợi cảm. Kết quả tái hiện tác phẩm có bản quyền trải từ mơ hồ (xenomorph) đến phi lý (ngai sắt). Ảnh nguồn nằm trong ô nhỏ ở góc dưới bên phải.
Sẽ rất thú vị nếu biết Xóa và Thay Thế sử dụng phương pháp nào để tách riêng các đối tượng mà nó có thể thay thế. Có lẽ hình ảnh được đưa qua một biến thể của CLIP, với các mục riêng lẻ được xác định bằng nhận dạng đối tượng và phân đoạn ngữ nghĩa tiếp theo. Không thao tác nào trong số này hoạt động gần tốt bằng như vậy trong một cài đặt thông thường của Stable Diffusion.
Nhưng không gì là hoàn hảo – đôi khi hệ thống dường như xóa mà không thay thế, ngay cả khi (như chúng ta đã thấy trong hình trên), cơ chế dựng hình nền chắc chắn hiểu ý nghĩa của lời nhắc văn bản. Trong trường hợp này, việc biến một bàn cà phê thành xenomorph là không thể – thay vào đó, bàn chỉ biến mất.
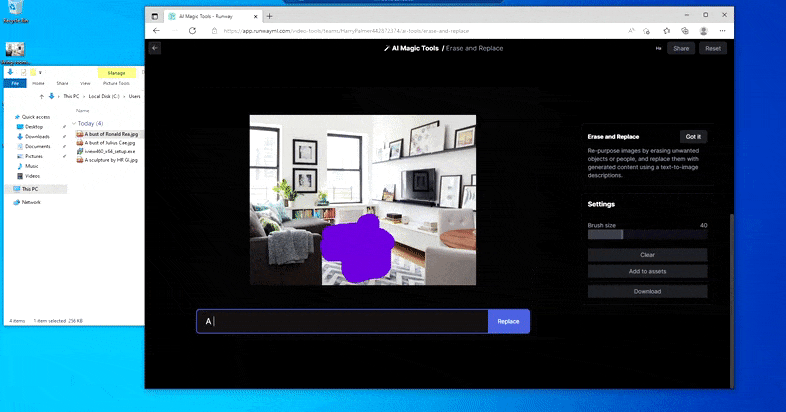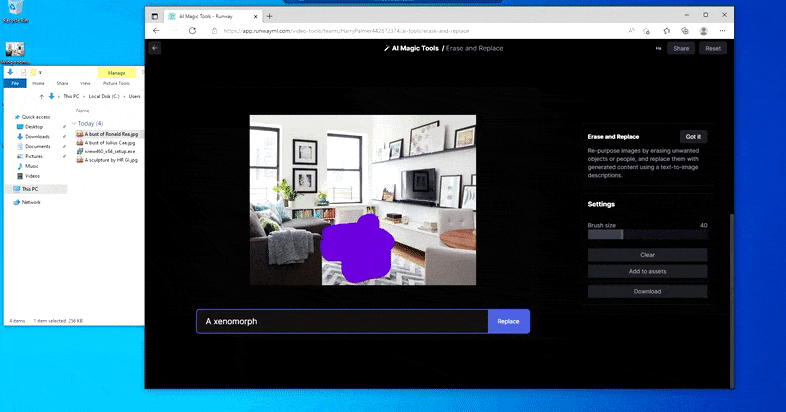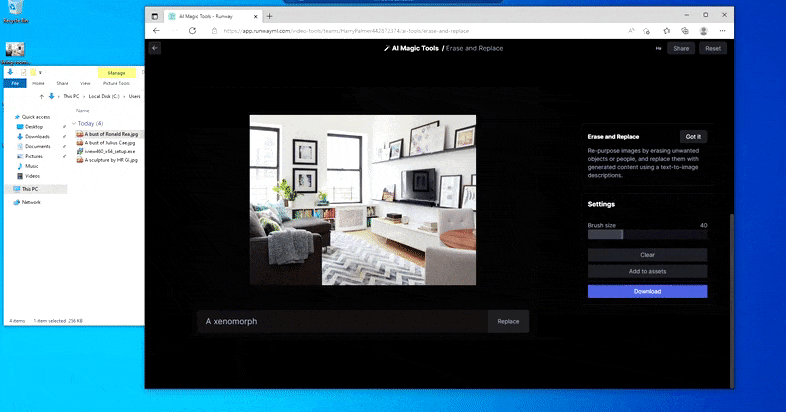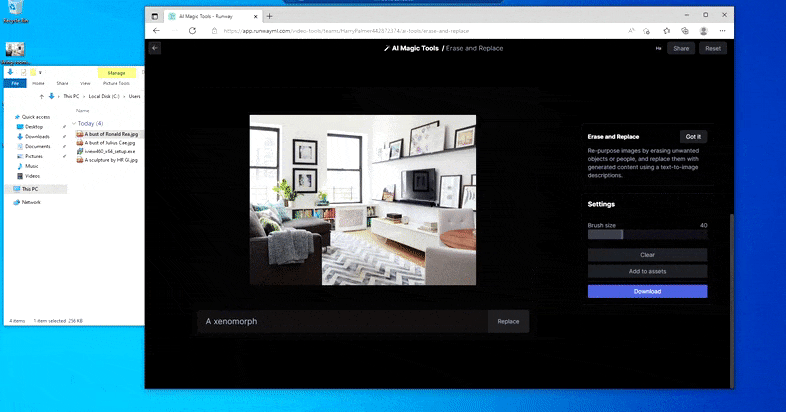
Một phiên bản đáng sợ hơn của trò Where’s Waldo khi Erase and Replace không tạo được người ngoài hành tinh.
Xóa và Thay Thế dường như là một hệ thống thay thế đối tượng hiệu quả, với khả năng tái tạo vùng ảnh xuất sắc. Tuy nhiên, nó không thể chỉnh sửa các đối tượng đã tồn tại mà chỉ thay thế chúng. Thực sự thay đổi nội dung ảnh hiện có mà không làm ảnh hưởng đến môi trường xung quanh là một nhiệm vụ khó hơn nhiều, gắn liền với cuộc đấu tranh lâu dài của lĩnh vực nghiên cứu thị giác máy tính hướng tới tách rời trong các không gian tiềm ẩn của các khung phổ biến.
Imagic
Đó là nhiệm vụ mà Imagic giải quyết. Bài báo mới cung cấp nhiều ví dụ về các chỉnh sửa thành công thay đổi các khía cạnh riêng lẻ của một bức ảnh trong khi để lại phần còn lại của hình ảnh không thay đổi.

Trong Imagic, ảnh đã sửa không bị kéo giãn, méo dạng hay suy đoán phần bị che khuất như kỹ thuật điều khiển hình ảnh deepfake vốn dùng thông tin tiên nghiệm hạn chế từ một ảnh duy nhất.
Hệ thống sử dụng quy trình ba giai đoạn – tối ưu hoá nhúng văn bản; tinh chỉnh mô hình; và cuối cùng, tạo ra hình ảnh đã chỉnh sửa.

Imagic mã hóa lời nhắc văn bản đích để có biểu diễn nhúng văn bản ban đầu, rồi tối ưu kết quả để thu được ảnh đầu vào. Sau đó, mô hình sinh được tinh chỉnh theo ảnh nguồn, bổ sung một loạt tham số trước khi thực hiện phép nội suy được yêu cầu.
Không có gì ngạc nhiên khi khung làm việc dựa trên kiến trúc văn bản‑đến‑video Imagen của Google, mặc dù các nhà nghiên cứu cho biết các nguyên tắc của hệ thống có thể áp dụng rộng rãi cho các mô hình khuếch tán tiềm ẩn.
Imagen sử dụng kiến trúc ba tầng, thay vì mảng bảy tầng được dùng cho phiên bản văn bản‑đến‑video mới hơn của công ty. Ba mô-đun riêng biệt bao gồm một mô hình khuếch tán sinh ra hoạt động ở độ phân giải 64x64px; một mô hình siêu phân giải nâng đầu ra lên 256x256px; và một mô hình siêu phân giải bổ sung để đưa đầu ra lên đến độ phân giải 1024×1024.
Imagic can thiệp ở giai đoạn sớm nhất của quy trình này, tối ưu hoá nhúng văn bản yêu cầu ở mức 64px bằng bộ tối ưu Adam với tốc độ học tĩnh 0.0001.

Một minh chứng xuất sắc về tách biệt biểu diễn: những người từng thử thay màu vật thể được tạo bởi mô hình khuếch tán, GAN hoặc NeRF sẽ hiểu tầm quan trọng của việc Imagic có thể làm vậy mà không phá vỡ tính nhất quán của phần ảnh còn lại.
Sau đó, quá trình tinh chỉnh diễn ra trên mô hình gốc của Imagen, với 1500 bước cho mỗi ảnh đầu vào, dựa trên nhúng đã chỉnh sửa. Đồng thời, lớp phụ 64px>256px được tối ưu song song trên ảnh đã điều kiện. Các nhà nghiên cứu lưu ý rằng việc tối ưu tương tự cho lớp cuối cùng 256px>1024px ‘hầu như không ảnh hưởng’ đến kết quả cuối cùng, vì vậy họ không thực hiện bước này.
Bài báo cho biết quá trình tối ưu mất khoảng tám phút cho mỗi ảnh trên hai chip TPUV4. Quá trình dựng hình cuối cùng diễn ra trong lõi Imagen theo sơ đồ lấy mẫu DDIM.
Tương tự như các quy trình tinh chỉnh cho DreamBooth của Google, các nhúng thu được còn có thể được dùng để tạo phong cách, cũng như các chỉnh sửa ảnh thực tế dựa trên thông tin từ cơ sở dữ liệu nền rộng hơn hỗ trợ Imagen (vì, như cột đầu tiên dưới đây cho thấy, các ảnh nguồn không có nội dung cần thiết để thực hiện những biến đổi này).

Imagic cho phép thay đổi chuyển động và chỉnh sửa linh hoạt với độ chân thực như ảnh chụp. Những mã được suy ra và tách biệt trong quá trình này cũng dễ dàng dùng để tạo đầu ra cách điệu.
Các nhà nghiên cứu đã so sánh Imagic với các công trình trước đó SDEdit, một phương pháp dựa trên GAN từ năm 2021, hợp tác giữa Đại học Stanford và Đại học Carnegie Mellon; và Text2Live, một dự án hợp tác từ tháng 4/2022 giữa Viện Khoa học Weizmann và NVIDIA.

So sánh trực quan giữa Imagic, SDEdit và Text2Live.
Rõ ràng các cách tiếp cận trước đây đang gặp khó khăn, nhưng ở hàng dưới, nơi cần thay đổi tư thế mạnh mẽ, các phương pháp hiện có hoàn toàn không thể biến đổi lại hình ảnh nguồn, trong khi Imagic đạt được thành công đáng chú ý.
Yêu cầu tài nguyên và thời gian huấn luyện cho mỗi ảnh của Imagic, dù ngắn so với tiêu chuẩn của những nỗ lực này, khiến nó khó có khả năng được tích hợp vào ứng dụng chỉnh sửa ảnh cục bộ trên máy tính cá nhân – và chưa rõ quy trình tinh chỉnh có thể được thu nhỏ đến mức tiêu dùng như thế nào.
Hiện tại, Imagic là một sản phẩm ấn tượng, phù hợp hơn với các API – một môi trường mà Google Research, do lo ngại chỉ trích liên quan đến việc hỗ trợ deepfake, có thể cảm thấy thoải mái nhất.
Được xuất bản lần đầu vào ngày 18 tháng 10 năm 2022.


