
Röportajlar
Xavier Conort, FeatureByte’nin Kurucu Ortağı ve Ürün Başkanı – Röportaj Serisi

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
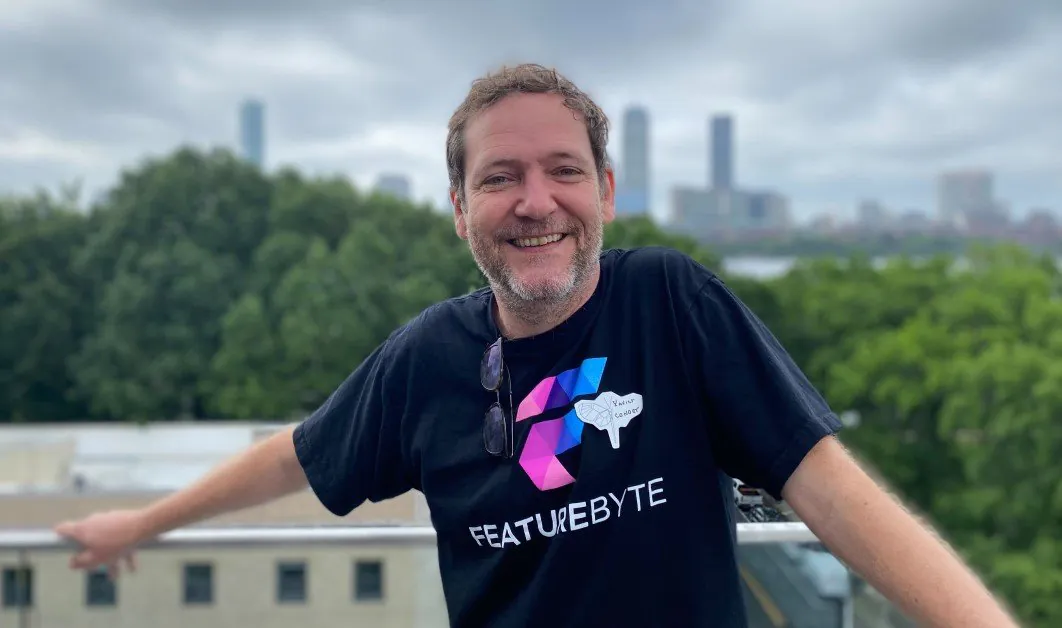
Xavier Conort 25 yılı aşkın veri deneyimine sahip bir vizyoner veri bilimcisidir. Kariyerine sigorta endüstrisinde aktüer olarak başladı ve daha sonra veri bilimine geçti. Kaggle yarışmalarında üst sıralarda yer alan bir veri bilimcisi ve DataRobot’ta Baş Veri Bilimcisi olarak görev yaptı, ardından FeatureByte’i kurdu.
FeatureByte ,kurumsal AI’yi ölçeklendirerek, AI verilerini köklü bir şekilde basitleştirerek ve endüstrileştirerek bir misyon üzerine kurulmuştur. Özellik mühendisliği ve yönetim platformu, veri bilimcilerin son teknoloji özellikleri ve üretimde kullanıma hazır veri hatlarını dakikalar içinde oluşturup paylaşmalarını sağlar – haftalar veya aylar yerine.
Kariyerinize sigorta endüstrisinde aktüer olarak başladınız, daha sonra veri bilimine geçtiniz, bu geçişin nedeni nedir?
Belirleyici bir an, GE Flight Quest’i kazanmak oldu, bu yarışmada 250.000 dolarlık bir ödül havuzu vardı ve katılımcıların ABD iç hat uçuşlarındaki gecikmeleri tahmin etmesi gerekiyordu. Bu başarının bir kısmını, eğitim verisinde yeterince temsil edilmeyen özelliklerdeki önyargıyı kontrol etmeye yardımcı olan 2 aşamalı modelleme uygulamasına borçluyum. Kaggle’deki diğer zaferlerimle birlikte bu başarı, veri biliminde aktüeryal geçmişimin bana rekabet avantajı sağladığını bana gösterdi.
Kaggle yolculuğum sırasında, DataRobot’un kurucuları olan Jeremy Achin ve Tom De Godoy gibi diğer veri bilimcileri ile tanıştım. Bizimle birlikte sigorta geçmişine sahiptik ve Kaggle’de önemli başarılar elde ettik. DataRobot‘u kurduklarında, AutoML uzmanlaşmış bir şirket olarak beni Baş Veri Bilimcisi olarak katılmaya davet ettiler. Sigorta endüstrisinin en iyi uygulamalarını makine öğrenimi gücünü birleştirmeyi amaçlayan vizyonları beni heyecanlandırdı ve yenilikçi ve etkili bir şey yaratma fırsatı sundu.
DataRobot’ta veri bilim yol haritanızı oluştururken hangi tür veri zorluklarıyla karşılaştınız?
Karşılaştığımız en önemli zorluk, AutoML çözümümüze girdi olarak verilen verilerin değişen kalitesiydi. Bu sorun, ekibimiz ve müşterilerimiz arasında zaman alıcı işbirliğine veya üretim aşamasında uygun şekilde ele alınmazsa hayal kırıklığına yol açan sonuçlara neden oluyordu. Kalite sorunları, bizim dikkat etmemiz gereken birden fazla kaynaktan kaynaklanıyordu.
İş zekası araçlarının veri hazırlama ve yönetiminde kullanılması, birincil zorluklardan biriydi. Bu araçlar, içgörüler üretmek için değerli olsa da, makine öğrenimi verisini hazırlarken her kayıt için ilgili zamanda gerçekten mevcut olan bilgilerin kullanılmasını sağlayan zaman noktası doğruluğu yeteneklerine sahip değildir. Bu nedenle, eğitim verisinde sızıntılar oluşabilir, bu da aşırı uyuma ve model performansının hatalı olmasına yol açabilir.
Veri bilimcileri ve veri mühendisleri arasında yanlış iletişim, üretim aşamasında model performansını etkileyen bir başka zorluktu. Bu iki ekip arasındaki uyumsuzluğun eğitim ve üretim aşamaları arasında yarattığı tutarsızlıklar gerçek dünya ortamında model performansını etkileyebilirdi.
Bu deneyimden elde ettiğiniz bazı önemli çıkarımlar nelerdir?
DataRobot’taki deneyimim, makine öğreniminde veri hazırlamanın önemini vurguladı. Eğitim verisi oluşturma zorluklarını ele alarak, yani zaman noktası doğruluğunu, uzmanlık açıklarını, alan bilgisini, araç sınırlamalarını ve ölçeklenebilirliği ele alarak, makine öğrenimi modellerinin doğruluğunu ve güvenilirliğini artırabiliriz. Veri hazırlama sürecini basitleştirmek ve yenilikçi teknolojileri entegre etmek, AI’nin vaatlerini yerine getirmek ve tam potansiyelini açığa çıkarmak için çok önemlidir.
Kurucu ortağınız Razi Raziuddin ile yapılan röportajda FeatureByte’nin köken hikayesini dinledik, sizin versiyonunuzu alabilir miyiz?
Kurucu ortağım Razi Raziuddin ile gözlem ve içgörülerimi konuşurken, makine öğrenimi için veri hazırlama zorlukları konusunda ortak bir anlayışımız olduğunu gördük. MLOps topluluğundaki son gelişmeleri onunla paylaştım. AI odaklı teknoloji şirketlerinin özellik sunma gecikmesini azaltmak, özelliklerin yeniden kullanımını teşvik etmek ve eğitim ile sunumun tutarlı olmasını sağlayarak özellikleri eğitim verisine dönüştürmeyi kolaylaştırmak için özellik depoları ve platformları kurduğunu gözlemledim. Ancak veri bilimcilerinin ihtiyaçlarını karşılamada hâlâ boşluk vardı. Razi de modern veri yığınının iş zekâsı ve analitiği nasıl dönüştürdüğünü, fakat AI için henüz tam kullanılmadığını anlattı.
Razi ile benim için açık olan şey, özellik mühendisliği sürecini köklü bir şekilde basitleştirerek ve veri bilimcilerine ve ML mühendislerine özellik deneyleri ve özellik sunumu için doğru araçları ve kullanıcı deneyimini sağlayarak önemli bir etki yaratma fırsatımız olduğu idi.
Veri bilimcisinden girişimciye geçiş yaparken karşılaştığınız en büyük zorluklar nelerdi?
Veri bilimcisinden girişimciye geçmek, teknik bir perspektiften daha geniş bir iş odaklı zihniyete geçmek anlamına geliyordu. Hala sorun alanlarını anlamak, yol haritası oluşturmak, planları uygulamak, takım oluşturmak ve bütçeleri yönetmek için güçlü bir temelim vardı, ancak hedef kitlemizle gerçekten karşılık bulan doğru mesajı oluşturmak benim için en büyük zorluklardan biriydi.
Veri bilimcisi olarak, odak noktam her zaman verilerin analizini ve yorumlanmasını yaparak değerli içgörüler elde etmek üzerine olmuştu. Ancak, girişimci olarak, düşünceyi pazar, müşteriler ve genel iş üzerine yöneltmek zorundaydım.
Şanslıyım ki, bu zorluğu aşmak için Razi gibi birinin deneyiminden yararlanabildim.
Razi ile yapılan röportajda özellik mühendisliğinin neden zor olduğu hakkında bilgi aldık, sizin görüşünüz nedir?
Özellik mühendisliği iki ana zorluğa sahiptir:
- Mevcut sütunları dönüştürme: Bu, verileri makine öğrenimi algoritmaları için uygun bir forma dönüştürmeyi içerir. One-hot encoding, özellik ölçekleme ve metin ve görüntü dönüşümleri gibi gelişmiş yöntemler kullanılır. Mevcut özelliklerden etkileşim özellikleri gibi yeni özellikler oluşturmak, model performansını büyük ölçüde artırabilir. Scikit-learn ve Hugging Face gibi popüler kütüphaneler, bu tür özellik mühendisliği için geniş destek sağlar. AutoML çözümleri de bu süreci basitleştirmeyi amaçlar.
- Tarihi verilerden yeni sütunlar çıkarma: Tarihi veriler, öneri sistemleri, pazarlama, dolandırıcılık tespiti, sigorta fiyatlandırması, kredi puanlaması, talep tahmini ve sensör verileri işleme gibi problem alanlarında çok önemlidir. Bu verilerden bilgilendirici sütunlar çıkarmak zorlu bir görevdir. Örnekler, son olaydan bu yana geçen süre, yakın olaylar üzerinde agregasyonlar ve olay dizilerinden gömme vektörleri içerir. Bu tür özellik mühendisliği, alan uzmanlığını, deneysel çalışmayı, güçlü kodlama ve veri mühendisliği becerilerini ve derin veri bilimi bilgilerini gerektirir. Zaman sızıntısı, büyük veri kümelerini işleme ve verimli kod yürütme gibi faktörler de dikkate alınmalıdır.
Genel olarak, özellik mühendisliği uzmanlık, deneysel çalışma ve karmaşık ad-hoc veri boru hatlarının inşası gerektirir ve bu iş için özel olarak tasarlanmış araçlar olmadan yapılır.
FeatureByte nasıl veri bilimcilerini güçlendirir ve özellik boru hatlarını basitleştirir?
FeatureByte, özellik mühendisliği sürecini basitleştirerek veri bilimcilerini güçlendirir. Akıllı bir Python SDK ile, çok büyük olay ve öğe tablolarından hızlı özellik oluşturma ve çıkarma sağlar. Hesaplama, Snowflake, DataBricks ve Spark gibi veri platformlarının ölçeklenebilirliğini kullanarak verimli bir şekilde gerçekleştirilir. Çalışma defterleri (notebook), deneysel çalışmayı kolaylaştırır, özellik paylaşımı ve yeniden kullanımı zaman kazandırır, denetim özelliği doğruluğunu sağlar ve anında dağıtım, boru hattı yönetiminden kaynaklanan baş ağrılarını ortadan kaldırır.
Açık kaynak kütüphanemizdeki yeteneklerin yanı sıra, kurumsal çözümümüz, AI operasyonlarını ölçeklendirerek yönetmek ve organize etmek için kapsamlı bir çerçeve sunar, bu çerçeve içinde yönetişim iş akışları ve özellik kataloğu için bir kullanıcı arayüzü bulunur.
FeatureByte’nin geleceği için vizyonunuz nedir?
FeatureByte için nihai vizyonumuz, veri bilim ve makine öğrenimi alanını, kullanıcıların veri varlıklarından daha önce görülmemiş değerler elde etmelerini sağlayarak devrimleştirerek, yaratıcı potansiyellerini açığa çıkarmaktır.
Özellikle Generatif AI ve transformers’in hızlı ilerlemesi bizi heyecanlandırıyor, bu da kullanıcılarımız için yeni olanaklar açıyor. Ayrıca, özellik mühendisliğini demokratikleştirmeye kararlıyız. Generatif AI, yaratıcı özellik mühendisliği için giriş engelini düşürerek, daha geniş bir kitleye ulaşılmasını sağlayabilir.
Özetle, FeatureByte’nin geleceği için vizyonumuz, sürekli yenilik, Generatif AI’nin gücünü kullanmak ve özellik mühendisliğini demokratikleştirmek etrafında dönüyor. Veri profesyonellerinin ham verileri makine öğreniminde kullanılabilir girdilere dönüştürmesini sağlayan, sektörler genelinde ilerlemeleri ve atılımları teşvik eden bir platform olmak istiyoruz.
AI girişimcisi olmak isteyenlere tavsiyeniz nedir?
Alanınızı tanımlayın, odaklanın ve yeniliği karşılayın.
İstediğiniz alanı tanımlayarak, kendinizi farklılaştırabilir ve o alanda güçlü bir varlık oluşturabilirsiniz. Pazarı araştırın, potansiyel müşterilerin ihtiyaçlarını ve sorun alanlarını anlayın ve bu zorlukları etkili bir şekilde ele alan benzersiz bir çözüm sunmaya çalışın.
Uzun vadeli vizyonunuzu tanımlayın ve bu vizyona uygun, net kısa vadeli hedefler belirleyin. Güçlü bir temel oluşturmak ve seçtiğiniz alanda değer sağlamak üzerine odaklanın.
Son olarak, odaklanmak önemli olsa da belirlediğiniz alanda yeniliği benimsemekten ve yeni fikirleri keşfetmekten çekinmeyin. AI alanı sürekli gelişiyor ve yenilikçi yaklaşımlar yeni fırsatlar açabilir.
Harika bir röportaj için teşekkür ederiz, daha fazla bilgi edinmek isteyen okuyucular FeatureByte ziyaret edebilir.








