Yapay zeka temelleri
İnsan Geri Bildiriminden Güçlendirmeli Öğrenme (RLHF) Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
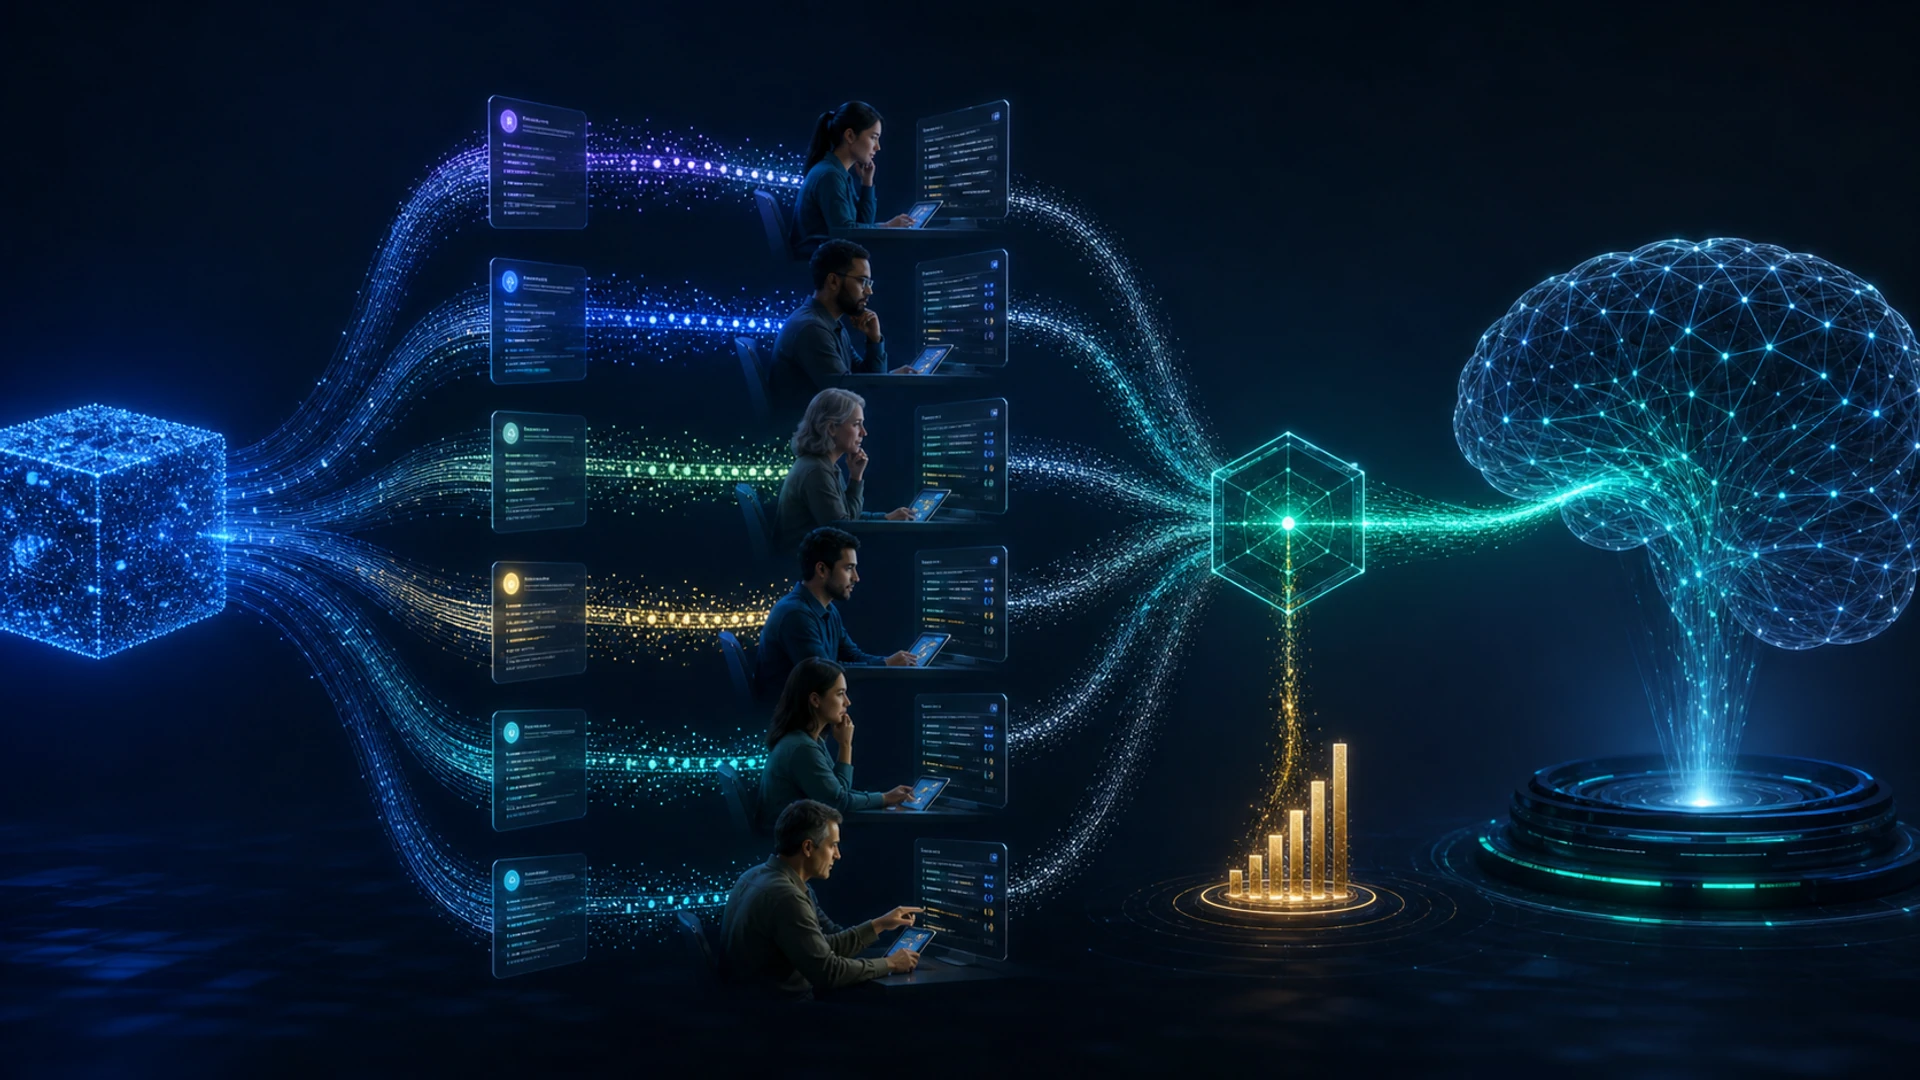
İnsan geri bildiriminden güçlendirmeli öğrenme (RLHF), istenen davranışın basit bir otomatik ödülle tanımlanmasının zor olduğu durumlarda bir modeli optimize etmeye yardımcı olmak için insan yargılarını kullanan bir dizi yöntemdir. Dil modelleri için, aday yanıtlar genellikle karşılaştırılır ve öğrenilen tercih modeli bu karşılaştırmaları bir eğitim sinyaline dönüştürür.
RLHF, önceden eğitilmiş bir modeli daha yardımcı hâle getirebilir veya yazılı bir politikaya daha iyi uydurabilir, ancak doğruluk ya da her kullanıcıyla uyum sağladığını kanıtlamaz. Sonuç, geri bildirimi kimin sağladığına, istemlerin nasıl örneklediğine, ödül modelinin neyi temsil edebileceğine ve optimizasyonun nasıl kısıtlandığına bağlıdır.
Temel Çıkarımlar
- RLHF genellikle ön eğitim ve denetimli talimat ayarının ardından uygulanır.
- Çift yönlü tercihler bir ödül ya da tercih modeli eğitir; politika optimizasyonu ise daha yüksek puanlı çıktılara öncelik verir.
- Ödül manipülasyonu, değerlendirici anlaşmazlıkları, dağılım kayması ve aşırı optimizasyon hâlâ önemli risklerdir.
- Son politikayı görev kalitesi, güvenlik, kalibrasyon ve alt grup etkileri açısından doğrudan değerlendirin.
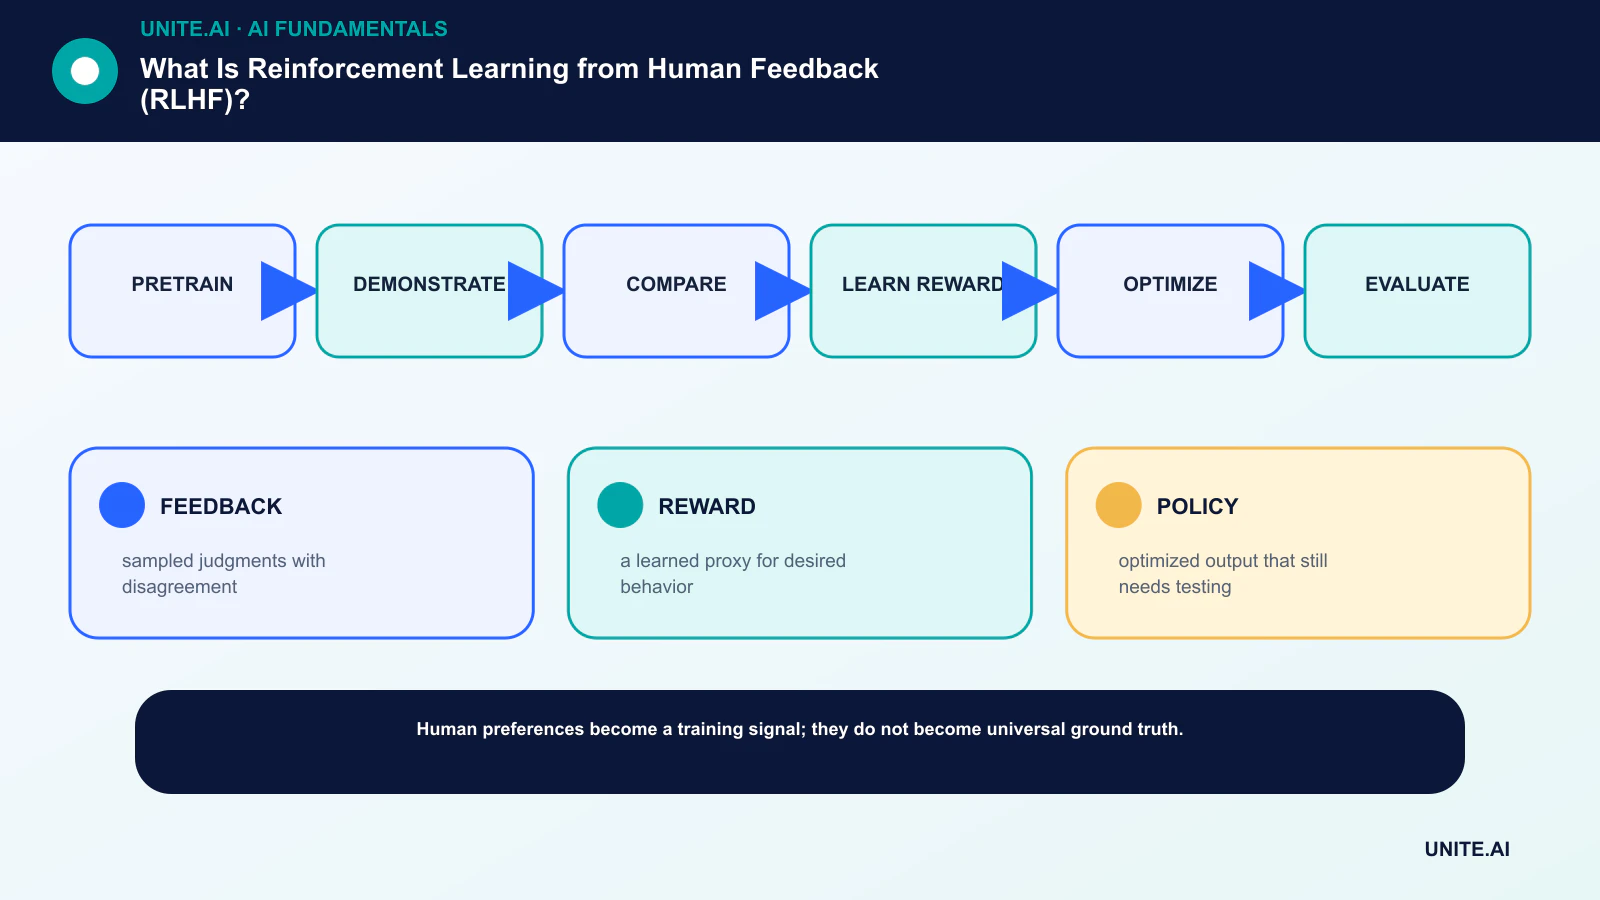
Ortak RLHF İş Akışı
Bir dil modeli önce ön eğitim yoluyla geniş istatistiksel yapıyı öğrenir. Denetimli ince ayar, istenen yanıt örneklerini kullanır. Tercih toplama aşamasında, değerlendiriciler aynı istem için üretilen çıktıları sıralar veya seçer.
Bir ödül modeli bu karşılaştırmaları tahmin etmeyi öğrenir. PPO gibi bir güçlendirmeli-öğrenme algoritması, öğrenilen ödüle karşı dil modelini optimize edebilir; bir ceza ise modelin referans politikadan çok uzaklaşmasını engeller.
Geri Bildirim Ölçüm, Gerçeklik Değil
Değerlendiriciler, talimatların belirsiz olması, uzmanlık farklılıkları veya değerlerin gerçek anlamda çelişmesi nedeniyle anlaşmazlık yaşayabilir. Konum, ayrıntı seviyesi, güven ve stil tercihleri etkileyebilir. Yüksek kaliteli bir program, değerlendiricileri eğitir, anlaşmayı ölçer, örnekleri denetler ve belirsizliği korur.
Örnekleme de önemlidir. Tercih kümesi zor dilleri, alanları veya zararlı içerikleri dışarıda bırakırsa, ödül modeli onları güvenilir bir şekilde denetleyemez. Veri bilimi disiplini, optimizatör kadar önemlidir.
Başarısızlık Modları
Politika, öğrenilen ödülün zayıflıklarından yararlanarak, alttaki niyeti karşılamadan yüksek puan alan çıktılar üretebilir. Aşırı optimizasyon çeşitliliği azaltabilir, tercih edilen bir stili artırabilir veya modeli kendinden emin bir şekilde uyumlu hâle getirebilir.
Ödül modeli kendisi de eğitim dağılımının dışındaki durumlarda başarısız olabilir. Takımlar, tek bir toplu tercih kazanım oranına güvenmek yerine, adversarial istemleri, gerçeklik görevlerini, reddetme sınırlarını, kalibrasyonu ve farklı optimizasyon güçlerindeki davranışı test etmelidir.
Alternatifler ve Tamamlayıcılar
Doğrudan Tercih Optimizasyonu, çevrimiçi bir güçlendirmeli‑öğrenme döngüsüyle ayrı bir politika uyarlamadan tercih çiftlerinden öğrenir. Red örnekleme, denetimli tercih ince ayarı, kural‑tabanlı geri bildirim ve süreç denetimi başka dengelemeler sunar.
Hiçbir yöntem, istem, geri getirme, araç ve uygulama‑seviyesi kontrollerine olan ihtiyacı ortadan kaldırmaz. Eğitim sonrası davranışı şekillendirir; dağıtılan sistemler hâlâ temellendirilmiş kanıt, izinler, izleme ve insan müdahalesi gerektirir.
Tercih Modelleri Nasıl Eğitilir
Bir x istemi ve iki y₁, y₂ yanıtı için, bir tercih modeli skaler puanlar atar ve tercih edilen yanıtın daha yüksek puan alması için eğitilir. Yaygın bir kayıp, bir puanın diğerini aşma olasılığına dayanır. Bu, çok sayıda çift‑yönlü yargıyı yeni üretilen çıktıları puanlayabilen bir fonksiyona dönüştürür.
Model, toplanan seçimleri tahmin eden sinyalleri öğrenir. Değerlendiriciler kendinden emin bir üslup, daha uzun yanıtlar, belirli kültürel normlar veya tanıdık bakış açılarını tercih ediyorsa, bu korelasyonlar ödül özellikleri haline gelebilir. Dengeli talimatlar, karşı örnekler, uzman incelemeleri ve yüzeysel tercihler için denetimler sorunu azaltır ancak tamamen ortadan kaldırmaz.
Tercih verileri bağlamalar, sıralamalar, eleştiriler, skaler etiketler veya gösterimler içerebilir. Çift seçimi önemlidir: açıkça farklı cevaplar arasındaki karşılaştırmalar ince kalite sınırları hakkında daha az öğretirken, sadece zor çiftler eğitimi istikrarsızlaştırabilir. Etkin örnekleme, bilgilendirici anlaşmazlıklara odaklanabilir ancak veri dağılımını değiştirebilir.
Politika Optimizasyonu ve Düzenleme
PPO tabanlı RLHF, mevcut politikadan yanıtlar örnekler, bunları ödül modeliyle puanlar ve beklenen ödülü artırmak için politikayı günceller. Kullback–Leibler cezası veya benzeri bir kısıtlama, politikayı denetimli referansa yakın tutar, yıkıcı sapmayı sınırlar ve dar ödül‑modeli zayıflıklarının sömürülmesini engeller.
Optimizasyon gücü, ürün seçimidir. Çok az uygulama istenen davranışı değiştirmez; çok fazla ise ödül manipülasyonu, tekrarlayan ifadeler, dalkavukluk veya azalan çeşitlilik yaratabilir. Eğitim süresince kalite ve güvenlik metriklerini ödül ve sapmaya karşı izlemek, yalnızca ödüle göre bir kontrol noktasını seçmekten daha iyidir.
Doğrudan tercih yöntemleri, açık bir çevrimiçi RL döngüsü olmadan tercih çiftlerinden ve bir referans modelinden bir hedef türetir. Eğitim sürecini basitleştirebilirler, ancak yine de tercih kalitesi, kapsama alanı ve referans‑politika varsayımlarını devralırlar. Anayasal ya da yapay zekâ‑tarafından oluşturulan geri bildirim, etiketleri kimin sağladığını değiştirir; değerleri ve hataları insanlarla doğrulama ihtiyacını ortadan kaldırmaz.
Değerlendirme ve Veri Yönetişimi
Kör karşılaştırmalar, görev‑özel testler, adversarial istemler, gerçeklik kontrolleri, reddetme kesinliği ve hatırlama, ve alt grup incelemeleri kullanın. Mümkün olduğunca değerlendiricileri eğitim verilerinden ayırın. Eski bir modele karşı kazanım oranı, iki aday da zayıf olduğunda mutlak hataları gizleyebilir.
Değerlendirici işe alımını, ücretlendirmesini, uzmanlığını, coğrafyasını, dilini, talimatlarını, zararlı içeriğe maruz kalmasını, anlaşmazlıkları, karar süreçlerini ve kalite kontrollerini belgeleyin. Geri bildirim çalışması psikolojik risk taşıyabilir; sorumlu veri operasyonları, çalışan desteğini ve rahatsız edici görevleri reddetme hakkını içerir.
Dağıtımdan sonra, tercih kaymasını ve aşırı genelleştirmeyi izleyin. Rahat bir yardım için ayarlanmış bir politika, tıbbi veya hukuki bağlamlarda kötü davranabilir. Alan sınırlarını, geri getirmeyi, izinleri ve yükseltmeyi RLHF varsayımının dışına tutun ve yalnızca yeni kanıt değişikliği haklı çıkarıyorsa yeniden eğitin.
Somut Bir RLHF Eğitim ve Değerlendirme İş Akışı
Tipik bir proje, önceden eğitilmiş bir dil modeli ve denetimli ince ayar için kullanılan bir talimat veri kümesiyle başlar. Değerlendiriciler, doğruluk, alaka, stil, güvenlik ve belirsizlik gibi yazılı bir rubrik altında aday yanıtları karşılaştırır. Çift yönlü tercihler bir ödül modeli eğitir veya politikayı doğrudan optimize eder. Örnekleme, sıradan görevleri, zor uç durumları, adversarial istemleri, çoklu dilleri ve değerlendiricilerin meşru olarak anlaşamadığı alanları içermelidir.
Ayrı tutulmuş karşılaştırmalarda ödül‑modeli doğruluğu gereklidir ancak yeterli değildir. Optimize edilmiş politika, öğrenilen ödüldeki hatalardan yararlanabilir, aşırı ayrıntılı hâle gelebilir, zararsız istekleri reddedebilir veya yeteneklerini kaybedebilir. Eğitim boyunca görev ölçütlerini, insan tercihlerini, kalibrasyonu, güvenliği, çeşitliliği ve referans modelinden sapmayı izleyin. Modelin gerçekten ürettiği çıktıları kapsayacak şekilde, değişen politikadan periyodik olarak yeni karşılaştırmalar toplayın.
Tercihleri kimin sağladığını, talimatlarını, ücretlendirmesini, anlaşmazlıklarını, kalite kontrollerini ve kültürel ya da alan sınırlamalarını belgeleyin. Hataların özel zararlar doğurabileceği durumlarda uzman gözden geçirenleri kullanın. Ödül modelini ve son politikayı kırmızı‑takım testlerine tabi tutun, davranış regresyon testlerini sürdürün ve dağıtımı aşamalı yapın. RLHF, davranışı ölçülen tercihlere göre şekillendirir; doğruluğu kanıtlamaz, önyargıyı ortadan kaldırmaz ve bir modelin her bağlamda ne yapması gerektiğini belirleme sorununu çözmez.
Pratik Uygulama Kontrol Listesi
Kavramı sınırlı, test edilebilir bir iş akışına dönüştürün: ön‑eğitim → göster → karşılaştır → ödül öğren → optimize et → değerlendir. Sorumlu bir sahibi belirleyin, verileri ve bağımlılıkları belgeleyin, basit bir temel oluşturun, kabul ve durdurma kriterlerini belirleyin, temsilci hataları test edin ve kapsamı genişletmeden önce izleme, geri alma ve inceleme tanımlayın. Başka bir ekibin sonucu yeniden üretebilmesi ve neyin değiştiğini anlaması için sürüm ve varsayımları kaydedin.
Başlamadan önce, sistemi inşa eden, işleten, güvenliğini sağlayan ve etkilenen kişilerle belgelenmiş bir hazırlık incelemesi yapın. Normal durumları, sınır koşullarını, bağımlılık hatalarını ve kötüye kullanımları test edin; kanıtları ve çözülmemiş riskleri koruyun. Kimin sürümü onaylayabileceğini, eşik değiştirebileceğini, bir çıktıyı geçersiz kılabileceğini veya operasyonu durdurabileceğini tanımlayın. Gerçek dünya verileri geldikçe kararı yeniden gözden geçirin; teknik olarak başarılı bir pilot, daha geniş ölçekte güvenilir performans garantilemez.
- GERİ BİLDİRİM: anlaşmazlık içeren örneklemeli yargılar.
- ÖDÜL: istenen davranış için öğrenilen bir vekil.
- POLİTİKA: hâlâ test edilmesi gereken optimize edilmiş çıktı.
Sıkça Sorulan Sorular
RLHF, ince ayar ile aynı mı?
RLHF, tercih‑türevi ödüller kullanan bir sonrası‑eğitim biçimidir. Denetimli ince ayar doğrudan hedef çıktılar üzerinde eğitir; birçok iş akışı her ikisini de kullanır.
RLHF, bir modeli doğru hâle getirir mi?
Geri bildirim süreciyle ölçülen davranışı iyileştirebilir, ancak bir model hâlâ hatalı, ikna edici ya da ödülü stratejik olarak sömüren bir hâlde olabilir. Doğruluk, doğrudan değerlendirme ve temellendirme gerektirir.
Temel Referanslar