Yapay zeka temelleri
Gradient Descent Nedir?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Gradient descent model parametrelerini bir hedef fonksiyonunu azaltmak için ayarlayan bir optimizasyon yöntemidir. Sinir ağı eğitiminde bu hedef genellikle örnekler üzerinden hesaplanan bir kayıptır. Gradyan, yerel olarak en dik artış yönünü gösterir, bu yüzden gradient descent ters yönde bir adım atar.
Gradyan yerel duyarlılığı tanımlar; büyüklüğü bir modelin ne kadar hızlı “öğrendiğinin” doğrudan ölçüsü değildir. Gerçek ilerleme ayrıca öğrenme oranı, eğrilik, gürültü, parametreleme, optimizasyon durumu ve veriye bağlıdır.
Temel Çıkarımlar
- Backpropagation gradyanları hesaplar, gradient descent ise bunları parametreleri güncellemek için kullanır.
- Mini-batch optimizasyonu, derin öğrenme için standart pratik yaklaşımdır.
- Öğrenme oranı güncelleme ölçeğini kontrol eder ve her adımdan sonra küçülmek yerine bir takvime göre değişebilir.
- Momentum, AdamW, clipping ve normalizasyon farklı optimizasyon problemlerine çözüm sunar.
Temel Güncelleme Kuralı
Parametre vektörü θ, öğrenme oranı η ve kayıp L:
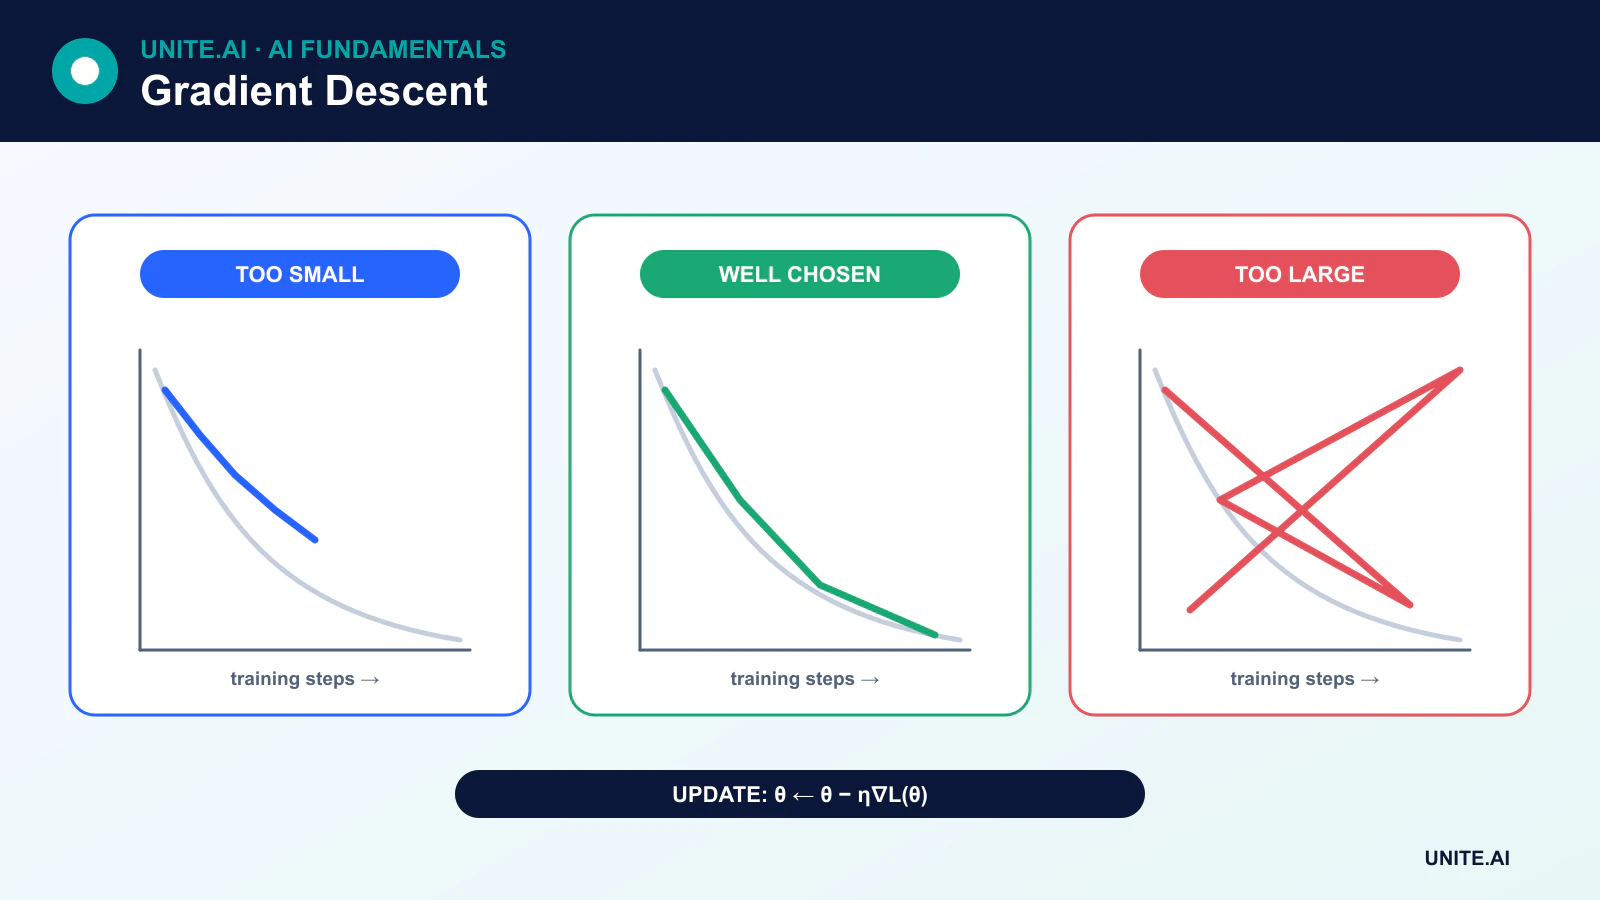
θ ← θ - η∇L(θ)
∇L(θ) gradyanı, her parametre için bir kısmi türev içerir. Bunu çıkarmak yerel olarak aşağı doğru hareket eder. Durağan bir noktanın gradyanı sıfırdır, ancak bu bir minimum, maksimum, eyer noktası ya da düz bir bölge olabilir. Derin‑learning kayıp yüzeyleri konveks değildir, bu yüzden eğitim benzersiz bir küresel minimum ya da sıfır kayıp bulmayı garanti etmez.
Batch, stochastic ve mini-batch yöntemleri
Batch gradyan inişi
Batch gradyan inişi, her güncelleme için tam eğitim setini kullanarak bir gradyan hesaplar. Tahmin stabildir ancak zaman ve bellek açısından maliyetli olabilir ve bir güncelleme modern hızlandırıcıları yeterince kullanmayabilir.
Stochastic gradyan inişi
Katı stochastic gradyan inişi, her güncelleme için rastgele seçilen bir örnek kullanır. Gradyanları gürültülüdür, bu da kayıp yüzeyini keşfetmeye yardımcı olabilir, ancak tek örnekli işlemler paralel donanımda verimsiz olabilir.
Mini-batch gradyan inişi
Mini-batch eğitimi, gradyanı örneklerin bir alt kümesinden tahmin eder. İstatistiksel gürültüyü verimli matris işlemleriyle dengeler ve derin öğrenmede yaygın bir yaklaşımdır. Batch boyutu bellek, işleme hızı, gradyan gürültüsü, normalizasyon ve bazen genelleme üzerinde etkilidir.
Öğrenme oranı seçimi
Çok büyük bir oran, faydalı bölgeleri aşabilir veya sapmaya neden olabilir. Çok küçük bir oran ise eğitimi pratik olmayan derecede yavaşlatabilir veya düz bölgelerde takılabilir. En uygun ölçek, optimizatöre, batch boyutuna, modele, başlatmaya ve hedefe bağlıdır.
Takvimler kademeli olarak ısınabilir, kilometre taşlarında azalabilir, kosinüs eğrisi izleyebilir veya doğrulama ilerlemesine yanıt verebilir. Oran her güncellemeden sonra monoton şekilde küçülmek zorunda değildir. Isınma yeniden başlatmaları ve döngüsel takvimler, eğitimin belirli bölümlerinde bilinçli olarak artırır.
Momentum
Momentum, geçmiş gradyanların üstel hareketli ortalamasını tutar. Tutarlı yönlerde ilerlemeyi hızlandırabilir ve dik, dar yönlerde salınımları azaltabilir. Nesterov tarzı momentum, momentum yönünde ileri bakıldıktan sonra gradyanı değerlendirir ya da yaklaşık olarak hesaplar.
Uyarlamalı optimizatörler
RMSProp, kare gradyanların hareketli ortalamasını kullanarak güncellemeleri ölçeklendirir. Adam, momentum benzeri birinci anları ikinci an ölçeklendirmesiyle birleştirir. AdamW, ağırlık çürümesini uyarlamalı gradyan güncellemesinden ayırır ve transformer modellerde yaygın olarak kullanılır.
Uyarlamalı optimizatörler genellikle erken eğitimi kolaylaştırır, ancak her model ya da nihai genelleme hedefi için otomatik olarak üstün değildir. Optimizatör karşılaştırmaları eşleşen takvimler ve dikkatli ayarlamalar gerektirir.
Gradyan kırpma ve birikim
Gradyan kırpma, özellikle yinelemeli ya da kararsız eğitimde patlayan gradyanların etkisini azaltmak için bir gradyanın normunu veya değerlerini sınırlamaya yarar. Gradyan birikimi, bir güncellemeden önce birkaç daha küçük batch’teki gradyanları toplar ve bellek sınırlı olduğunda daha büyük bir etkili batch’i taklit eder.
Optimizasyonu izleme
Eğitim ve doğrulama kayıplarını, görev metriklerini, öğrenme oranını, gradyan normlarını, parametre normlarını ve sayısal hataları izleyin. Eğitim kaybının düşmesi ancak doğrulama performansının kötüleşmesi, otomatik olarak devam edilmesi gereken bir optimizasyon başarısı değil, aşırı öğrenmeyi (overfitting) gösterir.
Optimizasyon, verilen hedefi minimize eder. Düşük bir kayıp, verinin, metriğin ya da gerçek‑dünya davranışının uygun olduğunu kanıtlamaz. Veri sızıntısı, hatalı etiketler ve uyumsuz bir hedef, iyi optimize edilmiş ancak zararlı bir model üretebilir.
Optimizasyon geometrisi ve güncelleme kuralları
Gradient descent, parametreleri kaybın gradyanının ters yönünde günceller. Tam batch inişi, her adımda tüm eğitim örneklerini kullanır; stochastic iniş bir örnek kullanır; mini-batch yöntemleri gradyanı bir alt kümeden tahmin eder ve derin öğrenmede baskındır. Öğrenme oranı adım ölçeğini belirler. Çok küçük değerler hesaplamayı boşa harcar ya da takılır; çok büyük değerler salınım yapar ya da sapar. Momentum, hareketli bir yön biriktirirken, Adam gibi uyarlamalı yöntemler gradyan anlarını kullanarak koordinatları ölçeklendirir. Farklı örtük önyargıları, benzer eğitim kaybına sahip ancak farklı genelleme özellikli modeller üretebilir.
Sinir ağlarındaki kayıp yüzeyleri düz ve keskin bölgeler, eyerler, simetriler ve kötü koşullandırılmış yönler içerir. Özellik ölçeklendirme, normalizasyon, başlatma, residual bağlantılar ve ön koşullama, optimizatörün gördüğü geometriyi değiştirir. Takvimler ısınabilir, azalabilir, döngü yapabilir veya plato durumlarına yanıt verebilir. Ağırlık çürümesi, bazı uyarlamalı optimizatörlerde sadece L2 cezası eklemekten farklıdır. Batch boyutu, gürültü, bellek, paralellik ve öğrenme‑oranı rejimini etkiler; bu yüzden optimizatör karşılaştırmaları eşleşen eğitim bütçeleri ve dikkatli ayarlamalar gerektirir.
Tanı, yeniden üretilebilirlik ve durdurma
Eğitim ve doğrulama kayıplarını, görev metriklerini, gradyan ve parametre normlarını, öğrenme oranını, işleme hızını ve sayısal uyarıları izleyin. Sapma, bozuk batch’lerden, geçersiz etiketlerden, kararsız karışık hassasiyetten ya da hatalı bir kayıp azaltımından kaynaklanabilir. Plato durumları kapasite yetersizliğini, doymuş aktivasyonları, kötü özellikleri, aşırı düzenlemeyi ya da takvim sorununu gösterebilir. Aşırı öğrenme, veri, artırma, düzenleme ya da erken durdurma gerektirir—optimizatörün başarısız olduğu iddiası değil. Temsilci hataları inceleyin ve eğitim karmaşıklığını artırmadan önce basit bir temel modeli karşılaştırın.
Yeniden üretilebilirlik, tohumlar, veri sırası, kod, yapılandırma, donanım ve kütüphane sürümlerini gerektirir; ancak bazı hızlandırıcı çekirdekleri deterministik değildir. Eğitim tutarlı bir şekilde devam edebilsin diye optimizatör ve takvim durumunu içeren kontrol noktalarını kaydedin. Önceden belirlenmiş doğrulama kriterlerine göre bir kontrol noktası seçin ve dokunulmamış bir test seti ayırın. Dağıtık eğitimde, etkili batch boyutunu, gradyan ortalamasını ve başarısız çalışanların yönetimini doğrulayın. Optimizasyon, mevcut veride seçilen hedefi minimize eder; kalibre edilmiş olasılıkları, nedensel akıl yürütmeyi, adaleti, güvenliği ya da gerçek‑dünya faydasını garanti etmez.
Uygulamalı örnek: bir dil modeli için optimizatör ayarlama
Bir ekip, tokenleştiriciyi, veri sırasını, modeli, etkili batch’i ve eğitim‑token bütçesini sabitleyip ardından SGD’yi momentum ve AdamW ile savunulabilir öğrenme‑oranı takvimleri üzerinden karşılaştırır. Isınma, azalma, ağırlık çürümesi, kırpma ve hassasiyet kaydedilir. Her aday birkaç tohumla çalıştırılır ve doğrulama, ayrılmış bir zaman dilimi ve görev değerlendirmeleriyle yapılır. İşleme hızı ve enerji, kayıpla birlikte raporlanır, böylece biraz daha iyi bir optimizatör orantısız maliyetle seçilmez.
Tanılamalar, istikrarsızlığın bir veri diliminden, aşırı adım büyüklüğünden, alt akımdan ya da model mimarisinden kaynaklanıp kaynaklanmadığını ortaya koyar. Kontrol noktaları optimizatör ve takvim durumunu korur ve bir testte devam ettirilir. Son seçim, en düşük eğitim kaybına göre değil, doğrulama kalitesi ve dayanıklılığına dayanır. Seçimden sonra bir kez kapalı bir test seti çalıştırılır. Üretim çıkarımı ayrı olarak kalibre edilir ve izlenir, çünkü ön‑eğitimdeki optimizatör başarısı güvenli ya da doğru davranışı garantilemez.
Uygulama kanıtları ve operasyonel hazırlık
Bir üretim kararı, sadece başarılı bir gösterimden daha fazlasını gerektirir. Hedef kullanıcıları, çalışma ortamını, girdileri, çıktıları, bağımlılıkları, sorumluyu ve her önemli hatanın sonucunu tanımlayın. Ayarlamadan önce yeniden üretilebilir bir temel ve sürümlenmiş bir değerlendirme seti oluşturun. Normal durumları, sınır koşullarını, hatalı ya da eksik girdileri, dağılım kaymasını, bağımlılık kesintisini, kötü kullanımı ve hizmet dışı kalma ihtimali yüksek grupları veya ortamları test edin. Görev kalitesini kalibrasyon veya belirsizlik, gecikme, işleme hızı, kaynak maliyeti, erişilebilirlik, gizlilik ve güvenlikle birlikte ölçün. Bağımsız bir inceleyicinin sonucu yeniden üretebilmesi ve kanıtı çekici bir prototipten ayırabilmesi için her dönüşümü ve eşiği kaydedin.
Başlamadan önce, sürüm, istisna, değişiklik, geri alma ve emeklilik için yetki atayın. Aşamalı bir dağıtım kullanın, güvenli bir geri dönüşü koruyun ve kasıtlı olarak eklenen hatalarla izlemeyi doğrulayın. Operasyonel telemetri, gereksiz hassas veri toplamayarak giriş kalitesini, çıkış davranışını, model ya da kural sürümünü, bağımlılık sağlığını, insan müdahalelerini ve onaylanmış sonuçları ortaya koymalıdır. Uyarı eşiklerini ve bir yanıt sorumlusunu tanımlayın, ardından çevrim dışı performansın devam edeceğini varsaymak yerine dağıtımdan sonra gerçek‑dünya kanıtlarını gözden geçirin. Veri kaynakları, kullanıcılar, modeller, satıcılar, politikalar, donanım veya hedefler değiştiğinde yeniden değerlendirin. Sürekli bir sistem, belgelenmiş bir kurtarma, olay öğrenimi, silme ve saklama prosedürleri ve devre dışı bırakılması ya da değiştirilmesi gereken net bir noktaya da ihtiyaç duyar.
Sıkça Sorulan Sorular
Gradient descent her zaman küresel minimuma ulaşır mı?
Hayır. Konveks hedefler için uygun koşullar güçlü garantiler sağlar. Derin ağ hedefleri konveks değildir ve pratik optimizatörler genellikle benzersiz küresel minimumu bulduklarını kanıtlamaktan ziyade faydalı bir çözüm ararlar.
Sıfır gradyan neden yanıltıcı olabilir?
Sıfır ya da çok küçük bir gradyan, bir minimum, maksimum, eyer noktası, doyma ya da düz bir platoyu gösterebilir. Eğitim tanılamaları kayıp geçmişini, eğriliği, parametre ölçeğini ve doğrulama performansını göz önünde bulundurmalıdır.
Ana referanslar