

Yapay zeka modelleri ve platformları
SEER: Öz Gözetimli Bilgisayarlı Görme Modellerinde Çığır Açan Bir Gelişme mi?

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Son on yılda yapay zekâ (AI) ve makine öğrenmesi (ML) büyük ilerleme kaydetti. Günümüzde her zamankinden daha doğru, verimli ve yetenekliler. Modern AI ve ML modelleri, görüntü veya video dosyalarındaki nesneleri sorunsuz ve doğru biçimde tanıyabiliyor. Ayrıca insan zekâsını andıran metin ve konuşmalar üretebiliyorlar.
Günümüzün AI ve ML modelleri, bir metin parçasının nasıl yorumlanacağını, görüntü veya video karesindeki nesnelerin nasıl tanınacağını ve başka birçok görevin nasıl yapılacağını öğreten etiketli veri kümeleriyle eğitime büyük ölçüde bağımlıdır.
Yeteneklerine rağmen AI ve ML modelleri kusursuz değildir. Bilim insanları, kendilerine verilen bilgilerden öğrenebilen ve mutlaka etiketlenmiş ya da açıklamalar eklenmiş verilere dayanmayan modeller geliştirmeye çalışıyor. Bu yaklaşım, öz gözetimli öğrenmeolarak bilinir ve günümüzün AI modellerinin kapasitesini aşan sorunları çözmek için gereklisağduyuyaveya arka plan bilgisine sahip ML ve AI modelleri geliştirmenin en etkili yollarından biridir.
Öz gözetimli öğrenme, çok büyük miktarda veriyle çalışabilen büyük modellerin eğitilmesini sağlayarak doğal dil işlemede şimdiden sonuç verdi ve şu alanlarda çeşitli atılımlara yol açtı: doğal dil çıkarımı, makine çevirisi ve soru yanıtlama.
Facebook (META ) AI tarafından geliştirilen SEER modeli, bilgisayarlı görmede öz gözetimli öğrenmenin kapasitesini en üst düzeye çıkarmayı amaçlıyor. SEER, yani SElf SupERvised, bir milyardan fazla parametreye sahip, öz gözetimli bir bilgisayarlı görme öğrenme modelidir. İnternette bulunan, uygun açıklamaları veya etiketleri olmayan rastgele bir görüntü grubundan bile örüntüler bulabilir ve öğrenebilir.
Bilgisayarlı Görmede Öz Gözetimli Öğrenmeye Duyulan İhtiyaç
Veri açıklama veya veri etiketleme, makine öğrenmesi ve yapay zekâ modellerinin geliştirilmesinde bir ön işleme aşamasıdır. Bu süreçte görüntüler ya da video kareleri gibi ham veriler belirlenir ve modelin verinin bağlamını anlaması için etiketler eklenir. Bu etiketler modelin veriler üzerinde doğru tahminlerde bulunmasını sağlar.
Bilgisayarlı görme modelleri üzerinde çalışan geliştiricilerin karşılaştığı en büyük engellerden biri, yüksek kaliteli, açıklamalar eklenmiş veriler bulmaktır. Bilgisayarlı görme modelleri bugün görüntülerdeki nesneleri tanımalarını sağlayan örüntüleri öğrenmek için bu etiketli veya açıklamalar eklenmiş veri kümelerine dayanır.
Verilerin açıklanması ve bilgisayarlı görme modellerinde kullanılması şu zorlukları doğurur:
Veri Kümesi Kalitesinin Tutarlı Biçimde Korunması
Geliştiricilerin önündeki en büyük engel, yüksek kaliteli veri kümelerine sürekli erişebilmek olabilir. Uygun etiketlere ve net görüntülere sahip kaliteli veri kümeleri, daha iyi öğrenme ve daha doğru modeller sağlar. Ancak bu verilere sürekli erişmenin kendine özgü zorlukları vardır.
İş Gücü Yönetimi
Veri etiketleme çoğu zaman iş gücü yönetimi sorunları yaratır. Büyük miktardaki yapılandırılmamış ve etiketsiz veriyi kaliteyi koruyarak işlemek ve etiketlemek için çok sayıda çalışan gerekir. Bu nedenle geliştiricilerin veri etiketlemede kalite ile nicelik arasında denge kurması önemlidir.
Mali Kısıtlar
En büyük engellerden biri de veri etiketleme sürecinin beraberinde getirdiği mali kısıtlardır. Veri etiketleme maliyeti çoğu zaman toplam proje maliyetinin önemli bir bölümünü oluşturur.
Görüldüğü gibi veri açıklama, özellikle çok miktarda eğitim verisiyle çalışan karmaşık modeller söz konusu olduğunda, gelişmiş bilgisayarlı görme modelleri geliştirmede önemli bir engeldir. Bilgisayarlı görme alanının, mevcut modellerin kapsamını aşan görevleri yerine getirebilecek karmaşık ve gelişmiş modeller üretmek için öz gözetimli öğrenmeye ihtiyaç duymasının nedeni budur.
Bununla birlikte, kontrollü ortamlarda ve özellikle ImageNet veri kümesinde iyi performans gösteren birçok öz gözetimli öğrenme modeli zaten vardır. Bu modeller iyi sonuçlar verebilse de bilgisayarlı görmede öz gözetimli öğrenmenin temel koşulunu karşılamazlar: yalnızca iyi tanımlanmış bir veri kümesinden değil, sınırlandırılmamış herhangi bir veri kümesinden veya rastgele görüntüden öğrenmek. İdeal biçimde uygulandığında öz gözetimli öğrenme, daha doğru ve yetenekli olmanın yanı sıra ekonomik ve uygulanabilir bilgisayarlı görme modelleri geliştirmeye yardımcı olabilir.
SEER veya SElf-supERvised Modeline Giriş
AI ve ML alanındaki son eğilimler, yarı gözetimli, zayıf gözetimli ve öz gözetimli öğrenme gibi ön eğitim yaklaşımlarının çoğu derin öğrenme modelinin sonraki görevlerdeki performansını önemli ölçüde artırabildiğini gösteriyor.
Bu derin öğrenme modellerindeki performans artışına büyük katkıda bulunan iki temel etken vardır.
Çok Büyük Veri Kümeleriyle Ön Eğitim
Çok büyük veri kümeleriyle ön eğitim, modeli çok çeşitli verilere maruz bıraktığı için genellikle doğruluğu ve performansı artırır. Büyük veri kümeleri modellerin verilerdeki örüntüleri daha iyi anlamasını ve sonuçta gerçek yaşam senaryolarında daha iyi performans göstermesini sağlar.
GPT-3 ve Wav2vec 2.0 gibi en iyi performans gösteren modellerden bazıları çok büyük veri kümeleriyle eğitilir. GPT-3 dil modelinin ön eğitim veri kümesi 300 milyardan fazla sözcük içerirken, konuşma tanıma için kullanılan Wav2vec 2.0 modelinin veri kümesi 53 bin saatten fazla ses verisiiçerir.
Çok Yüksek Kapasiteli Modeller
Daha fazla parametreye sahip modeller çoğu zaman doğru sonuçlar verir. Parametre sayısının yüksek olması, modelin verilerdeki parazit veya gürültü yerine yalnızca gerekli nesnelere odaklanmasını sağlar.
Geliştiriciler daha önce öz gözetimli öğrenme modellerini etiketsiz veya özenle seçilmemiş verilerle eğitmeyi denedi; ancak bu denemelerde yalnızca birkaç milyon görüntü içeren daha küçük veri kümeleri kullanıldı. Peki öz gözetimli öğrenme modelleri, büyük miktarda etiketsiz ve seçilmemiş veriyle eğitildiklerinde yüksek doğruluk sağlayabilir mi? SEER modelinin yanıtlamayı amaçladığı soru tam olarak budur.
SEER modeli, özenle seçilmiş veya etiketlenmiş veri kümelerinden bağımsız olarak internetteki görüntüleri işlemeyi amaçlayan bir derin öğrenme çerçevesidir. SEER çerçevesi, geliştiricilerin büyük ve karmaşık ML modellerini rastgele veriler üzerinde gözetim olmadan eğitmesine olanak tanır. Başka bir deyişle model, ek bir elle müdahale olmadan verileri analiz eder ve örüntüleri veya bilgileri kendisi öğrenir.
SEER modelinin nihai amacı, seçilmemiş verileri kullanarak aktarım öğrenmesinde en ileri düzeyde performans sağlayan ön eğitim stratejilerinin geliştirilmesine yardımcı olmaktır. Ayrıca SEER modeli, hiç bitmeyen bir veri akışından öz gözetimli biçimde sürekli öğrenebilen sistemler oluşturmayı da amaçlar.
SEER çerçevesi, internetten alınan milyarlarca rastgele ve kısıtlanmamış görüntü üzerinde yüksek kapasiteli modeller eğitir. Bu modeller eğitim veya veri filtreleme için görüntülerin meta verilerine ya da açıklamalarına dayanmaz. Son dönemde, seçilmemiş veriler üzerinde eğitilen modellerin sonraki görevlerde gözetimli ön eğitimden geçmiş modellere kıyasla daha iyi sonuçlar vermesi, öz gözetimli öğrenmenin yüksek potansiyelini gösterdi.
SEER Çerçevesi ve RegNet: Aralarındaki Bağlantı Nedir?
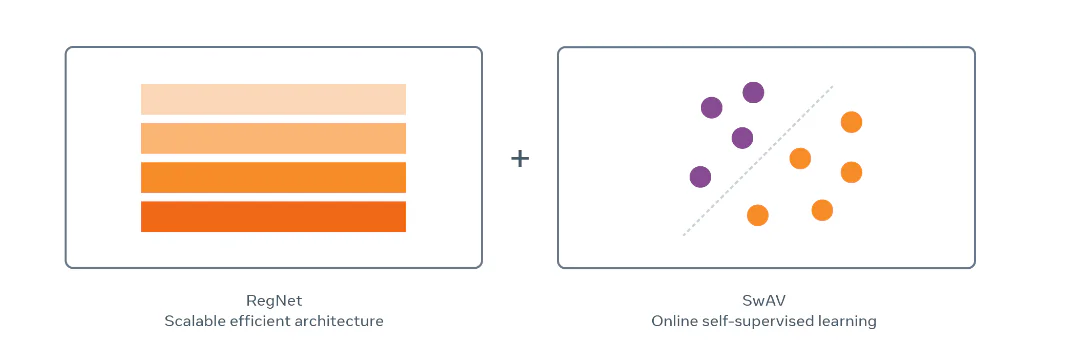
SEER modelini incelerken, 700 milyondan fazla parametreye sahip RegNet mimarisine odaklanılır. Bu mimari iki temel nedenle SEER’in seçilmemiş veriler üzerinde öz gözetimli öğrenme hedefiyle uyumludur:
- Performans ile verimlilik arasında çok iyi bir denge sağlar.
- Oldukça esnektir ve farklı parametre sayılarına ölçeklenebilir.

SEER Çerçevesi: Farklı Alanlardaki Önceki Çalışmalar
SEER çerçevesi, öz gözetimli öğrenmeyle seçilmemiş veya etiketsiz veri kümeleri üzerinde büyük model mimarilerini eğitmenin sınırlarını araştırmayı amaçlar ve alandaki önceki çalışmalardan esinlenir.
Görsel Özelliklerin Gözetimsiz Ön Eğitimi
Öz gözetimli öğrenme, bilgisayarlı görmede bir süredir şu yöntemlerle uygulanmaktadır: otomatik kodlayıcılar, örnek düzeyinde ayrım veya kümeleme. Son dönemde karşıtsal öğrenme yöntemleri, sonraki görevler için gözetimsiz ön eğitimin gözetimli öğrenme yaklaşımından daha iyi performans gösterebildiğini ortaya koydu.
Görsel özelliklerin gözetimsiz öğrenilmesinden çıkan başlıca sonuç şudur: filtrelenmiş verilerle eğitim yapıldığı sürece gözetimli etiketler gerekli değildir. SEER modeli, büyük model mimarileri çok miktarda seçilmemiş, etiketsiz ve rastgele görüntü üzerinde eğitildiğinde doğru temsiller öğrenilip öğrenilemeyeceğini araştırır.
Görsel Özellikleri Büyük Ölçekte Öğrenmek
Önceki modeller, milyonlarca filtrelenmiş görüntü üzerinde zayıf gözetimli, gözetimli ve yarı gözetimli öğrenmeyle büyük etiketli veri kümelerinden ön eğitim almanın faydasını gördü. Model analizleri ayrıca, milyarlarca görüntü üzerinde ön eğitimin modeli sıfırdan eğitmeye kıyasla genellikle daha yüksek doğruluk sağladığını gösterdi.
Büyük ölçekli eğitim, görüntüleri hedef kavramlarla eşleştirmek için genellikle veri filtreleme adımlarına dayanır. Bu adımlarda ya önceden eğitilmiş bir sınıflandırıcının tahminleri ya da çoğu zaman ImageNet sınıflarının eş anlamlı kümelerine karşılık gelen etiketler kullanılır. SEER modeli ise herhangi bir rastgele görüntüdeki özellikleri öğrenmeyi amaçladığından farklı çalışır; eğitim verileri, önceden tanımlanmış özellik veya kavram kümelerine uyacak şekilde seçilmez.
Görüntü Tanıma Mimarilerini Ölçeklendirmek
Modeller genellikle daha kaliteli görsel özellikler üzerinde büyük mimariler eğitmekten yararlanır. Büyük bir veri kümesinde ön eğitim gerektiğinde büyük mimariler eğitmek önemlidir; çünkü kapasitesi sınırlı bir model çoğu zaman veriye yetersiz uyum gösterir. Ön eğitim karşıtsal öğrenmeyle birlikte yapıldığında bu daha da önem kazanır. Bu durumda model, daha iyi görsel temsiller öğrenebilmek için veri kümesindeki örnekleri birbirinden ayırmayı öğrenmelidir.
Ancak görüntü tanımada mimariyi ölçeklendirmek, modelin derinliğini ve genişliğini değiştirmekten çok daha fazlasını gerektirir. Yüksek kapasiteli ve verimli ölçeklenen bir model oluşturmak için kapsamlı araştırmaya ihtiyaç vardır. SEER modeli, RegNets model ailesini kullanmanın büyük ölçekli öz gözetimli öğrenmedeki faydalarını gösterir.
SEER: Kullanılan Yöntemler ve Bileşenler
SEER çerçevesi, görsel temsilleri öğrenmesi için modele ön eğitim verirken çeşitli yöntem ve bileşenler kullanır. Başlıcaları şunlardır: RegNet ve SwAV. Bu yöntem ve bileşenleri kısaca inceleyelim.
SwAV ile Öz Gözetimli Ön Eğitim
SEER çerçevesi, çevrimiçi bir öz gözetimli öğrenme yaklaşımı olan SwAV ile ön eğitim alır. SwAV, evrişimli sinir ağlarını açıklamalar olmadan eğitmek için kullanılan çevrimiçi bir kümeleme yöntemidir. SwAV, aynı görüntünün farklı görünümleri arasında tutarlı küme atamaları üreten bir gömme temsilini eğitir. Sistem daha sonra veri artırma dönüşümleri altında değişmeyen kümeleri bularak anlamsal temsiller öğrenir.
Uygulamada SwAV, bir görüntünün farklı görünümlerinin özelliklerini bağımsız küme atamalarından yararlanarak karşılaştırır. Bu atamalar aynı veya benzer özellikleri yakalıyorsa bir görünümün özellikleri kullanılarak başka bir görünümün ataması tahmin edilebilir.
SEER modeli, K kümeden oluşan bir küme topluluğunu ele alır. Her küme, öğrenilebilir d boyutlu bir vektörle ilişkilidir: vk. Bir yığındaki görüntü sayısı B olduğunda, her i görüntüsü iki farklı görünüme dönüştürülür: xi1 ve xi2. Ardından görünümlerin özellikleri bir evrişimli sinir ağıyla çıkarılır ve iki özellik kümesi elde edilir: (f11, …, fB2) ve (f12, …, fB2). Her özellik kümesi daha sonra bir optimal taşıma çözücüsü yardımıyla bağımsız olarak küme prototiplerine atanır.
Optimal taşıma çözücüsü, özelliklerin kümeler arasında dengeli dağıtılmasını sağlar ve bütün temsillerin tek bir prototipe eşlendiği önemsiz çözümleri önlemeye yardımcı olur. Elde edilen atamalar daha sonra iki küme arasında değiştirilir: yi1 küme atamasına sahip xi1 görünümü için atama, fi2 özellik temsiline sahip xi2görünümü kullanılarak tahmin edilmelidir; ters yönde de aynı işlem yapılır.
Ardından prototip ağırlıkları ve evrişimli sinir ağı, tüm örneklerdeki kaybı en aza indirecek şekilde eğitilir. Küme tahmin kaybı l, temelde f ile prototipin nokta çarpımına uygulanan softmax ile küme ataması arasındaki çapraz entropidir.

RegNetY: Verimli Ölçeklenen Model Ailesi
Model kapasitesini ve verileri ölçeklendirmek, yalnızca bellek açısından değil çalışma süresi açısından da verimli mimariler gerektirir. RegNets, özellikle bu amaç için tasarlanmış bir model ailesidir.
RegNet mimari ailesi, dört aşamalı evrişimli sinir ağlarının oluşturduğu bir tasarım uzayıyla tanımlanır. Her aşama, yapısı sabit tutulan bir dizi özdeş blok içerir; başlıca yapı artık bağlantılı darboğaz bloğudur.
SEER çerçevesi RegNetY mimarisine odaklanır ve performansı artırmak için standart RegNets mimarisine Squeeze-and-Excitation bileşeni ekler. RegNetY modelinde, makul kaynak tüketimiyle sabit FLOP sayısına sahip iyi örneklerin aranmasına yardımcı olan beş parametre bulunur. SEER, RegNetY mimarisini doğrudan öz gözetimli ön eğitim görevinde kullanarak sonuçlarını iyileştirmeyi amaçlar.
RegNetY 256GF Mimarisi: SEER modeli, RegNetY ailesinde ağırlıklı olarak RegNetY 256GF mimarisine odaklanır ve parametreleri RegNets mimarisinin ölçekleme kuralını kullanır. Parametreler aşağıdaki gibidir.

RegNetY 256GF mimarisinin aşama genişlikleri (528, 1056, 2904, 7392), aşama derinlikleri ise (2, 7, 17, 1) olan dört aşaması vardır ve bunlar toplamda 696 milyondan fazla parametre oluşturur. 512 adet NVIDIA V100 32 GB GPU üzerinde, 8.704 görüntülük yığın boyutuyla eğitimde her yineleme yaklaşık 6.125 ms sürer. Bir milyardan fazla görüntü içeren veri kümesinde, 8.704 görüntülük yığınlarla ve 512’den fazla GPU üzerinde eğitim 114.890 yineleme gerektirir ve yaklaşık sekiz gün sürer.
Büyük Ölçekte Optimizasyon ve Eğitim
SEER modeli, öz gözetimli yöntemleri büyük ölçeğe uygulamak ve uyarlamak için çeşitli eğitim düzenlemeleri önerir:
- Öğrenme hızı çizelgesi.
- GPU başına bellek tüketimini azaltma.
- Eğitim hızını optimize etme.
- Büyük ölçekli ön eğitim verileri.
Bunları kısaca inceleyelim.
Öğrenme Hızı Çizelgesi
SEER modeli iki öğrenme hızı çizelgesinin kullanımını araştırır: kosinüs dalgası öğrenme hızı çizelgesi ve sabit öğrenme hızı çizelgesi.
Kosinüs dalgası öğrenme hızı çizelgesi, güncelleme sayısına uyum sağladığı için farklı modelleri adil biçimde karşılaştırmada kullanılır. Ancak büyük ölçekli eğitime uyum sağlamaz; çünkü görüntülere eğitim sırasında ne zaman görüldüklerine göre farklı ağırlıklar verir ve çizelgeyi oluştururken tüm güncellemeleri kullanır.
Sabit öğrenme hızı çizelgesi, kayıp artık azalmayana kadar öğrenme hızını sabit tutar; ardından hızı ikiye böler. Analiz, eğitime daha fazla esneklik tanıdığı için sabit öğrenme hızı çizelgesinin daha iyi çalıştığını gösterir. Ancak model yalnızca bir milyar görüntü üzerinde eğitildiğinden en büyük modeli olan RegNet 256GFiçin kosinüs dalgası öğrenme hızı kullanılır.
GPU Başına Bellek Tüketimini Azaltma
Model, karma hassasiyet ve gradyan kontrol noktaları kullanarak eğitim sırasında gerekli GPU belleğini azaltmayı da amaçlar. Evrişim ve GEMM gibi işlemleri 16 bit kayan nokta hassasiyetinde gerçekleştirmek için NVIDIA Apex kütüphanesinin O1 optimizasyon düzeyini kullanır. Ayrıca hesaplama karşılığında bellek tasarrufu sağlayan PyTorch gradyan kontrol noktası uygulamasından yararlanır.
Model, ileri geçiş sırasında oluşan ara aktivasyonları da atar ve geri geçişte bu aktivasyonları yeniden hesaplar.
Eğitim Hızını Optimize Etme
Bellek kullanımını optimize etmek için karma hassasiyetten yararlanmanın ek faydaları da vardır. Hızlandırıcılar, FP16’nın daha küçük boyutundan yararlanarak FP32’ye göre işlem hacmini artırır. Bellek bant genişliği darboğazının hafiflemesi eğitimi hızlandırır.
SEER modeli ayrıca BatchNorm katmanını GPU’lar arasında eşzamanlayarak işlem grupları oluşturur; genellikle daha fazla zaman alan küresel eşzamanlama yerine bu yaklaşımı kullanır. Son olarak SEER’in veri yükleyicisi daha fazla eğitim yığınını önceden getirerek PyTorch’un veri yükleyicisine kıyasla daha yüksek veri aktarımı sağlar.
Büyük Ölçekli Ön Eğitim Verileri
SEER modeli ön eğitimde bir milyardan fazla görüntü kullanır. Veri yükleyicisi rastgele görüntüleri doğrudan internetten ve Instagram’dan örnekler. Model bu görüntüler üzerinde gerçek ortamda ve çevrimiçi olarak eğitildiğinden görüntülere ön işleme uygulamaz; yinelenenleri kaldırma veya etiketlere göre filtreleme gibi süreçlerle onları seçmez.
Veri kümesi sabit değildir; görüntüler üç ayda bir yenilenir. Ancak veri kümesinin yenilenmesi modelin performansını etkilemez.
SEER Modelinin Uygulanması
SEER modeli, her görüntü için 2×224 + 4×96 çözünürlük düzeninde altı kırpma kullanarak RegNetY 256GF’ye SwAV ile ön eğitim verir. Ön eğitim aşamasında, projeksiyon başlıklarının boyutları 10444×8192, 8192×8192 ve 8192×256 olan üç katmanlı bir MLP, yani çok katmanlı algılayıcı kullanılır.
SEER modeli, başlıkta BatchNorm katmanları kullanmak yerine 16 bin prototip kullanır ve sıcaklık parametresi t 0,1 olarak ayarlanır. Sinkhorn düzenlileştirme parametresi 0,05’tir ve algoritma 10 yineleme gerçekleştirir. Model ayrıca BatchNorm istatistiklerini GPU’lar arasında eşzamanlar ve bu amaçla 64 büyüklüğünde çok sayıda işlem grubu oluşturur.
Model ayrıca LARS, yani Katman Bazlı Uyarlamalı Hız Ölçekleme optimizasyon yöntemini, 10-5ağırlık azalmasını, aktivasyon kontrol noktalarını ve O1 karma hassasiyet optimizasyonunu kullanır. Ardından 512 NVIDIA GPU’ya dağıtılan 8.192 rastgele görüntülük yığınlarla, GPU başına 16 görüntü olacak şekilde stokastik gradyan inişiyle eğitilir.
İlk sekiz bin eğitim güncellemesinde öğrenme hızı 0,15’ten 9,6’ya doğrusal olarak yükseltilir. Isınma aşamasından sonra model, 0,0096 son değerine kadar azalan bir kosinüs öğrenme hızı çizelgesini izler. SEER toplamda 122 bin yineleme boyunca bir milyardan fazla görüntü üzerinde eğitilir.
SEER Çerçevesi: Sonuçlar
Öz gözetimli ön eğitim yaklaşımının ürettiği özelliklerin kalitesi, çeşitli kıyaslama veri kümelerinde ve sonraki görevlerde incelenir. Model ayrıca sonraki görevler için görüntülere ve etiketlerine sınırlı erişim sağlayan az örnekli bir düzeni de ele alır.
Önceden Eğitilmiş Büyük Modellere İnce Ayar
Rastgele veriler üzerinde önceden eğitilmiş modellerin kalitesi, nesne sınıflandırması için ImageNet kıyaslamasına aktarılmalarıyla ölçülür. Büyük ön eğitimli modellerin ince ayar sonuçları aşağıdaki parametrelerle belirlenir.
Deney Düzeni
Model, farklı kapasitelere sahip altı RegNet mimarisine ön eğitim verir: RegNetY-{8,16,32,64,128,256}GF. SwAV ile bir milyardan fazla rastgele ve herkese açık Instagram görüntüsü kullanılır. Ardından modellere ImageNet üzerinde görüntü sınıflandırması için ince ayar yapılır. ImageNet, uygun etiketlere sahip 1,28 milyondan fazla standart eğitim görüntüsü ve değerlendirme için 50 binden fazla görüntülük standart doğrulama kümesi içerir.
Model daha sonra SwAV’dekiyle aynı veri artırma tekniklerini uygular. SGD, yani stokastik gradyan inişi optimizasyonuyla 35 dönem ince ayar yapılır. Yığın boyutu 256, öğrenme hızı 0,0125’tir ve 30 dönemden sonra 10’a bölünür. Momentum 0,9, ağırlık azalması ise 10-4olarak belirlenir. Model, doğrulama veri kümesinde 224×224 merkez kırpması kullanarak ilk-1 doğruluğunu raporlar.
Diğer Öz Gözetimli Ön Eğitim Yaklaşımlarıyla Karşılaştırma
Aşağıdaki tabloda en büyük ön eğitimli model olan RegNetY-256GF, öz gözetimli öğrenme kullanan mevcut ön eğitimli modellerle karşılaştırılır.

Görüldüğü gibi SEER, ImageNet’te %84,2 ilk-1 doğruluğu elde eder ve mevcut en iyi ön eğitimli model olan SimCLRv2’yi %1 aşar.
Aşağıdaki şekil ayrıca SEER çerçevesini farklı kapasitelere sahip modellerle karşılaştırır. Model kapasitesinden bağımsız olarak RegNet ile SwAV’nin birleştirilmesi, ön eğitimde doğru sonuçlar sağlar.

SEER modeli seçilmemiş ve rastgele görüntüler üzerinde ön eğitim alır; SwAV öz gözetimli öğrenme yöntemiyle RegNet mimarisini kullanır. SEER, farklı ağ mimarilerine sahip SimCLRv2 ve ViT modelleriyle karşılaştırılır. Son olarak modele ImageNet veri kümesinde ince ayar yapılır ve ilk-1 doğruluğu raporlanır.
Model Kapasitesinin Etkisi
Model kapasitesi, ön eğitim performansını önemli ölçüde etkiler. Aşağıdaki şekil bunu sıfırdan eğitimdeki etkisiyle karşılaştırır.

Ön eğitimli modellerin ilk-1 doğruluğunun sıfırdan eğitilen modellerden daha yüksek olduğu ve parametre sayısı arttıkça aradaki farkın büyüdüğü açıkça görülür. Kapasite artışı her iki model türüne de fayda sağlasa da çok sayıda parametre söz konusu olduğunda etkisi ön eğitimli modellerde daha büyüktür.
ImageNet veri kümesinde sıfırdan eğitilen bir modelin aşırı uyum göstermesinin olası nedeni veri kümesinin küçük olmasıdır.
Az Örnekli Öğrenme
Az örnekli öğrenme, SEER modelinin sonraki görevlerde toplam verinin yalnızca bir bölümünü kullanan bir düzende değerlendirilmesini ifade eder.
Deney Düzeni
SEER çerçevesi, az örnekli öğrenmede iki veri kümesi kullanır: Places205 ve ImageNet. Aktarım öğrenmesi sırasında hem görüntülere hem de etiketlerine sınırlı erişim olduğu varsayılır. Bu düzen, modelin tüm veri kümesine eriştiği ve yalnızca görüntü etiketlerine erişimin sınırlandığı standart öz gözetimli öğrenme düzeninden farklıdır.
-
Place205 Veri Kümesindeki Sonuçlar
Aşağıdaki şekil, modelin Place205 veri kümesinin farklı bölümleriyle ön eğitim almasının etkisini gösterir.

Bu yaklaşım, aynı RegNetY-128GF mimarisinin ImageNet üzerinde gözetimli ön eğitimiyle karşılaştırılır. Sonuçlar dikkat çekicidir: Places205’te ince ayar için kullanılabilen eğitim verisinin oranından bağımsız olarak ilk-1 doğruluğunda yaklaşık %2,5’lik istikrarlı bir artış görülür.
Gözetimli ve öz gözetimli ön eğitim süreçleri arasındaki fark, eğitim verilerinin yapısıyla açıklanabilir. Gerçek ortamdan alınan rastgele görüntülerden öğrenilen özellikler, sahne sınıflandırmasına daha uygun olabilir. Ayrıca temel kavramların eşit dağılmaması, Places205 gibi dengesiz bir veri kümesinde ön eğitim için avantaj sağlayabilir.
ImageNet Sonuçları

Yukarıdaki tablo, SEER yaklaşımını az örnekli öğrenmede öz gözetimli ön eğitim ve yarı gözetimli yaklaşımlarla karşılaştırır. Bu yöntemlerin tümü, ön eğitimde ImageNet’teki 1,2 milyon görüntünün tamamını kullanır ve yalnızca etiketlere erişimi sınırlar. SEER yaklaşımı ise veri kümesindeki görüntülerin yalnızca %1 ila %10’unu görür.
Ağların ön eğitimde aynı dağılımdan daha fazla görüntü görmesi, bu yaklaşımlara büyük fayda sağlar. Buna rağmen SEER’in ImageNet’in yalnızca %1 ila %10’unu görerek yaklaşık %80 ilk-1 doğruluğuna ulaşması etkileyicidir; bu değer, tabloda ele alınan yaklaşımların doğruluğunun yalnızca biraz altındadır.
Model Kapasitesinin Etkisi
Aşağıdaki şekil, ImageNet veri kümesinin %1, %10 ve %100’ü kullanıldığında model kapasitesinin az örnekli öğrenmeye etkisini ele alır.

Veri kümesindeki hem görüntülere hem etiketlere erişim azaldığında, model kapasitesini artırmanın doğruluğu iyileştirebildiği görülür.
Diğer Kıyaslamalara Aktarım
SEER modelini daha fazla değerlendirmek ve performansını incelemek için ön eğitimli özellikler başka sonraki görevlere aktarılır.
Görüntü Sınıflandırmasının Doğrusal Değerlendirmesi

Yukarıdaki tablo, SEER’in ön eğitimli RegNetY-256GF özelliklerini, aynı mimariyle ImageNet üzerinde gözetimli ve gözetimsiz ön eğitim almış RegNetY128-GF özellikleriyle karşılaştırır. Özelliklerin kalitesini incelemek için model ağırlıkları dondurulur ve sonraki görevlerin eğitim kümesi kullanılarak özelliklerin üzerine doğrusal bir sınıflandırıcı eklenir. Open-Images (OpIm), iNaturalist (iNat), Places205 (Places) ve Pascal VOC (VOC) kıyaslamaları kullanılır.
Tespit ve Bölütleme
Aşağıdaki şekil, ön eğitimli özellikleri tespit ve bölütleme görevleri açısından karşılaştırır ve değerlendirir.

SEER çerçevesi, ön eğitimli RegNetY-64GF ve RegNetY-128GF’yi yapı taşları olarak kullanarak COCO kıyaslamasında bir Mask-RCNN modeli eğitir. Her iki mimaride ve sonraki görevlerde SEER’in öz gözetimli ön eğitim yaklaşımı, gözetimli eğitimi 1,5 ila 2 AP puanıfarkla geçer.
Zayıf Gözetimli Ön Eğitimle Karşılaştırma
İnternetteki görüntülerin çoğu, ön eğitimde yararlanılabilecek meta açıklamalar, alternatif metinler, açıklamalar veya coğrafi konum bilgileri içerir. Önceki çalışmalar, seçilmiş ya da etiketlenmiş bir etiket kümesini tahmin etmenin ortaya çıkan görsel özelliklerin tahmin kalitesini artırabildiğini gösterdi. Ancak bu yaklaşım görüntüleri filtrelemeyi gerektirir ve en iyi sonucu yalnızca metinsel meta veriler bulunduğunda verir.
Aşağıdaki şekil, rastgele görüntüler üzerinde eğitilen ResNetXt101-32dx8d mimarisinin ön eğitimini, aynı mimarinin etiketler ve meta veriler içeren etiketli görüntüler üzerindeki eğitimiyle karşılaştırır ve her ikisinin ilk-1 doğruluğunu raporlar.

SEER çerçevesi ön eğitimde meta veri kullanmasa da doğruluğunun meta veri kullanan modellerle karşılaştırılabilir olduğu görülür.
Bileşen Çıkarma Çalışmaları
Bir bileşenin modelin genel performansına etkisini incelemek için bileşen çıkarma çalışması yapılır. Bileşen modelden tamamen kaldırılır ve modelin nasıl performans gösterdiği incelenir. Böylece geliştiriciler, o bileşenin modelin performansına etkisi hakkında genel bir fikir edinir.
Model Mimarisinin Etkisi
Model mimarisi, özellikle model ölçeklendirildiğinde veya ön eğitim verilerinin özellikleri değiştirildiğinde, performans üzerinde önemli etkiye sahiptir.
Aşağıdaki şekil, ImageNet üzerinde doğrusal değerlendirme yaparak mimari değişikliğinin ön eğitimli özelliklerin kalitesine etkisini gösterir. Bu durumda değerlendirme, ImageNet’te sıfırdan eğitildiğinde yüksek doğruluk sağlayan modele ayrıcalık tanımadığından ön eğitimli özellikler doğrudan incelenebilir.

ResNeXts ve ResNet mimarilerinde sondan bir önceki katmandan elde edilen özelliklerin mevcut ayarlarda daha iyi çalıştığı görülür. RegNet mimarisi ise diğer mimarileri geride bırakır.
Genel olarak model kapasitesini artırmanın özellik kalitesini olumlu etkilediği ve model performansında logaritmik bir kazanç sağladığı sonucuna varılabilir.
Ön Eğitim Verilerini Ölçeklendirmek
Bir modeli daha büyük veri kümesinde eğitmenin, öğrenilen görsel özelliklerin genel kalitesini artırabilmesinin iki temel nedeni vardır: daha fazla benzersiz görüntü ve daha fazla parametre. Bunların model performansına etkisini kısaca inceleyelim.
Benzersiz Görüntü Sayısını Artırmak

Yukarıdaki şekil, aynı sayıda parametreye sahip ancak farklı sayıda benzersiz görüntüyle eğitilen RegNet8 ve RegNet16 mimarilerini karşılaştırır. SEER çerçevesi, modelleri bir milyar görüntü için bir döneme veya 32 benzersiz görüntü için 32 döneme karşılık gelen güncellemelerle ve tek yarım dalga kosinüs öğrenme hızıyla eğitir.
Bir modelin iyi performans göstermesi için ideal olarak modele verilen benzersiz görüntü sayısının yüksek olması gerektiği görülür. Bu durumda model, ImageNet’tekinden daha fazla benzersiz görüntüyle beslendiğinde iyi performans gösterir.
Daha Fazla Parametre
Aşağıdaki şekil, RegNet-128GF mimarisiyle bir milyardan fazla görüntü üzerinde eğitilen modelin performansını gösterir. Parametre sayısı arttıkça performansın düzenli biçimde yükseldiği görülür.

Gerçek Dünyada Öz Gözetimli Bilgisayarlı Görme
Şimdiye kadar öz gözetimli öğrenmenin ve bilgisayarlı görme için SEER modelinin teoride nasıl çalıştığını ele aldık. Şimdi bu yaklaşımın gerçek yaşam senaryolarında nasıl çalıştığına ve SEER’in neden öz gözetimli bilgisayarlı görmenin geleceği olduğuna bakalım.
SEER modeli, ön eğitimde trilyonlarca veri kümesi ve parametreyle birlikte trilyonlarca sözcük kullanan en gelişmiş modellerin bulunduğu doğal dil işleme alanındaki çalışmalara rakip olur. Modeli eğitmek için kullanılan girdi verisinin miktarı arttıkça sonraki görevlerdeki performans genellikle yükselir; aynı durum bilgisayarlı görme görevleri için de geçerlidir.
Ancak doğal dil işlemede öz gözetimli öğrenme kullanmak, bilgisayarlı görmede kullanmaktan farklıdır. Metinlerde anlamsal kavramlar genellikle ayrı sözcüklere bölünürken, görüntülerde modelin hangi pikselin hangi kavrama ait olduğuna karar vermesi gerekir.
Ayrıca farklı görüntüler farklı görünümlere sahiptir. Birden fazla görüntü aynı nesneyi içerse bile kavram önemli ölçüde değişebilir. Örneğin kedi görüntülerinden oluşan bir veri kümesini düşünün. Temel nesne olan kedi tüm görüntülerde ortak olsa da bir görüntüde hareketsiz dururken başka birinde topla oynayabilir. Görüntüler çoğu zaman farklı kavramlar içerdiğinden, modelin aynı kavram çevresindeki farklılıkları anlamak için çok sayıda görüntüyü görmesi gerekir.
Bir modeli yüksek boyutlu ve karmaşık görüntü verileriyle verimli çalışacak şekilde başarıyla ölçeklendirmek için iki bileşen gerekir:
- Çok büyük bir görüntü veri kümesindeki görsel kavramları yakalayıp öğrenebilecek kadar büyük bir evrişimli sinir ağı, yani CNN.
- Hiçbir etiket, açıklama veya meta veri olmadan çok sayıda görüntüdeki örüntüleri öğrenebilen bir algoritma.
SEER modeli bu bileşenleri bilgisayarlı görmeye uygulamayı amaçlar. Benzer görsel kavramlara sahip görüntüleri gruplamak veya eşleştirmek için çevrimiçi kümeleme kullanan öz gözetimli öğrenme çerçevesi SwAV’deki gelişmelerden yararlanır ve bu benzerlikleri örüntüleri daha iyi belirlemek için kullanır.
SwAV mimarisi sayesinde SEER modeli, bilgisayarlı görmede öz gözetimli öğrenmeyi çok daha etkili hale getirebilir ve eğitim süresini altı kata kadar azaltabilir.
Ayrıca bir milyardan fazla görüntü gibi büyük ölçekte eğitim, yalnızca çalışma süresi ve bellek açısından değil doğruluk açısından da verimli bir mimari gerektirir. RegNet modelleri burada devreye girer. Bu evrişimli sinir ağı modelleri trilyonlarca parametreye ölçeklenebilir ve bellek sınırlamalarına ve çalışma süresi gereksinimlerine uyacak şekilde optimize edilebilir.
Sonuç: Öz Gözetimli Bir Gelecek
Öz gözetimli öğrenme bir süredir AI ve ML alanlarında önemli bir tartışma konusu. Çünkü AI modellerinin, yalnızca eğitim amacıyla özenle seçilmiş ve etiketlenmiş veri kümelerine dayanmak yerine internette rastgele bulunan çok miktarda veriden doğrudan bilgi öğrenmesini sağlıyor.
Öz gözetimli öğrenme, geliştiricilerin gerçek yaşam senaryolarına iyi uyum sağlayan ve tek bir amaç yerine birden fazla kullanım alanına sahip AI modelleri oluşturmasına olanak tanıyabileceğinden AI ve ML’nin geleceği için önemli bir kavramdır. SEER, bilgisayarlı görmede bu yaklaşımın uygulanmasında bir dönüm noktasıdır.
SEER modeli, bilgisayarlı görme alanının dönüşümünde ve etiketli veri kümelerine bağımlılığın azaltılmasında ilk adımı atar. Veri kümesini açıklama ihtiyacını ortadan kaldırarak geliştiricilerin çeşitli ve büyük miktarda verilerle çalışmasını amaçlar. SEER’in uygulanması, özellikle tıp gibi görüntü veya meta verinin sınırlı olduğu alanlarda model geliştirenler için yararlıdır.
Ayrıca insan eliyle açıklama ekleme ihtiyacının ortadan kalkması, modellerin daha hızlı geliştirilip kullanıma sunulmasını sağlar. Böylece geliştiriciler hızla değişen durumlara daha çabuk ve daha doğru yanıt verebilir.



