
Röportajlar
Nora Petrova, Makine Öğrenimi Mühendisi ve Prolific’te AI Danışmanı – Röportaj Serisi

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
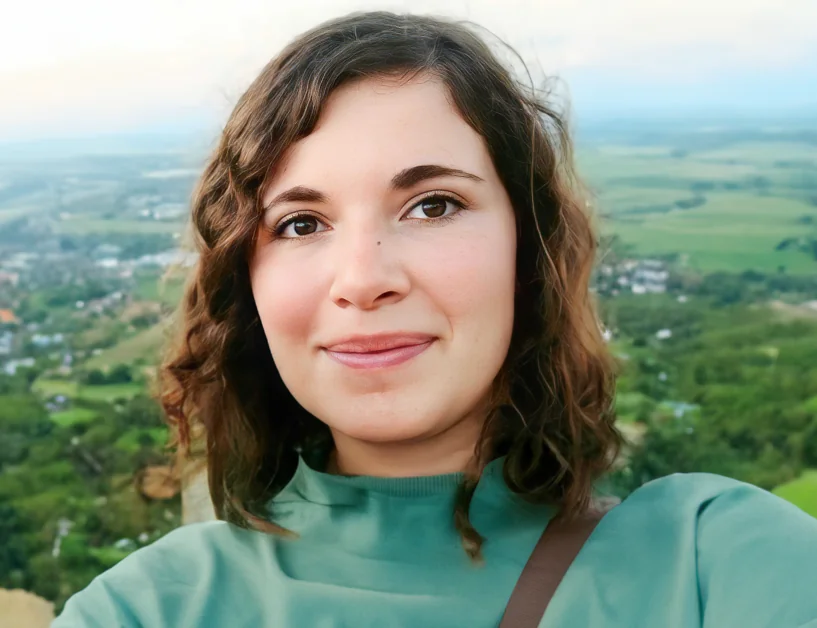
Nora Petrova, Prolific şirketinde Makine Öğrenimi Mühendisi ve AI Danışmanıdır. 2014 yılında kurulan Prolific’in müşterileri arasında Google (GOOGL ), Stanford Üniversitesi, Oxford Üniversitesi, King’s College London ve Avrupa Komisyonu bulunuyor. Bu kuruluşlar katılımcı ağını yeni ürünleri test etmek, göz takibi gibi alanlarda AI sistemlerini eğitmek ve insanlarla etkileşime giren AI uygulamalarının geliştiricilerinin amaçladığı gibi çalışıp çalışmadığını belirlemek için kullanıyor.
Sizden Prolific’teki geçmişiniz ve kariyeriniz hakkında bilgi alabilir miyiz? AI’ye ilgi duymaya nasıl başladınız?
Prolific’teki rolüm, AI kullanım örnekleri ve fırsatları hakkında danışmanlık yapmak ve doğrudan uygulama geliştiren Makine Öğrenimi Mühendisi olarak ikiye ayrılmıştır. Kariyerime Yazılım Mühendisliği olarak başlamış ve giderek Makine Öğrenimi’ne geçiş yapmışım. Son 5 yılın çoğunu NLP kullanım örnekleri ve sorunları üzerinde odaklanmışım.
AI’ye ilk olarak ilgi duymama neden olan, veriden öğrenme yeteneği ve bu yeteneğin insan beyninin yapısı ile bağlantısı oldu. Sanırım Makine Öğrenimi ve Nörobilim birbirini tamamlayabilir ve AI sistemlerinin dünyayı gezmesi, yaratıcılık göstermesi ve topluma değer katması için gerekli olan anlayışımızı geliştirebilir.
Şahsen farkında olduğunuz en büyük AI yanlılığı sorunları nelerdir?
Yanlılık, AI modellerine verdiğimiz verilerin içinde mevcuttur ve tamamen ortadan kaldırmak çok zordur. Ancak, verideki yanlılıkların farkında olmak ve zararlı yanlılıkları önemli görevlerde modele güvenmeden önce azaltmak çok önemlidir. En büyük sorunlar, modellerin zararlı klişeleri sürdürmesi, sistemli önyargıları ve adaletsizlikleri ve AI modellerinin kullanıcıları üzerindeki etkisini ve güvenli olup olmadığını garantilemek için kullanıcılara ve onaylayanlara dikkat etmek gerekmektedir.
Öne çıkan örnekler arasında, okul ve üniversiteye kabulde yeterince temsil edilmeyen gruplara ayrımcılık ve kadınların işe alınmasını olumsuz etkileyen toplumsal cinsiyet kalıpları var. ABD'de bir ceza adaleti algoritmasının Afrikalı Amerikalı sanıkları yanlışlıkla “yüksek riskli” olarak etiketleme oranının, beyaz sanıkları yanlış etiketleme oranının neredeyse iki katı olduğu görüldü. Yüz tanıma teknolojisinde de temsili eğitim verisi eksikliği nedeniyle azınlıklar için hata oranları yüksek kalıyor.
Yukarıdaki örnekler, AI modellerinin sergilediği yanlılıkların küçük bir bölümünü kapsar ve gelecekte daha büyük sorunların ortaya çıkabileceğini öngörüyoruz. AI modellerinin, insan karar vermelerinin etkilediği ve denetimsiz ve bilinçdışı yanlılıkların etkilediği verilerden öğrendiğini unutmamak önemlidir. Birçok durumda, insan karar vericilere başvurmak yanlılığı ortadan kaldırmayabilir. Gerçekten yanlılıkları azaltmak, verilerin içinde nasıl bulunduğunu anlamak, yanlı tahminlere katkıda bulunan faktörleri izole etmek ve önemli kararlar için neye dayanmak istediğimizi topluca karar vermek anlamına gelir. Modelleri hassas kullanım alanlarında devreye almadan önce güvenlik açısından değerlendirebileceğimiz standartlar geliştirmek önemli bir adım olacaktır.
Her türlü yaratıcı AI için büyük bir sorun olan AI sanrıları hakkında, insanın sürece katıldığı (HITL) eğitimin bu sorunları nasıl azaltabileceği hakkında konuşabilir misiniz?
AI modellerindeki sanrılar, özellikle yaratıcı AI kullanım örneklerinde sorunludur, ancak kendi başlarına sorun değildir. Bazı yaratıcı AI kullanım örneklerinde, sanrılar hoş karşılanır ve daha yaratıcı ve ilginç bir yanıt oluşturmaya katkıda bulunur.
Sağlık gibi, karar almada güvenirliğin önemli olduğu alanlarda, sağlık profesyonellerine güvenilir ve gerçek bilgileri sağlamak çok önemlidir.
HITL, modellerin, belirli bir güven seviyesinin altında olan tahminler için doğrudan insan geri bildirimi almasına olanak tanıyan sistemleri ifade eder. Sanrılar bağlamında, HITL, modellerin farklı kullanım örnekleri için hangi güven seviyesine sahip olması gerektiğini öğrenmelerine yardımcı olabilir. Bu eşikler, kullanım örneğine bağlı olarak değişecektir ve modellere, farklı kullanım örnekleri için gereken titizlik farklılıklarını öğretmek, sorunlu sanrıları azaltmak için önemli bir adım olacaktır. Örneğin, bir yasal kullanım örneğinde, insanlar AI modellerine, karmaşık yasal belgelerin birçok koşul ve koşulla ilgili sorulara cevap verirken gerçekleri kontrol etmenin gerekli bir adım olduğunu gösterebilir.
AI çalışanları, özellikle veri anotatörleri, potansiyel yanlılık sorunlarını nasıl azaltabilir?
AI çalışanları, öncelikle verideki yanlılıkları tanımlamaya yardımcı olabilir. Yanlılık tanımlandıktan sonra, azaltma stratejileri geliştirmek daha kolay olur. Veri anotatörleri, yanlılığı azaltmak için yollar önermek için de yardımcı olabilir. Örneğin, NLP görevleri için, sorunlu metin parçalarını, dildeki yanlılığı azaltacak şekilde yeniden ifade etmelerine yardımcı olabilir. Ayrıca, AI çalışanlarındaki çeşitlilik, etiketleme yanlılıklarını azaltmaya yardımcı olabilir.
AI çalışanlarının, AI sistemine kendi insan yanlılıklarını kazara beslemelerini nasıl önleyebilirsiniz?
Bu, dikkatli düşünmeyi gerektiren karmaşık bir sorundur. İnsan yanlılıklarını tamamen ortadan kaldırmak neredeyse imkansızdır ve AI çalışanları, AI modellerine kendi yanlılıklarını kazara besleyebilir, bu nedenle işçilerin en iyi uygulamalara uymalarına rehberlik edecek süreçler geliştirmek çok önemlidir.
İnsan yanlılıklarını en aza indirmek için atılabilecek bazı adımlar şunlardır:
- AI çalışanlarının bilinçdışı yanlılıkları ve bu yanlılıkları tanımlama ve yönetme araçları hakkında kapsamlı eğitim.
- Çalışanların yanıtlarını göndermeden önce doğrulamalarını hatırlatan kontrol listeleri.
- Çalışanların, farklı yanlılıkların örneklerini gösteren bir değerlendirmeye tabi tutulması ve en az yanlı yanıtı seçmeleri.
Dünya çapındaki düzenleyiciler, AI çıktısını düzenlemek istiyorlar. Düzenleyicilerin neyi yanlış anladığına ve neyi doğru yaptığı görüşünüz nedir?
Bu, gerçekten zor bir sorun ve kimse henüz çözümü bulamadı. Toplum ve AI, birbirlerini etkileyerek, çok zor öngörülebilecek şekillerde evrilecekler. Etkili bir düzenleme stratejisinin parçası, AI’de neler olduğu, insanların buna nasıl tepki verdiği ve farklı endüstriler üzerindeki etkileri hakkında dikkat etmek önemlidir.
Düzenleyicilerin AI modellerinin ne yapabileceği ve nasıl çalıştığı hakkında yeterli bilgiye sahip olmaması, etkili AI düzenlemesinin önündeki önemli bir engel olarak görüyorum. Bu, AI modellerinin farklı sektörler ve toplumun farklı kesimleri üzerindeki sonuçlarını doğru bir şekilde öngörmeyi daha da zorlaştırıyor. Bir diğer eksik alan, AI modellerini insan değerleri ile hizalamak ve güvenliğin somut olarak ne anlama geldiği hakkında liderlik göstermektir.
Düzenleyiciler, AI alanındaki uzmanlarla işbirliği yapmış, AI için fazla katı kurallar koymaktan kaçınmış ve AI’nin işgücü yer değiştirmesi üzerindeki etkileri hakkında düşünmeye başlamışlar, bu da çok önemli alanlardır. Düşüncelerimiz AI düzenlemesi hakkında netleştikçe dikkatli ilerlemeli ve bu sorunu demokratik bir şekilde ele almak için mümkün olduğunca çok insanı dahil etmeliyiz.
Prolific çözümleri, girişimlerin AI yanlılığını ve diğer konuları azaltmasına nasıl yardımcı olabilir?
AI projeleri için veri toplama her zaman düşünülmüş veya bilinçli bir süreç olmamıştır. Daha önce veri kazıma, offshore ve diğer yöntemler yaygın olarak kullanılmıştır. Ancak AI’yi nasıl eğittiğimiz çok önemlidir ve bir sonraki nesil modeller, kasıtlı olarak toplanan, yüksek kaliteli verilerden ve gerçek insanlardan inşa edilmelidir. İşte Prolific’in fark yarattığı yer burasıdır.
Diğer alanlar, örneğin anketler, pazar araştırması veya bilimsel araştırma, bu gerçeği çok önce öğrendi. Örnekleminizi aldığınız kitle, sonuçlarınız üzerinde büyük bir etkiye sahiptir. AI, nihayet bu gerçeğe ulaşıyor ve şimdi bir yol ayrımındayız.
Şimdi, daha iyi örnekler kullanmaya ve daha temsilcisi gruplarla çalışmaya başlama zamanı. Her ikisi de güvenli, yanlısız ve hizalı modeller geliştirmek için çok önemlidir.
Prolific, girişimlerin AI deneylerini güvenli bir şekilde gerçekleştirmelerine ve yanlılığı kontrol edilen ve azaltılan katılımcılardan veri toplamasına yardımcı olabilir. En iyi veri toplama ve seçim uygulamaları hakkında rehberlik sağlayabilir ve katılımcıların adil bir şekilde muamele görmesini ve ödenmesini sağlayabiliriz.
AI şeffaflığı hakkında görüşünüz nedir, kullanıcıların AI algoritmalarının hangi verilere dayandığını görmelerine izin verilmeli midir?
Bence şeffaflığın hem artıları hem eksileri var ve henüz iyi bir denge bulunamadı. Şirketler, dava korkusu nedeniyle AI modellerini eğittiği verileri açıklamaktan kaçınıyorlar. Diğerleri, AI modellerini kamuoyuna açıklayarak ve kullandıkları verileri açıkladılar. Tam şeffaflık, bu modellerin zayıflıklarının sömürülmesine olanak tanır. Tam gizlilik, güven oluşturmaya ve toplumu güvenli AI geliştirmeye dahil etmeye yardımcı olmaz. İyi bir orta yol, AI modellerinin iyi kaliteli, ilgili ve rıza verilen verilere dayandığını güvenle anlamamızı sağlayacaktır. AI’nin farklı endüstrileri nasıl etkilediğini ve etkilenen taraflarla diyalogları açarak herkes için çalışacak uygulamalar geliştirmeye dikkat etmeliyiz.
Kullanıcıların, bir modelin belirli bir yanıtı neden ürettiğini anlamak için neyin yeterli olacağını düşünmek de önemlidir. Onlara modelin eğitildiği ham veriyi verirse, bu muhtemelen sorularını cevaplamaya yardımcı olmayacaktır. Bu nedenle, iyi açıklanabilirlik ve yorumlanabilirlik araçları geliştirmek önemlidir.
AI hizalama araştırmaları, AI sistemlerini insanların amaçlarına, tercihlerine veya etik ilkelerine yöneltmeyi hedefliyor. AI çalışanlarının eğitimi ve AI’nin hizalanması hakkında konuşabilir misiniz?
Bu, aktif bir araştırma alanı ve modelleri insan değerleriyle hizalamak için hangi stratejileri kullanmamız gerektiği, hatta hangi değerler kümesini hedeflememiz gerektiği konusunda henüz uzlaşma yoktur.
AI çalışanları genellikle, tercihlerini gerçekten temsil etmeleri ve güvenliği, yanlılıktan kaçınmayı, zararsızlığı ve faydalılığı içeren ilkeleri dikkate alarak sorulara doğru bir şekilde cevap vermeleri istenir.
Hedefler, etik ilkeler veya değerlerle hizalama konusunda umut verici birkaç yaklaşım var. Önemli bir örnek, Meaning Alignment Institute tarafından yürütülen Demokratik İnce Ayar çalışması. Fikri tanıtan çok iyi bir yazı burada bulunabilir.
Harika röportaj için teşekkür ederiz ve AI yanlılığı hakkındaki görüşlerinizi paylaştığınız için teşekkür ederiz. Daha fazla bilgi edinmek isteyen okuyucular Prolific ziyaret edebilir.




