
Yapay zeka modelleri ve platformları
Appen’den Yeni Off-the-Shelf (OTS) Veri Setleri: AI Dağıtımını Hızlandırın

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
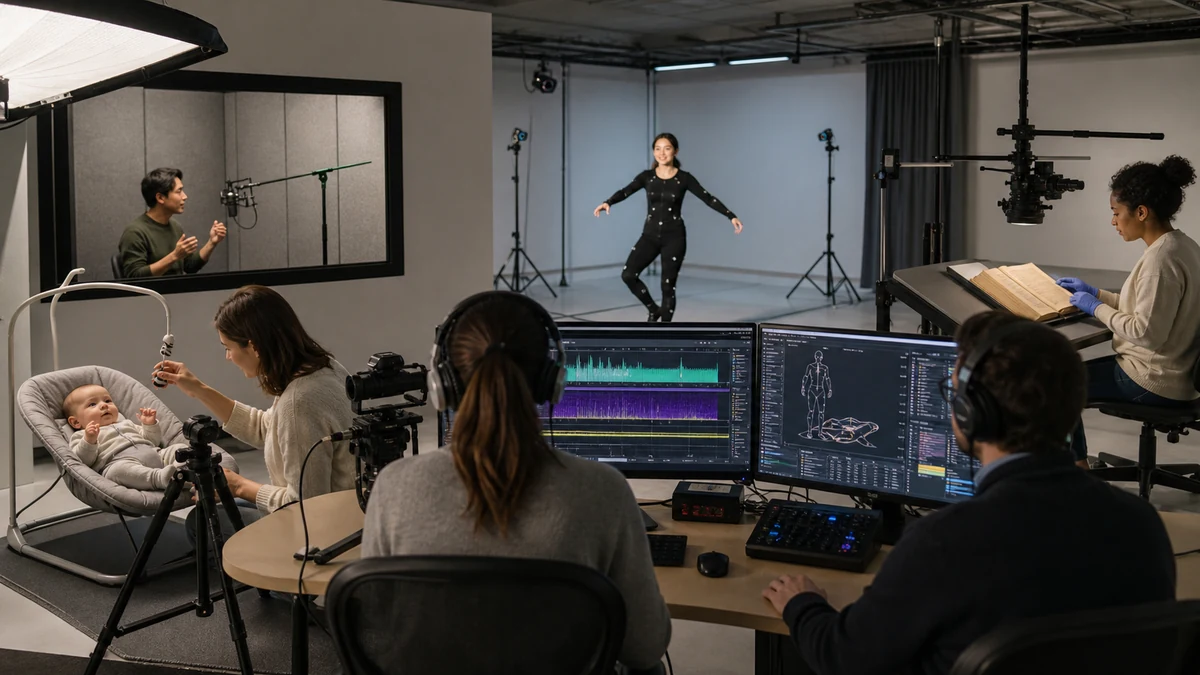
Appen Limited (ASX:APX), büyük ölçekli etkili AI sistemleri oluşturan organizasyonlar için yüksek kaliteli eğitim verisi sağlayan önde gelen sağlayıcı, bugün yeni off-the-shelf (OTS) veri setlerini duyurdu. Bu veri setleri, işletmelerin AI ve makine öğrenimi (ML) projelerini hızlandırmak için gerekli yüksek kaliteli eğitim verilerini edinmesini daha kolay ve hızlı hale getirmek üzere tasarlandı. Yeni OTS veri setleri, insan vücudu hareketleri ve yenilikçi bebek ağlama sesleri ile birlikte, Arapça, Hırvatça, Yunanca, Macarca, Tayca ve daha fazlası gibi talep edilen ancak elde edilmesi zor diller için optical character recognition (OCR) için metin içeren sesli konuşma ve görüntüleri içerir. Genişletilmiş veri setleri ile Appen’in toplam OTS teklifleri, 80 dil ve birden fazla lehçe üzerinden 11.000 saatten fazla ses, 25.000’den fazla görüntü ve 8,7 milyondan fazla kelime içeren 250’den fazla veri setini içerir.
Appen’in OTS veri setleri, AI veya ML projesini yüksek kaliteli eğitim verisi ile hızlı ve maliyet-effective bir şekilde başlatmak için bir araçtır. AI yeteneklerini genişleten ekipler, OTS veri setlerini kullanarak etkili bir şekilde doğruluğu geliştirebilir, yeni model becerileri geliştirebilir ve AI modellerine diğer iyileştirmeleri dahil edebilir. Bir OTS veri seti genellikle bir hafta içinde teslim edilir, örneğin, yeni bir veri toplama ve anotasyon projesi için sekiz ila on iki hafta yerine – veya daha uzun, karmaşıklığa bağlı olarak. Tüm Appen veri setleri, tamamen şeffaf, opt-in bir metodoloji kullanılarak geliştirilir, böylece AI uzmanları verilerinin temiz ve uyumlu olduğunu bilir ve geri tepme ve itibar hasarı riskini ortadan kaldırır.
“Dünya çapındaki AI ekipleri, sıkı teslim tarihleri ve esnek veri gereksinimleri ile çalışan projelerden yararlanmak için off-the-shelf veri setlerini kullanabilir” dedi Appen CTO’su Wilson Pang. “OTS veri setleri, değere ulaşma süresini kısaltır ve geleneksel yöntemler kullanıldığında daha düşük toplam maliyetle yüksek kaliteli verilere erişim sağlar. Appen olarak, tüm veri setlerimizin etik olarak kaynaklandığını ve demografik olarak dengeli olduğunu garantileyerek, şirketlerin sorumlu AI uygulamalarını sürdürmelerini ve modellerindeki önyargıyı en aza indirerek veri anotatörlerinin adil muamele görmesini sağlıyoruz. Her zaman bir OTS veri setinin kesin kalitesini bilirsiniz, bu da gerçek dünyada çalışan daha iyi AI’lerin oluşturulmasına yardımcı olur.”
MediaInterface, 20 yılı aşkın bir süredir Almanya ve Avrupa’nın diğer bölgelerindeki sağlık kurumlarına dil teknolojisi çözümleri sunuyor. Şirket Fransa’ya genişlediğinde, tamamen yerelleştirilmiş yazılıma sahip olmasına rağmen, özellikle Fransız isimleri ve yerleri içeren Fransız leksikon verilerine ihtiyaç duyuyordu. Appen OTS veri setlerini kullanarak MediaInterface, yaklaşık 21.000 Fransız ismi ve 14.000 yer ismi edindi. “Appen’den alınan kritik veriler, yeni bir pazarı başarıyla başlatmak için arka plan leksikonumuza entegre edildi ve bu, müşterilerimiz için yeni sözlükler oluşturmamıza ve gelecekteki pazar lansmanları için yaklaşımımızı güçlendirmemize yardımcı oluyor” dedi MediaInterface ürün müdürü Ines Wendler.
En deneyimli AI uzmanları, karmaşık AI modeli eğitim veri setlerini karşılamak için OTS veri setlerini talep üzerine veri toplama ve anotasyon projeleriyle birleştirir. Appen, devam eden desteği sağlamak için, sürekli veri anotasyonu ve akıllı etiketleme gibi özel veri toplama hizmetleri, AI destekli araçlar ve otomatik iş akışları sunarak verimliliği en üst düzeye çıkarmak için liderdir.
“AI ile günün her saatinde, uyanma anından uyku vaktine kadar etkileşime giriyoruz – sanal asistanlar, sohbet botları, arama motorları, sosyal ağlar, tıbbi cihazlar, akıllı arabalar ve diğer uygulamalar aracılığıyla” dedi Appen’in AI uzmanları kıdemli müdürü Judith Bishop, 100 AI dilbilimcisi ve dil uzmanından oluşan bir ekibe liderlik ediyor. “Dil, birçok bu cazip AI kullanım durumu için genellikle birincil arayüzdür, bu nedenle mükemmel bir deneyim garantilemek için modelin herkes için çalışacak şekilde eğitilmesi gerekir. Appen’in yüksek kaliteli verilere ve sorumlu, etik AI geliştirmeye olan taahhüdü, şirketlerin off-the-shelf veri setlerimizi satın alırken veri setlerine tam güvenle AI projelerini hızlandırmasına olanak tanır.”
Mevcut yüzlerce veri setine ek olarak appen.com üzerinde canlı olan yeni Appen OTS veri setleri listesi şunları içerir:
- Mısır Arapçası, Suudi Arapçası, Birleşik Arap Emirlikleri Arapçası, Orta Khmer (Kamboçya), Hırvatça, Yunanca, Macarca, Lehçe, İspanyolca (İspanya) ve Türkçe için sesli konuşma
- Basılı metin için Çinçe (Basitleştirilmiş) OCR, Tayca basılı metin ve Fince basılı metin – Bilgisayarlı görme OCR modellerini eğitmek ve güncellemek için önceden kaydedilmiş billboardlar, dış ambalaj, işaretler, dergiler ve menüleri içerir
- İnsan vücudu hareketleri (Çin) – Piksel düzeyinde izlenen, oyun geliştirme, fitness uygulamaları ve daha fazlası için uygun, anotlanmış videolar içerir
- Bebeğin ağlama sesi (Çin) – Ebeveynleri farklı ağlama seslerini tanımak için eğitebilecek ve uyarmak için kullanılabilen önceden kaydedilmiş ve anotlanmış bebek sesleri içerir
Daha fazla bilgi için ve bir Appen OTS veri seti örneği istemek için buraya tıklayın.


