Anderson’un Açısı
Sahneleri Anlayan Yapay Zekâ Görüntü Maskeleme

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Öne çıkan noktalarYapay zekâ tabanlı arka plan ayırma artık yeşil perde yerine sahne anlayışını…
Daha fazla göster
- Yapay zekâ tabanlı arka plan ayırma artık yeşil perde yerine sahne anlayışını kullanıyor.
- Yeni SPG-IM hattı, trimap gerektirmeyen yöntemleri büyük bir farkla geride bırakıyor.
- Metinsel etiketler, pahalı piksel anotasyonuna düşük maliyetli bir alternatif sunuyor.
2003’te DVD olarak yayımlanan Alien3 (1992) filminin ek içeriklerindeki belgeselde, görsel efektlerin efsane isimlerinden Richard Edlund, 1930’ların sonlarından 1980’lerin sonlarına kadar görsel efekt çalışmalarına hâkim olan fotokimyasal maske çıkarma sürecini korkuyla anımsayarak bu süreci “sumo güreşi” diye nitelendirdi. Edlund, isabet oranı düşük ve zahmetli bu süreci, 1990’ların başında yaygınlaşan dijital mavi/yeşil perde teknikleriyle karşılaştırarak “sumo güreşi” olarak tanımlamıştı (daha sonra bu benzetmeye yeniden başvurdu).
Ön plandaki bir öğeyi (örneğin bir kişiyi ya da uzay gemisi modelini) arka plandan ayırıp kesilmiş görüntüyü bir arka plan karesine yerleştirmek için, başlangıçta ön plandaki nesne tek renkli mavi ya da yeşil bir fonun önünde filme alınırdı.
ILM’nin ‘Jedi’ın Dönüşü’ (1983) için hazırladığı bir görsel efekt çekiminde kullanılan zahmetli fotokimyasal maske çıkarma işlemleri.
Ortaya çıkan görüntülerde arka plan rengi daha sonra kimyasal yöntemlerle yalıtılır ve ön plandaki nesneyi (ya da kişiyi), diğer kısımları saydam olan film karesinde “havada süzülüyormuş” gibi yeniden basmak için optik yazıcıda şablon olarak kullanılırdı.
Bu işlem, renk ayrımlı bindirme (CSO) olarak biliniyordu. Ancak bu terim zamanla, 1970’lerde ve 1980’lerde daha düşük bütçeli televizyon yapımlarında kullanılan, kimyasal ya da dijital değil analog yöntemlerle gerçekleştirilen ilkel renk anahtarlama video efektleriyle daha çok anılır oldu.

1970’te İngiliz çocuk programı ‘Blue Peter’ için yapılan bir renk ayrımlı bindirme gösterimi. Kaynak: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
Her hâlükârda, film ya da video görüntülerinde olsun, ayrıştırılan görüntüler daha sonra başka herhangi bir görüntüye eklenebiliyordu.
Disney’in belirgin biçimde daha pahalı ve kendine özgü sodyum buharlı yöntemi özellikle sarı rengi anahtarlıyordu ve Alfred Hitchcock’un 1963 yapımı korku filmi The Birds için de kullanılmıştı. Bu yöntem daha net sınırlar ve daha keskin maskeler sağlasa da fotokimyasal maske çıkarma işlemi zahmetli ve güvenilmez olmayı sürdürdü.

Disney’in kendine özgü sodyum buharlı maske çıkarma yöntemi, spektrumun sarı ucuna yakın renklerde arka planlar gerektiriyordu. Burada Angela Lansbury, ‘Bedknobs and Broomsticks’ (1971) için görsel efektlerle dolu bir sahnenin çekimleri sırasında kablolarla havada asılı duruyor. Kaynak
Dijital Maskelemenin Ötesinde
1990’larda dijital devrim kimyasalları ortadan kaldırdı, ancak yeşil perde ihtiyacını ortadan kaldırmadı. Artık Photoshop gibi piksel düzenleme yazılımlarında ve renkli arka planları otomatik olarak anahtarlayabilen yeni nesil video birleştirme programlarında, o rengin belirli bir tolerans aralığı içindeki pikselleri aranarak yeşil (ya da başka renkteki) arka plan kaldırılabiliyordu. Neredeyse bir gecede, optik baskı endüstrisinin altmış yıllık geçmişi tarihe karıştı.
GPU hızlandırmalı bilgisayarlı görü alanındaki son on yıllık araştırmalar, maske çıkarımını üçüncü bir çağa taşıyor; araştırmacılara, yeşil perdeye gerek kalmadan yüksek kaliteli maskeler çıkarabilen sistemler geliştirme görevi veriyor. Yalnızca arXiv’de bile, makine öğrenmesine dayalı ön plan çıkarımındaki yenilikleri ele alan makaleler her hafta yayımlanıyor.
Bizi Görüntüye Dâhil Etmek
Yapay zekâ destekli maske çıkarımına yönelik akademik ve sektörel ilgi, tüketici ürünlerini şimdiden etkiledi: Hepimiz, video konferans görüşmelerinde oturma odalarımızın arka planını tropik adalarla ve benzeri görüntülerle değiştirebilen Zoom ve Skype filtrelerinin ilkel ama iş gören uygulamalarına aşinayız.
Ancak en iyi maskeler için hâlâ yeşil perde gerekiyor; Zoom’un geçen çarşamba belirttiği gibi.

Solda, Zoom’un Sanal Arka Plan özelliğiyle saçları iyi biçimde ayrıştırılmış, yeşil perde önünde duran bir adam. Sağda, sıradan bir ev ortamında duran bir kadın; saçları algoritmik olarak, daha az isabetli biçimde ve daha yüksek işlem gücü gereksinimiyle ayrıştırılmış. Kaynak: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Zoom Destek platformundaki bir başka paylaşımda, yeşil perde kullanılmadan yapılan maske çıkarma işleminin çekim cihazında daha fazla işlem gücü gerektirdiği belirtiliyor.
Kesip Çıkarma İhtiyacı
(Yani yeşil perdeye ihtiyaç duymadan insanları ayıran) gerçek dünya koşullarında çalışan maske çıkarma sistemlerinin kalitesini, taşınabilirliğini ve kaynak verimliliğini artırmak; yalnızca video konferans filtreleriyle sınırlı kalmayıp çok daha fazla sektör ve alanda önem taşır.
Veri kümelerinin geliştirilmesi açısından, yüzü, başın tamamını ve tüm vücudu daha iyi tanımak; insan öznelerin bilgisayarlı görü modellerinin eğitimine ilgisiz arka plan öğelerinin dahil edilmesini önleme olanağı sunar. Daha doğru bir ayırma, alanları (yani ‘kedi’, ‘kişi’, ‘tekne’) ayırt edip özümsemek üzere tasarlanmış semantik bölütleme tekniklerini büyük ölçüde iyileştirir; VAE ve transformer tabanlı görüntü sentezi sistemlerini, örneğin OpenAI’ın yeni DALL-E 2 modelini geliştirir. Ayrıca daha iyi çıkarım algoritmaları, yüksek maliyetli görsel efekt iş akışlarında pahalı manuel rotoskopi ihtiyacını azaltır.
Aslında, ‘kedi’ gibi bir alanın hem görüntü olarak hem de ilişkili metin referanslarıyla kodlandığı çok kipli (genellikle metin/görüntü) yöntemler, görüntü işlemede şimdiden kendine yer edinmeye başladı. Bunun yakın tarihli bir örneği Text2Live mimarisidir. Bu mimari çok kipli (metin/görüntü) eğitimden yararlanarak sayısız olasılığın yanı sıra kristal kuğular ve cam zürafalar içeren videolar oluşturur.
Sahneleri Anlayan Yapay Zekâ ile Maske Çıkarımı
Yapay zekâ tabanlı otomatik maske çıkarımı üzerine yapılan araştırmaların önemli bir bölümü, bir görüntü veya video karesindeki piksel gruplarının sınırlarını tanımaya ve değerlendirmeye odaklandı. Ancak Çin’den gelen yeni bir araştırma, sahnenin metin tabanlı açıklamalarından yararlanarak ayrımı ve maske kalitesini iyileştiren bir çıkarım iş akışı sunuyor. Bilgisayarlı görü araştırma alanında son 3-4 yılda yaygınlık kazanan bu çok kipli yaklaşım, önceki yöntemleri çeşitli açılardan geliştirdiğini öne sürüyor.

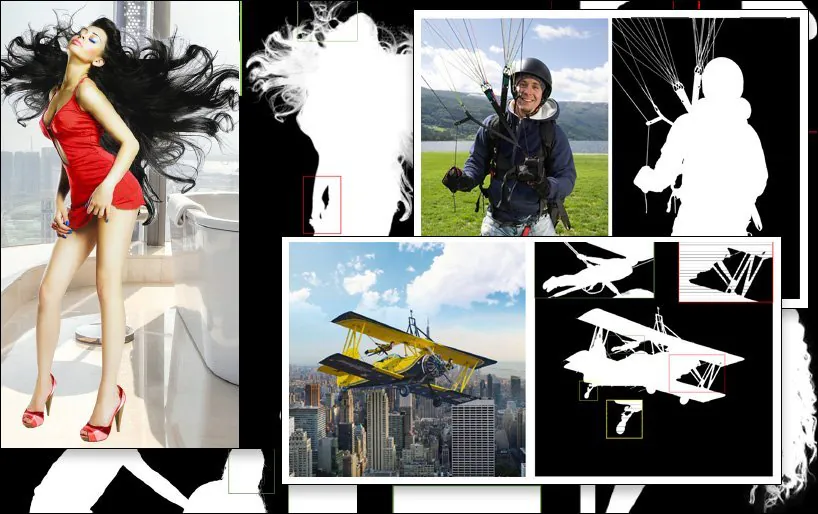
Önceki rakip yöntemlerle karşılaştırılan SPG-IM çıkarım örneği (son görsel, sağ alt). Kaynak: https://arxiv.org/pdf/2204.09276.pdf
Çıkarım araştırmalarının alt alanındaki zorluk, mümkünse hiç manuel açıklama ve insan müdahalesi gerektirmeyen, en az düzeyde gerektiren iş akışları geliştirmektir. Maliyet boyutunun yanı sıra, yeni makalenin araştırmacıları, farklı kültürlerden dış kaynaklı çalışanlar tarafından yapılan açıklamaların ve manuel bölütlemelerin, görüntülerin farklı biçimlerde etiketlenmesine, hatta bölütlenmesine yol açabileceğini; bunun da tutarsız ve yetersiz algoritmalarla sonuçlanabileceğini belirtiyor.
Bunun bir örneği, ‘ön plan nesnesi’ tanımının öznel yorumlanmasıdır:

Yeni makaleden: Önceki LFM ve MODNet yöntemleri (‘GT’, Ground Truth’u, yani çoğu zaman manuel olarak veya algoritmik olmayan yöntemlerle elde edilen ‘ideal’ sonucu ifade eder), ön plan içeriğinin tanımını farklı biçimlerde ve değişen başarı düzeyleriyle ele alırken, yeni SPG-IM yöntemi sahne bağlamından yararlanarak ‘yakın içeriği’ daha etkili biçimde belirginleştiriyor.
Araştırmacılar bu sorunu çözmek için Situational Perception Guided Image Matting (SPG-IM) adlı iki aşamalı bir iş akışı geliştirdi. İki aşamalı kodlayıcı/kod çözücü mimarisi, Situational Perception Distillation (SPD) ve Situational Perception Guided Matting (SPGM) bileşenlerinden oluşuyor.

SPG-IM mimarisi.
İlk olarak SPD, görüntüden metne özellik dönüşümlerini önceden eğitir ve ilgili görüntülere uygun açıklamalar üretir. Ardından, iş akışı yeni bir belirginlik tahmini tekniğine bağlanarak ön plan maskesi tahmini mümkün hale getirilir.
Daha sonra SPGM, ham RGB görüntü girdisine ve ilk modülde oluşturulan maskeye dayanarak tahmini bir alfa maskesi üretir.
Amaç, durumsal algı rehberliği sağlamaktır. Böylece sistem, görüntünün nelerden oluştuğunu bağlamsal olarak anlayabilir ve örneğin karmaşık saçları arka plandan ayırma zorluğunu bu özel görevin bilinen özellikleri çerçevesinde ele alabilir.

Aşağıdaki örnekte SPG-IM, iplerin ‘paraşütün’ ayrılmaz bir parçası olduğunu anlıyor; MODNet ise bu ayrıntıları koruyup belirginleştiremiyor. Benzer şekilde, yukarıdaki örnekte oyun alanı ekipmanının tüm yapısı MODNet’te gelişigüzel biçimde kayboluyor.
Yeni makalenin başlığı Sahne Algısıyla Yönlendirilen Görüntü Maskeleme ve makale, OPPO Research Institute, PicUp.ai ve Xmotors araştırmacıları tarafından hazırlandı.
Akıllı Otomatik Maskeler
SPG-IM ayrıca yerel ayrıntıları ve genel bağlamı ayrı ayrı işleyebilen, böylece “akıllı maskelerin” oluşturulmasını kolaylaştıran bir Adaptive Focal Transformation (AFT) İyileştirme Ağı sunuyor.

Bu örnekte “atla birlikte bir kız” olan sahne bağlamını anlamak, ön planı ayırmayı önceki yöntemlere kıyasla potansiyel olarak kolaylaştırabilir.
Makalede şöyle deniyor:
‘Görselden metne dönüştürme görevi kapsamında elde edilen görsel temsillerin, örneğin görüntü açıklaması oluşturmanın, hem genel bilgileri hem de yerel ayrıntıları kapsayan açıklamalar üretebilmek için a) nesneler arası ve b) nesnelerle çevreleri arasındaki daha kapsamlı anlamsal sinyallere odaklandığına inanıyoruz. Ayrıca, görüntü maskelemede gereken yüksek maliyetli piksel etiketlemesiyle karşılaştırıldığında metinsel etiketler çok düşük maliyetle büyük ölçekte toplanabilir.’
Mimarinin SPD dalı, anlamsal açıdan yoğun açıklamalardan görsel temsiller öğrenen, University of Michigan’ın Transformer tabanlı metin çözücüsü VirTex ile birlikte önceden eğitiliyor.

VirTex, görüntü-açıklama çiftleri aracılığıyla bir ConvNet ile Transformer modellerini birlikte eğitir ve elde edilen bilgileri nesne algılama gibi sonraki aşamalardaki görsel görevlere aktarır. Kaynak: https://arxiv.org/pdf/2006.06666.pdf
Araştırmacılar, diğer testlerin ve bileşen çıkarma çalışmalarının yanı sıra SPG-IM’yi, son teknoloji üç bölgeli harita tabanlı yöntemler olan Deep Image Matting (DIM), IndexNet, Context-Aware Image Matting (CAM), Guided Contextual Attention (GCA), FBA ve Semantic Image Matting (SIM) ile karşılaştırdı.
Test edilen diğer önceki yöntemler arasında üç bölgeli harita kullanmayan LFM, HAttMatting ve MODNet yaklaşımları da vardı. Adil bir karşılaştırma için test yöntemleri, metodolojiler arasındaki farklılıklara göre uyarlandı; kodun mevcut olmadığı durumlarda ise makalede açıklanan mimariye dayanarak teknikler yeniden uygulandı.
Yeni makalede şöyle deniyor:
‘SPG-IM’miz, üç bölgeli harita kullanmayan tüm rakip yöntemleri ([LFM], [HAttMatting] ve [MODNet]) büyük farkla geride bırakıyor. Ayrıca modelimiz, kamuya açık veri kümelerinin (Composition-1K, Distinction-646 ve Human-2K) tamamında ve Multi-Object-1K kıyaslama veri kümemizde, dört ölçütün tümünde son teknoloji (SOTA) üç bölgeli harita tabanlı ve maskeyle yönlendirilen yöntemlere karşı da kayda değer bir üstünlük gösteriyor.’
Şöyle devam ediyor:
‘Yöntemimizin, üç bölgeli harita yönlendirmesi olmadan ince ayrıntıları (ör. saç uçlarını, saydam dokuları ve sınırları) koruduğu açıkça görülüyor. Ayrıca SPG-IM’miz, üç bölgeli harita kullanmayan diğer rakip modellere kıyasla anlamsal bütünlüğü daha iyi koruyabiliyor.’


İlk olarak 24 Nisan 2022’de yayımlandı.