
Anderson’un Açısı
Metinle Yönlendirilen Girdilerle Tutarlı Yapay Zekâ Video İçeriği Düzenleme

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
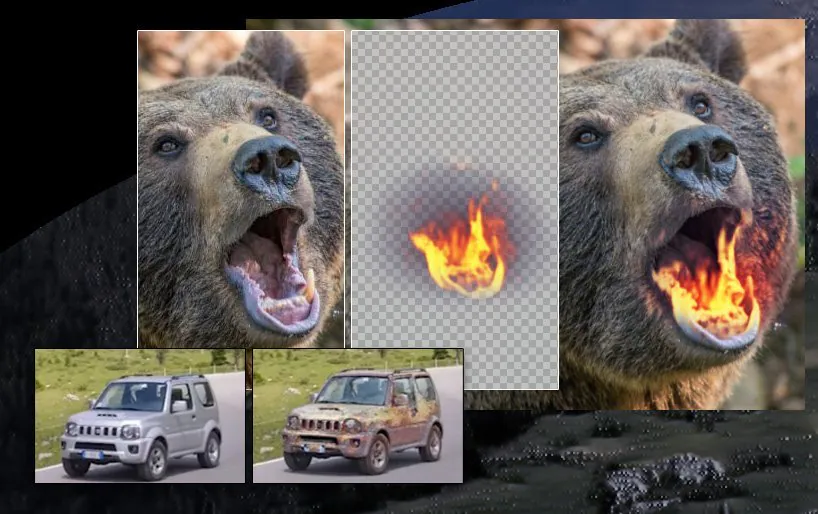
Öne çıkan noktalarText2Live, metin istemlerinden tutarlı video düzenlemeleri yapmayı, kare bazında işlem…
Daha fazla göster
- Text2Live, metin istemlerinden tutarlı video düzenlemeleri yapmayı, kare bazında işlem gerektirmeden sağlar.
- Sistem, düzenlemeleri tüm video zaman çizelgesinde bir kez uygulamak için sinirsel katmanlı bir atlas kullanır.
- Text2Live, maskeleme ve birleştirme işlemlerini otomatikleştirerek rotoskop veya yeşil ekran ihtiyacını ortadan kaldırır.
Profesyonel VFX topluluğu görüntü ve video sentezindeki yeni gelişmelere ilgi duyarken zaman zaman bunlardan biraz tehdit de hissediyor. Ancak çoğu yapay zekâ tabanlı video düzenleme projesindeki zamansal süreklilik eksikliği, bu çalışmaların çoğunu «psikedelik» alana itiyor: parlayan ve hızla değişen dokular ve yapılar, tutarsız efektler ve görsel efektlerin fotokimyasal çağını hatırlatan kaba teknoloji kullanımı.
Eğer bir videoda, derin sahteciliklerin (yani, bir kişinin mevcut görüntüsüne yeni bir kimlik dayatması) dışında bir şeyi değiştirmek istiyorsanız, çoğu mevcut çözüm üretim kaliteli görsel efektler için gerekli kesinlik açısından oldukça ciddi sınırlamalarla çalışır.
Bu durumun bir istisnası, Weizmann Bilim Enstitüsü’nden bir grup akademisyenin devam eden çalışmasıdır. 2021 yılında enstitünün üç araştırmacısı, Adobe (ADBE ) ile birlikte, videoyu parçalara ayırıp tutarlı bir iç eşlemeyi —bir katmanlı nöral atlası— alfa kanalları ve zaman içinde uyumlu sonuçlarla birleşik çıktıya ekleyen yeni bir yöntem duyurdu.
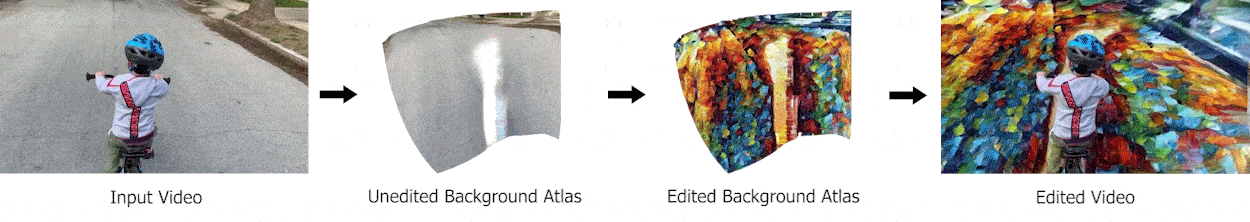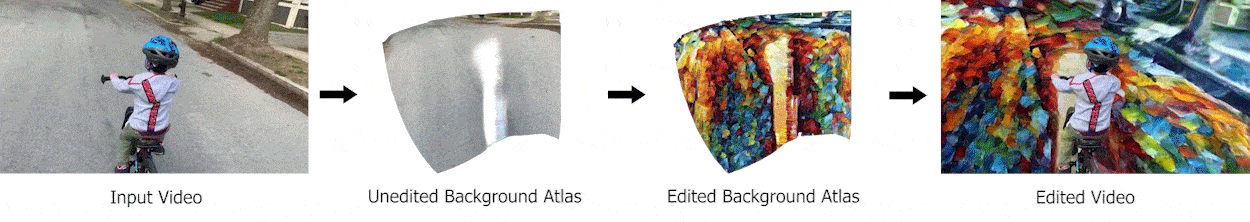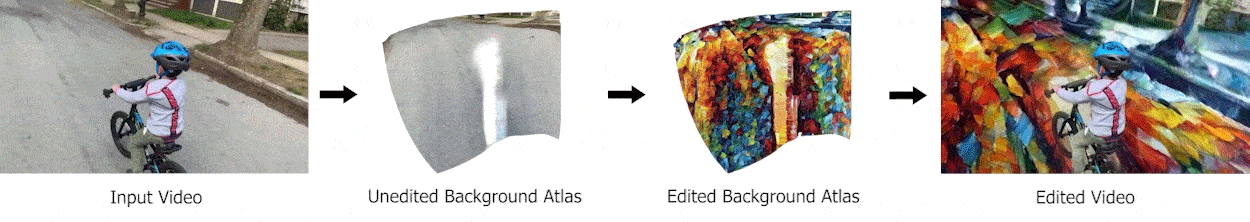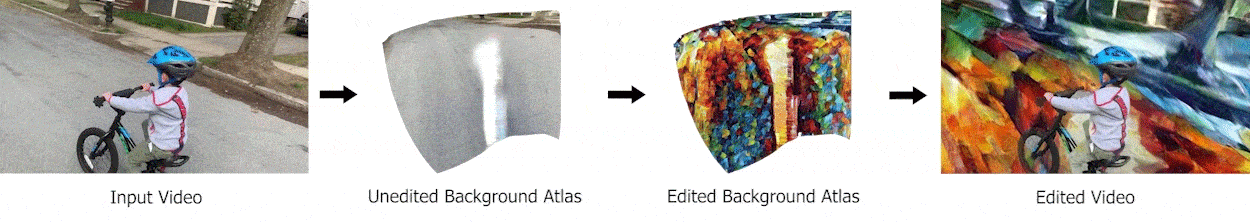
2021 makalesinden: Kaynak klipteki yolun tam geçişinin tahmini, geleneksel olarak geniş rotoskopi ve hareket eşleştirmesi gerektirecek şekilde bir nöral ağ tarafından düzenlenmiştir. Arka plan ve ön plan elemanları farklı ağlar tarafından işlendiği için maskeler gerçekten ‘otomatik’tir. Kaynak: https://layered-neural-atlases.github.io/
Bu, VFX pipeline’larında optik akış tarafından kapsanan alana girer, ancak geleneksel CGI iş akışlarında doğrudan eşdeğeri yoktur, çünkü esasen bir ‘zamanlı doku haritası’ oluşturur ve geleneksel yazılım yöntemleriyle üretilebilir ve düzenlenebilir.
Üstteki illüstrasyondaki ikinci resim, yol yüzeyinin arka planını (sembolik olarak) tüm video süresince temsil eder. Bu temel görüntüyü değiştirmek (üstteki illüstrasyondaki üçüncü resim), arka planında tutarlı bir değişikliğe neden olur.
‘Açık’ atlasın yukarıdaki resimleri yalnızca bireysel yorumlanmış kareleri temsil eder; hedef video karesindeki tutarlı değişiklikler, gerekli örtüşmeleri ve diğer sahne efektlerini (gölgeler veya yansımalara benzer) koruyarak orijinal kareye geri eşlenir.
Temel mimari, katmanlı atlasları, alfa kanallarını ve eşleştirmeleri temsil etmek için bir Çok Katmanlı Perceptron (MLP) kullanır; tüm bunlar birlikte ve tamamen iki boyutlu bir alanda optimize edilir ve NeRF tarzı 3B geometri noktaları, derinlik haritaları ve benzer CGI tarzı unsurların önceden bilgisine gerek kalmaz.
Bireysel nesnelerin referans atlası da güvenilir bir şekilde değiştirilebilir:
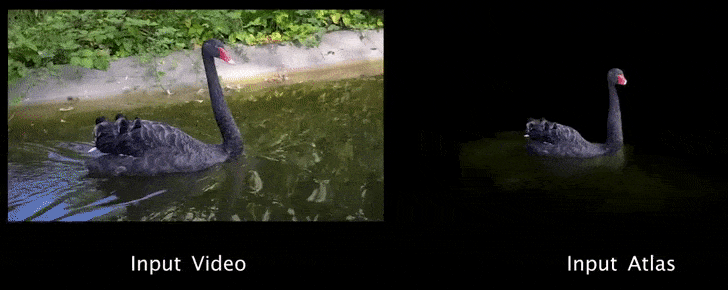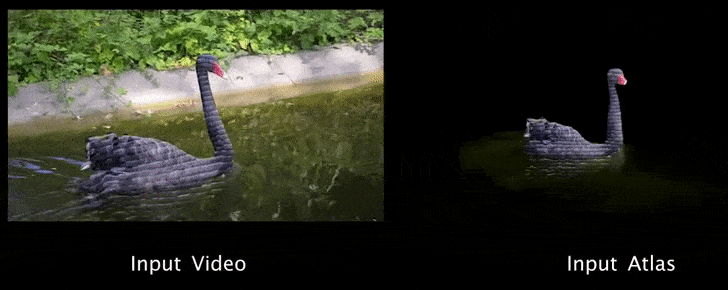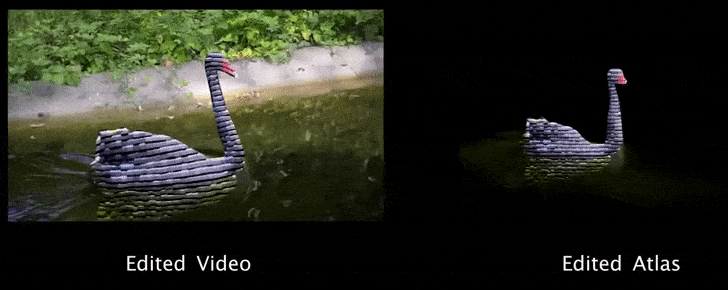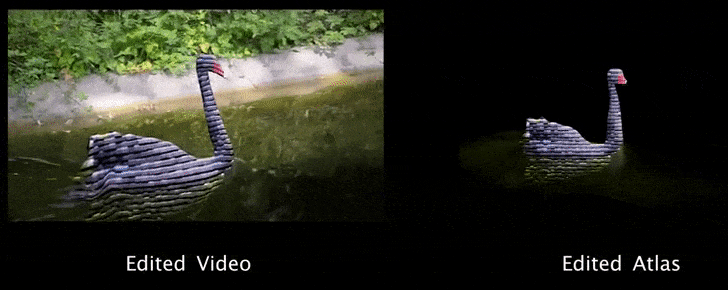
2021 çerçevesi altında hareketli bir nesneye tutarlı değişiklik. Kaynak: https://www.youtube.com/watch?v=aQhakPFC4oQ
Esasen 2021 sistemi; geometri hizalama, hareket eşleştirme, eşleme, yeniden dokulandırma ve rotoskopiyi ayrı bir nöral süreçte birleştirir.
Text2Live
2021 makalesinin üç orijinal araştırmacısı, NVIDIA (NVDA ) araştırma ekibiyle birlikte, katmanlı atlasların gücünü, metinle yönlendirilen CLIP teknolojisiyle birleştiren yeni bir geliştirmeye katkıda bulunuyor. Bu teknoloji, OpenAI’ın DALL-E 2 çerçevesini bu hafta yayımlamasıyla yeniden öne çıktı.
Text2Live adlı yeni mimari, son kullanıcının metin promtlarına dayalı olarak gerçek video içeriğine yönelik yerel düzenlemeler yapmasına olanak tanır:
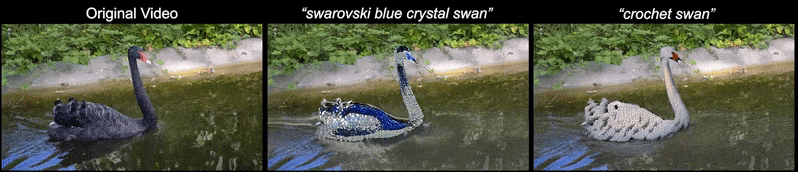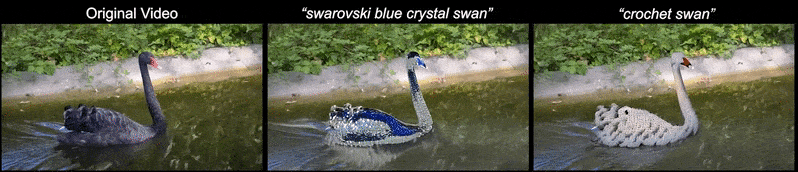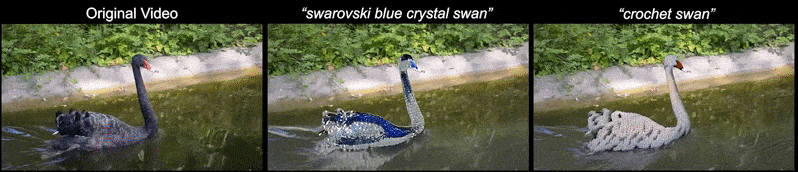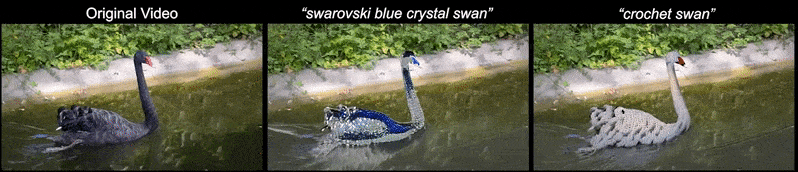
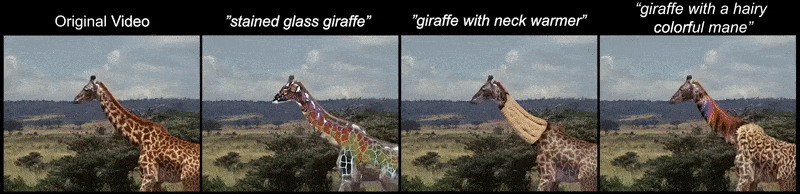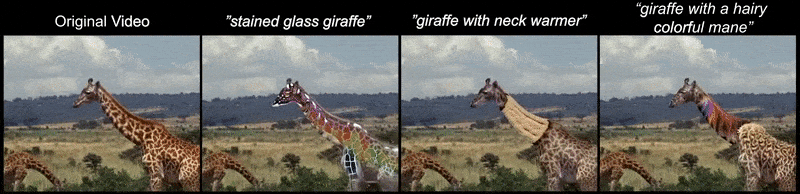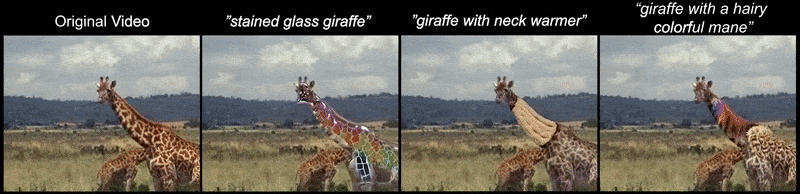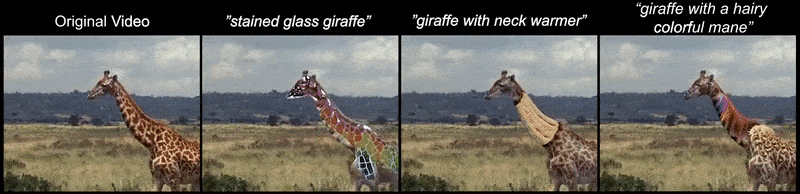
Ön plan düzenlemenin iki örneği. Daha iyi çözünürlük ve netlik için, orijinal videolara https://text2live.github.io/sm/pages/video_results_atlases.html adresinden ulaşabilirsiniz
Text2Live, önceden eğitilmiş bir jeneratör kullanmadan, video klibine özgü bir iç veritabanını kullanarak, anlamsal ve yüksek derecede yerel düzenleme sağlar.

Text2Live altında arka plan ve ön plan (nesne) dönüşümleri. Kaynak: https://text2live.github.io/sm/pages/video_results_atlases.html
Teknik, geleneksel rotoskopi veya yeşil ekran iş akışlarında olduğu gibi kullanıcı tarafından sağlanan maskeleri gerektirmez, ancak Tel Aviv Üniversitesi Bilgisayar Bilimleri Okulu ve Facebook AI Research’ün (FAIR) 2021 araştırmasına dayalı bir önyükleme tekniğiyle alaka haritaları tahmin eder.

Transformer tabanlı genel dikkat modeli ile oluşturulan çıktı haritaları.
Yeni makale, Text2LIVE: Metin-Rehberli Katmanlı Görüntü ve Video Düzenleme olarak adlandırılmıştır. Orijinal 2021 ekibine, Weizmann’ın Omer Bar-Tal’i ve NVIDIA Araştırma’nın Yoni Kasten’i de katılmıştır.
Mimari
Text2Live, tek bir girdi görüntüsü ve hedef metin promtlarına dayalı olarak eğitilen bir jeneratörden oluşur. 400 milyon metin/görüntü çifti üzerinde önceden eğitilmiş karşıtsal dil–görüntü ön eğitimi (CLIP) modeli, kullanıcı girişine dayalı dönüşümlerin yorumlanabileceği ilgili görsel materyali sağlar.

Jeneratör, girdi görüntüsünü (kare) kabul eder ve renk ve opaklık bilgilerini içeren bir hedef RGBA katmanını çıkarır. Bu katman daha sonra orijinal görüntüye ek işlemlerle birleştirilir.

Üretilen RGBA katmanındaki alfa kanalı, After Effects gibi piksel tabanlı yazılımlar kullanan geleneksel süreçlere gerek kalmadan iç birleştirme işlevi sağlar.
Text2Live, hedef video veya görüntüyle ilgili iç görüntüler üzerinde eğitilerek, girdi görüntüsünü üretici çekişmeli ağın (GAN) gizil uzayına ters eşleme gereksinimini ortadan kaldırır. Bu uygulama hâlen üretim düzeyindeki video düzenleme için yeterince hassas olmaktan uzaktır. Ayrıca daha hassas ve yapılandırılabilir olmasına rağmen hedef videoya sadakati koruyamayan bir difüzyon modelini kullanmak da gerekmez.

Text2Live’dan çeşitli promt tabanlı dönüşüm düzenlemeleri.
Önceki yaklaşımlar, iletim tabanlı yöntemler veya optik akış tabanlı yaklaşımları kullanmıştır. Bu teknikler belirli bir ölçüde kare tabanlı olduğundan, çıktı videosunda değişikliklerin tutarlı bir zamanlı görünümünü oluşturamazlar. Bir nöral katmanlı atlas, ise değişikliklere yönelik tek bir alanda işlem yapma olanağı sağlar ve bu değişiklikler video ilerledikçe sadık kalır.
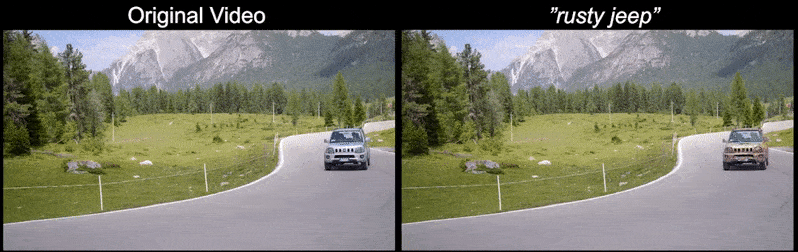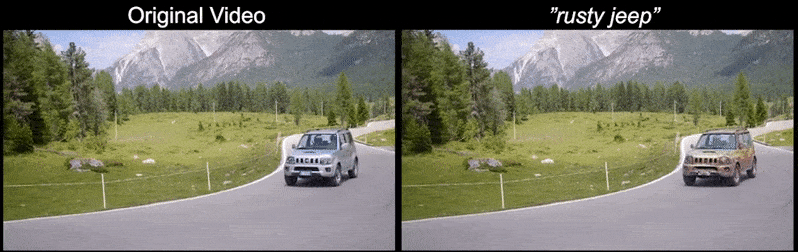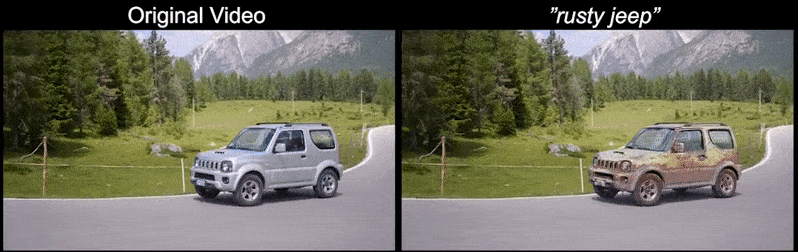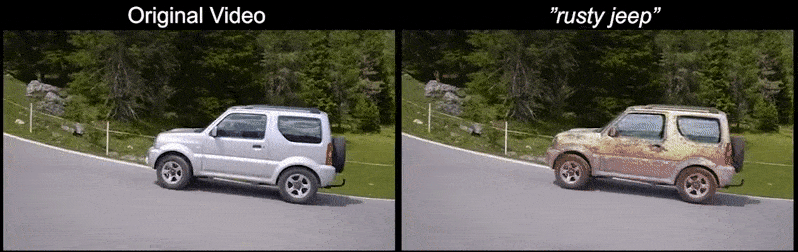
Titreme veya rastgele halüsinasyon yok: Text2Live, metin promt’ını ‘paslı jeep’ olarak yorumlar ve videodaki araba için nöral katmanlı atlasına bir kez uygular, her yorumlanmış kare için dönüşümü yeniden başlatmak yerine.

Text2Live’nin bir Jeep’i paslı bir enkaz haline getirmesinin iş akışı.
Text2Live, yapay zekâ tabanlı birleştirmede bir atılıma daha yakındır. OpenAI’ın DALL-E çerçevesinin ikinci neslinin bu hafta yayımlanmasıyla büyük ilgi gören metinden görüntü üretme alanından ziyade bu alanda ilerleme sağlar. DALL-E dönüşüm sürecine hedef görüntüleri katabilse de fotoğrafı doğrudan değiştirme yeteneği sınırlıdır. Ayrıca kullanıcıların kötüye kullanımını önlemek için kaynak eğitim verilerinin sansürlenmesi ve filtreler uygulanması gibi kısıtlamalar vardır.
Text2Live ise son kullanıcının bir atlas çıkarmasına ve bunu Photoshop gibi yüksek denetim sağlayan piksel tabanlı ortamlarda tek geçişte düzenlemesine olanak tanır. Bunun NeRF gibi daha soyut görüntü sentezi çerçevelerinde bile yapılabileceği söylenebilir. Atlas daha sonra üç boyutlu tahmine veya eski yöntemlere dönen CGI yaklaşımlarına dayanmayan, doğru yönlendirilmiş ortama geri verilir.
Dahası, Text2Live, yazarlara göre, tamamen otomatik bir şekilde maskeleme ve kompozisyonu başaran ilk karşılaştırılabilir çerçeve olduğunu iddia ediyor.
İlk olarak 7 Nisan 2022’de yayımlanmıştır.





