
Cybersäkerhet
Varför Adversarial Image Attacks Inte Är Något Att Skämta Om

 Lägg till Unite.AI bland dina föredragna källor på Google
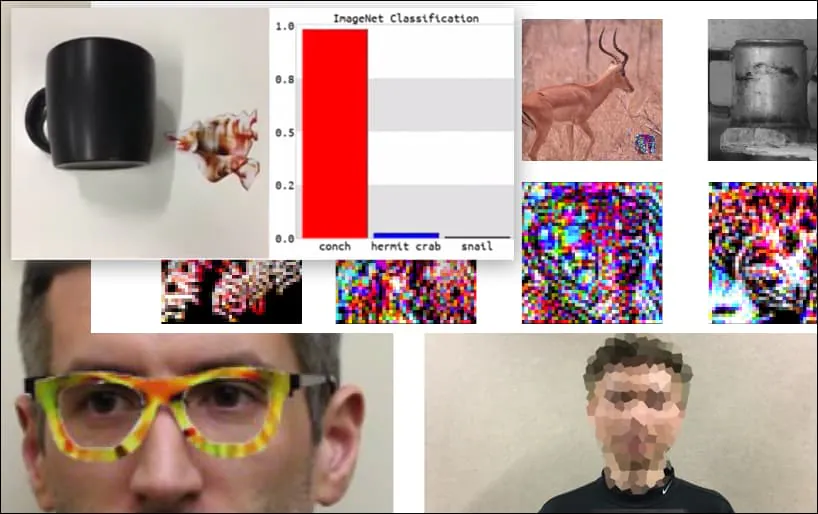
Att attackera bildigenkänningssystem med noggrant utformade adversarialbilder har under de senaste fem åren ansetts vara ett roligt men trivialt bevis för konceptet. Men ny forskning från Australien tyder på att det slumpmässiga användandet av mycket populära bildsatsningar för kommersiella AI-projekt kan skapa ett varaktigt nytt säkerhetsproblem.
För ett par år sedan har en grupp akademiker vid University of Adelaide försökt förklara något mycket viktigt om framtiden för AI-baserade bildigenkänningssystem.
Det är något som skulle vara svårt (och mycket dyrt) att åtgärda just nu, och som skulle vara oförsvarligt dyrt att lösa när de nuvarande trenderna inom bildigenkänning forskning har utvecklats till kommersiella och industrialiserade distributioner om 5-10 år.
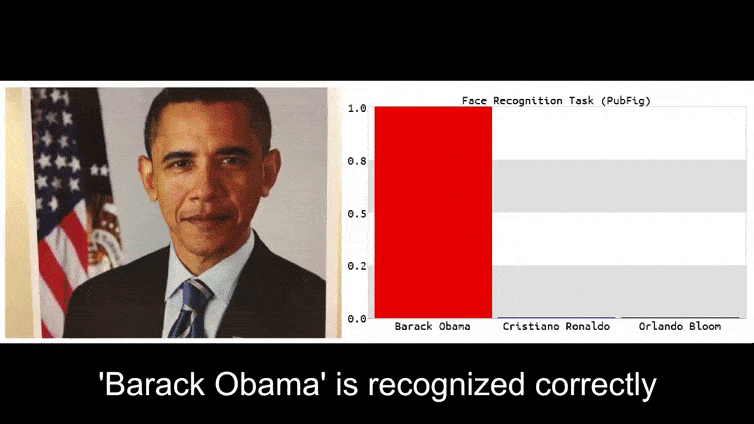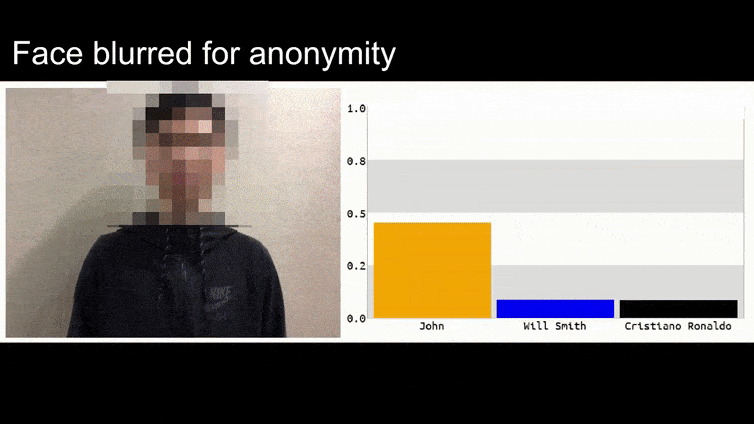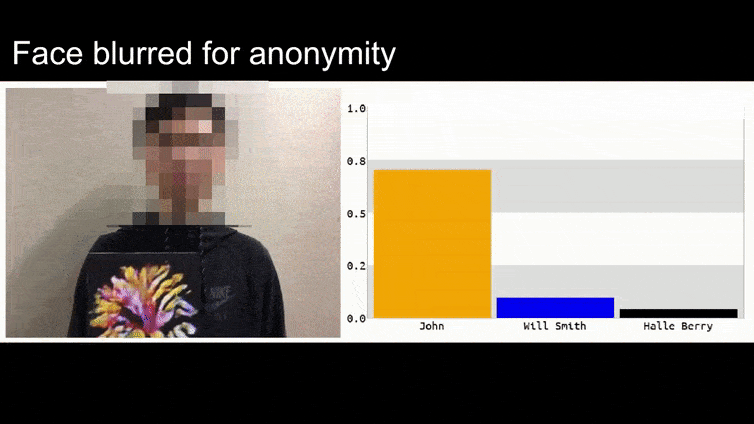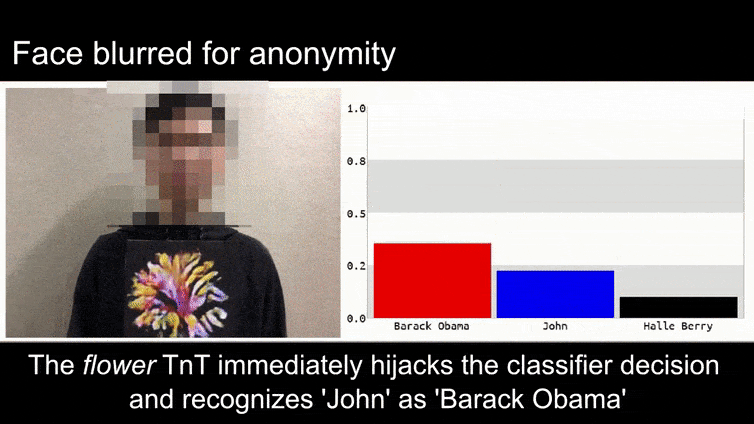
Innan vi går in på det, låt oss titta på en blomma som klassificeras som president Barack Obama, från en av de sex videor som teamet har publicerat på projektsidan:
Källa: https://www.youtube.com/watch?v=Klepca1Ny3c
I ovanstående bild är ett ansiktsigenkänningssystem som tydligt vet hur man känner igen Barack Obama lurat att tro att en anonym man som håller i en utformad, utskriven adversarialbild av en blomma också är Barack Obama. Systemet bryr sig inte ens om att “falskt ansikte” är på subjektets bröst, snarare än på hans axlar.
Även om det är imponerande att forskarna har kunnat åstadkomma denna typ av identitetsfångst genom att generera en sammanhängande bild (en blomma) istället för bara det vanliga slumpmässiga bruset, verkar det som att sådana löjliga exploateringar dyker upp ganska regelbundet i säkerhetsforskning om datorseende. Till exempel de konstigt mönstrade glasögonen som kunde lura ansiktsigenkänning för några år sedan, eller särskilt utformade adversarialbilder som försöker omdefiniera vägskyltar.
Om du är intresserad är det konvolutionella neuronnätverksmodellen (CNN) som attackeras i ovanstående exempel VGGFace (VGG-16), tränad på Columbia Universitys PubFig-dataset. Andra attackexempel som utvecklats av forskarna använde olika resurser i olika kombinationer.

En tangentbord klassificeras om som en snäcka, i en WideResNet50-modell på ImageNet. Forskarna har också säkerställt att modellen inte har någon bias mot snäckor. Se den fullständiga videon för utökade och ytterligare demonstrationer på https://www.youtube.com/watch?v=dhTTjjrxIcU
Bildigenkänning som en Ny Attackvektor
De många imponerande attacker som forskarna beskriver och illustrerar är inte kritik av enskilda dataset eller specifika maskinlärningsarkitekturer som använder dem. Inte heller kan de enkelt försvaras mot genom att byta dataset eller modeller, omträna modeller eller någon av de andra “enkla” lösningarna som får ML-praktiker att skratta åt sporadiska demonstrationer av denna typ av trickery.
Rättare sagt exemplifierar Adelaide-teamets exploateringar en central svaghet i den nuvarande arkitekturen för AI-baserad bildigenkänning; en svaghet som kunde utsätta många framtida bildigenkänningssystem för lätt manipulation av angripare och sätta eventuella försvarsåtgärder på defensiven.
Tänk dig de senaste adversarial attack-bilderna (såsom blomman ovan) som läggs till som “zero-day-exploits” till säkerhetssystem i framtiden, precis som nuvarande anti-malware och antivirus-ramverk uppdaterar sina virusdefinitioner varje dag.
Potentialen för nya adversarial attack-bilder skulle vara outtömlig, eftersom systemets grundarkitektur inte förutsåg framtida problem, som skedde med internet, Millennium Bug och Leaning Tower of Pisa.
På vilket sätt ställer vi då scenen för detta?
Att Hämta Data för en Attack
Adversarialbilder som “blomma”-exemplet ovan genereras genom att ha tillgång till de bildsatsningar som tränade datormodellerna. Du behöver inte “privilegerad” tillgång till träningsdata (eller modellarkitekturer), eftersom de mest populära dataseten (och många tränade modeller) är allmänt tillgängliga i en robust och ständigt uppdaterad torrent-scen.
Till exempel är den väldiga jätten inom datorseende-datasets, ImageNet, tillgänglig för torrent i alla dess många iterationer, och bypassar dess vanliga begränsningar, och gör viktiga sekundära element tillgängliga, såsom valideringsuppsättningar.

Källa: https://academictorrents.com
Om du har datan kan du (som Adelaide-forskarna observerar) effektivt “reverse-engineera” vilket populärt dataset som helst, såsom CityScapes eller CIFAR.
I fallet med PubFig, det dataset som möjliggjorde “Obama-blomman” i det tidigare exemplet, har Columbia University hanterat en växande trend kring upphovsrättsfrågor kring bildsatsning-redistribuering genom att instruera forskare hur man reproducerar datasetet via kuraterade länkar, snarare än att göra samlingen direkt tillgänglig, och observerar ‘Det verkar som att det är det sätt som andra stora webbaserade databaser utvecklas’.
I de flesta fall är det inte nödvändigt: Kaggle uppskattar att de tio mest populära bildsatsningarna inom datorseende är: CIFAR-10 och CIFAR-100 (båda direkt nedladdningsbara); CALTECH-101 och 256 (båda tillgängliga, och båda för närvarande tillgängliga som torrents); MNIST (officiellt tillgänglig, också på torrents); ImageNet (se ovan); Pascal VOC (tillgänglig, också på torrents); MS COCO (tillgänglig, och på torrents); Sports-1M (tillgänglig); och YouTube-8M (tillgänglig).
Denna tillgänglighet är också representativ för den bredare utbudet av tillgängliga datorseende-bildsatsningar, eftersom okändhet är döden i en “publicera eller dö” öppen källkodsutvecklingskultur.
I vilket fall som helst, bristen på hanterbara nya dataset, den höga kostnaden för bildsatsningsutveckling, beroendet av “gamla favoriter” och tendensen att enbart anpassa äldre dataset förvärrar problemet som beskrivs i den nya Adelaide-rapporten.
Typiska Kritiker av Adversarial Image Attack-metoder
Den vanligaste och mest ihållande kritiken från maskinläringsingenjörer mot effektiviteten av den senaste adversarial image attack-tekniken är att attacken är specifik för ett visst dataset, en viss modell eller båda; att den inte är “generaliserbar” till andra system; och att den därför representerar en trivial fara.
Den andra vanligaste kritiken är att den adversarial image attacken är ‘white box’, vilket innebär att man skulle behöva direkt tillgång till träningsmiljön eller datan. Detta är i själva verket en osannolik scenario i de flesta fall – till exempel om man ville utnyttja träningsprocessen för London Metropolitan Polices ansiktsigenkänningssystem, skulle man behöva hacka sig in i NEC, antingen med en konsol eller en yxa.
Den Långsiktiga “DNA”:n i Populära Datorseende-datasets
Med avseende på den första kritiken bör vi överväga inte bara att ett fåtal datorseende-datasets dominerar branschen år för år (t.ex. ImageNet för flera typer av objekt, CityScapes för körscener och FFHQ för ansiktsigenkänning); utan också att de, som enkla annoterade bilddata, är “plattformsoberoende” och högt överförbara.
Beroende på dess förmågor kommer varje datorseende-träningsarkitektur att hitta några funktioner av objekt och klasser i ImageNet-datasetet. Vissa arkitekturer kan hitta fler funktioner än andra, eller göra mer användbara kopplingar än andra, men alla bör hitta åtminstone de högsta nivåfunktionerna:

ImageNet-data, med det minsta antalet korrekta identifieringar – ‘hög nivå’ funktioner.
Det är dessa “hög nivå” funktioner som skiljer och “fingeravtrycker” ett dataset, och som är de tillförlitliga “krokar” som en långsiktig adversarial image attack-metod kan hänga på, och som kan sträcka sig över olika system och växa i takt med att det “gamla” datasetet förblir i nya forsknings- och produkter.
En mer avancerad arkitektur kommer att producera mer precisa och detaljerade identifieringar, funktioner och klasser:

Men ju mer en adversarial attack-generator förlitar sig på dessa lägre funktioner (t.ex. “Ung vit man” istället för “Ansikte”), desto mindre effektiv kommer den att vara i övergång eller senare arkitekturer som använder olika versioner av det ursprungliga datasetet – såsom en undermängd eller filterad uppsättning, där många av de ursprungliga bilderna från det fullständiga datasetet inte är närvarande:

Adversarial Attacker på “Zeroed”, Förförtränade Modeller
Vad gäller de fall där man bara laddar ner en förförtränad modell som ursprungligen tränades på ett mycket populärt dataset, och ger den helt ny data?
Modellen har redan tränats på (till exempel) ImageNet, och allt som återstår är vikterna, som kan ha tagit veckor eller månader att träna, och som nu är redo att hjälpa dig identifiera liknande objekt som de som fanns i den ursprungliga (nu frånvarande) datan.

Med den ursprungliga datan borttagen från träningsarkitekturen, är vad som återstår ‘förkastelsen’ av modellen att klassificera objekt på det sätt som den ursprungligen lärde sig att göra, vilket i princip kommer att orsaka att många av de ursprungliga ‘signaturerna’ reformerar och blir sårbara igen för samma gamla Adversarial Image Attack-metoder.
De vikterna är värdefulla. Utan datan eller vikterna har du i princip en tom arkitektur med ingen data. Du kommer att behöva träna den från scratch, till stor kostnad av tid och datorkraft, precis som de ursprungliga författarna gjorde (förmodligen på mer kraftfull hårdvara och med en högre budget än du har tillgänglig).
Problemet är att vikterna redan är ganska välformade och resistenta. Även om de kommer att anpassa sig något under träning, kommer de att bete sig liknande på din nya data som de gjorde på den ursprungliga datan, och producera signaturfunktioner som en adversarial attack-system kan koppla tillbaka på.
I det långa loppet bevarar detta också “DNA”:t för datorseende-datasets som är tolv eller fler år gamla, och som kan ha passerat genom en anmärkningsvärd evolution från öppen källkodsinsatser till kommersiella distributioner – även om den ursprungliga träningsdatan helt togs bort i början av projektet. Vissa av dessa kommersiella distributioner kan inte ske förrän om några år.
Ingen Vit Låda Behövs
Med avseende på den andra vanliga kritiken av adversarial image attack-system, har författarna till den nya artikeln funnit att deras förmåga att lura igenkänningsystem med utformade bilder av blommor är högt överförbar mellan flera arkitekturer.
Medan de observerar att deras ‘Universal NaTuralistic adversarial paTches’ (TnT) metod är den första som använder igenkännliga bilder (istället för slumpmässigt brus) för att lura bildigenkänningssystem, skriver författarna också:
‘[TnTs] är effektiva mot flera state-of-the-art-klassificerare, från WideResNet50 i ImageNet-datasetets storskaliga visuella igenkänning till VGG-face-modeller i PubFig-datasetets ansiktsigenkänning, i både riktade och oriktade attacker.
‘TnTs kan besitta: i) den naturalism som kan uppnås med utlösare som används i Trojan-attackmetoder; och ii) generaliserbarheten och överförbarheten av adversarial-exempel till andra nätverk.
‘Detta väcker säkerhets- och säkerhetsproblem för redan distribuerade DNNs, samt för framtida DNN-distributioner där angripare kan använda osynliga, naturliga objekt för att lura neuronnätverkssystem utan att manipulera modellen och riskera upptäckt.’
Författarna föreslår att konventionella motåtgärder, såsom att försämra Clean Acc. hos ett nätverk, teoretiskt sett kan ge något försvar mot TnT-patchar, men att ‘TnTs fortfarande kan lyckas kringgå denna SOTA-provbar försvarsmetod med de flesta försvarssystem som uppnår 0% robusthet’.
Möjliga andra lösningar inkluderar federerad inlärning, där provenansen av bidragande bilder skyddas, och nya tillvägagångssätt som direkt kan “kryptera” data under träningsfasen, såsom en nyligen föreslagen av Nanjing University of Aeronautics and Astronautics.
Även i dessa fall skulle det vara viktigt att träna på riktigt nya bilddata – eftersom de bilder och associerade annoteringar i den lilla skaran av de mest populära CV-datasetsen nu är så inbäddade i utvecklingscykler runt om i världen att de liknar programvara mer än data; programvara som ofta inte har uppdaterats på åratal.
Slutsats
Adversarial image attacker möjliggörs inte bara av öppen källkodspraxis för maskinlärning, utan också av en företagskultur för AI-utveckling som motiveras att återanvända etablerade datorseende-datasets av flera skäl: de har redan visat sig vara effektiva; de är mycket billigare än att “börja från scratch”; och de underhålls och uppdateras av framstående sinnen och organisationer inom akademi och industri, på nivåer av finansiering och personal som skulle vara svåra för ett enskilt företag att replikera.
Dessutom, i många fall där datan inte är original (till skillnad från CityScapes), samlades bilderna in före nyliga kontroverser kring integritet och datagenereringspraxis, vilket lämnar dessa äldre dataset i en sorts halvlaglig limbo som kan se ut som en “säker hamn” ur ett företags perspektiv.
TnT Attacks! Universal Naturalistic Adversarial Patches Against Deep Neural Network Systems är skriven av Bao Gia Doan, Minhui Xue, Ehsan Abbasnejad, Damith C. Ranasinghe från University of Adelaide, tillsammans med Shiqing Ma från datavetenskapsavdelningen vid Rutgers University.
Uppdaterad den 1 december 2021, 7:06, GMT+2 – korrigering av stavfel.


