
Andersons vinkel
Klistrar DALL-E 2 bara ihop saker utan att förstå deras relationer?

 Lägg till Unite.AI bland dina föredragna källor på Google

Viktiga punkterDALL-E 2 misslyckas med att återge grundläggande rumsliga relationer som 'i' eller 'på'…
Visa mer
- DALL-E 2 misslyckas med att återge grundläggande rumsliga relationer som 'i' eller 'på' i genererade bilder.
- Endast 22 % av DALL-E 2-bilderna matchade sina uppmaningar i en studie med 169 deltagare.
- Systemets relationsmisslyckanden förvärras när träningsdata saknar exempel på den avbildade händelsen.
En ny forskningsrapport från Harvard University tyder på att OpenAI:s uppmärksammade text-till-bild-ramverk DALL-E 2 har betydande svårigheter att reproducera även relationer som även spädbarn förstår mellan de element som det komponerar in i syntetiserade foton, trots den imponerande sofistikeringen av mycket av dess utdata.
Forskarna genomförde en användarstudie med 169 crowdsourced deltagare, som presenterades med DALL-E 2-bilder baserade på de mest grundläggande mänskliga principerna för relationssemantik, tillsammans med textprompten som skapade dem. När de tillfrågades om prompten och bilderna var relaterade, var mindre än 22% av bilderna uppfattade som relevanta för deras associerade prompter, i termer av de mycket enkla relationerna som DALL-E 2 tillfrågades att visualisera.

En skärmdump från försöken som genomfördes för den nya rapporten. Deltagarna fick i uppgift att välja alla bilder som matchade prompten. Trots upplysningen längst ner i gränssnittet hade samtliga bilder i själva verket skapats från den visade prompten, vilket deltagarna inte kände till. Källa: https://arxiv.org/pdf/2208.00005.pdf
Resultaten tyder också på att DALL-E:s uppenbara förmåga att förena disparata element kan minska när dessa element blir mindre sannolika att ha förekommit i den realvärldsträningsdata som driver systemet.
Till exempel fick bilder för prompten “barn rör en skål” en 87% överensstämmelsegrad (dvs. deltagarna klickade på de flesta bilderna som relevanta för prompten), medan liknande fotorealistiska återgivningar av “en apa rör en leguan” uppnådde endast 11% överensstämmelse:

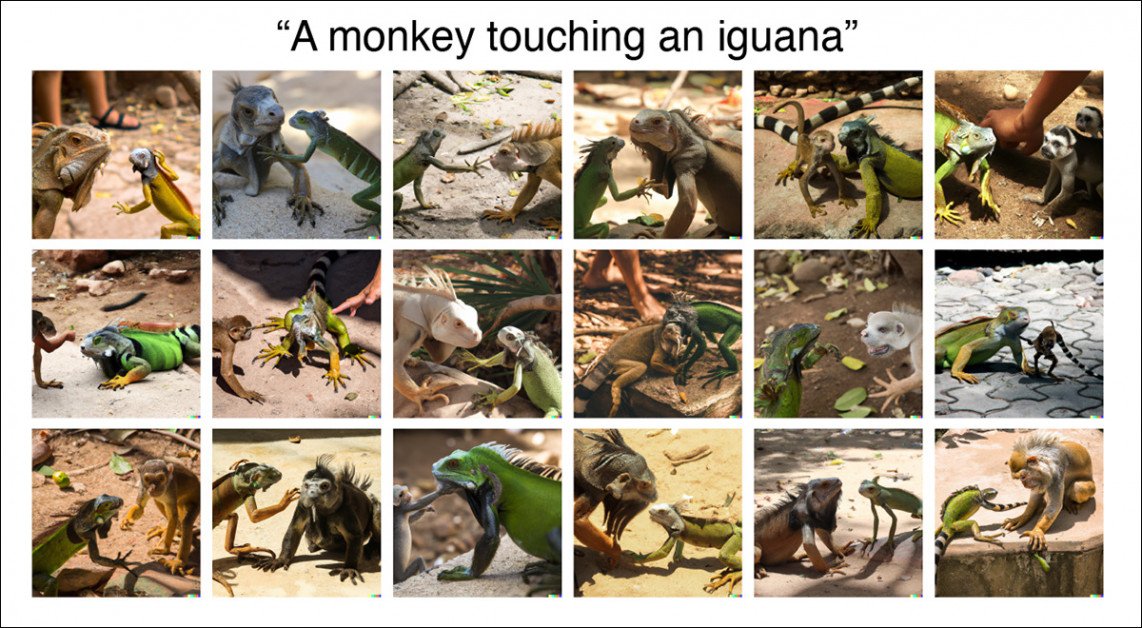
DALL-E har svårt att avbilda den osannolika händelsen av en ‘apa rör en leguan’, sannolikt eftersom detta är ovanligt eller snarare saknas helt i träningsmaterialet.
I det andra exemplet får DALL-E 2 ofta fel skala och till och med art, antagligen på grund av brist på realvärldsbilder som avbildar denna händelse. I kontrast är det rimligt att förvänta sig ett stort antal träningsfotografier relaterade till barn och mat, och att denna subdomän/klass är välutvecklad.
DALL-E:s svårighet att kombinera kraftigt kontrasterande bild-element tyder på att allmänheten för närvarande är så bedövad av systemets fotorealistiska och breda tolkningsförmåga att de inte har utvecklat ett kritiskt öga för de fall där systemet har effektivt bara “limmat” ett element starkt på ett annat, som i dessa exempel från den officiella DALL-E 2-sajten:
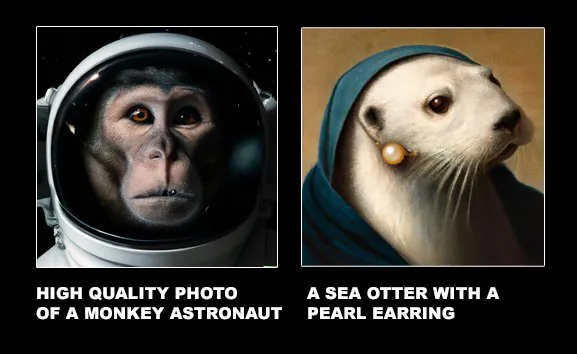
Klipp-och-klistra-syntes, från de officiella exemplen för DALL-E 2. Källa: https://openai.com/dall-e-2/
Den nya rapporten hävdar*:
‘Relational förståelse är en grundläggande komponent av mänsklig intelligens, som manifesterar sig tidigt i utvecklingen och beräknas snabbt och automatiskt i perceptionen.
‘DALL-E 2:s svårighet med till och med grundläggande rumsliga relationer (såsom i, på, under) tyder på att vad systemet än har lärt sig, har det inte lärt sig de typer av representationer som tillåter människor att så flexibelt och robust strukturera världen.
‘En direkt tolkning av denna svårighet är att system som DALL-E 2 inte har relationell sammansättning.’
Författarna föreslår att textstyrda bildgenereringssystem som DALL-E-serien kunde dra nytta av att utnyttja algoritmer som är vanliga inom robotik, som modellerar identiteter och relationer samtidigt, på grund av behovet av att agenten faktiskt interagerar med miljön snarare än att bara fabricera en blandning av olika element.
En sådan metod, med titeln CLIPort, använder samma CLIP-mekanism som tjänar som en kvalitetsbedömningsenhet i DALL-E 2:
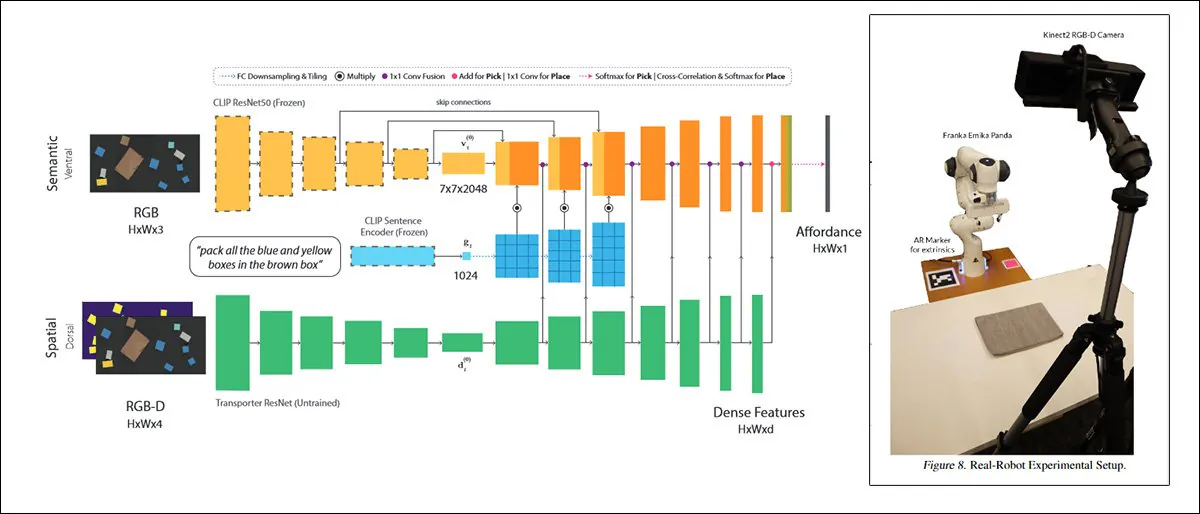
CLIPort, ett samarbete 2021 mellan University of Washington och NVIDIA, använder CLIP i en kontext så praktisk att systemen som tränas på det nödvändigtvis måste utveckla en förståelse för fysiska relationer, en drivkraft som saknas i DALL-E 2 och liknande fantasifulla bildsyntesramverk. Källa: https://arxiv.org/pdf/2109.12098.pdf
Författarna föreslår dessutom ‘en annan trolig uppgradering’ kan vara att arkitekturen för bildsyntesystem som DALL-E inkorporerar multiplicerande effekter i ett enda beräkningslager, vilket tillåter beräkning av relationer på ett sätt som inspireras av informationsbearbetningsförmågorna i biologiska system.
Den nya rapporten har titeln Testing Relational Understanding in Text-Guided Image Generation, och kommer från Colin Conwell och Tomer D. Ullman vid Harvard’s Department of Psychology.
Bortom tidig kritik
I en kommentar om “trolleritrick” bakom realismen och integriteten i DALL-E 2:s utdata, noterar författarna tidigare arbeten som har funnit brister i DALL-E-liknande generativa bildsystem.
I juni i år noterade UoC Berkeley svårigheten DALL-E har med att hantera reflektioner och skuggor; samma månad undersökte en studie från Korea unikheten och originalitet hos DALL-E 2-liknande utdata med ett kritiskt öga; en preliminär analys av DALL-E 2-bilder, strax efter lanseringen, från NYU och University of Texas, fann olika problem med sammansättning och andra viktiga faktorer i DALL-E 2-bilder; och förra månaden ett samarbete mellan University of Illinois och MIT erbjöd förslag för arkitektoniska förbättringar av sådana system i termer av sammansättning.
Forskarna noterar dessutom att DALL-E-luminarier som Aditya Ramesh har medgivit ramverkets problem med bindning, relativ storlek, text och andra utmaningar.
Utvecklarna bakom Google’s rivaliserande bildsyntesystem Imagen har också föreslagit DrawBench, ett nytt jämförelsesystem som mäter bilders träffsäkerhet över ramverk med olika metriker.
I stället föreslår författarna till den nya rapporten att ett bättre resultat kan uppnås genom att ställa mänsklig uppskattning – snarare än interna, algoritmiska metriker – mot de resulterande bilderna, för att fastställa var svagheterna ligger, och vad som kan göras för att mildra dem.
Studien
För detta ändamål baserar det nya projektet sin metod på psykologiska principer, och försöker att dra sig tillbaka från den nuvarande vågen av intresse i prompt engineering (vilket i själva verket är en eftergift till DALL-E 2:s brister, eller något liknande system), för att undersöka och potentiellt åtgärda begränsningarna som gör sådana “workarounds” nödvändiga.
Rapporten hävdar:
‘Det aktuella arbetet fokuserar på en uppsättning 15 grundläggande relationer som tidigare beskrivits, undersökts eller föreslagits i den kognitiva, utvecklings- eller lingvistiska litteraturen. Uppsamlingen innehåller både grundade rumsliga relationer (t.ex. ’X på Y’), och mer abstrakta agensrelationer (t.ex. ’X hjälper Y’).
‘Prompten är avsiktligt enkla, utan attributkomplexitet eller utarbetning. Det vill säga, istället för en prompt som ’en åsna och en bläckfisk leker. Åsnan håller i en repända, bläckfisken håller i den andra. Åsnan håller i repet med munnen. En katt hoppar över repet’, använder vi ’en låda på en kniv’.
‘Enkelheten fångar fortfarande en bred uppsättning relationer från hela underområden av mänsklig psykologi, och gör eventuella modellmisslyckanden mer slående och specifika.’
För sin studie rekryterade författarna 169 deltagare från Prolific, alla belägna i USA, med en genomsnittsålder på 33, och 59% kvinnor.
Deltagarna visades 18 bilder organiserade i en 3×6-rutnät med prompten överst, och en varning längst ner på gränssnittet som angav att alla, några eller inga av bilderna kunde ha genererats från den visade prompten, och de fick sedan i uppgift att välja de bilder som de trodde var relaterade på detta sätt.
Bilderna som presenterades för individerna baserades på lingvistisk, utvecklings- och kognitiv litteratur, och bestod av en uppsättning åtta fysiska och sju “agensrelationer” (detta kommer att bli tydligt om en stund).
Fysiska relationer
i, på, under, täcker, nära, skymd av, hängande över, och bunden till.
Agensrelationer
knuffar, drar, rör, slår, sparkar, hjälper, och hindrar.
Alla dessa relationer hämtades från tidigare nämnda forskningsområden utanför datavetenskap.
Tolv entiteter härleddes för användning i prompten, med sex objekt och sex agenter:
Objekt
låda, cylinder, filt, skål, tekopp, och kniv.
Agenter
man, kvinna, barn, robot, apa, och leguan.
(Forskarna medger att att inkludera leguan, inte en huvudaktör i torr sociologisk eller psykologisk forskning, var ‘en liten bonus’)
För varje relation skapades fem olika prompter genom att slumpmässigt sampla två entiteter fem gånger, vilket resulterade i 75 totala prompter, var och en av vilka skickades till DALL-E 2, och för var och en av vilka de ursprungliga 18 bilderna användes, utan variationer eller andra chanser tillåtna.
Resultat
Rapporten hävdar*:
‘Deltagarna rapporterade i genomsnitt en låg mängd överensstämmelse mellan DALL-E 2:s bilder och prompterna som användes för att generera dem, med ett genomsnitt på 22,2% [18,3, 26,6] över de 75 olika prompterna.
‘Agensprompter, med ett genomsnitt på 28,4% [22,8, 34,2] över 35 prompter, genererade högre överensstämmelse än fysiska prompter, med ett genomsnitt på 16,9% [11,9, 23,0] över 40 prompter.’

Resultat från studien. Svarta punkter visar alla prompter, där varje punkt motsvarar en enskild prompt. Färgerna skiljer mellan prompter om agenter och fysiska föremål.
För att jämföra skillnaden mellan mänsklig och algoritmisk perception av bilderna, körde forskarna sina återgivningar genom OpenAI:s öppen källkods ViT-L/14 CLIP-baserade ramverk. Genomsnittlig av poängen fann de en “måttlig relation” mellan de två resultatsatserna, vilket kanske är förvånande, med tanke på den utsträckning till vilken CLIP själv hjälper till att generera bilderna.

Resultat från CLIP (ViT-L/14) jämförelse mot mänskliga svar.
Forskarna föreslår att andra mekanismer inom arkitekturen, kanske i kombination med en slumpmässig övervikt (eller brist) på data i träningsuppsättningen, kan förklara varför CLIP kan känna igen DALL-E:s begränsningar utan att alltid kunna göra något åt problemet.
Författarna drar slutsatsen att DALL-E 2 endast har en nominell förmåga, om någon, att reproducera bilder som inkorporerar relationell förståelse, en grundläggande aspekt av mänsklig intelligens som utvecklas tidigt.
‘Föreställningen att system som DALL-E 2 inte har sammansättning kan komma som en överraskning för någon som har sett DALL-E 2:s slående rimliga svar på prompter som “en teckning av en liten daikonrättika i balettkjol som rastar en pudel”. Prompter som dessa genererar ofta en rimlig approximation av ett sammansatt koncept, med alla delar av prompten närvarande, och närvarande på rätt platser.
‘Sammansättning kräver dock inte bara förmågan att limma saker ihop – även saker som du aldrig har sett ihop tidigare. Sammansättning kräver en förståelse av de regler som binder saker samman. Relationer är sådana regler.’
Man biter T-Rex
Åsikt När OpenAI öppnar upp för ett större antal användare efter sin nyligen beta-monetisering av DALL-E 2, och eftersom man nu måste betala för de flesta genereringarna, kan DALL-E 2:s brister i relationell förståelse bli mer uppenbara när varje “misslyckat” försök har en ekonomisk tyngd, och återbetalningar inte är tillgängliga.
De som fick en inbjudan tidigare har haft tid (och, tills nyligen, större möjlighet att leka med systemet) att observera några av “relationsglitcharna” som DALL-E 2 kan producera.
Till exempel, för en Jurassic Park-fan, är det mycket svårt att få en dinosaurie att jaga en person i DALL-E 2, även om konceptet “jaga” inte verkar vara i DALL-E 2:s censursystem, och även om den långa historien av dinosauriefilmer borde ge tillräckligt med träningsexempel (i alla fall i form av trailers och publicitybilder) för denna annars omöjliga möte mellan arter.
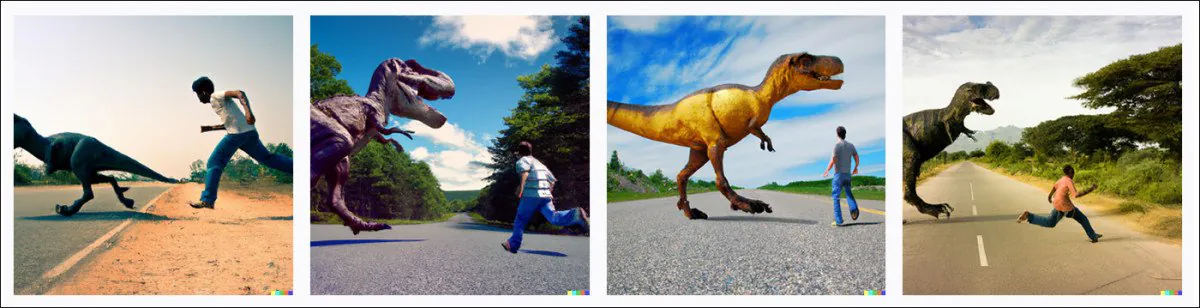
Ett typiskt DALL-E 2-svar på prompten ‘Ett färgfoto av en T-Rex som jagar en man nerför en väg’. Källa: DALL-E 2
Jag har funnit att bilderna ovan är typiska för variationer på ‘[dinosaurie] jagar [en person]’-promptdesign, och att ingen mängd utarbetning i prompten kan få T-Rexen att faktiskt lyda. I den första och andra bilden jagar mannen (mer eller mindre) T-Rexen; i den tredje, närmar han sig den med en nonchalant försummelse av säkerheten; och i den sista bilden, verkar han jogga parallellt med det stora djuret. Över cirka 10-15 försök på detta tema, har jag funnit att dinosaurien är lika distraherad.
Det kan vara så att den enda träningsdata som DALL-E 2 kunde komma åt var i linje med ‘man kämpar mot dinosaurie’, från publicitybilder för äldre filmer som En miljon år före vår tid (1966), och att Jeff Goldblums berömda flykt från rovdjurets kung är bara ett undantag i den lilla mängden data.
* Min konvertering av författarnas inline-citat till hyperlänkar.
Publicerad första gången den 4 augusti 2022.





