AGI și viitorul AI
Ce este testul Turing și de ce contează?

 Adaugă Unite.AI la sursele tale preferate pe Google
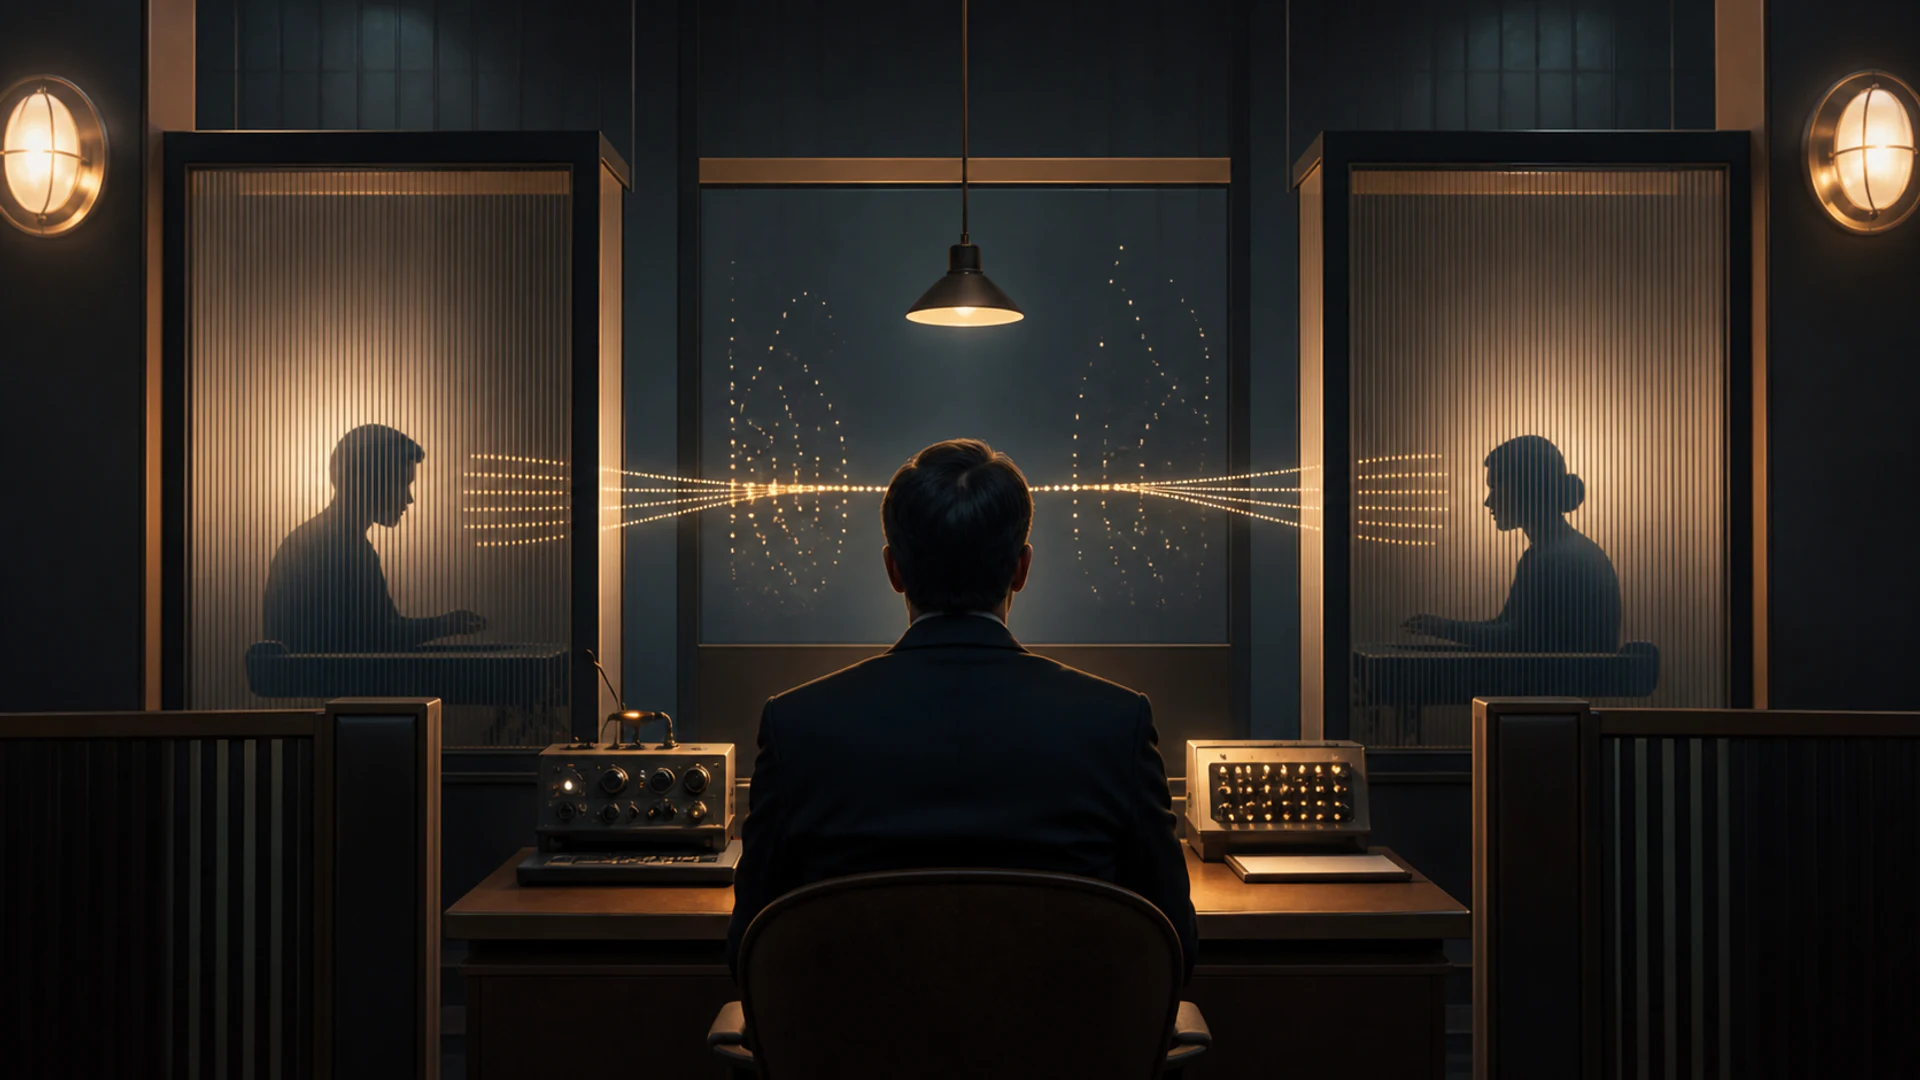
Testul Turing a luat naștere din lucrarea lui Alan Turing din 1950, “Computing Machinery and Intelligence”. În loc să încerce să definească gândirea, Turing a propus un joc de imitație: un interogator uman schimbă mesaje scrise cu participanți nevăzuți și judecă care este om și care este mașină.
Testul rămâne influent deoarece transformă o întrebare filozofică abstractă într-o interacțiune observabilă. Are totuși limitări: a părea uman într-o conversație nu înseamnă a fi sincer, informat, sigur, conștient sau, în general, inteligent.
Idei principale
- Jocul original de imitație al lui Turing este un test comportamental bazat pe text, nu o listă de verificare a proprietăților cognitive interne.
- Rezultatele depind de evaluator, de prompt, de durată, de instrucțiunile participanților și de regula de punctare.
- Un model poate imita conversația umană în timp ce generează fapte false sau eșuează la teste simple de robustețe.
- Evaluarea modernă necesită metrici de sarcină, teste adversariale, revizuire umană și dovezi specifice riscului, pe lângă conversație.
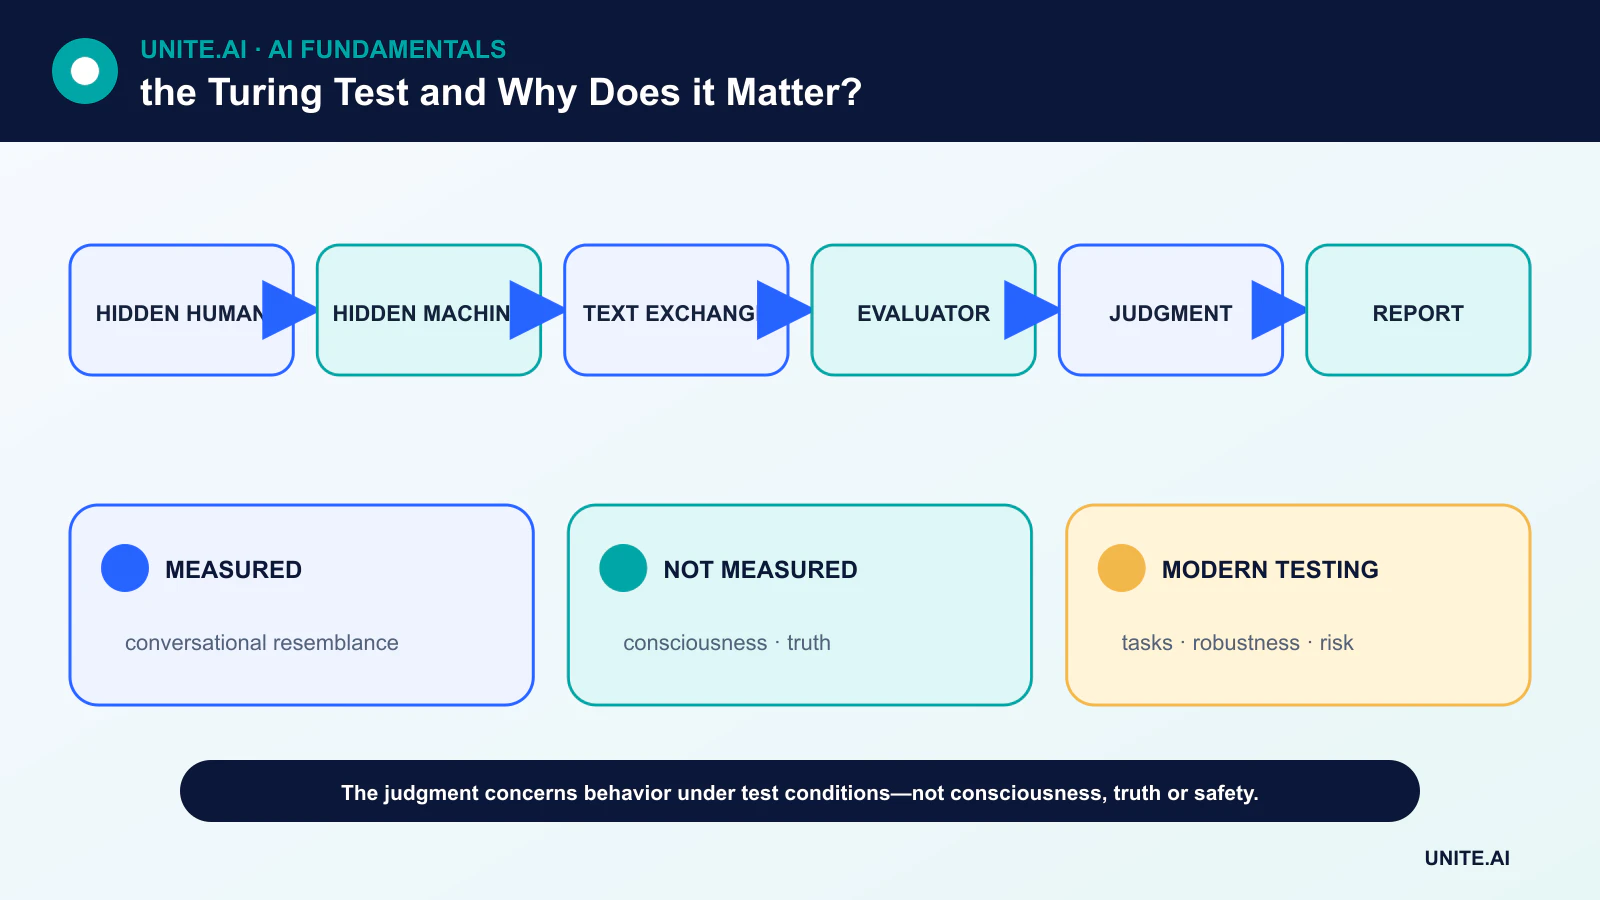
Jocul de imitație al lui Turing
În configurația inițială, un interogator comunica la distanță, astfel încât vocea și aspectul să nu dezvăluie identitatea. Turing a întrebat dacă o mașină ar putea performa suficient de bine în joc încât un evaluator să nu poată distinge în mod fiabil între ea și o persoană.
Această încadrare operațională a evitat necesitatea de a stabili o definiție unică a gândirii. Nu a susținut că fiecare schimb convingător dovedește inteligență și nu a specificat un prag universal de trecere aplicabil oricărei demonstrații ulterioare de chatbot.
Ce măsoară de fapt un rezultat
Un test măsoară indistincția comportamentală în condiții definite. Conversații scurte, judecători neexperimentați sau prompturi alese de dezvoltatorul sistemului pot face sarcina mai ușoară. Un raport riguros ar trebui să dezvăluie selecția transcrierilor, numărul și profilul judecătorilor, oamenii de comparație, limita de timp și metoda statistică.
Un sistem poate, de asemenea, să exploateze așteptările: evitarea, umorul, erorile tipografice și jocul de rol pot părea umane fără a demonstra raționament fiabil. În schimb, un răspuns uman neobișnuit de formal poate fi clasificat greșit ca generat de mașină.
Ce nu stabilește testul Turing
Testul nu măsoară direct conștiința, experiența subiectivă, acuratețea factuală, înțelegerea cauzală sau agenția morală. Nu dezvăluie datele de antrenament, arhitectura modelului sau modurile de eșec în afara conversației. De asemenea, oferă puține informații despre inteligența non‑lingvistică, cum ar fi manipularea fizică.
Sistemele moderne de limbaj sunt construite cu rețele neuronale transformer și învățare profundă, dar ieșirile lor fluente pot fi generate în continuare din structuri statistice învățate, mai degrabă decât dintr-un model al lumii verificat.
Cum extinde evaluarea modernă a IA întrebarea
Evaluarea contemporană folosește seturi de sarcini reținute, incertitudine calibrată, teste de robustețe, red‑teaming, verificări ale factualității și studii de preferință umană. O metrică de clasificare a textului poate testa un comportament definit, în timp ce evaluarea bazată pe scenarii poate verifica dacă un sistem respectă politica sub presiune.
Niciun benchmark unic nu surprinde fiecare implementare. Contaminarea testului poate inflata scorurile, iar benchmark‑urile statice încurajează supraînvățarea. Evaluarea ar trebui repetată pe măsură ce modelele, datele, prompturile, instrumentele și populațiile de utilizatori se schimbă.
De ce testul este încă relevant
Testul Turing a anticipat o lecție de bază a evaluării IA: să se evalueze capacitatea observabilă în loc să se bazeze pe afirmații despre o esență internă. De asemenea, ne obligă să ne întrebăm ce comportamente umane contează ca dovezi și cum o configurație experimentală modelează o concluzie.
Cel mai bun mod de utilizare modernă este ca reper istoric și conceptual. Trecerea unui joc de imitație poate fi interesantă, dar deciziile de implementare necesită dovezi legate de sarcina reală, utilizatorii afectați și daunele previzibile.
Ce măsoară testul Turing
Jocul de imitație al lui Alan Turing a întrebat dacă un interogator care comunică prin text ar putea distinge în mod fiabil o mașină de o persoană. A transformat o dezbatere abstractă despre dacă mașinile gândesc într-un experiment conversațional observabil. Testul depinde de participanți, durată, protocol, subiecte și regula de judecare; nu există un scor universal unic. A trece înseamnă a produce răspunsuri asemănătoare cu cele umane în acea configurație. Nu măsoară direct acuratețea factuală, raționamentul, conștiința, autonomia, percepția, întruparea, fiabilitatea sau comportamentul benefic în lumea reală.
Imitația umană poate recompensa evitarea, persona, greșelile, umorul sau manipularea. Un judecător poate confunda un om cu o mașină sau poate fi influențat de așteptări, limbă și context cultural. Conversațiile scurte permit trucuri care eșuează în interacțiuni prelungite. În schimb, un sistem extrem de util pentru matematică, traducere sau modelare de proteine ar putea eșua deoarece nu pretinde a fi uman. Astfel, testul măsoară o capacitate socială și lingvistică modelată de evaluator, nu un ordin complet al inteligenței.
Modele de limbaj moderne și evaluare mai riguroasă
Modelele mari de limbaj pot menține un dialog fluent prin prezicerea secvențelor din date de antrenament ample și ajustări ulterioare, dar fluenta este o dovadă slabă a adevărului sau înțelegerii. Modelele memorate, accesul la instrumente, prompturi ascunse, latența și setările de eșantionare afectează rezultatele. Evaluările controlate ar trebui să dezvăluie modelul și protocolul, să prevină scurgerea informațiilor, să includă întrebări adversariale și de domeniu și să evalueze incertitudinea și citarea. O demonstrație aleasă din conversații de succes nu poate estima fiabilitatea pe întreaga distribuție de utilizare.
Evaluarea modernă este multidimensională: acuratețea sarcinii, calibrul, robustețea, consistența pe termen lung, siguranța, părtinirea, confidențialitatea, securitatea, eficiența și rezultatele umane. Testele comportamentale ar trebui completate de dovezi de proces, red‑teaming, benchmark‑uri reproductibile și monitorizare în lumea reală. Benchmark‑urile pot satura sau pot intra în datele de antrenament, așa că sunt necesare seturi de testare private și actualizate. Pentru sistemele care acționează, se evaluează permisiunile instrumentelor, recuperarea și consecințele separat de calitatea conversației.
De ce testul este încă relevant
Testul Turing rămâne important din punct de vedere istoric deoarece se concentrează pe comportament și pe dificultatea definirii inteligenței. De asemenea, ridică întrebări continue despre antropomorfizare și înșelăciune. Interfețele ar trebui să identifice agenții sintetici în loc să trateze identitatea greșită ca succes, în special în contexte cu consecințe. Folosiți testul ca lentilă filozofică și ca o evaluare conversațională, nu ca certificare a inteligenței generale sau a personalității. Întrebarea esențială de implementare este ce poate face sistemul în mod fiabil, pe baza căror dovezi și limite, și cine este responsabil când eșuează.
Exemplu practic: o evaluare conversațională controlată
Evaluatorii compară oamenii și mai multe sisteme AI în conversații textuale cu durată, subiecte, limbă și identități ascunse fixe. Judecătorii înregistrează dacă cred că fiecare participant este uman și, de asemenea, evaluează factualitatea, consistența, utilitatea, incertitudinea și manipularea. Mai mulți judecători și conversații estimează variația, iar protocolul împiedică dezvoltatorii de modele să selecteze transcrieri favorabile. Clasificarea greșită a unui om oferă o bază necesară pentru interpretarea rezultatului.
Un sistem care păcălește judecătorii, dar inventează fapte, nu este declarat inteligent în mod general, în timp ce un model specialist clar dezvăluit poate fi extrem de util în ciuda eșecului la imitație. Rezultatele includ promptul, modelul, sampler‑ul, accesul la instrumente și caracteristicile judecătorului. Experimentul este încadrat ca un test al conversației asemănătoare cu cea umană. Deciziile de implementare folosesc dovezi separate pentru corectitudinea sarcinii, siguranță, confidențialitate și recuperare, iar interfața identifică agentul în loc să transforme înșelăciunea în obiectivul produsului.
Dovezi de implementare și pregătire operațională
Decizia de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul operațional, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazurile obișnuite, condițiile de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperea dependenței, utilizarea abuzivă și grupurile sau mediile care ar putea fi subservite. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag pentru ca un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare în etape, păstrați o soluție de rezervă sigură și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și responsabilul de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
A reușit vreun AI să treacă definitiv testul Turing?
Nu există o autoritate oficială unică pentru test sau un protocol acceptat universal. Demonstrațiile publice folosesc reguli diferite, astfel încât afirmațiile de „trecere” nu sunt direct comparabile.
Eșecul la test dovedește că un sistem este uninteligent?
Nu. Un sistem specializat poate fi extrem de capabil fără să imite stilul conversațional uman.
Referințe principale