
Fundamentele AI
Ce este validarea încrucișată? Cum să estimezi în mod fiabil performanța unui model
Cross-validation rotește în mod repetat plierile reținute, permițând echipelor să estimeze performanța și variabilitatea atunci când o singură divizare de validare ar fi instabilă. Acest ghid explică mecanismul, compromisurile, evaluarea și controalele care contează în practică.

 Adaugă Unite.AI la sursele tale preferate pe Google
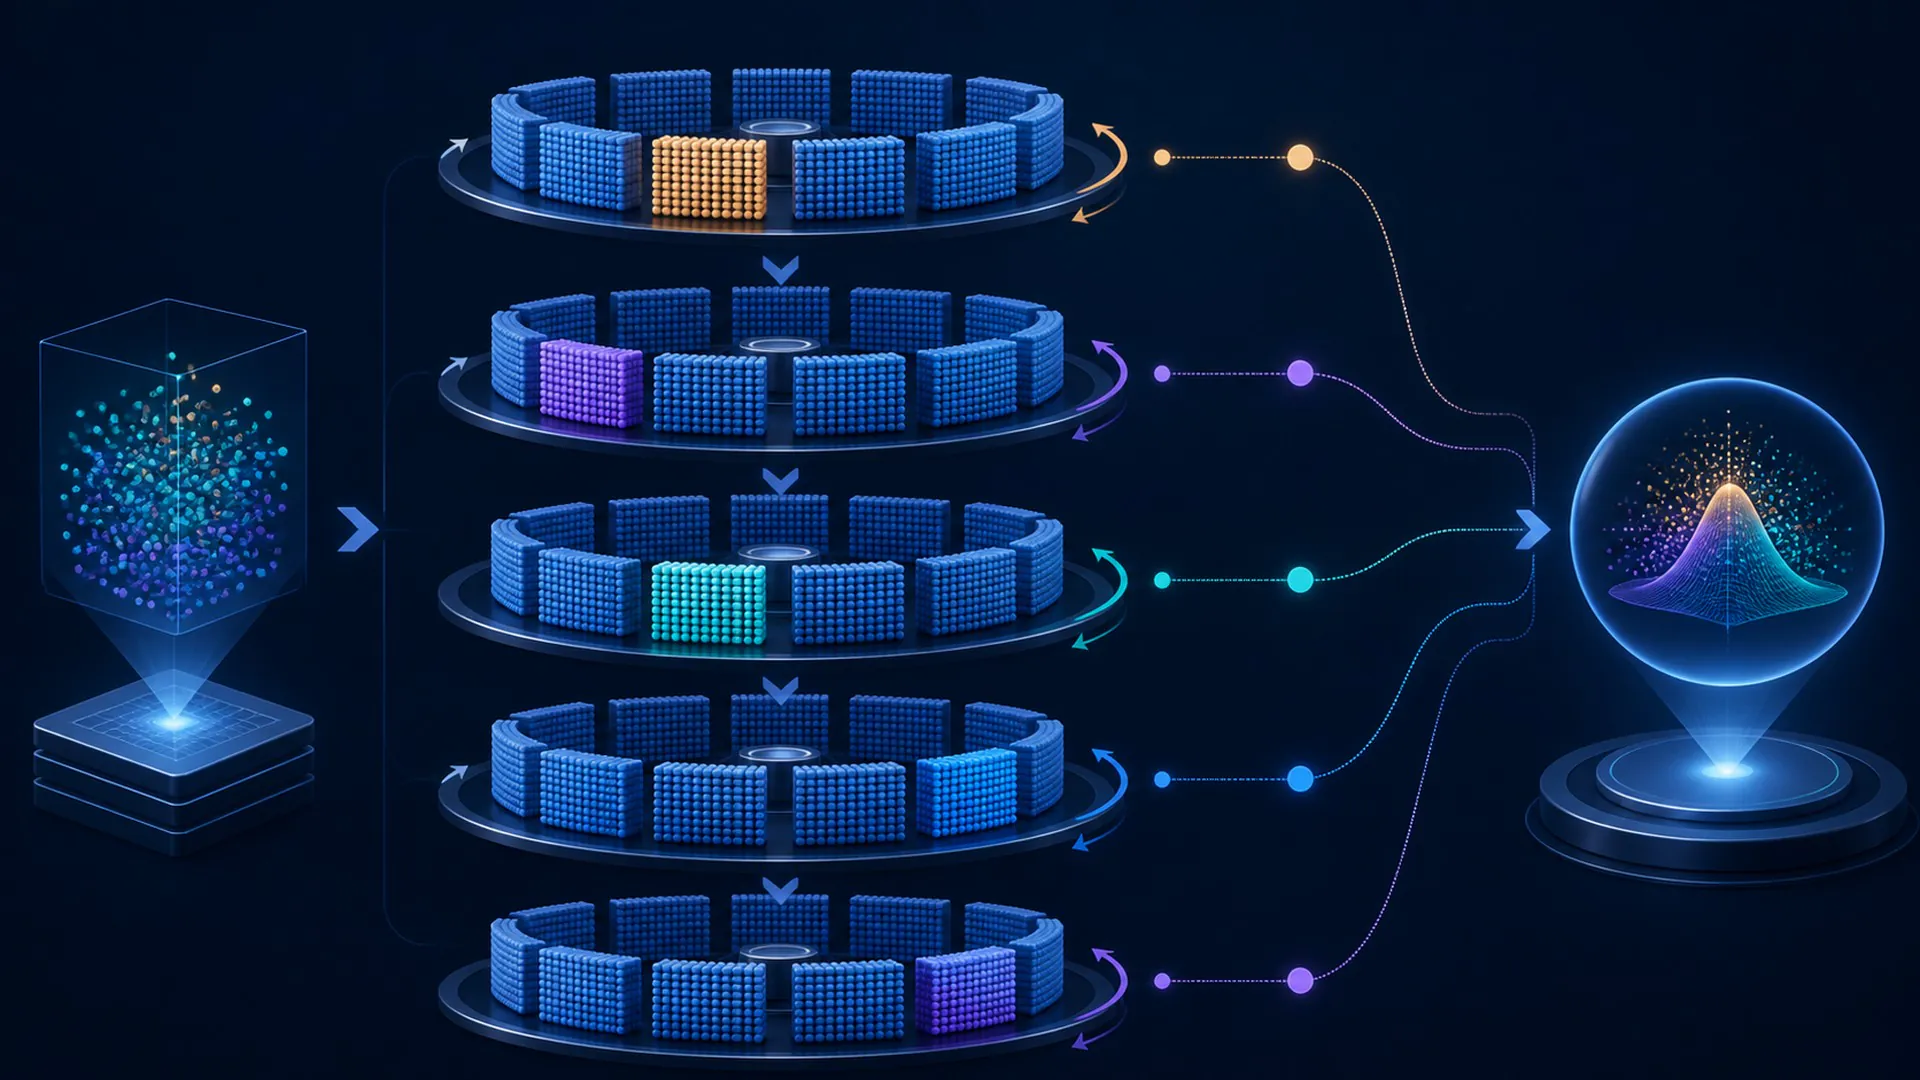
Validarea încrucișată rotește în mod repetat grupurile reținute, permițând echipelor să estimeze performanța și variabilitatea atunci când o singură împărțire de validare ar fi instabilă.
Validarea încrucișată merită o explicație precisă deoarece denumirea sa identifică un flux specific de informații, o alegere de antrenament, un mecanism de rulare sau o limită de guvernanță. Tratarea ei ca sinonim pentru „inteligență artificială avansată” face ca afirmațiile să fie imposibil de testat. Acest ghid urmărește conceptul de la intrările și presupunerile sale până la rezultatul observabil, apoi testează scurtătura cea mai probabil confundată cu aceasta.
Validarea încrucișată: definiție, limită și scop
Validarea încrucișată rotește în mod repetat grupurile reținute, permițând echipelor să estimeze performanța și variabilitatea atunci când o singură împărțire de validare ar fi instabilă. Definiția conține trei angajamente practice: există o intrare identificabilă, o transformare sau decizie caracteristică validării încrucișate și un rezultat care poate fi evaluat în raport cu un obiectiv declarat. Dacă unul dintre aceste elemente lipsește, eticheta poate descrie o aspirație mai degrabă decât un mecanism implementat.
Învățarea statistică transformă eșantioane finite în afirmații despre datele viitoare. Împărțirea, optimizarea, regularizarea, metricile și monitorizarea sunt, prin urmare, părți ale unei singure probleme de generalizare, nu tehnici izolate din manuale. Pentru validarea încrucișată, această perspectivă de sistem contează deoarece performanța poate fi determinată de datele înconjurătoare, interfețe, hardware, permisiuni și oameni, chiar și atunci când modelul de bază rămâne neschimbat. O explicație utilă separă astfel comportamentul învățat al modelului de produsul care decide când, unde și cu ce autoritate este utilizat acel comportament.
Scurtătura înșelătoare cea mai apropiată este testarea multor modele pe setul final de testare. Aceasta poate împărtăși o caracteristică vizibilă cu validarea încrucișată, totuși modifică povestea cauzală: dovezi diferite ar stabili succesul, resurse diferite ar domina costul și controale diferite ar preveni daunele. Prin urmare, limita este operațională, nu terminologică.
O hartă operațională în cinci etape a validării încrucișate
Diagrama este o hartă cauzală compactă pentru validarea încrucișată, nu o afirmație că fiecare implementare folosește cinci componente software. Unele sisteme combină etapele, altele le repetă într-o buclă. Harta rămâne utilă deoarece obligă fiecare schimbare în informație sau autoritate să aibă un responsabil, o intrare, o ieșire și un test.
1. Împărțirea datelor în grupuri adecvate: intrare și presupuneri în validarea încrucișată
În această etapă a validării încrucișate, sistemul trebuie să împartă datele în grupuri adecvate. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că modificarea a fost validă. Un evaluator ar trebui să poată diferenția această operație de testarea multor modele pe setul final de testare și să reproducă rezultatul în aceleași condiții declarate.
Transferul către această etapă a validării încrucișate începe cu obiectivul declarat și ar trebui să se încheie cu un rezultat care poate susține antrenarea pe toate, cu excepția unui grup. Înregistrează incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Această urmă este locul în care echipele pot detecta dacă grupurile aleatorii obișnuite sunt nevalide atunci când datele prezintă dependență temporală, de grup sau spațială, înainte ca aceeași slăbiciune să ajungă la un rezultat consecvent.
2. Antrenarea pe toate, cu excepția unui grup: reprezentare sau decizie în validarea încrucișată
În această etapă a validării încrucișate, sistemul trebuie să antreneze pe toate, cu excepția unui grup. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că modificarea a fost validă. Un evaluator ar trebui să poată diferenția această operație de testarea multor modele pe setul final de testare și să reproducă rezultatul în aceleași condiții declarate.
Transferul către această etapă a validării încrucișate începe cu împărțirea datelor în grupuri adecvate și ar trebui să se încheie cu un rezultat care poate susține evaluarea pe grupul reținut. Înregistrează incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Această urmă este locul în care echipele pot detecta dacă grupurile aleatorii obișnuite sunt nevalide atunci când datele prezintă dependență temporală, de grup sau spațială, înainte ca aceeași slăbiciune să ajungă la un rezultat consecvent.
3. Evaluarea pe pliul exclus: Transformare distinctivă în validarea încrucișată
În această etapă a validării încrucișate, sistemul trebuie să evalueze pe pliul exclus. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că modificarea a fost validă. Un revizor ar trebui să poată distinge această operație de testarea multor modele pe setul final de testare și să reproducă rezultatul în aceleași condiții declarate.
Transferul în această etapă a validării încrucișate începe cu antrenarea pe toate pliurile, cu excepția unuia, și ar trebui să se încheie cu un rezultat care să permită rotirea până când fiecare pli a servit ca validare. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Această urmă este locul în care echipele pot detecta dacă pliurile aleatorii obișnuite sunt nevalide atunci când datele au dependență temporală, de grup sau spațială, înainte ca aceeași slăbiciune să ajungă la un rezultat semnificativ.
4. Rotirea până când fiecare pli a servit ca validare: Constrângere și limită de verificare în validarea încrucișată
În această etapă a validării încrucișate, sistemul trebuie să rotească până când fiecare pli a servit ca validare. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că modificarea a fost validă. Un revizor ar trebui să poată distinge această operație de testarea multor modele pe setul final de testare și să reproducă rezultatul în aceleași condiții declarate.
Transferul în această etapă a validării încrucișate începe cu evaluarea pe pliul exclus și ar trebui să se încheie cu un rezultat care să permită agregarea scorurilor și a variației. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Această urmă este locul în care echipele pot detecta dacă pliurile aleatorii obișnuite sunt nevalide atunci când datele au dependență temporală, de grup sau spațială, înainte ca aceeași slăbiciune să ajungă la un rezultat semnificativ.
5. Agregarea scorurilor și a variației: Ieșire, feedback și regulă de oprire în validarea încrucișată
În această etapă a validării încrucișate, sistemul trebuie să agregheze scorurile și variația. Întrebarea utilă nu este doar dacă operația are loc, ci ce informații consumă, ce stare modifică și ce dovezi atestă că modificarea a fost validă. Un revizor ar trebui să poată distinge această operație de testarea multor modele pe setul final de testare și să reproducă rezultatul în aceleași condiții declarate.
Transferul în această etapă a validării încrucișate începe cu rotirea până când fiecare pli a servit ca validare și ar trebui să se încheie cu un rezultat care să permită monitorizarea sau o decizie finală. Înregistrați incertitudinea, alternativele respinse, utilizarea resurselor și orice control uman sau software aplicat la limită. Această urmă este locul în care echipele pot detecta dacă pliurile aleatorii obișnuite sunt nevalide atunci când datele au dependență temporală, de grup sau spațială, înainte ca aceeași slăbiciune să ajungă la un rezultat semnificativ.
Citiți harta validării încrucișate înainte pentru a înțelege producția și înapoi pentru a diagnostica eșecul. Analiza în avans întreabă cum o etapă alimentează pe cea următoare. Analiza înapoi începe de la un rezultat incorect, lent, costisitor sau nesigur și urmărește ce presupunere anterioară l-a permis. Calea inversă este adesea locul în care o echipă descoperă că eroarea decisivă a apărut înainte ca modelul să producă ceva.
Un exemplu practic de validare încrucișată
Un set de date medicale mic poate utiliza pliuri grupate astfel încât înregistrările fiecărui pacient să rămână împreună.
Acest exemplu este informativ deoarece validarea încrucișată poate fi legată de intrări observabile, stări intermediare și un rezultat, în loc să fie evaluată printr-o demonstrație finisată. Un test riguros ar construi cazuri obișnuite, dificile și în mod deliberat înșelătoare în jurul scenariului, ar păstra o linie de bază fără tehnică și ar înregistra atât performanța medie, cât și severitatea eșecurilor individuale.
Modificați o presupunere în exemplul de validare încrucișată și repetați analiza. Eliminați o intrare obligatorie, introduceți un semnal contradictoriu, limitați calculul, modificați populația de utilizatori sau forțați sistemul să se abțină. Un mecanism care reușește doar într-o demonstrație atent aranjată nu a demonstrat că se generalizează în mediul de operare.
Validarea încrucișată vs. cea mai comună scurtătură a sa
Validarea încrucișată este adesea redusă la testarea multor modele pe setul final de testare. Această reducere elimină limita care definește conceptul. Poate determina cumpărătorii să compare produse neomogene, cercetătorii să exagereze ceea ce demonstrează un experiment și operatorii să monitorizeze semnalul greșit după implementare.
| Lentilă | Răspuns practic |
|---|---|
| Definiție | Validarea încrucișată rotește în mod repetat subîmpărțirile reținute, permițând echipelor să estimeze performanța și variabilitatea atunci când o singură divizare de validare ar fi instabilă. |
| Confuzie | testarea multor modele pe setul final de testare. |
| Risc | împărțirile aleatorii obișnuite sunt nevalide când datele au dependență temporală, de grup sau spațială. |
Comparația ar trebui să identifice și unitatea de analiză. Un articol despre validarea încrucișată poate izola un model sau un algoritm, în timp ce un serviciu implementat adaugă recuperare, rutare, caching, politici, identitate, interfețe de utilizator și monitorizare. Două produse pot folosi același termen de titlu, implementând părți diferite ale acelui stack. Întrebați care componentă efectuează transformarea definitorie și care alte componente sunt necesare pentru rezultatul raportat.
De ce contează validarea încrucișată în sistemele AI actuale
Validarea încrucișată este importantă acum deoarece sistemele AI primesc contexte mai mari, mai multe modalități, mai multă putere de calcul la rulare, acces la instrumente mai larg și conexiuni mai profunde cu deciziile organizaționale. În aceste condiții, ceea ce odată părea un detaliu de cercetare poate determina latența, securitatea, accesibilitatea, costul de mediu, calitatea produsului sau responsabilitatea legală.
Măsura relevantă nu este dacă validarea încrucișată poate produce un singur rezultat impresionant. Este dacă tehnica îmbunătățește un rezultat care contează în condiții reprezentative și o face mai eficient decât un punct de referință mai simplu. Raportați distribuții, categorii de eșec, latență la coadă, utilizarea resurselor și subgrupurile afectate în loc să comprimați fiecare rezultat într-o singură medie.
Alegeți proceduri din structura datelor și costul deciziei. Păstrați grupurile și timpul, cuantificați incertitudinea, inspectați segmentele, blocați testele finale și verificați că câștigurile offline supraviețuiesc implementării. Aplicat specific la validarea încrucișată, această disciplină face dovezile portabile: o altă echipă poate judeca dacă câștigul revendicat este probabil să reziste unui model diferit, limbaj, platformă hardware, set de date, populație de utilizatori sau toleranță la risc.
Beneficiile pe care le poate oferi validarea încrucișată
Cel mai puternic motiv pentru a folosi validarea încrucișată este că poate aborda direct blocajul vizat. În funcție de implementare, beneficiul poate apărea ca o mai bună fundamentare, o reprezentare mai fidelă, o generalizare îmbunătățită, latență redusă, mișcare de memorie scăzută, responsabilitate mai clară sau o frontieră mai sigură între propunerea unui model și o acțiune reală.
Beneficiile trebuie exprimate ca decizii și măsurători. „Mai inteligent” nu este un criteriu de acceptare pentru validarea încrucișată. Un obiectiv util ar putea specifica rata de eroare pe cazuri dificile, recuperarea după dovezi contradictorii, costul la un percentil de trafic, timpul de revizuire umană, calibrarea sau procentul de acțiuni menținute în limita unei autorități definite.
Modul de eșec care definește validarea încrucișată
Limitarea centrală este că împărțirile aleatorii obișnuite sunt nevalide când datele au dependență temporală, de grup sau spațială. Acest eșec nu este un gând ulterior de listat odată ce dezvoltarea este finalizată. Ar trebui să modeleze colectarea datelor, arhitectura, permisiunile, evaluarea, porțile de lansare și monitorizarea pentru validarea încrucișată încă de la început.
Un control pentru validarea încrucișată este util doar dacă acționează înainte de o consecință costisitoare sau ireversibilă. Identificați cel mai devreme precursor observabil al eșecului, stabiliți un prag sau o regulă, atribuiți un responsabil și testați recuperarea. În funcție de caz, recuperarea poate însemna abținere, revenire la un sistem mai simplu, solicitarea de dovezi suplimentare, escaladarea către o persoană, revenirea la o versiune anterioară a modelului sau oprirea completă a acțiunii.
Un plan de evaluare pentru validarea încrucișată
Începeți evaluarea Cross-validation prin redactarea deciziei pe care trebuie să o susțină dovezile. Definiți populația de operare, consecința unui rezultat greșit, informațiile efectiv disponibile în momentul deciziei și cea mai simplă alternativă credibilă. Acest lucru împiedică ca un benchmark să devină scopul doar pentru că este ușor de rulat.
Utilizați un set de testare neatins pentru comparații controlate, apoi validați Cross-validation într-un mediu de operare etapizat. Evaluarea offline face variantele comparabile; modul shadow, canari, limitele de rată sau porțile de aprobare dezvăluie cum traficul real, buclele de feedback și oamenii modifică comportamentul. Etapa de implementare ar trebui să aibă o condiție de oprire explicită, în loc să se presupună că fiecare îmbunătățire merită o lansare completă.
Versionați intrările necesare pentru a reproduce Cross-validation: datele sursă, preprocesarea, tokenizer-ul sau encoder-ul, greutățile modelului, configurația, promptul sau politica, indicele de recuperare, setul de evaluare, presupunerile hardware și codul de servire, după caz. Fără trasabilitate, o echipă nu poate determina dacă un rezultat modificat provine din tehnică, din mediu sau dintr-o editare net observată a pipeline-ului.
În final, întrebați ce constatare ar falsifica afirmația că Cross-validation ajută. Dacă niciun rezultat nu ar putea inversa decizia de adoptare, evaluarea devine marketing. Pragurile de acceptare precomise și un set de confirmare păstrat transformă exercițiul în dovezi.
Întrebări de pus înainte de a adopta Cross-Validation
- Obiectiv: Ce blocaj măsurabil este destinat să rezolve Cross-validation?
- Mecanism: Care dintre cele cinci etape conține transformarea distinctivă?
- Referință: Cum se compară cu testarea multor modele pe setul final de testare sau cu o altă alternativă mai simplă?
- Dovezi: Ce cazuri obișnuite, dificile, adversare și de subgrup au fost testate?
- Operațiuni: Ce costuri de latență, memorie, calcul, energie, întreținere și revizuire apar la scară?
- Risc: Cum va detecta echipa că plierile aleatorii obișnuite sunt invalide când datele au dependență temporală, de grup sau spațială?
- Recuperare: Poate sistemul să se abțină, să revină la o versiune anterioară, să revină înapoi sau să escaladeze înainte de a provoca daune?
Surse primare pentru studierea Cross-Validation
Surse autoritare de pornire pentru partea din stiva AI care înconjoară validarea încrucișată includ scikit-learn ghid de selecție a modelelor, Google Regulile ML, NIST AI RMF. Citiți-le împreună cu documentația pentru modelul exact, setul de date, hardware-ul și jurisdicția implicate. O sursă generală poate defini mecanismul, dar doar dovezile specifice implementării pot demonstra că o anumită implementare este adecvată.
Ce trebuie să rețineți despre Cross-Validation
Cross-validation este un mecanism definit în cadrul unui sistem sociotehnic mai larg. Valoarea sa provine din îmbunătățirea unui rezultat specific în condiții explicite, nu din etichetă în sine. Harta în cinci etape face fluxul său de informații vizibil, comparația identifică ce nu este, iar calea de control arată unde poate interveni un operator responsabil.
Regula practică pentru Cross-validation este să definiți obiectivul, să comparați cu o referință credibilă, să testați defectul care contează cel mai mult și să păstrați dovezile necesare pentru a monitoriza schimbarea. Odată ce aceste elemente sunt în loc, conceptul devine o alegere de inginerie și guvernanță care poate fi evaluată. Fără ele, rămâne un nume promițător atașat unui risc operațional necunoscut.


