
Fundamentele AI
Ce sunt modelele viziune-limbaj (VLM)? Cum conectează IA imaginile și cuvintele
Modelele de viziune și limbaj conectează caracteristicile vizuale cu limbajul, astfel încât un sistem să poată descrie, compara, regăsi sau raționa despre imagini folosind cuvinte. Acest ghid explică mecanismul, compromisurile, evaluarea și controalele relevante în practică.

 Adaugă Unite.AI la sursele tale preferate pe Google
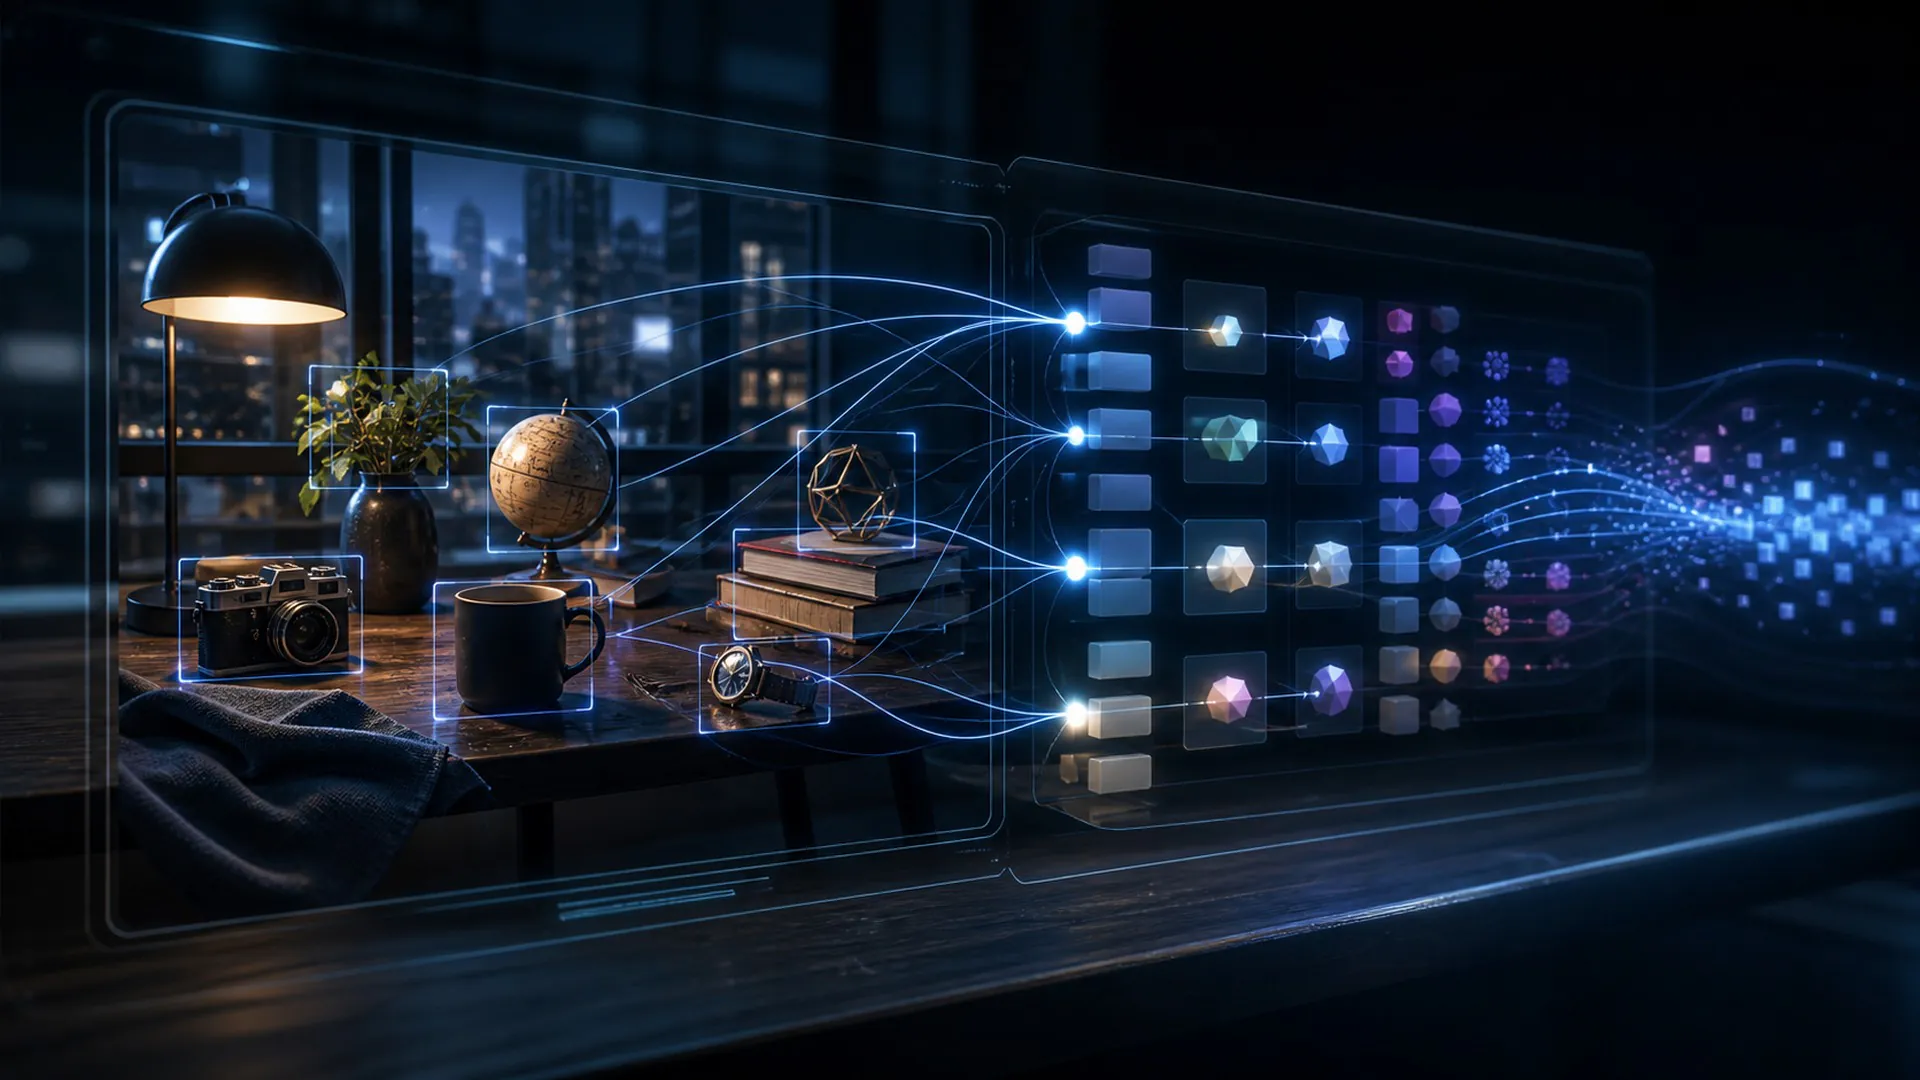
Modelele viziune-limbaj conectează caracteristicile vizuale cu limbajul, astfel încât un sistem să poată descrie, compara, regăsi sau analiza imagini folosind cuvinte.
Modelele viziune-limbaj merită o explicație precisă, deoarece denumirea lor identifică un anumit flux de informații, o anumită alegere de antrenare, un mecanism de execuție sau o limită de guvernanță. Dacă le tratăm ca sinonim pentru „IA avansată”, afirmațiile despre ele devin imposibil de verificat. Acest ghid urmărește conceptul de la datele de intrare și ipotezele sale până la rezultatul observabil, apoi testează scurtătura cel mai ușor de confundat cu acesta.
Modelele viziune-limbaj: definiție, delimitare și scop
Modelele viziune-limbaj conectează caracteristicile vizuale cu limbajul, astfel încât un sistem să poată descrie, compara, regăsi sau analiza imagini folosind cuvinte. Definiția presupune trei angajamente practice: existența unei date de intrare identificabile, a unei transformări sau decizii caracteristice modelelor viziune-limbaj și a unui rezultat care poate fi evaluat în raport cu un obiectiv declarat. Dacă lipsește unul dintre aceste elemente, denumirea poate descrie o aspirație, nu un mecanism implementat.
Sistemele multimodale trebuie să alinieze semnale cu rezoluții, temporizări, niveluri de zgomot și ambiguități diferite. Un cuvânt se poate referi la o mică regiune a imaginii, iar un eveniment audio poate preceda cadrul video care îl explică. În cazul modelelor viziune-limbaj, această perspectivă asupra sistemului contează, deoarece performanța poate depinde de datele, interfețele, componentele hardware, permisiunile și oamenii din jurul modelului, chiar dacă modelul în sine rămâne neschimbat. Prin urmare, o explicație utilă separă comportamentul învățat al modelului de produsul care decide când, unde și cu ce autoritate este folosit acel comportament.
Cea mai apropiată scurtătură înșelătoare este vederea computerizată care prezice o etichetă fixă, fără a folosi limbaj deschis. Poate avea o caracteristică vizibilă comună cu modelele viziune-limbaj, dar schimbă explicația cauzală: succesul ar fi demonstrat prin alte dovezi, costurile ar fi dominate de alte resurse, iar pentru prevenirea prejudiciilor ar fi necesare alte controale. Prin urmare, delimitarea este una operațională, nu terminologică.
O hartă operațională în cinci etape a modelelor viziune-limbaj
Diagrama este o hartă cauzală compactă a modelelor viziune-limbaj, nu o afirmație că fiecare implementare folosește cinci componente software. Unele sisteme combină etapele, iar altele le repetă într-o buclă. Harta rămâne utilă deoarece obligă la identificarea unui responsabil, a unei intrări, a unei ieșiri și a unui test pentru fiecare schimbare de informație sau de autoritate.
1. Împărțirea sau codificarea imaginii în tokeni vizuali: date de intrare și ipoteze în modelele viziune-limbaj
În această etapă a modelelor viziune-limbaj, sistemul trebuie să împartă sau să codifice imaginea în tokeni vizuali. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații folosește, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge această operațiune de vederea computerizată care prezice o etichetă fixă, fără a folosi limbaj deschis, și să-i reproducă rezultatul în aceleași condiții declarate.
Predarea către această etapă a modelelor viziune-limbaj pornește de la obiectivul declarat și ar trebui să se încheie cu un rezultat care să permită codificarea textului însoțitor. Înregistrați incertitudinea, alternativele respinse, resursele folosite și orice control uman sau software aplicat la această limită. Această urmă le permite echipelor să detecteze dacă descrierile fluente pot numi obiecte sau relații care nu sunt de fapt vizibile, înainte ca aceeași slăbiciune să afecteze un rezultat cu consecințe importante.
2. Codificarea textului însoțitor: reprezentare sau decizie în modelele viziune-limbaj
În această etapă a modelelor viziune-limbaj, sistemul trebuie să codifice textul însoțitor. Întrebarea utilă nu este doar dacă operațiunea are loc, ci și ce informații folosește, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge această operațiune de vederea computerizată care prezice o etichetă fixă, fără a folosi limbaj deschis, și să-i reproducă rezultatul în aceleași condiții declarate.
Trecerea la această etapă a modelelor de viziune și limbaj începe prin împărțirea sau codificarea imaginii în tokenuri vizuale și ar trebui să se încheie cu un rezultat care să permită conectarea ambelor reprezentări. Înregistrați incertitudinea, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această urmă le permite echipelor să detecteze dacă descrierile fluente pot numi obiecte sau relații care nu sunt de fapt vizibile, înainte ca aceeași slăbiciune să afecteze un rezultat cu consecințe importante.
3. Conectarea ambelor reprezentări: transformarea distinctivă din modelele de viziune și limbaj
În această etapă a modelelor de viziune și limbaj, sistemul trebuie să conecteze ambele reprezentări. Întrebarea utilă nu este doar dacă are loc această operațiune, ci și ce informații utilizează, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge operațiunea de viziunea computerizată, care prezice o etichetă fixă fără limbaj deschis, și să-i reproducă rezultatul în aceleași condiții declarate.
Trecerea la această etapă a modelelor de viziune și limbaj începe prin codificarea textului însoțitor și ar trebui să se încheie cu un rezultat care să permită identificarea corespondențelor dintre regiuni și expresii. Înregistrați incertitudinea, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această urmă le permite echipelor să detecteze dacă descrierile fluente pot numi obiecte sau relații care nu sunt de fapt vizibile, înainte ca aceeași slăbiciune să afecteze un rezultat cu consecințe importante.
4. Identificarea corespondențelor dintre regiuni și expresii: limita constrângerilor și a verificării în modelele de viziune și limbaj
În această etapă a modelelor de viziune și limbaj, sistemul trebuie să identifice corespondențele dintre regiuni și expresii. Întrebarea utilă nu este doar dacă are loc această operațiune, ci și ce informații utilizează, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge operațiunea de viziunea computerizată, care prezice o etichetă fixă fără limbaj deschis, și să-i reproducă rezultatul în aceleași condiții declarate.
Trecerea la această etapă a modelelor de viziune și limbaj începe prin conectarea ambelor reprezentări și ar trebui să se încheie cu un rezultat care să permită decodificarea unui răspuns sau a unei acțiuni fundamentate. Înregistrați incertitudinea, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această urmă le permite echipelor să detecteze dacă descrierile fluente pot numi obiecte sau relații care nu sunt de fapt vizibile, înainte ca aceeași slăbiciune să afecteze un rezultat cu consecințe importante.
5. Decodificarea unui răspuns sau a unei acțiuni fundamentate: rezultat, feedback și regulă de oprire în modelele de viziune și limbaj
În această etapă a modelelor de viziune și limbaj, sistemul trebuie să decodifice un răspuns sau o acțiune fundamentată. Întrebarea utilă nu este doar dacă are loc această operațiune, ci și ce informații utilizează, ce stare modifică și ce dovezi demonstrează că modificarea a fost validă. Un evaluator ar trebui să poată distinge operațiunea de viziunea computerizată, care prezice o etichetă fixă fără limbaj deschis, și să-i reproducă rezultatul în aceleași condiții declarate.
Trecerea la această etapă a modelelor de viziune și limbaj începe prin identificarea corespondențelor dintre regiuni și expresii și ar trebui să se încheie cu un rezultat care să permită monitorizarea sau luarea unei decizii finale. Înregistrați incertitudinea, alternativele respinse, resursele utilizate și orice control uman sau software aplicat la această limită. Această urmă le permite echipelor să detecteze dacă descrierile fluente pot numi obiecte sau relații care nu sunt de fapt vizibile, înainte ca aceeași slăbiciune să afecteze un rezultat cu consecințe importante.
Parcurgeți schema modelelor de viziune și limbaj înainte, pentru a înțelege producția, și înapoi, pentru a diagnostica defecțiunile. Analiza înainte examinează modul în care o etapă furnizează informații etapei următoare. Analiza înapoi pornește de la un rezultat incorect, lent, costisitor sau nesigur și urmărește ipoteza anterioară care l-a permis. Adesea, urmărind traseul invers, echipa descoperă că eroarea decisivă s-a produs înainte ca modelul să genereze ceva.
Exemplu aplicat de utilizare a modelelor de viziune și limbaj
Un model de viziune și limbaj poate analiza o captură de ecran a unui tablou de bord și poate explica ce diagramă susține o afirmație scrisă.
Acest exemplu este instructiv, deoarece modelele de viziune și limbaj pot fi evaluate pe baza unor intrări observabile, a unor stări intermediare și a unui rezultat, nu doar printr-o demonstrație bine finisată. Un test riguros ar construi cazuri obișnuite, dificile și înșelătoare în mod deliberat, pornind de la scenariu, ar păstra un rezultat de referință fără tehnica respectivă și ar înregistra atât performanța medie, cât și gravitatea defecțiunilor individuale.
Modificați o ipoteză din exemplul cu modelele de viziune și limbaj și repetați analiza. Eliminați o intrare necesară, introduceți un semnal contradictoriu, limitați puterea de calcul, schimbați populația de utilizatori sau obligați sistemul să se abțină. Un mecanism care reușește doar într-o singură demonstrație aranjată cu grijă nu a dovedit că se generalizează la mediul operațional.
Modelele de viziune și limbaj comparate cu cea mai frecventă soluție simplificatoare
Modelele de viziune și limbaj sunt adesea reduse la viziune computerizată care prezice o etichetă fixă, fără limbaj deschis. Această reducere elimină tocmai limita care definește conceptul. Poate determina cumpărătorii să compare produse diferite, cercetătorii să exagereze ceea ce demonstrează un experiment, iar operatorii să monitorizeze semnalul greșit după implementare.
| Perspectivă | Răspuns practic |
|---|---|
| Definiție | Modelele de viziune și limbaj asociază caracteristici vizuale cu limbajul, astfel încât un sistem să poată descrie, compara, căuta sau raționa despre imagini folosind cuvinte. |
| Confuzie | viziune computerizată care prezice o etichetă fixă, fără limbaj deschis. |
| Risc | descrierile fluente pot denumi obiecte sau relații care nu sunt de fapt vizibile. |
Comparația ar trebui să precizeze și unitatea de analiză. Un studiu despre modelele de viziune și limbaj poate examina separat un model sau un algoritm, în timp ce un serviciu implementat adaugă funcții de regăsire, rutare, stocare în cache, politici, gestionarea identității, interfețe pentru utilizatori și monitorizare. Două produse pot folosi același termen-cheie, deși implementează componente diferite ale acestei stive. Întrebați care componentă realizează transformarea definitorie și ce alte componente sunt necesare pentru rezultatul raportat.
De ce contează modelele de viziune și limbaj în sistemele de inteligență artificială actuale
Modelele de viziune și limbaj contează acum deoarece sistemele de inteligență artificială primesc contexte mai ample, mai multe modalități, mai multe resurse de calcul în timpul execuției, acces mai larg la instrumente și conexiuni mai strânse cu deciziile organizaționale. În aceste condiții, ceea ce părea cândva un detaliu de cercetare poate determina latența, securitatea, accesibilitatea, costul de mediu, calitatea produsului sau responsabilitatea juridică.
Criteriul relevant nu este dacă modelele de viziune și limbaj pot produce un singur rezultat impresionant. Contează dacă tehnica îmbunătățește un rezultat important în condiții reprezentative și dacă o face mai eficient decât o metodă de referință mai simplă. Raportați distribuțiile, categoriile de erori, latența la coada distribuției, utilizarea resurselor și subgrupurile afectate, în loc să comprimați toate rezultatele într-o singură medie.
Evaluarea ar trebui să izoleze fiecare modalitate, să testeze intrările contradictorii și să verifice ancorarea temporală sau spațială. Un răspuns fluent care combină mai multe modalități nu dovedește că modelul a acordat atenție semnalului potrivit. Aplicată în mod specific modelelor de viziune și limbaj, această rigoare face ca dovezile să poată fi folosite și în alte contexte: o altă echipă poate aprecia dacă este probabil ca avantajul revendicat să se mențină cu un alt model, într-o altă limbă, pe o altă platformă hardware, cu un alt set de date, o altă populație de utilizatori sau o altă toleranță la risc.
Beneficiile pe care le pot oferi modelele de viziune și limbaj
Cel mai puternic motiv pentru a folosi modelele de viziune și limbaj este că acestea pot aborda direct blocajul vizat. În funcție de implementare, beneficiul se poate traduce printr-o ancorare mai bună, o reprezentare mai fidelă, o capacitate de generalizare îmbunătățită, o latență mai mică, mai puține transferuri de date în memorie, o responsabilitate mai clară sau o delimitare mai sigură între propunerea unui model și o acțiune reală.
Beneficiile ar trebui exprimate prin decizii și măsurători. „Mai inteligent” nu este un criteriu de acceptare pentru modelele de viziune și limbaj. Un obiectiv util ar putea preciza rata de eroare în cazurile dificile, capacitatea de recuperare în urma unor dovezi contradictorii, costul la un anumit percentil al traficului, timpul necesar verificării umane, calibrarea sau procentul de acțiuni menținute în limitele de autoritate definite.
Modul de eșec care definește modelele de viziune și limbaj
Limitarea centrală este că descrierile fluente pot denumi obiecte sau relații care nu sunt de fapt vizibile. Acest mod de eșec nu este un detaliu secundar de adăugat pe listă după încheierea dezvoltării. Încă de la început, el ar trebui să influențeze colectarea datelor, arhitectura, permisiunile, evaluarea, criteriile de lansare și monitorizarea modelelor de viziune și limbaj.
Un control pentru modelele de viziune și limbaj este util numai dacă intervine înainte de apariția unei consecințe costisitoare sau ireversibile. Identificați cel mai timpuriu precursor observabil al eșecului, stabiliți un prag sau o regulă, desemnați un responsabil și testați procedura de recuperare. În funcție de cazul de utilizare, recuperarea poate însemna abținerea de la un răspuns, revenirea la un sistem mai simplu, solicitarea unor dovezi suplimentare, escaladarea către o persoană, revenirea la o versiune anterioară a modelului sau oprirea completă a unei acțiuni.
Un plan de evaluare pentru modelele de viziune și limbaj
Începeți evaluarea modelelor de viziune și limbaj formulând decizia pe care trebuie să o susțină dovezile. Definiți populația vizată de utilizare, consecințele unui rezultat greșit, informațiile disponibile efectiv în momentul deciziei și cea mai simplă alternativă credibilă. Astfel, evitați ca un set de referință să devină scopul în sine doar pentru că este ușor de folosit.
Folosiți un set de testare neatins pentru comparații controlate, apoi validați modelele de viziune și limbaj într-un mediu operațional etapizat. Evaluarea offline permite compararea variantelor; modul shadow, testările canary, limitele de rată sau etapele de aprobare arată cum influențează comportamentul traficul real, buclele de feedback și oamenii. Etapa de implementare ar trebui să aibă o condiție explicită de oprire, în loc să presupună că orice îmbunătățire justifică lansarea completă.
Versionați datele de intrare necesare pentru reproducerea rezultatelor modelelor de viziune și limbaj: datele sursă, preprocesarea, tokenizatorul sau codificatorul, ponderile modelului, configurația, promptul sau politica, indexul de regăsire, setul de evaluare, ipotezele privind hardware-ul și codul de servire, după caz. Fără o trasabilitate a provenienței, echipa nu poate stabili dacă un rezultat modificat se datorează tehnicii, mediului sau unei modificări neobservate a conductei de procesare.
În cele din urmă, întrebați-vă ce constatare ar infirma afirmația că modelele de viziune și limbaj sunt utile. Dacă niciun rezultat nu ar putea schimba decizia de adoptare, evaluarea nu este decât marketing. Pragurile de acceptare stabilite în prealabil și păstrarea unui set de confirmare transformă exercițiul în dovezi.
Întrebări de pus înainte de adoptarea modelelor de viziune și limbaj
- Obiectiv: Ce blocaj măsurabil ar trebui să rezolve modelele de viziune și limbaj?
- Mecanism: În care dintre cele cinci etape are loc transformarea distinctivă?
- Referință: Cum se compară cu viziunea computerizată, care prezice o etichetă fixă fără limbaj deschis, sau cu o altă alternativă mai simplă?
- Dovezi: Ce cazuri obișnuite, dificile, adversariale și din subgrupuri au fost testate?
- Operațiuni: Ce costuri privind latența, memoria, puterea de calcul, energia, mentenanța și verificarea apar la scară largă?
- Riscuri: Cum va detecta echipa situațiile în care descrierile formulate fluent numesc obiecte sau relații care nu sunt de fapt vizibile?
- Recuperare: Poate sistemul să se abțină de la un răspuns, să revină la o variantă de rezervă, să revină la o versiune anterioară sau să escaladeze situația înainte de producerea unui prejudiciu?
Surse primare pentru studierea modelelor de viziune și limbaj
Printre punctele de plecare cu autoritate pentru partea din stiva de inteligență artificială care include modelele de viziune și limbaj se numără lucrarea de cercetare CLIP și modelul multimodal întrupat PaLM-E. Consultați-le împreună cu documentația modelului, setului de date, hardware-ului și jurisdicției specifice implicate. O sursă generală poate defini mecanismul, însă numai dovezile specifice implementării pot stabili dacă o anumită soluție este adecvată.
Ce trebuie reținut despre modelele de viziune și limbaj
Modelele de viziune și limbaj constituie un mecanism bine definit în cadrul unui sistem sociotehnic mai amplu. Valoarea lor constă în îmbunătățirea unui rezultat specific în condiții explicite, nu în eticheta în sine. Schema în cinci etape face vizibil fluxul de informații, comparația arată ce nu sunt, iar traseul de control indică unde poate interveni un operator responsabil.
Regula practică pentru modelele de viziune și limbaj este să definiți obiectivul, să comparați soluția cu o referință credibilă, să testați eșecul cel mai important și să păstrați dovezile necesare pentru monitorizarea schimbărilor. Odată puse la punct aceste elemente, conceptul devine o opțiune de inginerie și guvernanță care poate fi evaluată. În lipsa lor, rămâne doar o denumire promițătoare asociată unui risc operațional necunoscut.


